2026年MacBook上运行Ollama的最佳eGPU是什么?
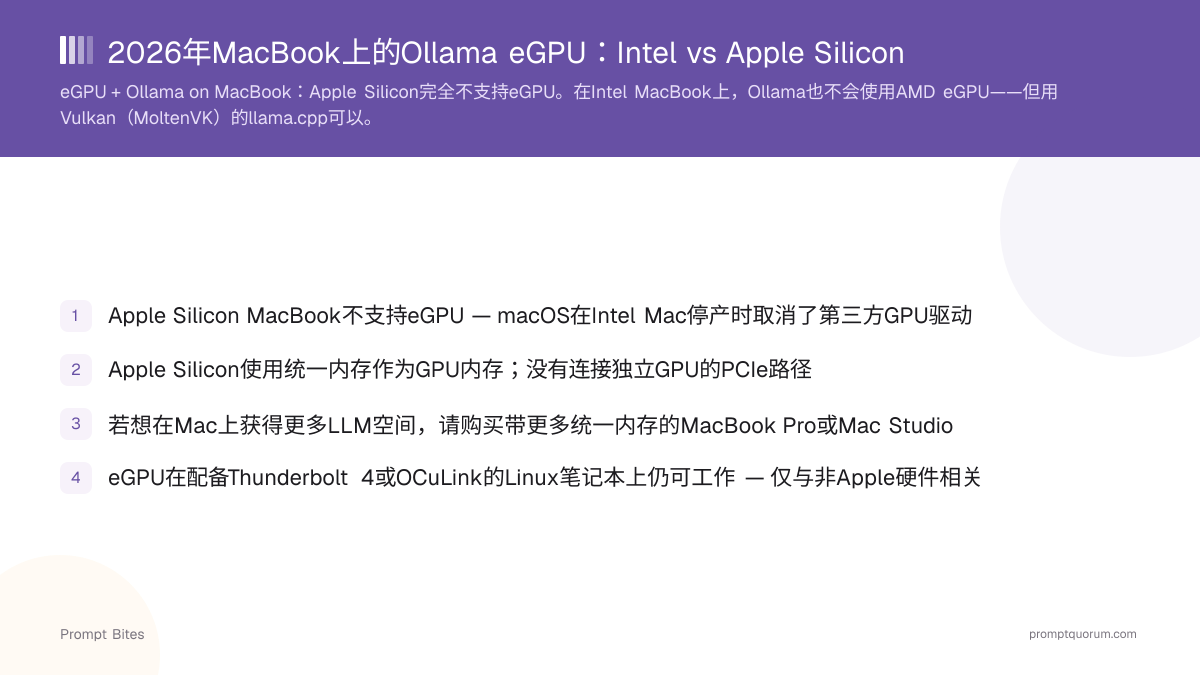
对于Apple Silicon MacBook,eGPU通常不是应该为Ollama购买的升级方案。Ollama已经通过Metal使用Mac内置GPU进行加速,因此买更多统一内存对本地LLM能力的提升,比任何外接GPU都更大。自2026年4月起,苹果批准了一款名为TinyGPU的第三方驱动,让NVIDIA和AMD eGPU可以通过Thunderbolt或USB4在Apple Silicon上进行AI计算——但这仅通过tinygrad框架工作,与Ollama无关,因此目前不会改变对Ollama用户的这一建议。如果你需要的本地AI性能远超任何Mac配置所能提供的,独立的NVIDIA GPU系统才是更好的投资。如果你使用的是Intel MacBook或iMac,eGPU是更合理的选择——详见下文。
本页包含指向第三方产品的参考链接。PromptQuorum 未加入任何联盟计划——这些是不产生佣金的普通链接。点击链接和后续步骤由您自行承担责任。这些链接不代表 PromptQuorum 的任何认可或验证。
快速回答
对于Apple Silicon MacBook,没有任何eGPU能加速Ollama——应改为购买更多统一内存。如果你需要的本地AI性能远超Mac所能提供的,请购买独立的NVIDIA GPU系统。如果你拥有Intel MacBook或iMac,eGPU是真正合理的选择。
- ▸Apple Silicon上的Ollama使用芯片内置的Metal——无论有没有苹果新推出的TinyGPU驱动,都没有eGPU路径。
- ▸苹果于2026年4月批准了TinyGPU,使NVIDIA/AMD eGPU可以在Apple Silicon上进行AI计算——但仅通过tinygrad框架,而非Ollama。
- ▸在Intel Mac上,AMD eGPU可以通过Thunderbolt 3在物理层面工作,并可通过Vulkan(MoltenVK)加速llama.cpp——但不能直接用于Ollama本身。
关键要点
- ✓Apple Silicon + Ollama:使用内置的Metal GPU——eGPU通常不是应该购买的升级方案
- ✓在Apple Silicon上运行更大本地模型的真正升级路径是增加统一内存
- ✓苹果于2026年4月批准了用于AI计算的第三方eGPU驱动(TinyGPU),但它通过tinygrad运行,与Ollama无关
- ✓需要的本地AI性能远超Mac所能提供?独立的NVIDIA GPU系统是更好的投资
- ✓拥有Intel Mac或iMac?eGPU是一种真正不同、更合理的情况——参见Intel Mac部分
快速答案
如果你有Apple Silicon MacBook,不要为Ollama购买eGPU——应购买更多统一内存,因为Ollama已经通过Metal在Mac内置GPU上运行。如果你的优先事项从"一台也能运行本地AI的MacBook"转变为"最大化的本地AI性能",独立的NVIDIA GPU系统是更好的选择。如果你已经拥有Intel MacBook或iMac,eGPU是延长其使用寿命的真正合理方式。
- ▸🍎 Apple Silicon的最佳方案:购买更多统一内存,而非eGPU
- ▸💰 最佳预算方案:保留你的MacBook,直接使用其内置Metal GPU
- ▸🚀 需要更强GPU性能?购买独立的NVIDIA GPU系统
- ▸⚠️ 拥有Intel Mac或iMac?eGPU可能是合理选择——这是根本不同的情况
为什么eGPU不是Apple Silicon上Ollama的升级方案
在Apple Silicon上,GPU与CPU共享同一物理内存(统一内存),Ollama只通过Metal把推理任务分发给这个内置GPU。没有可以用外接显卡扩展的独立显存池,Ollama在macOS上也没有像在Windows和Linux上那样的NVIDIA/AMD加速路径。
这一点在2026年4月有所变化:苹果批准了TinyGPU,这是Tiny Corp(tinygrad背后的团队)开发的第三方DriverKit扩展,允许NVIDIA(Ampere或更新)或AMD(RDNA3或更新)eGPU通过Thunderbolt或USB4在Apple Silicon上进行AI计算,且无需关闭系统完整性保护(SIP)。它仅限于计算——没有游戏加速、没有显示输出、不支持Metal API——并且只能通过tinygrad框架(`DEV=NV`或`DEV=AMD`)运行。Ollama不使用tinygrad,因此这并不会给Ollama带来eGPU路径;它主要对已经在tinygrad上开发的开发者有意义。
对于专门使用Ollama的人来说,购买eGPU机箱、显卡、电源,再排查Thunderbolt兼容性问题,要花不少钱和精力,最终得到的却是一套Ollama仍然用不上的配置。增加统一内存更简单,按每GB有效容量算更便宜,而且今天就能零配置直接使用。
| 约束 | Apple Silicon MacBook | TB4/OCuLink Linux笔记本 |
|---|---|---|
| Ollama eGPU加速 | 无路径——仅限Metal | 可用CUDA或ROCm工作 |
| 任何AI计算eGPU路径 | TinyGPU(仅tinygrad,2026年4月起) | 原生NVIDIA/AMD驱动 |
| 内存架构 | 仅统一内存 | eGPU上的独立VRAM |
根据想运行的模型购买内存
在Apple Silicon上运行本地LLM时,统一内存容量决定了你到底能加载哪些模型——GPU速度只决定能加载的模型运行有多快。
苹果2026年8月的产品线更新提高了桌面Mac的内存上限:Mac mini起售价899美元(M6,最高32GB)或1,699美元(M5 Pro,最高64GB),Mac Studio起售价2,499美元(M5 Max,最高128GB),最高配置5,499美元(M5 Ultra,最高512GB)。这些上限针对的是桌面系列——MacBook Pro的内存上限仍然更低。
| 统一内存 | 评价 |
|---|---|
| 16 GB | 🟡 仅适合小模型 |
| 24 GB | 🟢 余量明显更好 |
| 32 GB | 🟢 强大的便携配置 |
| 48 GB以上 | 🚀 模型余量大幅提升 |
需要更强性能?购买独立的NVIDIA系统
如果你的优先事项从"一台也能处理本地AI的MacBook"转变为"最大化的本地AI性能",请购买一台独立的NVIDIA主机,而不是试图给Mac硬加GPU性能。Ollama通过CUDA支持RTX 30、40、50系列(及更新)的NVIDIA GPU,这能带来专用显存、更丰富的硬件选择,以及任何Mac都无法提供的直接可升级性。
这是一种清晰的分工,而不是妥协:MacBook继续负责便携性与日常使用,NVIDIA系统则用于真正需要额外性能的本地AI工作负载。
Intel MacBook或iMac怎么办?eGPU是不同的、更合理的情况
在这种情况下答案会改变。较旧的Intel Mac——包括Intel MacBook Pro和Intel iMac——在macOS层面通过Thunderbolt 3支持外部GPU,因此eGPU可以是延长现有设备使用寿命的合理方式。Apple Silicon iMac(当前的M系列iMac)遵循与Apple Silicon MacBook相同的规则:Ollama没有eGPU路径。
在Intel Mac上,Ollama仍然不会把任务分发给eGPU——它只在Apple Silicon的Metal上加速。变通方案是用Vulkan后端(通过MoltenVK)编译llama.cpp,它可以在Intel Mac上的AMD eGPU(例如Radeon RX 6800/6900 XT)上运行推理,Thunderbolt带宽会带来约15–17%的开销。这需要手动编译,因此不像Apple Silicon上的Ollama那样开箱即用——但如果你已经拥有这台Intel Mac,这是一个真实可行的选项。
如果你今天专门为本地AI购买Mac,请改为购买Apple Silicon机型并优先考虑统一内存——不要为这个用途购买Intel Mac。
延伸阅读
- ▸Mac Mini M4适合本地LLM吗? — 同架构的桌面版
- ▸2026本地LLM GPU购买指南 — 独立NVIDIA系统路线
- ▸1,000美元以下最佳AI预算笔记本 — 入门层级的非Apple替代
- ▸本地LLM最佳迷你PC — 桌面迷你PC与MacBook统一内存对比