هل يمكن تشغيل Qwen 3 على Ollama؟
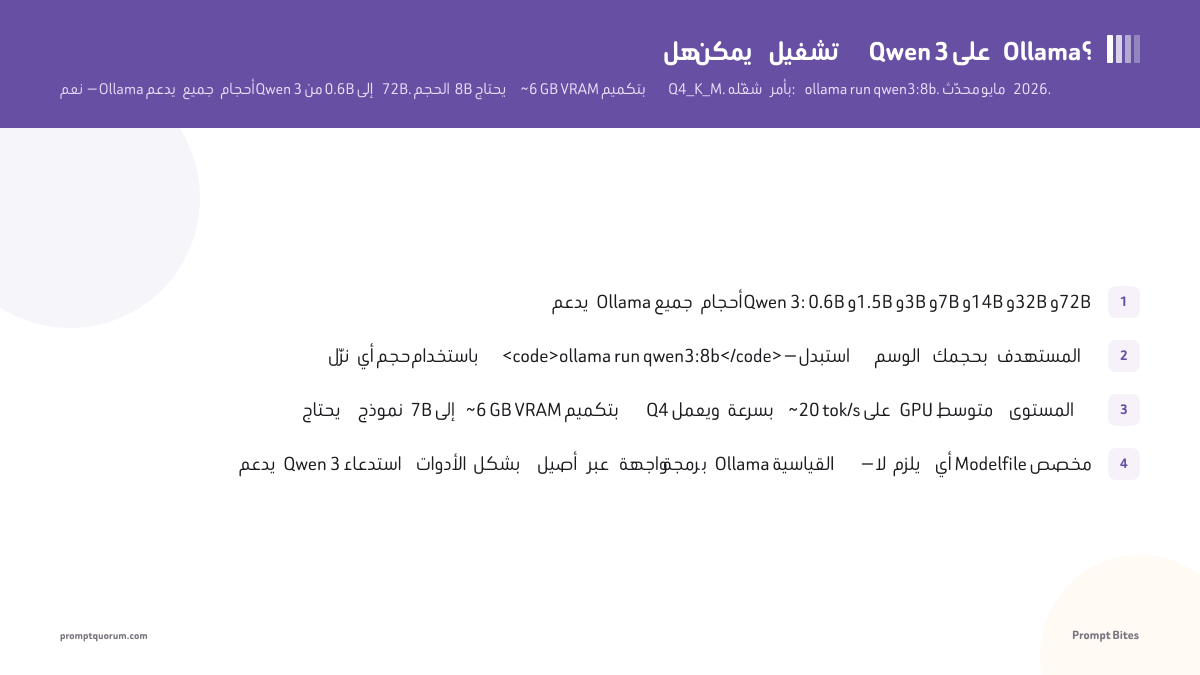
إجابة سريعة
نعم — يدعم Ollama جميع أحجام نماذج Qwen 3 من 0.6B إلى 32B، إضافةً إلى نسخة MoE بحجم 30B-A3B. شغّل أي حجم بأمر واحد مثل ollama run qwen3:8b. يحتاج النموذج 8B إلى ~6 GB VRAM بتكميم Q4.
- ▸ollama run qwen3:0.6b — يعمل بـ 1 GB VRAM
- ▸ollama run qwen3:8b — يحتاج ~6 GB VRAM
- ▸ollama run qwen3:32b — يحتاج ~21 GB VRAM
النقاط الرئيسية
- ✓يدعم Ollama جميع أحجام Qwen 3: 0.6B و1.7B و4B و8B و14B و32B، إضافةً إلى نسخة MoE بحجم 30B-A3B
- ✓نزّل أي حجم باستخدام <code>ollama run qwen3:8b</code> — استبدل الوسم بحجمك المستهدف
- ✓يحتاج نموذج 8B إلى ~6 GB VRAM بتكميم Q4 ويعمل بسرعة ~20 tok/s على GPU متوسط المستوى
- ✓يدعم Qwen 3 استدعاء الأدوات بشكل أصيل عبر واجهة برمجة Ollama القياسية — لا يلزم أي Modelfile مخصص
نعم — إليك ما هو متاح
يدعم Ollama جميع أحجام نماذج Qwen 3 الرئيسية من 0.6B إلى 32B، إضافةً إلى نسخة MoE بحجم 30B-A3B. نزّل أي حجم بأمر واحد: ollama run qwen3:8b. استبدل 8b بـ 0.6b أو 1.7b أو 4b أو 14b أو 32b أو 30b-a3b للأحجام الأخرى.
كل حجم متاح بتكميمات متعددة. Q4_K_M هو نقطة البداية الافتراضية والموصى بها — يوفر أفضل نسبة جودة إلى حجم الملف. Q8_0 متاح للنموذجين 8B و14B إذا كان لديك هامش VRAM إضافي.
استدعاء الأدوات مدعوم بشكل أصيل في جميع أحجام Qwen 3 عبر واجهة برمجة Ollama القياسية. لا يلزم أي Modelfile مخصص أو قالب مطالبة خاص.
ollama run qwen3:8bاختيار حجم Qwen 3 المناسب
يعتمد اختيار الحجم المناسب من Qwen 3 كليًا على VRAM المتاح. بالنسبة لمعظم المستخدمين الذين يمتلكون GPU متوسط المستوى (6-8 GB VRAM)، يُعدّ نموذج 8B بتكميم Q4_K_M الخيار العملي — يحتاج ~6 GB ويعمل بسرعة ~20 tok/s.
نموذج 14B بتكميم Q4 هو المستوى الموصى به للبرمجة: يتفوق على 8B في توليد الشيفرة ويعمل بشكل مريح في 10-12 GB VRAM. للمقارنة الكاملة لأداء Qwen 3 في البرمجة مقابل النماذج المحلية الأخرى، راجع دليل تشغيل Qwen محليًا في 2026.
| VRAM | حجم Qwen 3 | الأفضل لـ |
|---|---|---|
| < 4 GB | 0.6B / 1.7B | الأجهزة الطرفية والاختبارات والمعالجة المركزية فقط |
| 4–6 GB | 4B | GPU اقتصادي أو معالج مركزي بذاكرة محدودة |
| 6–12 GB | 8B / 14B | الاستخدام العام والبرمجة |
| 12–24 GB | 32B / 30B-A3B (MoE) | برمجة واستدلال عالي الجودة |
إجابات سريعة حول Qwen 3 على Ollama
كيف أُثبّت Qwen 3 على Ollama؟▾
ollama run qwen3:8b في الطرفية. يُنزّل Ollama النموذج تلقائيًا في أول تشغيل. استبدل 8b بحجمك المستهدف: 0.6b أو 1.7b أو 4b أو 14b أو 32b أو 30b-a3b.