可以在Ollama上运行Qwen 3吗?
快速回答
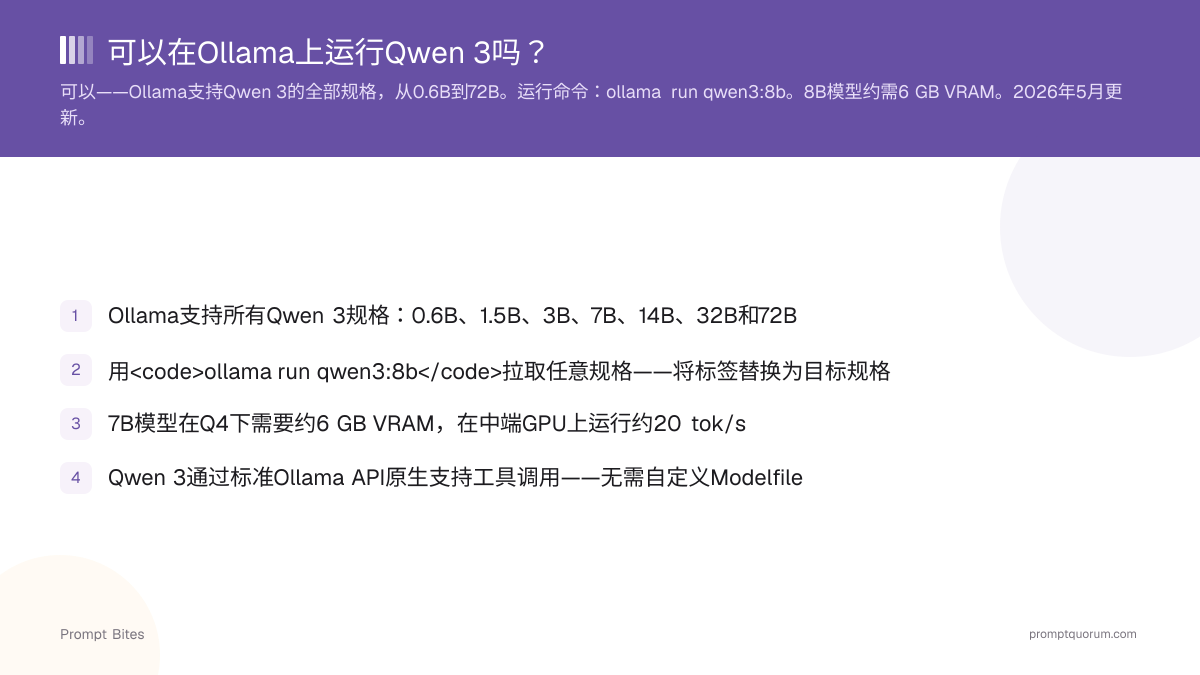
可以——Ollama支持从0.6B到32B的所有Qwen 3模型规格,以及30B-A3B MoE变体。用单条命令运行任意规格:ollama run qwen3:8b。8B模型在Q4下需要约6 GB VRAM。
- ▸ollama run qwen3:0.6b — 仅需1 GB VRAM
- ▸ollama run qwen3:8b — 需要约6 GB VRAM
- ▸ollama run qwen3:32b — 需要约21 GB VRAM
Ollama
关键要点
- ✓Ollama支持所有Qwen 3规格:0.6B、1.7B、4B、8B、14B、32B,以及30B-A3B MoE变体
- ✓用<code>ollama run qwen3:8b</code>拉取任意规格——将标签替换为目标规格
- ✓8B模型在Q4下需要约6 GB VRAM,在中端GPU上运行约20 tok/s
- ✓Qwen 3通过标准Ollama API原生支持工具调用——无需自定义Modelfile
可以——以下是可用的规格
Ollama支持从0.6B到32B的所有主要Qwen 3模型规格,以及30B-A3B MoE变体。用单条命令拉取任意规格:ollama run qwen3:8b。将8b替换为0.6b、1.7b、4b、14b、32b或30b-a3b。
每个规格提供多种量化版本。Q4_K_M是默认的推荐起点——它提供最佳的质量与文件大小比。如果VRAM充足,8B和14B还提供Q8_0版本。
所有Qwen 3规格均通过标准Ollama API原生支持工具调用。无需自定义Modelfile或特殊提示词模板。
ollama run qwen3:8b选择哪个Qwen 3规格
选择Qwen 3规格完全取决于可用VRAM。对于使用中端GPU(6–8 GB VRAM)的大多数用户,Q4_K_M的8B模型是实用之选——需要约6 GB,运行约20 tok/s。
Q4的14B模型是推荐的代码层级:代码生成性能优于8B,且可稳定运行在10–12 GB VRAM中。Qwen 3代码性能与其他本地模型的完整对比,请参阅2026年本地运行Qwen指南。
| VRAM | Qwen 3规格 | 适用场景 |
|---|---|---|
| < 4 GB | 0.6B / 1.7B | 边缘设备、测试、纯CPU |
| 4–6 GB | 4B | 入门级GPU或低内存CPU |
| 6–12 GB | 8B / 14B | 通用使用和代码生成 |
| 12–24 GB | 32B / 30B-A3B(MoE) | 高质量代码和推理 |
Ollama上运行Qwen 3的常见问题
如何在Ollama上安装Qwen 3?▾
在终端运行
ollama run qwen3:8b。Ollama在首次运行时自动下载模型。将8b替换为目标规格:0.6b、1.7b、4b、14b、32b或30b-a3b。Qwen 3在代码任务上比Llama 3更好吗?▾
代码任务:是的,Qwen3 14B在HumanEval基准上优于Llama 3 8B。8B层级的通用对话:Llama 3 8B仍具竞争力。跨任务的当前最佳Ollama选择,请参阅当前最佳Ollama模型。
Qwen 3在Ollama上支持工具调用吗?▾
支持。Qwen 3通过标准Ollama API原生支持函数和工具调用。无需自定义Modelfile或特殊配置——适用于任何支持Ollama工具使用格式的客户端。
本地能运行的最大Qwen 3模型是什么?▾
最大的密集型Qwen 3模型是32B,在Q4下需要约21 GB VRAM——单块RTX 3090或RTX 4090即可运行。若追求相近质量下更快的推理速度,30B-A3B MoE变体仅需约19 GB VRAM,且由于每个token只激活一部分参数,运行速度明显更快。配备32 GB以上统一内存的Apple M系列Mac可轻松运行这两种规格。