目前最佳的Ollama模型是什么?
快速回答
通用场景下,qwen3.5:9b(下载 6.6 GB)是目前最有力的选择。代码方面,qwen2.5-coder:7b 仅 4.7 GB,所需硬件远低于多数指南的说法。轻量场景可用 llama3.2:3b,只需 2.0 GB。所有体积均于 2026 年 8 月 28 日从 Ollama 模型库读取。
- ▸最佳通用:qwen3.5:9b — 6.6 GB
- ▸最佳代码:qwen2.5-coder:7b — 4.7 GB
- ▸最佳轻量:llama3.2:3b — 2.0 GB
关键要点
- ✓最佳通用模型:qwen3.5:9b — 下载 6.6 GB,是 Ollama 中实际可获取的最新一代 Qwen
- ✓最佳代码模型:qwen2.5-coder:7b — 4.7 GB,性价比之选,因为 qwen3-coder 起步就是 19 GB
- ✓最佳轻量模型:llama3.2:3b — 2.0 GB;若想看推理过程,可选 deepseek-r1:1.5b(1.1 GB)
- ✓注意你在比较的数字:这些是 Ollama 模型库的下载体积,不是显存需求。请在下载体积之上为上下文窗口预留余量
- ✓半年前的模型若量化成熟,往往胜过社区支持有限的全新发布版本
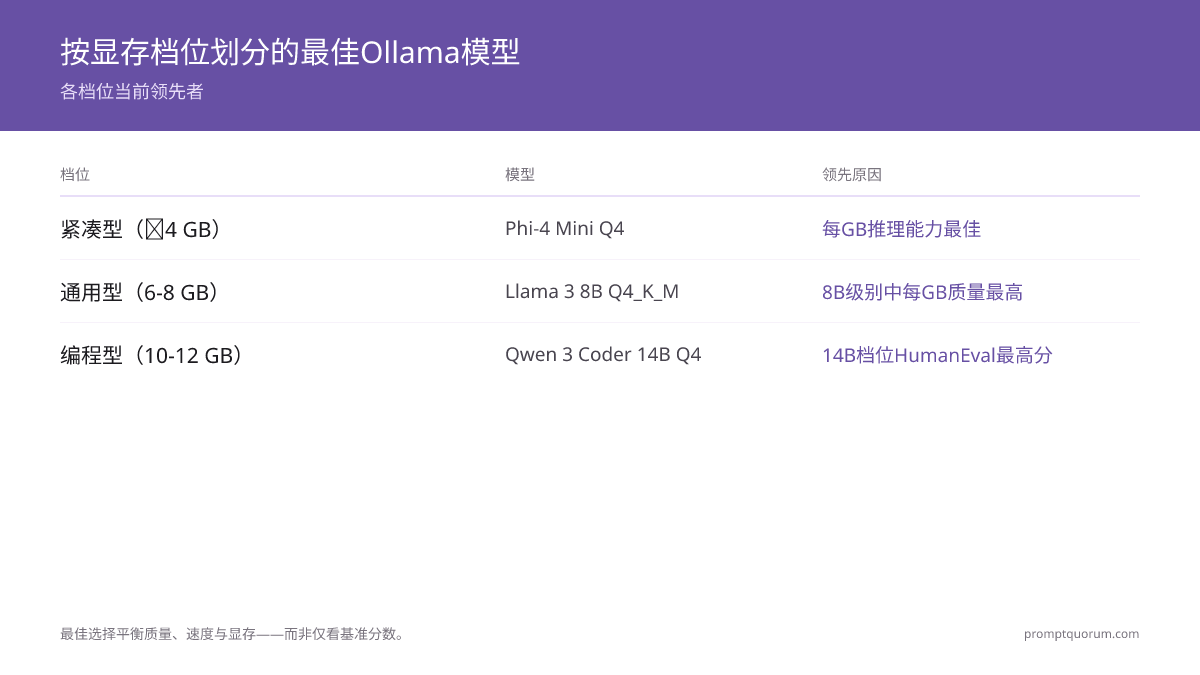
三个层级的领先模型
通用场景当前的选择是 qwen3.5:9b,下载 6.6 GB。下列体积于 2026 年 8 月 28 日直接从 Ollama 模型库读取。
"最佳"的实际含义是输出质量、推理速度和内存效率的最优平衡——而非单纯的基准分数。一个真正装得下的 9B 模型,比一个溢出到磁盘的 30B 模型更有用。
有一个数字需要更正:代码模型比多数指南所说的便宜得多。qwen2.5-coder:7b 下载 4.7 GB,无需特殊提示即可处理 Python、TypeScript 和 Go。更新的 qwen3-coder 起步 19 GB,属于完全不同的硬件档次,并非顺手可换的升级。
| 层级 | 模型 | 下载体积 | 领先原因 |
|---|---|---|---|
| 轻量 | llama3.2:3b | 2.0 GB | 小体积档位每 GB 质量最佳;8160 万次拉取 |
| 通用 | qwen3.5:9b | 6.6 GB | Ollama 中可获取的最新一代 Qwen |
| 代码 | qwen2.5-coder:7b | 4.7 GB | 以 qwen3-coder 零头的体积提供强劲代码输出 |
| 推理 | deepseek-r1:8b | 5.2 GB | 9200 万次拉取,Ollama 上下载量第二 |
新发布不代表更好
新模型发布不会自动成为最佳Ollama选择。量化质量、社区微调和Ollama集成成熟度通常需要4–8周才能赶上新发布版本。
拉取量比任何基准都更能说明问题。llama3.1 以 1.189 亿次拉取仍是模型库中下载最多的,llama3.2 为 8160 万次——两者都领先于所有更新的后来者。这不是惯性,而是人们在选择量化优化充分、跨硬件行为可预测的那一个。
若想用新一代,gemma4(7.2 GB)与 gpt-oss:20b(14 GB,128K 上下文)都值得一试。在投入生产前,先看它能否在首位稳定 6 周以上。关于如何针对自身工作负载评估模型,请参阅Ollama顶级开源模型指南。
体积于 2026 年 8 月 28 日在 ollama.com/library 核实。模型标签变动频繁——在依据此处数字做规划前,请运行 ollama pull 并查看实际报告的体积。
相关指南
- ▸下载AI模型的最佳VPN -- VPN for AI downloads
- ▸Ollama 128K上下文模型 -- long context models
- ▸Ollama最新版本:有什么新功能? -- Ollama updates
- ▸Mistral Small 24B vs Qwen 3 14B vs Llama 3.1 8B -- model comparison