Les meilleurs modèles Ollama en ce moment ?
Par Hans Kuepper · Fondateur de PromptQuorum · Moteur de découverte de l'IA open-weight et open source
Points clés
- ✓Meilleur usage polyvalent : qwen3.5:9b — 6,6 Go de téléchargement, la génération Qwen la plus récente réellement disponible dans Ollama
- ✓Meilleur code : qwen2.5-coder:7b — 4,7 Go, et c'est le choix rapport qualité-prix car qwen3-coder démarre à 19 Go
- ✓Meilleur compact : llama3.2:3b — 2,0 Go, ou deepseek-r1:1.5b à 1,1 Go si vous voulez des traces de raisonnement
- ✓Attention au chiffre comparé : ce sont des tailles de téléchargement de la bibliothèque Ollama, pas des besoins en VRAM. Prévoyez de la marge au-dessus pour votre fenêtre de contexte
- ✓Un modèle de six mois avec une quantization mature surpasse souvent une toute nouvelle release au support communautaire limité
Réponse rapide
Pour un usage général, qwen3.5:9b est le choix le plus solide avec 6,6 Go de téléchargement. Pour le code, qwen2.5-coder:7b à 4,7 Go fait le travail sur bien moins de matériel que ne le prétendent la plupart des guides. Pour les configurations compactes, llama3.2:3b tient dans 2,0 Go. Toutes les tailles relevées dans la bibliothèque Ollama le 28 août 2026.
- ▸Meilleur polyvalent : qwen3.5:9b — 6,6 Go
- ▸Meilleur pour le code : qwen2.5-coder:7b — 4,7 Go
- ▸Meilleur compact : llama3.2:3b — 2,0 Go
Les trois leaders par tier
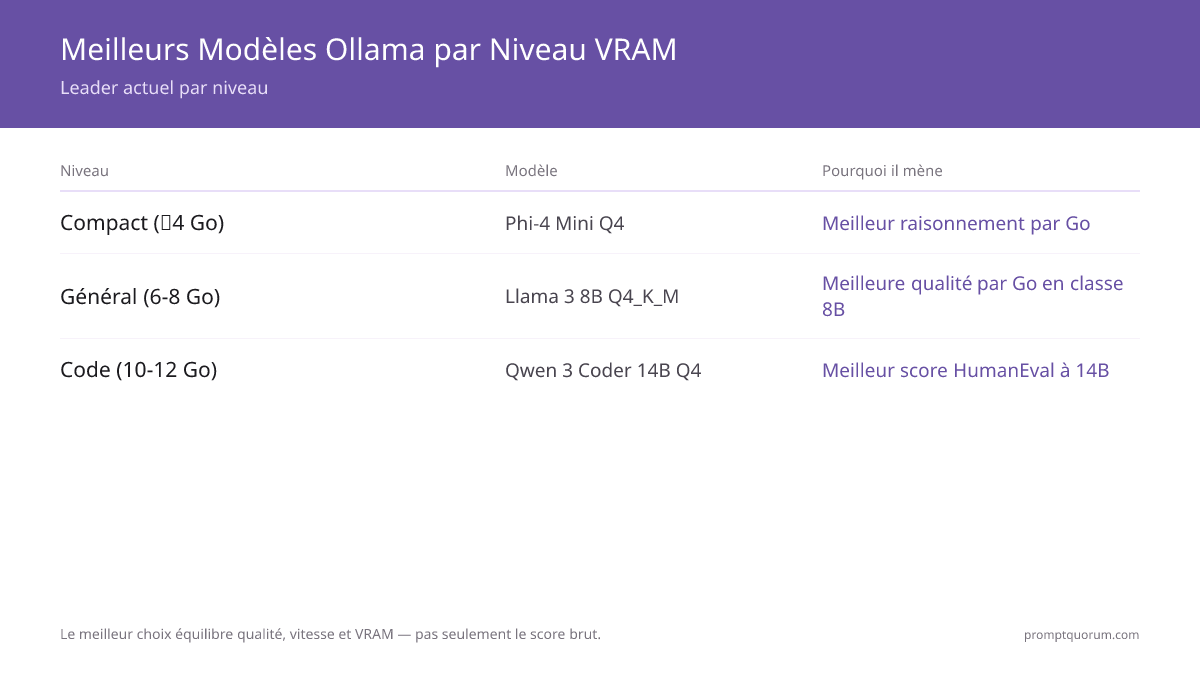
Pour un usage général, le choix actuel est qwen3.5:9b avec 6,6 Go de téléchargement. Les tailles ci-dessous ont été relevées directement dans la bibliothèque Ollama le 28 août 2026.
"Meilleur" en pratique signifie le meilleur équilibre entre qualité de sortie, vitesse d'inférence et efficacité mémoire — pas uniquement un score de benchmark brut. Un modèle 9B qui tient réellement est plus utile qu'un modèle 30B qui déborde sur le disque.
Un chiffre mérite correction : les modèles de code coûtent moins cher que ne le suggèrent la plupart des guides. qwen2.5-coder:7b pèse 4,7 Go et gère Python, TypeScript et Go sans prompting spécial. Le plus récent qwen3-coder démarre à 19 Go : c'est une tout autre classe de matériel, pas une mise à niveau directe.
| Tier | Modèle | Téléchargement | Pourquoi il est en tête |
|---|---|---|---|
| Compact | llama3.2:3b | 2,0 Go | Meilleure qualité/Go dans le bas de gamme ; 81,6 M de pulls |
| Polyvalent | qwen3.5:9b | 6,6 Go | Génération Qwen la plus récente disponible dans Ollama |
| Code | qwen2.5-coder:7b | 4,7 Go | Sortie de code solide pour une fraction de la taille de qwen3-coder |
| Raisonnement | deepseek-r1:8b | 5,2 Go | Deuxième modèle le plus téléchargé sur Ollama avec 92 M de pulls |
Quand le plus récent n'est pas le meilleur
Une nouvelle release de modèle ne devient pas automatiquement le meilleur choix Ollama. La qualité de quantization, les fine-tunes communautaires et la maturité d'intégration Ollama mettent 4–8 semaines à rattraper une nouvelle release.
Les compteurs de téléchargement le démontrent mieux que n'importe quel benchmark. llama3.1 reste le modèle le plus téléchargé de la bibliothèque avec 118,9 M de pulls, et llama3.2 atteint 81,6 M — tous deux devant chaque arrivée plus récente. Ce n'est pas de l'inertie : les gens choisissent ce dont les quantizations sont bien optimisées et le comportement prévisible.
Si vous voulez la génération récente, gemma4 (7,2 Go) et gpt-oss:20b (14 Go, contexte 128K) méritent un essai. Laissez un modèle tenir la tête 6+ semaines avant de compter dessus en production. Pour approfondir l'évaluation des modèles selon votre charge, consultez les meilleurs modèles open-source pour Ollama.
Guides associés
- ▸Meilleur VPN pour télécharger des modèles IA -- VPN for AI downloads
- ▸Modèles Ollama à contexte 128K -- long context models
- ▸Dernière version Ollama : quoi de neuf ? -- Ollama updates
- ▸Mistral Small 24B vs Qwen3 14B vs Llama 3.1 8B -- model comparison