Meilleurs modèles Ollama en mode CPU uniquement ?
Par Hans Kuepper · Fondateur de PromptQuorum · Moteur de découverte de l'IA open-weight et open source
Points clés
- ✓L'inférence CPU est 5 à 10× plus lente que sur GPU — comptez 3–6 tok/s pour un modèle 7B sur un processeur desktop 8 cœurs moderne
- ✓Le plus rapide sur CPU : Qwen3 0.6B (~35 tok/s) et Gemma 3 1B (~19 tok/s) dans un test indépendant sur un ancien portable i5
- ✓Meilleure qualité sur CPU : Phi-4 Mini Q4, environ 4 Go de RAM, ~7 tok/s dans le même test
- ✓L'inférence CPU convient au traitement par lots et aux requêtes ponctuelles ; trop lente pour le chat interactif
Réponse rapide
Le modèle Ollama CPU le plus rapide est Qwen3 0.6B (~35 tok/s dans un test indépendant) ou Gemma 3 1B (~19 tok/s). Pour la meilleure qualité de réponse sans GPU, choisissez Phi-4 Mini Q4 (~7 tok/s, environ 4 Go de RAM) ou Llama 3.2 3B Q4. Les machines avec 2 Go de RAM doivent rester à 1B de paramètres ou moins.
- ▸Le plus rapide : Qwen3 0.6B (~35 tok/s) et Gemma 3 1B (~19 tok/s), tous deux tiennent dans 2 Go de RAM
- ▸Meilleure qualité : Phi-4 Mini Q4 (~7 tok/s), nécessite environ 4 Go de RAM
- ▸Équilibré : Llama 3.2 3B Q4, téléchargement de 2,0 Go, environ 4 Go de RAM
La réalité de la vitesse CPU
L'inférence CPU tourne à 3–6 tokens par seconde sur un processeur desktop 8 cœurs moderne — soit environ 5 à 10× plus lentement qu'un GPU milieu de gamme. Un modèle 7B en Q4 produit un mot environ toutes les 200 à 300 millisecondes sur CPU.
Cette vitesse est acceptable pour deux cas d'usage : le traitement par lots nocturne (résumé de documents, classification de données) et les requêtes ponctuelles où une attente de 30 secondes est tolérable. Pour le chat interactif ou la complétion de code en temps réel, l'inférence CPU est trop lente.
La contrainte fondamentale est la bande passante mémoire, pas la fréquence CPU. Les CPU grand public lisent la RAM à 40–80 GB/s. Un GPU dédié lit la VRAM à 400–900 GB/s. L'inférence LLM est directement proportionnelle à la bande passante mémoire — c'est pourquoi même un GPU milieu de gamme surpasse largement un CPU haut de gamme.
Top 4 des modèles pour un usage CPU uniquement
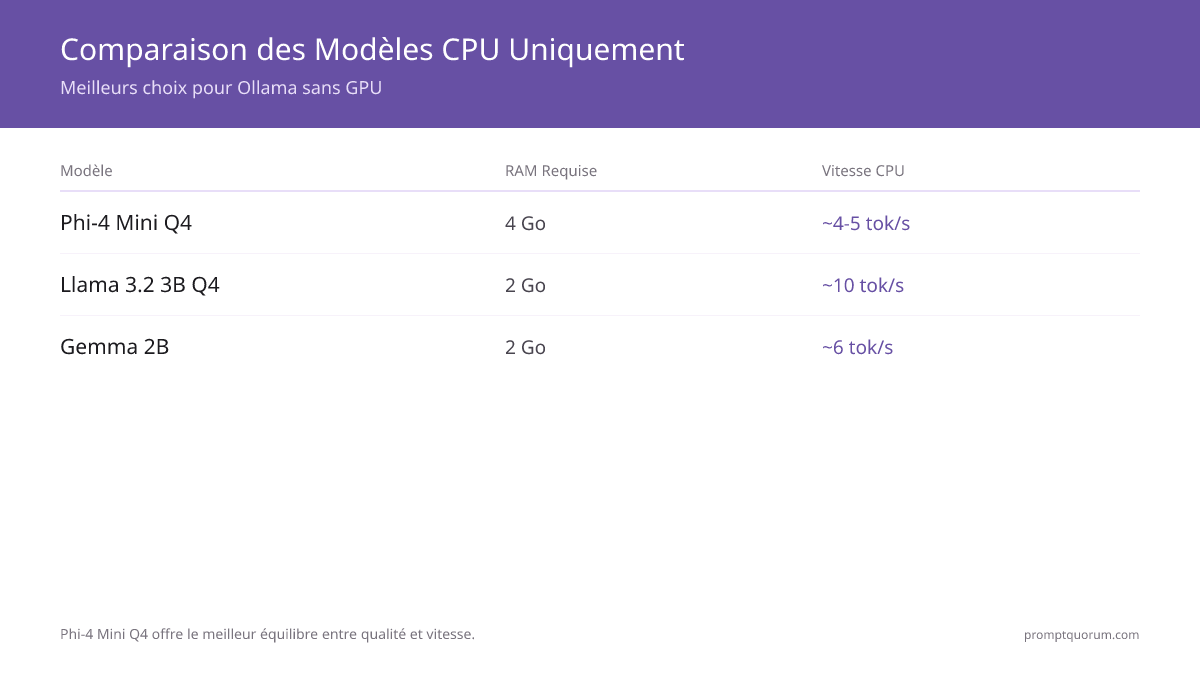
Qwen3 0.6B et Gemma 3 1B sont les modèles Ollama CPU les plus rapides ; Phi-4 Mini Q4 offre la meilleure qualité de réponse à environ 7 tok/s. Les vitesses ci-dessous proviennent d'un test CPU uniquement de It's FOSS indépendant sur un ancien portable Intel i5 avec 12 Go de RAM ; les CPU à mémoire plus rapide vont plus vite.
Gemma 3 1B (806 Mo de téléchargement) et Qwen3 0.6B (523 Mo) sont les options pratiques quand la RAM est limitée à 2 Go, au prix d'un raisonnement multi-étapes plus faible. Des modèles plus grands comme Gemma 4 E2B (4,6 Go+ de téléchargement, ~10 tok/s dans le même test) demandent plus de mémoire qu'une machine de 4 Go.
Pour la comparaison complète des configurations CPU-only incluant les exigences RAM et les optimisations système, consultez le guide des meilleurs LLMs CPU-only.
| Modèle | Téléchargement Ollama | RAM min. | Vitesse CPU |
|---|---|---|---|
| Qwen3 0.6B | 523 Mo | ~2 Go | ~34–36 tok/s |
| Gemma 3 1B | 806 Mo | ~2 Go | ~19 tok/s |
| Llama 3.2 3B Q4 | 2,0 Go | ~4 Go | Non testé |
| Phi-4 Mini Q4 | 2,5 Go | ~4 Go | ~7 tok/s |
Guides associés
- ▸Radeon 6800M pour LLM local : Guide complet -- Radeon GPU guide
- ▸Strix Halo + Ollama + Vulkan: Guide de performance -- Strix Halo guide