仅用 CPU 运行 Ollama 的最佳模型?
Hans Kuepper 作者 · PromptQuorum创始人 · 开放权重与开源AI发现引擎
关键要点
- ✓CPU推理比GPU慢5–10倍——现代8核台式机CPU上运行7B模型约为3–6 tok/s
- ✓CPU上最快:Qwen3 0.6B(约35 tok/s)和Gemma 3 1B(约19 tok/s),来自旧款i5笔记本的独立测试
- ✓CPU上质量最佳:Phi-4 Mini Q4,约需4 GB内存,同一测试中约7 tok/s
- ✓CPU 推理适合批量处理和单次查询;对于交互式对话速度太慢
快速回答
纯CPU运行最快的Ollama模型是Qwen3 0.6B(独立测试中约35 tok/s)或Gemma 3 1B(约19 tok/s)。无GPU时若要最佳回答质量,请选择Phi-4 Mini Q4(约7 tok/s,约需4 GB内存)或Llama 3.2 3B Q4。内存仅2 GB的设备应使用1B参数及以下的模型。
- ▸最快:Qwen3 0.6B(约35 tok/s)和Gemma 3 1B(约19 tok/s),均可在2 GB内存内运行
- ▸质量最佳:Phi-4 Mini Q4(约7 tok/s),约需4 GB内存
- ▸均衡:Llama 3.2 3B Q4,下载2.0 GB,约需4 GB内存
CPU 速度的实际情况
CPU 推理在现代 8 核台式机 CPU 上运行速度为每秒 3–6 个 token——大约比中端 GPU 慢 5–10 倍。 Q4 量化的 7B 模型在 CPU 上大约每 200–300 毫秒生成一个词。
这种速度适用于两种场景:隔夜批量处理(如文档摘要或数据分类),以及可以接受 30 秒等待的单次查询。对于交互式对话或实时代码补全,CPU 推理速度太慢,不具备实用性。
根本瓶颈在于内存带宽,而非 CPU 时钟频率。消费级 CPU 读取内存的速度为 40–80 GB/s,专用 GPU 读取 VRAM 的速度为 400–900 GB/s。LLM 推理直接随内存带宽扩展——这就是为什么即使是中端 GPU 也比高端 CPU 快得多。
纯CPU使用的前4款模型
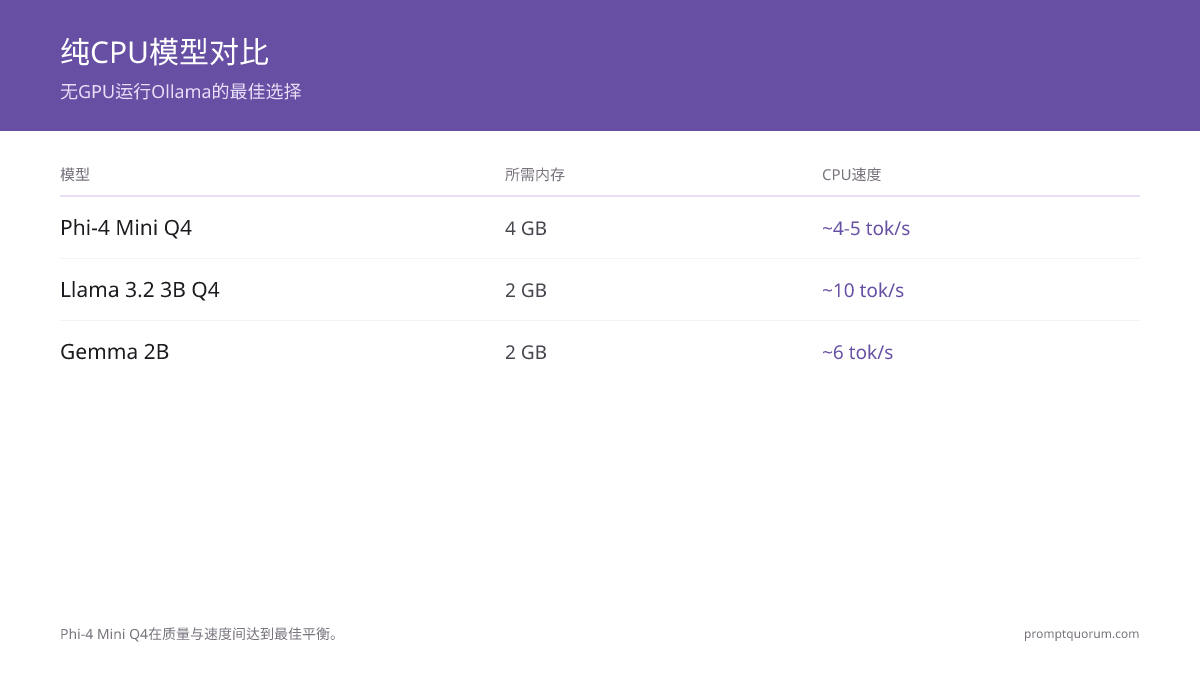
Qwen3 0.6B和Gemma 3 1B是纯CPU运行最快的Ollama模型;Phi-4 Mini Q4以约7 tok/s提供最佳回答质量。以下速度来自在12 GB内存的旧款Intel i5笔记本上进行的独立It's FOSS纯CPU测试;内存更快的CPU速度更高。
当内存限制为2 GB时,Gemma 3 1B(下载806 MB)和Qwen3 0.6B(523 MB)是可行的选择,代价是多步推理能力较弱。Gemma 4 E2B(下载4.6 GB以上,同一测试中约10 tok/s)等更大的模型所需内存超过4 GB设备所能提供的。
有关纯 CPU 配置的完整对比(包括内存需求和系统级优化),请参阅最佳纯 CPU LLM 指南。
| 模型 | Ollama下载大小 | 最低内存 | CPU速度 |
|---|---|---|---|
| Qwen3 0.6B | 523 MB | 约2 GB | 约34–36 tok/s |
| Gemma 3 1B | 806 MB | 约2 GB | 约19 tok/s |
| Llama 3.2 3B Q4 | 2.0 GB | 约4 GB | 未测试 |
| Phi-4 Mini Q4 | 2.5 GB | 约4 GB | 约7 tok/s |
相关指南
- ▸Radeon 6800M本地LLM:完整设置指南 -- Radeon GPU guide
- ▸Strix Halo + Ollama + Vulkan: 性能指南 -- Strix Halo guide