CPU 전용 최고의 Ollama 모델은 무엇입니까?
빠른 답변
CPU 전용에서 가장 빠른 Ollama 모델은 Qwen3 0.6B(독립 테스트 기준 ~35 tok/s) 또는 Gemma 3 1B(~19 tok/s)입니다. GPU 없이 최고의 답변 품질을 원하면 Phi-4 Mini Q4(~7 tok/s, RAM 약 4 GB) 또는 Llama 3.2 3B Q4를 사용하십시오. RAM 2 GB 기기는 1B 파라미터 이하 모델을 사용해야 합니다.
- ▸최고 속도: Qwen3 0.6B(~35 tok/s)와 Gemma 3 1B(~19 tok/s), 둘 다 RAM 2 GB에 들어갑니다
- ▸최고 품질: Phi-4 Mini Q4(~7 tok/s), RAM 약 4 GB 필요
- ▸균형형: Llama 3.2 3B Q4, 다운로드 2.0 GB, RAM 약 4 GB
핵심 요점
- ✓CPU 추론은 GPU보다 5~10배 느립니다 — 최신 8코어 데스크톱 CPU에서 7B 모델은 3~6 tok/s를 예상하십시오
- ✓CPU에서 가장 빠름: Qwen3 0.6B(~35 tok/s)와 Gemma 3 1B(~19 tok/s), 오래된 i5 노트북의 독립 테스트 기준
- ✓CPU에서 최고 품질: Phi-4 Mini Q4, RAM 약 4 GB, 같은 테스트에서 ~7 tok/s
- ✓CPU 추론은 배치 작업과 단일 쿼리에 실용적이며, 대화형 채팅에는 너무 느립니다
CPU 속도의 현실
CPU 추론은 최신 8코어 데스크톱 CPU에서 초당 3~6개 토큰으로 동작하며 — 중급 GPU보다 약 5~10배 느립니다. Q4 수준의 7B 모델은 CPU에서 약 200~300밀리초마다 단어 하나를 생성합니다.
이 속도는 두 가지 사용 사례에서 허용 가능합니다: 문서 요약이나 데이터 분류와 같은 야간 배치 처리, 그리고 30초 대기를 허용할 수 있는 단일 쿼리 조회입니다. 대화형 채팅이나 실시간 코드 자동 완성에는 CPU 추론이 너무 느려 실용적이지 않습니다.
근본적인 제약은 CPU 클록 속도가 아니라 메모리 대역폭입니다. 소비자용 CPU는 RAM을 40~80 GB/s로 읽습니다. 전용 GPU는 VRAM을 400~900 GB/s로 읽습니다. LLM 추론은 메모리 대역폭에 직접 비례하므로, 중급 GPU조차 고급 CPU보다 훨씬 빠른 추론을 제공합니다.
📍 한 문장으로
CPU 추론은 최신 8코어 데스크톱 CPU에서 초당 3~6개 토큰으로 동작하며, GPU보다 약 5~10배 느립니다.
💬 쉽게 설명하면
GPU가 없으면 Ollama는 RAM에서 직접 모델 데이터를 읽어 CPU로 처리합니다. 소비자용 CPU의 메모리 대역폭은 GPU의 약 10분의 1 수준이므로 토큰 생성 속도가 현저히 낮습니다.
CPU 전용 사용을 위한 상위 4개 모델
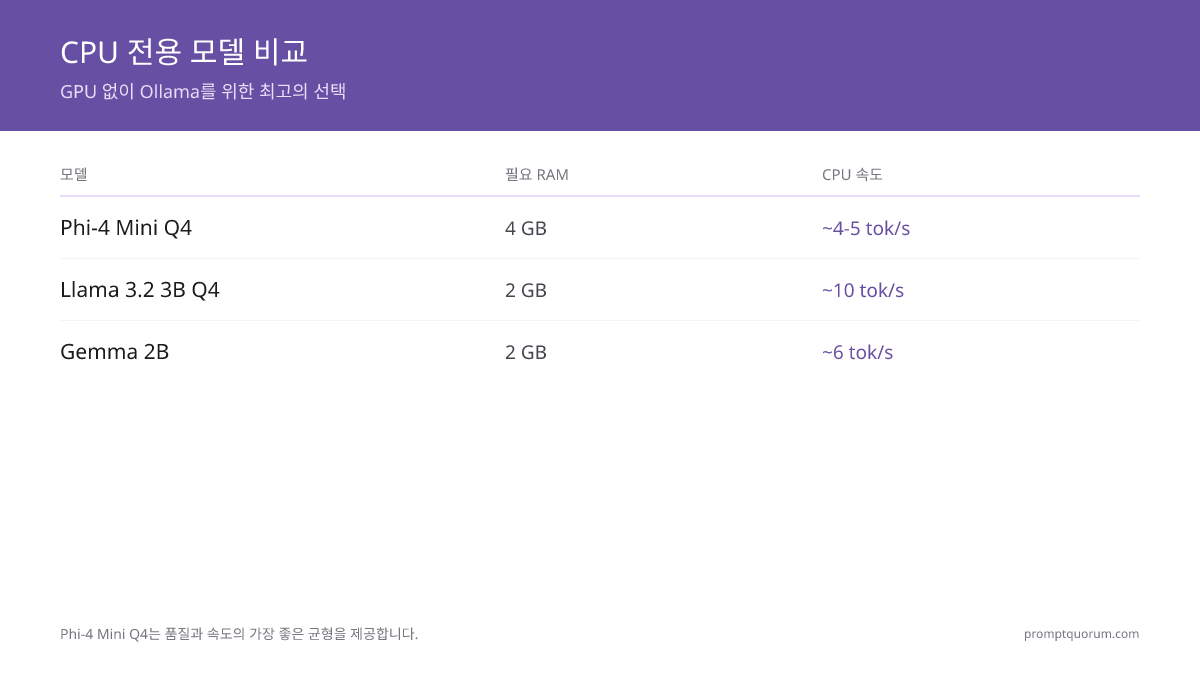
Qwen3 0.6B와 Gemma 3 1B는 CPU 전용에서 가장 빠른 Ollama 모델이며, Phi-4 Mini Q4는 약 7 tok/s로 최고의 답변 품질을 제공합니다. 아래 속도는 RAM 12 GB의 오래된 Intel i5 노트북에서 진행한 독립 It's FOSS CPU 전용 테스트에서 가져온 것이며, 메모리가 더 빠른 CPU는 더 빠르게 동작합니다.
RAM이 2 GB로 제한될 때는 Gemma 3 1B(다운로드 806 MB)와 Qwen3 0.6B(523 MB)가 현실적인 선택이지만 다단계 추론 능력은 떨어집니다. Gemma 4 E2B(다운로드 4.6 GB 이상, 같은 테스트에서 ~10 tok/s) 같은 대형 모델은 4 GB 기기가 제공하는 것보다 많은 메모리가 필요합니다.
RAM 요구 사항 및 OS 수준 최적화를 포함한 CPU 전용 구성의 전체 비교는 CPU 전용 최고의 LLM 가이드를 참조하십시오.
| 모델 | Ollama 다운로드 | 최소 RAM | CPU 속도 |
|---|---|---|---|
| Qwen3 0.6B | 523 MB | ~2 GB | ~34–36 tok/s |
| Gemma 3 1B | 806 MB | ~2 GB | ~19 tok/s |
| Llama 3.2 3B Q4 | 2.0 GB | ~4 GB | 미테스트 |
| Phi-4 Mini Q4 | 2.5 GB | ~4 GB | ~7 tok/s |
관련 가이드
- ▸Radeon 6800M 로컬 LLM: 완전 설정 가이드 -- Radeon GPU guide
- ▸Strix Halo + Ollama + Vulkan: 성능 가이드 -- Strix Halo guide