지금 최고의 Ollama 모델은?
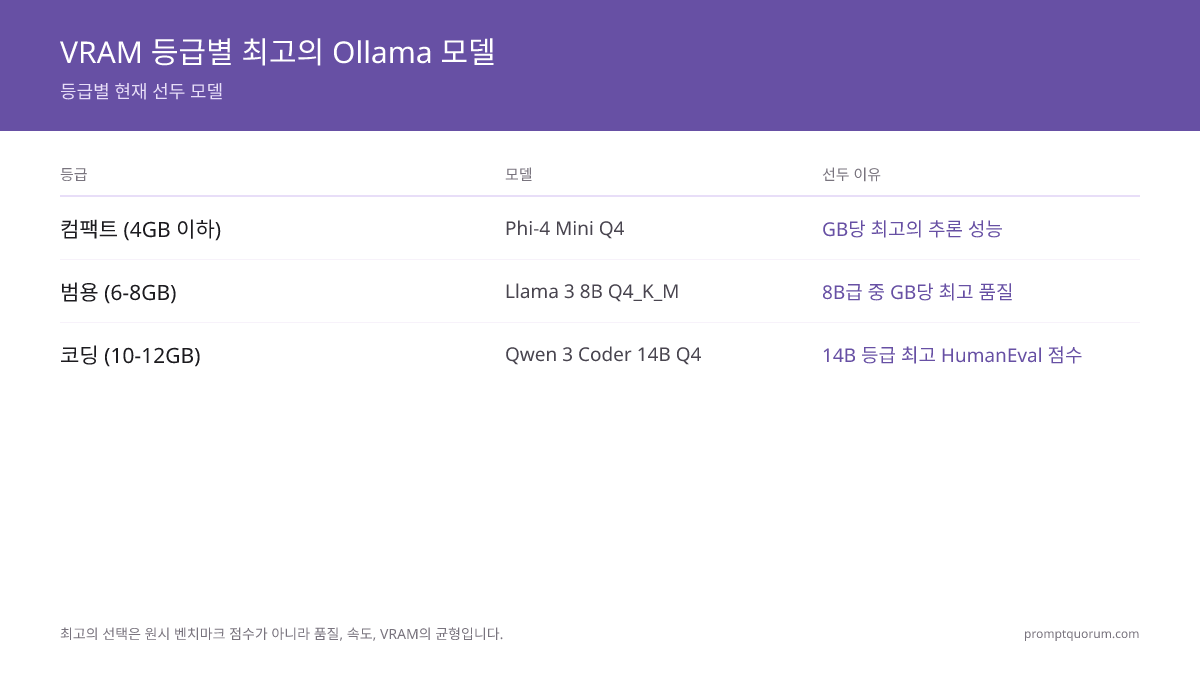
빠른 답변
범용으로는 다운로드 6.6 GB의 qwen3.5:9b가 현재 가장 강력한 선택입니다. 코딩에는 4.7 GB의 qwen2.5-coder:7b가 대부분의 가이드가 주장하는 것보다 훨씬 적은 하드웨어로 제 몫을 합니다. 경량 구성에는 llama3.2:3b가 2.0 GB로 동작합니다. 모든 용량은 2026년 8월 28일 Ollama 라이브러리에서 확인했습니다.
- ▸범용 최강: qwen3.5:9b — 6.6 GB
- ▸코딩 최강: qwen2.5-coder:7b — 4.7 GB
- ▸경량 최강: llama3.2:3b — 2.0 GB
핵심 요점
- ✓범용 최강: qwen3.5:9b — 다운로드 6.6 GB, Ollama에서 실제로 받을 수 있는 가장 최신 Qwen 세대
- ✓코딩 최강: qwen2.5-coder:7b — 4.7 GB. qwen3-coder가 19 GB부터 시작하므로 가성비 선택
- ✓경량 최강: llama3.2:3b — 2.0 GB, 추론 과정을 보고 싶다면 deepseek-r1:1.5b(1.1 GB)
- ✓어떤 숫자를 비교하는지 유의하세요. 이것은 Ollama 라이브러리의 다운로드 용량이지 VRAM 요구치가 아닙니다. 컨텍스트 창을 위해 다운로드 용량보다 여유를 두세요
- ✓양자화가 성숙한 6개월 전 모델이 커뮤니티 지원이 제한된 최신 출시 모델보다 나은 경우가 많습니다
단계별 3대 선두 모델
범용으로는 다운로드 6.6 GB의 qwen3.5:9b가 현재 선택입니다. 아래 용량은 2026년 8월 28일 Ollama 라이브러리에서 직접 확인했습니다.
실제 "최강"이란 출력 품질, 추론 속도, 메모리 효율의 최적 균형을 의미합니다 — 단순히 벤치마크 점수가 높은 것이 아닙니다. 실제로 올라가는 9B 모델이 디스크로 넘치는 30B 모델보다 유용합니다.
바로잡아야 할 숫자가 하나 있습니다. 코딩 모델은 대부분의 가이드가 시사하는 것보다 저렴합니다. qwen2.5-coder:7b는 다운로드 4.7 GB이며 특별한 프롬프트 없이 Python, TypeScript, Go를 처리합니다. 더 최신인 qwen3-coder는 19 GB부터 시작하므로, 손쉬운 업그레이드가 아니라 아예 다른 하드웨어 등급입니다.
| 단계 | 모델 | 다운로드 | 선두 이유 |
|---|---|---|---|
| 경량 | llama3.2:3b | 2.0 GB | 소형 구간에서 GB당 품질 최고; 8,160만 다운로드 |
| 범용 | qwen3.5:9b | 6.6 GB | Ollama에서 받을 수 있는 최신 Qwen 세대 |
| 코딩 | qwen2.5-coder:7b | 4.7 GB | qwen3-coder의 일부 용량으로 강력한 코딩 출력 |
| 추론 | deepseek-r1:8b | 5.2 GB | 9,200만 다운로드로 Ollama 전체 2위 |
📍 한 문장으로
범용 Ollama 모델은 다운로드 6.6 GB의 qwen3.5:9b, 코딩은 4.7 GB의 qwen2.5-coder:7b, 경량은 2.0 GB의 llama3.2:3b가 현재 선두입니다.
💬 쉽게 설명하면
Ollama는 로컬에서 LLM을 실행하는 도구입니다. 여기 적힌 GB 수치는 모델을 내려받을 때의 파일 크기이며, 그래픽카드 메모리 요구치와는 다릅니다.
최신 모델이 항상 최고는 아닙니다
새 모델 출시가 자동으로 Ollama 최고의 선택이 되는 것은 아닙니다. 양자화 품질, 커뮤니티 파인튜닝, Ollama 통합 성숙도가 최신 출시 모델을 따라잡는 데 4–8주가 걸립니다.
다운로드 수가 어떤 벤치마크보다 이를 잘 보여줍니다. llama3.1은 1억 1,890만 다운로드로 여전히 라이브러리에서 가장 많이 받은 모델이고, llama3.2는 8,160만으로 그 뒤를 잇습니다 — 둘 다 이후 등장한 모든 모델보다 앞섭니다. 관성이 아니라, 양자화가 잘 최적화되고 하드웨어를 넘나들며 동작이 예측 가능한 쪽을 고르는 것입니다.
최신 세대를 원한다면 gemma4(7.2 GB)와 gpt-oss:20b(14 GB, 128K 컨텍스트)를 살펴볼 만합니다. 프로덕션에서 의존하기 전에 6주 이상 선두를 유지하는지 지켜보세요. 특정 워크로드에 맞는 모델 평가 방법은 Ollama용 최고 오픈소스 모델을 참조하십시오.
관련 읽기
- ▸Ollama용 최고 오픈소스 모델
- ▸CPU 전용 최고 Ollama 모델
- ▸Ollama 최신 버전
- ▸AI 모델 다운로드를 위한 최고의 VPN -- VPN for AI downloads
- ▸Ollama 128K 컨텍스트 모델 -- long context models
- ▸Mistral Small 24B vs Qwen 3 14B vs Llama 3.1 8B -- model comparison