Die besten Ollama-Modelle im Moment?
Schnelle Antwort
Für den allgemeinen Gebrauch ist qwen3.5:9b mit 6,6 GB Download die derzeit stärkste Wahl. Für Coding erledigt qwen2.5-coder:7b mit 4,7 GB die Arbeit auf deutlich weniger Hardware, als die meisten Ratgeber behaupten. Für kompakte Setups läuft llama3.2:3b in 2,0 GB. Alle Größen am 28. August 2026 aus der Ollama-Bibliothek gelesen.
- ▸Bestes allgemeines Modell: qwen3.5:9b — 6,6 GB
- ▸Bestes Coding-Modell: qwen2.5-coder:7b — 4,7 GB
- ▸Bestes kompaktes Modell: llama3.2:3b — 2,0 GB
Wichtigste Punkte
- ✓Beste Allzwecknutzung: qwen3.5:9b — 6,6 GB Download, die neueste Qwen-Generation, die in Ollama tatsächlich verfügbar ist
- ✓Bestes Coding: qwen2.5-coder:7b — 4,7 GB, und die Preis-Leistungs-Wahl, denn qwen3-coder beginnt erst bei 19 GB
- ✓Bestes kompaktes Modell: llama3.2:3b — 2,0 GB, oder deepseek-r1:1.5b mit 1,1 GB, wenn Sie Reasoning-Spuren wollen
- ✓Achten Sie darauf, welche Zahl Sie vergleichen: Dies sind Download-Größen aus der Ollama-Bibliothek, keine VRAM-Anforderungen. Planen Sie über der Download-Größe Reserve für Ihr Kontextfenster ein
- ✓Ein Modell von vor sechs Monaten mit ausgereifter Quantisierung übertrifft oft ein brandneues Release mit begrenzter Community-Unterstützung
Die drei Tier-Spitzenreiter
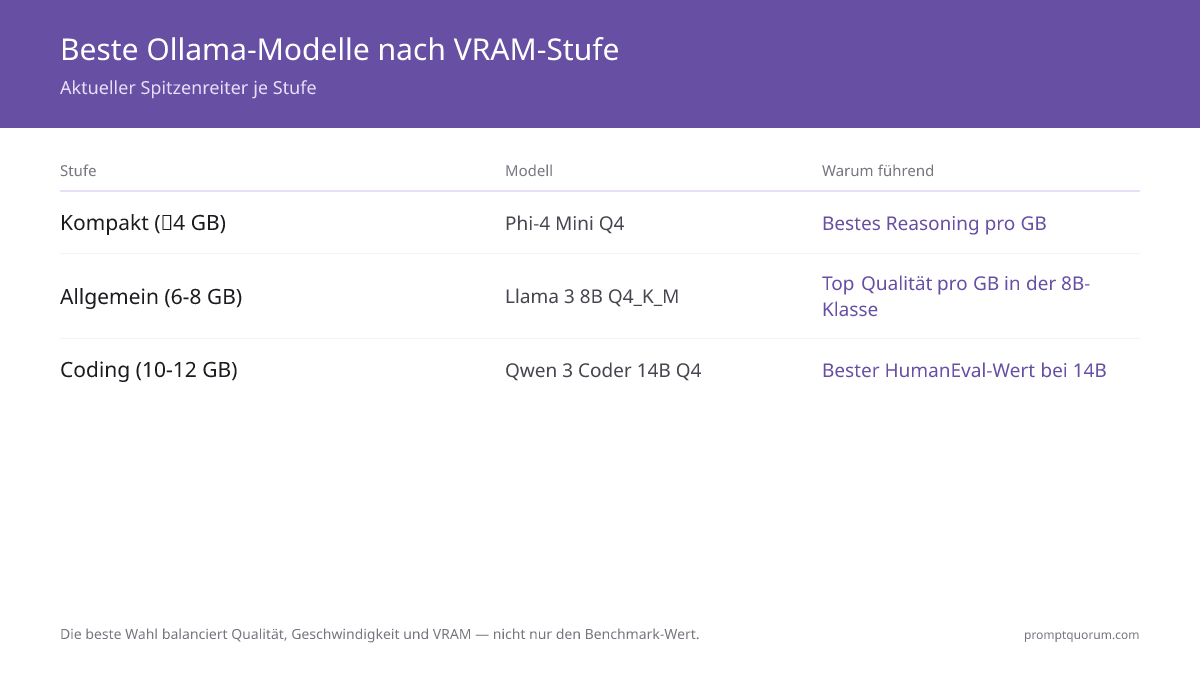
Für den allgemeinen Gebrauch ist qwen3.5:9b mit 6,6 GB Download die aktuelle Wahl. Die Größen unten wurden am 28. August 2026 direkt aus der Ollama-Bibliothek gelesen.
"Bestes" bedeutet in der Praxis die höchste Balance aus Ausgabequalität, Inferenzgeschwindigkeit und Speichereffizienz — nicht allein ein roher Benchmark-Score. Ein 9B-Modell, das tatsächlich hineinpasst, ist nützlicher als ein 30B-Modell, das auf die Festplatte auslagert.
Eine Zahl gehört korrigiert: Coding-Modelle sind günstiger, als die meisten Ratgeber nahelegen. qwen2.5-coder:7b ist ein 4,7-GB-Download und bearbeitet Python, TypeScript und Go ohne spezielles Prompting. Das neuere qwen3-coder beginnt bei 19 GB und ist damit eine ganz andere Hardwareklasse, kein einfaches Upgrade.
| Tier | Modell | Download | Warum führend |
|---|---|---|---|
| Kompakt | llama3.2:3b | 2,0 GB | Beste Qualität-pro-GB am unteren Ende; 81,6 Mio. Pulls |
| Allgemein | qwen3.5:9b | 6,6 GB | Neueste in Ollama verfügbare Qwen-Generation |
| Coding | qwen2.5-coder:7b | 4,7 GB | Starke Coding-Ausgabe bei einem Bruchteil der qwen3-coder-Größe |
| Reasoning | deepseek-r1:8b | 5,2 GB | Zweitmeistgeladenes Modell auf Ollama mit 92 Mio. Pulls |
Wenn Neuer Nicht Besser Ist
Ein neues Modell-Release wird nicht automatisch zur besten Ollama-Wahl. Quantisierungsqualität, Community-Fine-Tunes und Ollama-Integrationsreife brauchen 4–8 Wochen, um mit einem frischen Release Schritt zu halten.
Die Pull-Zahlen belegen das besser als jeder Benchmark. llama3.1 ist mit 118,9 Mio. Pulls weiterhin das meistgeladene Modell der Bibliothek, llama3.2 liegt bei 81,6 Mio. — beide vor jedem neueren Zugang. Das ist keine Trägheit, sondern die Wahl dessen, dessen Quantisierungen gut optimiert und dessen Verhalten über Hardware hinweg vorhersagbar ist.
Wenn Sie die neuere Generation wollen, lohnen sich gemma4 (7,2 GB) und gpt-oss:20b (14 GB, 128K Kontext). Geben Sie einem Modell 6+ Wochen an der Spitze, bevor Sie im Produktivbetrieb darauf bauen. Für einen tieferen Einblick in die Modellbewertung für Ihre Arbeitslast lesen Sie die Top-Open-Source-Modelle für Ollama.
Verwandte Leitfäden
- ▸Bestes VPN zum Herunterladen von KI-Modellen -- VPN for AI downloads
- ▸Ollama 128K-Kontext-Modelle -- long context models
- ▸Ollama neueste Version: Was ist neu? -- Ollama updates
- ▸Mistral Small 24B vs Qwen 3 14B vs Llama 3.1 8B -- model comparison