Mistral Small 24B مقابل Qwen3 14B مقابل Llama 3.1 8B: أيهما تشغّل محلياً؟
إجابة سريعة
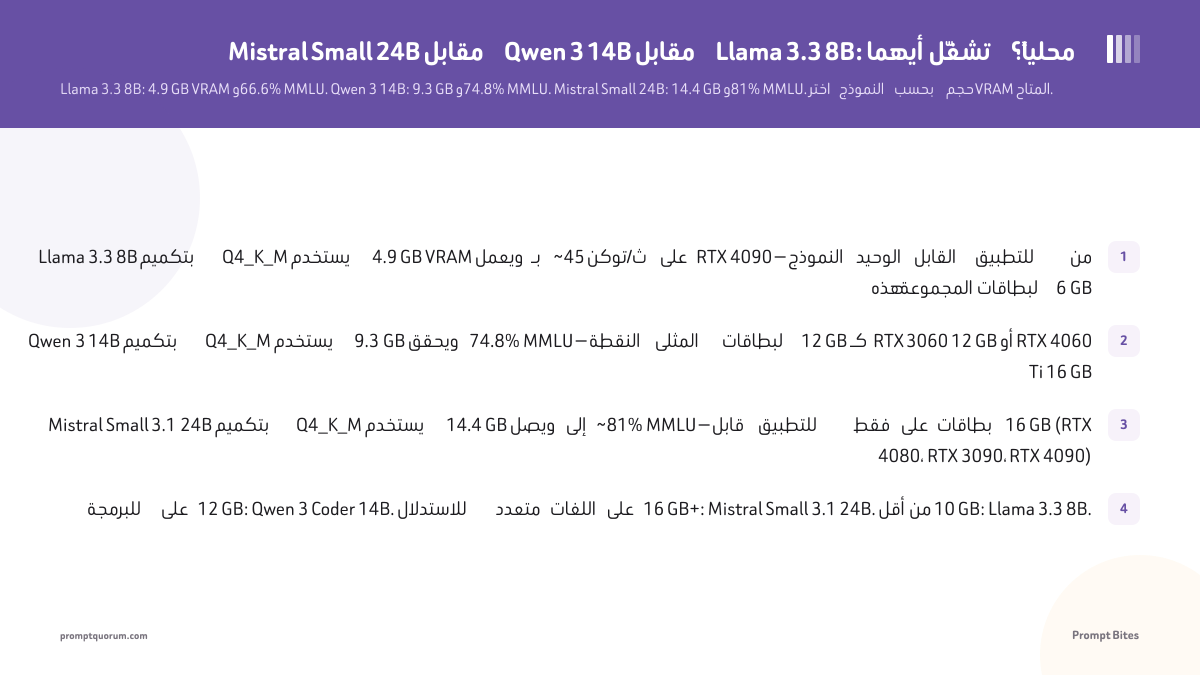
اختر حسب VRAM: Llama 3.1 8B (4.9 GB)، Qwen3 14B (9.3 GB)، Mistral Small 3.1 24B (14.4 GB). Qwen 14B يتفوق بـ 12 GB من VRAM. Mistral Small 24B يتفوق فوق 16 GB في مهام الاستدلال.
- ▸Llama 3.1 8B Q4_K_M: 4.9 GB VRAM، ~45 توكن/ث على RTX 4090، MMLU 66.6% — الأفضل لبطاقات 6–8 GB
- ▸Qwen3 14B Q4_K_M: 9.3 GB VRAM، ~28 توكن/ث، MMLU 74.8% — النقطة المثلى لبطاقات 12 GB
- ▸Mistral Small 3.1 24B Q4_K_M: 14.4 GB VRAM، ~20 توكن/ث، MMLU ~81% — لبطاقات 16 GB فما فوق فقط
النقاط الرئيسية
- ✓Llama 3.1 8B بتكميم Q4_K_M يستخدم 4.9 GB VRAM ويعمل بـ ~45 توكن/ث على RTX 4090 — النموذج الوحيد القابل للتطبيق من هذه المجموعة لبطاقات 6 GB
- ✓Qwen3 14B بتكميم Q4_K_M يستخدم 9.3 GB ويحقق 74.8% MMLU — النقطة المثلى لبطاقات 12 GB كـ RTX 3060 12 GB أو RTX 4060 Ti 16 GB
- ✓Mistral Small 3.1 24B بتكميم Q4_K_M يستخدم 14.4 GB ويصل إلى ~81% MMLU — قابل للتطبيق فقط على بطاقات 16 GB (RTX 4080، RTX 3090، RTX 4090)
- ✓للبرمجة على 12 GB: Qwen2.5-Coder 14B. للاستدلال متعدد اللغات على 16 GB+: Mistral Small 3.1 24B. أقل من 10 GB: Llama 3.1 8B.
متطلبات VRAM: أي بطاقة تشغّل أي نموذج
الاختيار بين هذه النماذج الثلاثة هو في الأساس قرار VRAM. عند تكميم Q4_K_M: Llama 3.1 8B يستخدم 4.9 GB، Qwen3 14B يستخدم 9.3 GB، وMistral Small 3.1 24B يستخدم 14.4 GB. هذا يتوافق مباشرةً مع ثلاثة مستويات من GPU: بطاقات 6–8 GB (Llama 3.1 8B فقط)، بطاقات 10–12 GB (Qwen3 14B)، وبطاقات 16+ GB (Mistral Small 24B).
السرعة على RTX 4090 بتكميم Q4_K_M: Llama 3.1 8B يعمل بـ ~45 توكن/ث، Qwen3 14B بـ ~28 توكن/ث، وMistral Small 3.1 24B بـ ~20 توكن/ث. على RTX 3060 12 GB، يتسع فقط Llama 3.1 8B وQwen3 14B — Mistral Small 24B يحتاج على الأقل بطاقة 16 GB لتجنب نقل الأحمال إلى RAM وحدة المعالجة.
الفرق في المعايير القياسية كبير: 81% MMLU لـ Mistral Small 24B يتفوق بـ 14 نقطة على Llama 3.1 8B وبـ 6 نقاط على Qwen3 14B. في مهام الاستدلال متعدد الخطوات المعقدة واتباع التعليمات، هذا الفارق ملحوظ عملياً.
| النموذج | VRAM (Q4_K_M) | السرعة (RTX 4090) | MMLU | الحد الأدنى للـ GPU |
|---|---|---|---|---|
| Llama 3.1 8B | 4.9 GB | ~45 توكن/ث | 66.6% | RTX 3060 6 GB |
| Qwen3 14B | 9.3 GB | ~28 توكن/ث | 74.8% | RTX 3060 12 GB |
| Mistral Small 3.1 24B | 14.4 GB | ~20 توكن/ث | ~81% | RTX 4080 16 GB |
الجودة مقابل VRAM: متى يتفوق كل نموذج
Llama 3.1 8B يتفوق في كفاءة VRAM. بـ 4.9 GB Q4_K_M هو النموذج الوحيد من هذه المجموعة الذي يتسع في بطاقة 6 GB مع هامش لنافذة سياق 4k توكن. يحقق 66.6% في MMLU ويوفر استجابات تفاعلية سريعة (~45 توكن/ث على RTX 4090). للمحادثة واستفسارات البرمجة السريعة والاستخدام اليومي على الأجهزة المحدودة، هو الاختيار الصحيح.
Qwen3 14B يتفوق بـ 12 GB VRAM. 74.8% MMLU يضعه فوق Llama 3.1 8B في الاستدلال والبرمجة — ويتسع في أكثر مستويات GPU شيوعاً للمحترفين. نسخة Qwen Coder 14B (نفس الحجم، محسّنة للكود) تحقق ~78% في HumanEval.
Mistral Small 3.1 24B يتفوق في الجودة عندما يسمح VRAM بذلك. 81% MMLU وأداء متعدد اللغات القوي يجعلانه الخيار الأفضل لبطاقات 16 GB. يتعامل مع الاستدلال الطويل ومهام الإخراج المنظم ومجموعات التعليمات المعقدة بشكل أكثر موثوقية من نماذج فئة 14B.
للمقارنة المباشرة لفئة 14B راجع مقارنة Qwen 14B مقابل Llama 8B، التي تتضمن تفاصيل معايير البرمجة.