Mistral Small 24B vs Qwen3 14B vs Llama 3.1 8B: ¿cuál ejecutar en local?
Respuesta rápida
Elige según el VRAM: Llama 3.1 8B (4.9 GB), Qwen3 14B (9.3 GB), Mistral Small 3.1 24B (14.4 GB). Qwen 14B gana con 12 GB de VRAM. Mistral Small 24B gana por encima de 16 GB en tareas de razonamiento.
- ▸Llama 3.1 8B Q4_K_M: 4.9 GB VRAM, ~45 tok/s en RTX 4090, MMLU 66.6% — mejor para tarjetas de 6–8 GB
- ▸Qwen3 14B Q4_K_M: 9.3 GB VRAM, ~28 tok/s, MMLU 74.8% — punto ideal para tarjetas de 12 GB
- ▸Mistral Small 3.1 24B Q4_K_M: 14.4 GB VRAM, ~20 tok/s, MMLU ~81% — solo para tarjetas de 16 GB o más
Puntos clave
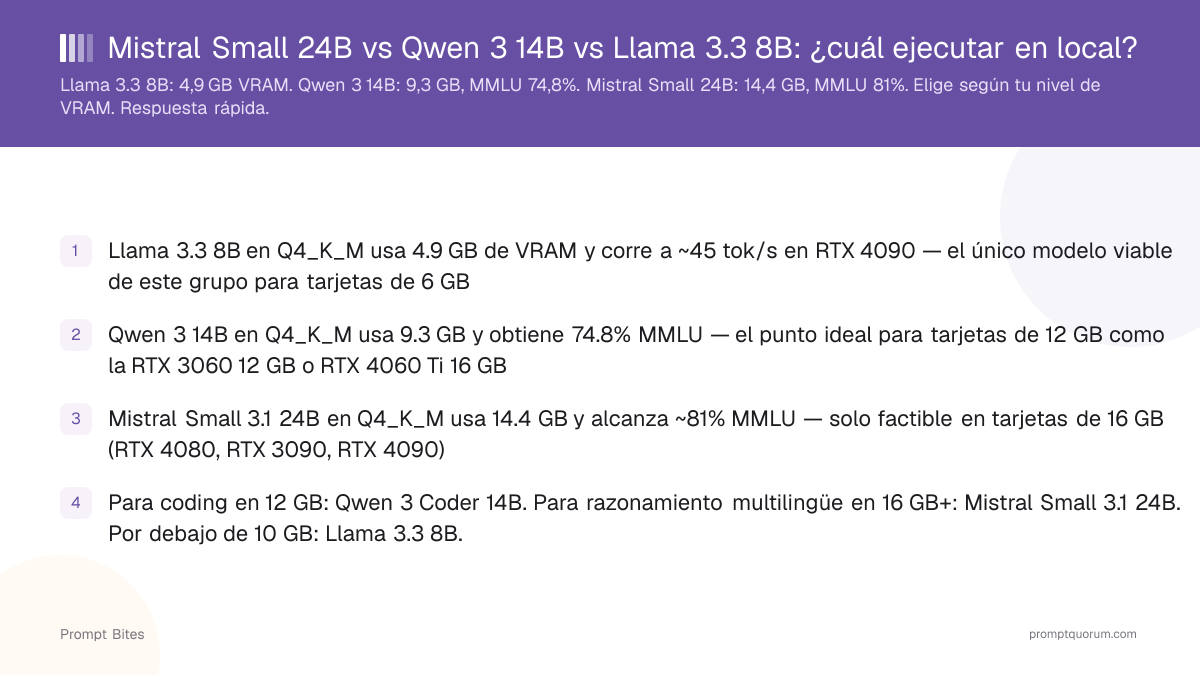
- ✓Llama 3.1 8B en Q4_K_M usa 4.9 GB de VRAM y corre a ~45 tok/s en RTX 4090 — el único modelo viable de este grupo para tarjetas de 6 GB
- ✓Qwen3 14B en Q4_K_M usa 9.3 GB y obtiene 74.8% MMLU — el punto ideal para tarjetas de 12 GB como la RTX 3060 12 GB o RTX 4060 Ti 16 GB
- ✓Mistral Small 3.1 24B en Q4_K_M usa 14.4 GB y alcanza ~81% MMLU — solo factible en tarjetas de 16 GB (RTX 4080, RTX 3090, RTX 4090)
- ✓Para coding en 12 GB: Qwen2.5-Coder 14B. Para razonamiento multilingüe en 16 GB+: Mistral Small 3.1 24B. Por debajo de 10 GB: Llama 3.1 8B.
Requisitos de VRAM: qué tarjeta ejecuta qué modelo
La elección entre estos tres modelos es principalmente una decisión de VRAM. En cuantización Q4_K_M: Llama 3.1 8B usa 4.9 GB, Qwen3 14B usa 9.3 GB y Mistral Small 3.1 24B usa 14.4 GB. Esto se corresponde directamente con tres niveles de GPU: tarjetas de 6–8 GB (solo Llama 3.1 8B), tarjetas de 10–12 GB (Qwen3 14B) y tarjetas de 16+ GB (Mistral Small 24B).
Velocidad en RTX 4090 en Q4_K_M: Llama 3.1 8B corre a aproximadamente 45 tok/s, Qwen3 14B a ~28 tok/s y Mistral Small 3.1 24B a ~20 tok/s. En una RTX 3060 12 GB, solo caben Llama 3.1 8B y Qwen3 14B — Mistral Small 24B necesita como mínimo una tarjeta de 16 GB para evitar volcar a la RAM de la CPU.
La diferencia en benchmarks es significativa: el 81% MMLU de Mistral Small 24B supera en 14 puntos a Llama 3.1 8B y en 6 puntos a Qwen3 14B. En tareas complejas de razonamiento multi-paso y seguimiento de instrucciones, esta diferencia es notable en la práctica.
| Modelo | VRAM (Q4_K_M) | Velocidad (RTX 4090) | MMLU | GPU mínima |
|---|---|---|---|---|
| Llama 3.1 8B | 4.9 GB | ~45 tok/s | 66.6% | RTX 3060 6 GB |
| Qwen3 14B | 9.3 GB | ~28 tok/s | 74.8% | RTX 3060 12 GB |
| Mistral Small 3.1 24B | 14.4 GB | ~20 tok/s | ~81% | RTX 4080 16 GB |
Calidad vs VRAM: cuándo gana cada modelo
Llama 3.1 8B gana en eficiencia de VRAM. Con 4.9 GB Q4_K_M es el único modelo de este grupo que cabe en una tarjeta de 6 GB con margen para una ventana de contexto de 4k tokens. Obtiene 66.6% en MMLU y ofrece respuestas interactivas rápidas (~45 tok/s en RTX 4090). Para chat, consultas rápidas de coding y uso diario en hardware limitado, es la elección correcta.
Qwen3 14B gana con 12 GB de VRAM. Su 74.8% MMLU lo sitúa muy por encima de Llama 3.1 8B en razonamiento y coding — y cabe en el nivel de GPU prosumer más común. La variante Qwen Coder 14B (mismo tamaño, optimizada para código) obtiene aproximadamente 78% en HumanEval. Si tu uso principal es el coding y tienes una tarjeta de 12 GB, Qwen3 14B es la respuesta.
Mistral Small 3.1 24B gana en calidad cuando el VRAM lo permite. Su 81% MMLU y sólido rendimiento multilingüe lo convierten en la mejor opción para tarjetas de 16 GB. Gestiona razonamiento de forma larga, tareas de salida estructurada y conjuntos de instrucciones complejos de forma más fiable que los modelos de clase 14B. En una RTX 4090 24 GB cabe en Q5_K_M para incluso mejor calidad.
Para una comparativa directa de clase 14B consulta la comparativa Qwen 14B vs Llama 8B, que incluye detalles de benchmarks de coding.