Mistral Small 24B vs Qwen3 14B vs Llama 3.1 8B: qual rodar localmente?
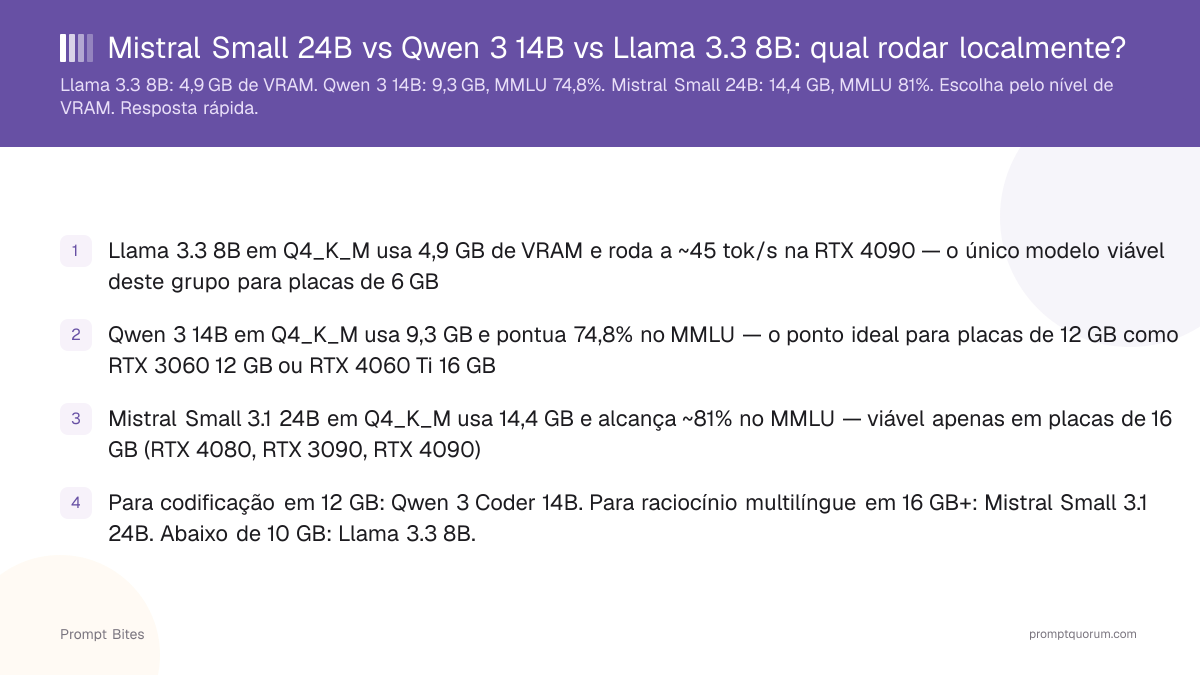
Resposta rápida
Escolha pelo VRAM: Llama 3.1 8B (4,9 GB), Qwen3 14B (9,3 GB), Mistral Small 3.1 24B (14,4 GB). Qwen 14B ganha com 12 GB de VRAM. Mistral Small 24B ganha acima de 16 GB em tarefas de raciocínio.
- ▸Llama 3.1 8B Q4_K_M: 4,9 GB de VRAM, ~45 tok/s na RTX 4090, MMLU 66,6% — melhor para placas de 6–8 GB
- ▸Qwen3 14B Q4_K_M: 9,3 GB de VRAM, ~28 tok/s, MMLU 74,8% — ponto ideal para placas de 12 GB
- ▸Mistral Small 3.1 24B Q4_K_M: 14,4 GB de VRAM, ~20 tok/s, MMLU ~81% — apenas para placas de 16 GB ou mais
Pontos principais
- ✓Llama 3.1 8B em Q4_K_M usa 4,9 GB de VRAM e roda a ~45 tok/s na RTX 4090 — o único modelo viável deste grupo para placas de 6 GB
- ✓Qwen3 14B em Q4_K_M usa 9,3 GB e pontua 74,8% no MMLU — o ponto ideal para placas de 12 GB como RTX 3060 12 GB ou RTX 4060 Ti 16 GB
- ✓Mistral Small 3.1 24B em Q4_K_M usa 14,4 GB e alcança ~81% no MMLU — viável apenas em placas de 16 GB (RTX 4080, RTX 3090, RTX 4090)
- ✓Para codificação em 12 GB: Qwen2.5-Coder 14B. Para raciocínio multilíngue em 16 GB+: Mistral Small 3.1 24B. Abaixo de 10 GB: Llama 3.1 8B.
Requisitos de VRAM: qual placa roda qual modelo
A escolha entre esses três modelos é principalmente uma decisão de VRAM. Em quantização Q4_K_M: Llama 3.1 8B usa 4,9 GB, Qwen3 14B usa 9,3 GB e Mistral Small 3.1 24B usa 14,4 GB. Isso se corresponde diretamente a três níveis de GPU: placas de 6–8 GB (apenas Llama 3.1 8B), placas de 10–12 GB (Qwen3 14B) e placas de 16+ GB (Mistral Small 24B).
Velocidade na RTX 4090 em Q4_K_M: Llama 3.1 8B roda a aproximadamente 45 tok/s, Qwen3 14B a ~28 tok/s e Mistral Small 3.1 24B a ~20 tok/s. Em uma RTX 3060 12 GB, apenas Llama 3.1 8B e Qwen3 14B cabem — Mistral Small 24B requer no mínimo uma placa de 16 GB para evitar derramamento para a RAM da CPU.
A diferença nos benchmarks é significativa: o MMLU 81% do Mistral Small 24B supera o Llama 3.1 8B em 14 pontos e o Qwen3 14B em 6 pontos. Em tarefas complexas de raciocínio em várias etapas e seguimento de instruções, essa lacuna é perceptível na prática.
| Modelo | VRAM (Q4_K_M) | Velocidade (RTX 4090) | MMLU | GPU mínima |
|---|---|---|---|---|
| Llama 3.1 8B | 4,9 GB | ~45 tok/s | 66,6% | RTX 3060 6 GB |
| Qwen3 14B | 9,3 GB | ~28 tok/s | 74,8% | RTX 3060 12 GB |
| Mistral Small 3.1 24B | 14,4 GB | ~20 tok/s | ~81% | RTX 4080 16 GB |
Qualidade vs VRAM: quando cada modelo ganha
Llama 3.1 8B ganha em eficiência de VRAM. Com 4,9 GB Q4_K_M, é o único modelo deste grupo que cabe em uma placa de 6 GB com margem para uma janela de contexto de 4k tokens. Pontua 66,6% no MMLU e oferece respostas interativas rápidas (~45 tok/s na RTX 4090). Para chat, consultas rápidas de codificação e uso diário em hardware limitado, é a escolha correta.
Qwen3 14B ganha com 12 GB de VRAM. Seu MMLU de 74,8% o coloca bem acima do Llama 3.1 8B em raciocínio e codificação — e cabe no nível de GPU prosumer mais comum. A variante Qwen Coder 14B (mesmo tamanho, otimizado para código) pontua aproximadamente 78% no HumanEval. Se seu uso principal é codificação e você tem uma placa de 12 GB, Qwen3 14B é a resposta.
Mistral Small 3.1 24B ganha em qualidade quando a VRAM permite. Seu MMLU de 81% e sólido desempenho multilíngue o tornam a principal escolha para placas de 16 GB. Lida com raciocínio de forma longa, tarefas de saída estruturada e conjuntos de instruções complexos de forma mais confiável do que os modelos da classe 14B. Em uma RTX 4090 24 GB, cabe em Q5_K_M para qualidade ainda melhor.
Para uma comparação direta da classe 14B, consulte a comparação Qwen 14B vs Llama 8B, que inclui detalhes de benchmarks de codificação.