Wichtigste Erkenntnisse
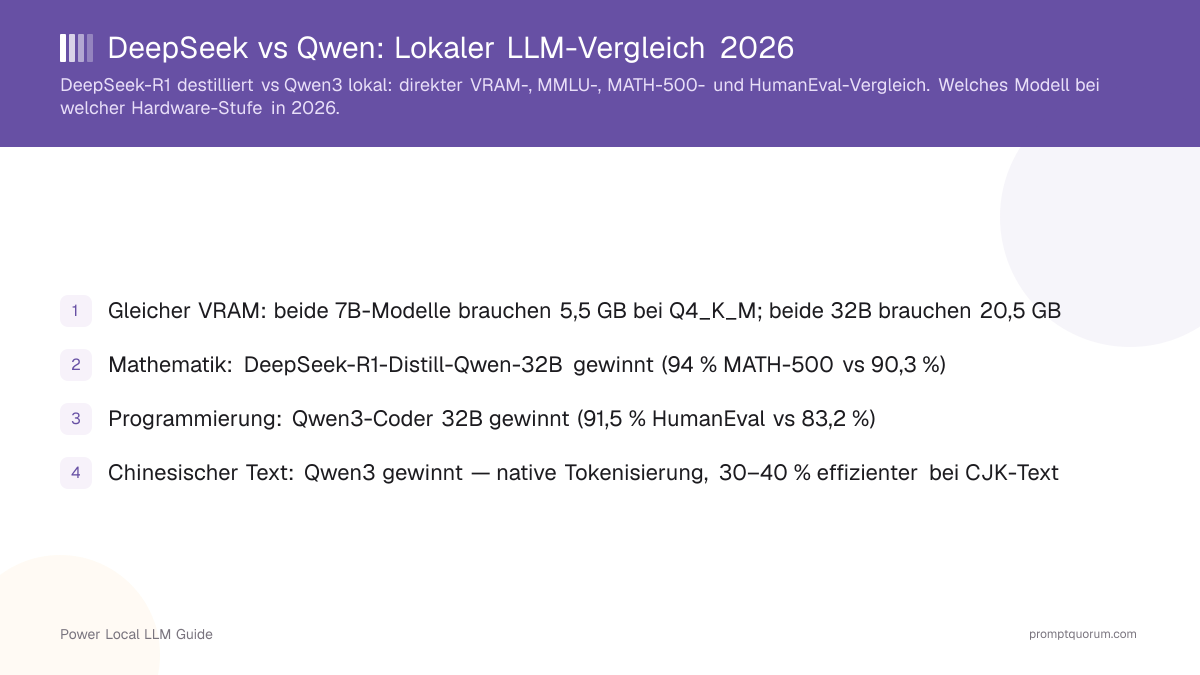
- Gleicher VRAM: beide 7B-Modelle brauchen 5,5 GB bei Q4_K_M; beide 32B brauchen 20,5 GB
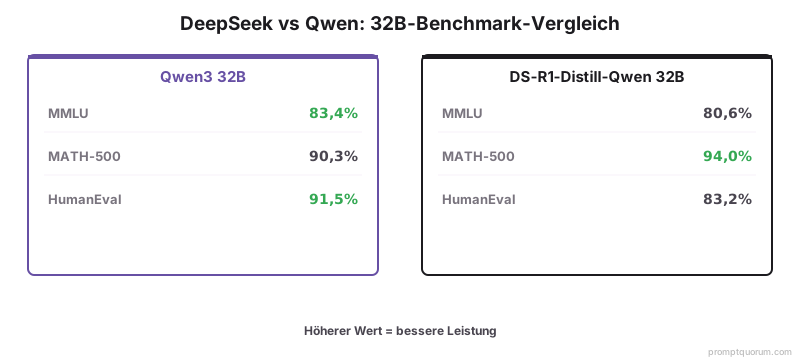
- Mathematik: DeepSeek-R1-Distill-Qwen-32B gewinnt (94 % MATH-500 vs 90,3 %)
- Programmierung: Qwen2.5-Coder 32B gewinnt (91,5 % HumanEval vs 83,2 %)
- Chinesischer Text: Qwen3 gewinnt — native Tokenisierung, 30–40 % effizienter bei CJK-Text
- Schlussfolgern: DeepSeek-R1-Destillate produzieren standardmäßig lange Gedankenketten
- DSGVO: beide laufen vollständig lokal — kein Datentransfer an Dritte
Direkte Benchmark-Tabelle
Alle Werte bei Q4_K_M-Quantisierung. Geschwindigkeit gemessen auf NVIDIA RTX 4090 (24 GB VRAM).
Modell | VRAM | MMLU (%) | MATH-500 (%) | HumanEval (%) | Geschwindigkeit |
|---|---|---|---|---|---|
| Qwen3 8B | 5,5 GB | 72,5 | 62,5 | 74,6 | 50–80 Tok/s |
| DS-R1-Distill-Qwen 7B | 5,5 GB | 70,1 | 88,0 | 68,4 | 50–80 Tok/s |
| Qwen3 14B | 9,5 GB | 79,2 | 76,1 | 82,1 | 30–50 Tok/s |
| DS-R1-Distill-Qwen 14B | 9,5 GB | 75,8 | 90,0 | 75,5 | 30–50 Tok/s |
| Qwen3 32B | 20,5 GB | 83,4 | 90,3 | 91,5 | 15–30 Tok/s |
| DS-R1-Distill-Qwen 32B | 20,5 GB | 80,6 | 94,0 | 83,2 | 15–30 Tok/s |
Welches Modell bei welcher Hardware-Stufe
VRAM-Anforderungen sind bei beiden Familien identisch. Die Wahl zwischen DeepSeek und Qwen ist eine Aufgaben-Präferenz, keine Hardware-Einschränkung.
- 8 GB VRAM (RTX 3060 / M2 16 GB): Qwen3 8B für Programmierung/Chat; DS-R1-Distill-Qwen-7B für Mathe-Nachhilfe
- 12 GB VRAM (RTX 3080 / M2 Pro 24 GB): Qwen3 14B für allgemeine Nutzung; DS-R1-Distill-Qwen-14B für Argumentationsketten
- 24 GB VRAM (RTX 4090 / M3 Max 48 GB): Qwen2.5-Coder 32B — bestes Allround-Modell in diesem Tier
- 48 GB+ (M2/M3 Ultra / RTX 4090 Dual): Qwen3 72B (86,1 % MMLU, 97 % HumanEval)
- Nur CPU (32+ GB RAM): Qwen3 8B oder DS-R1-Distill 7B — beide laufen bei 3–8 Tok/s auf modernen Laptop-CPUs
DeepSeek-Lokalmodelle erklärt
DeepSeek-R1 ist ein 671B MoE-Modell, das Server-Hardware erfordert. Für lokale Nutzung sind die destillierten Versionen die praktische Option.
- DeepSeek-R1-Distill-Qwen-7B: 5,5 GB VRAM bei Q4_K_M. 88 % MATH-500 — stärkstes Mathe-Modell im 7B-Tier. Standardmäßig lange Gedankenketten.
- DeepSeek-R1-Distill-Qwen-14B: 9,5 GB VRAM. Bestes Reasoning-pro-VRAM bei 14B.
- DeepSeek-R1-Distill-Qwen-32B: 20,5 GB VRAM. Höchster MATH-500-Wert aller Consumer-Modelle (94 %).
- DeepSeek-V3 (vollständig): 671B MoE — 400+ GB RAM bei Q4 — für Consumer-Hardware unpraktisch.
- Ollama-Befehl:
ollama run deepseek-r1:7b
Qwen3-Lokalmodelle erklärt
Qwen3 ist Alibabas Oktober-2025-Release mit Basis-, Coder- und Vision-Language-Varianten. Alle Basismodelle nutzen ein 128K-Kontextfenster und Apache-2.0-Lizenz. Update: Alibaba hat inzwischen Qwen3.6 (April 2026) veröffentlicht, eine neuere Generation mit hybridem Attention-Design und stärkeren Code-/Agenten-Benchmarks — das dichte Qwen3.6-27B erreicht beispielsweise 77,2 % auf SWE-bench Verified. Die in diesem Leitfaden verglichenen Qwen3-Modelle werden nicht eingestellt und bleiben weiterhin uneingeschränkt lokal nutzbar; wer die neueste Generation möchte, sollte Qwen3.6 zusätzlich in Betracht ziehen.
- Qwen3 8B: 5,5 GB VRAM. Bestes Allzweck-7B für Programmierung und chinesischen Text.
- Qwen3 14B: 9,5 GB VRAM. Bestes Gleichgewicht Qualität/Geschwindigkeit für 12-GB-VRAM-Setups.
- Qwen3 32B: 20,5 GB VRAM. 91,5 % HumanEval — bester Coding-Benchmark unter 48 GB VRAM.
- Qwen2.5-Coder 32B: Gleicher VRAM wie 32B-Basis, speziell für Code-Generierung feinabgestimmt.
- Ollama-Befehl:
ollama run qwen3:14b
Apple Silicon vs NVIDIA: Beide Familien betreiben
Beide Modell-Familien laufen gut auf Apple Silicon via Ollama oder llama.cpp mit Metal-Beschleunigung.
Hardware | Beste Modell-Stufe | Geschw. (7B) | Geschw. (32B) | Hinweise |
|---|---|---|---|---|
| M2/M3 16 GB | Nur 7B | 30–50 Tok/s | N/A | Beide 7B-Modelle passen |
| M3 Max 48 GB | 32B komfortabel | 80–120 Tok/s | 15–25 Tok/s | Bestes Consumer-Apple für 32B |
| RTX 4090 24 GB | 32B | 100–150 Tok/s | 18–28 Tok/s | Beste Einzel-GPU für 32B |
Anwendungsfall-Urteile
Ein-Satz-Antwort für jeden häufigen lokalen LLM-Anwendungsfall:
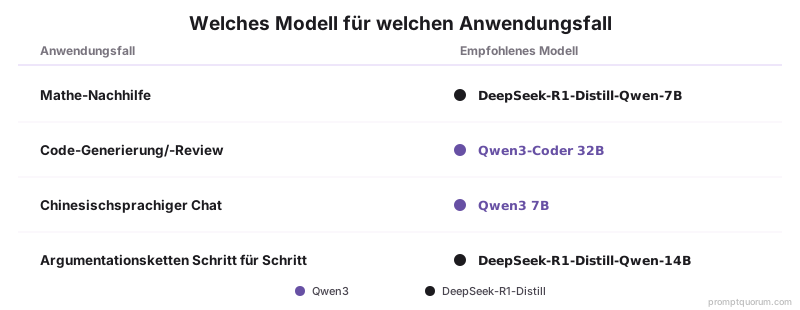
- Mathe-Nachhilfe: DS-R1-Distill-Qwen-7B — 88 % MATH-500 vs 62,5 % für Qwen3 8B
- Code-Generierung/-Review: Qwen2.5-Coder 32B — 91,5 % HumanEval, bestes Consumer-Modell
- Chinesischsprachiger Chat: Qwen3 8B — native CJK-Tokenisierung, 30–40 % effizienter
- Schritt-für-Schritt-Analyse: DS-R1-Distill-Qwen-14B — produziert standardmäßig explizite Gedankenketten
- Allgemeiner täglicher Assistent (8 GB VRAM): Qwen3 8B — flüssigere Konversation
常见问题
Ist DeepSeek-R1 dasselbe wie die destillierten Modelle?
Nein. DeepSeek-R1 ist das 671B-MoE-Modell. Die destillierten Versionen (7B, 14B, 32B) sind separate dichte Modelle — praktisch für lokale Nutzung.
Benötigen DeepSeek und Qwen denselben VRAM?
Ja, bei gleicher Quantisierung. Beide 7B-Modelle benötigen ca. 5,5 GB bei Q4_K_M; beide 32B-Modelle benötigen 20,5 GB.
Was ist besser für chinesischen Text: DeepSeek oder Qwen?
Qwen3 ist deutlich besser. Es verwendet einen speziell entwickelten chinesischen Tokenizer, der 30–40 % effizienter bei CJK-Text ist.
Muss ich bei der Verwendung dieser Modelle die DSGVO beachten?
Bei lokaler Ausführung verarbeiten beide Modelle keine personenbezogenen Daten auf Drittservern. Das vereinfacht die DSGVO-Dokumentation erheblich, da kein Auftragsverarbeitungsvertrag mit externen Anbietern erforderlich ist.
Welches Modell für Mathe bei 8 GB VRAM?
DeepSeek-R1-Distill-Qwen-7B. Es erzielt 88 % MATH-500 vs 62,5 % für Qwen3 8B bei identischem VRAM.
Welche Lizenz haben diese Modelle?
Qwen3 verwendet Apache 2.0 — kommerzielle Nutzung ist erlaubt. DeepSeek-R1-Destillate verwenden die MIT-Lizenz. Beide sind für kommerzielle Deployments geeignet.