📍 한 문장으로
Qwen3.8-27B(Apache-2.0, Ollama Q4_K_M 18 GB)는 이 비교에서 24 GB GPU 한 장에 들어가는 현행 모델이고, DeepSeek V4(MIT, 가중치 160~893 GB)는 서버급입니다. 각 벤더가 공개한 코딩 벤치마크는 설정이 달라 서로 순위를 매길 수 없습니다.
💬 쉽게 말하면
코드를 컴퓨터 밖으로 내보낼 수 없다면 Qwen3.8-27B를 사용하십시오. 24 GB 그래픽 카드에 들어갈 만큼 작습니다. DeepSeek V4도 공개 모델이지만 일반 PC에는 너무 커서 대부분 클라우드 서비스로 이용합니다. 각 회사가 공개한 점수는 측정 방식이 서로 달라 어느 쪽이 더 낫다고 말해 주지 않습니다.
모델 개요: 현행 오픈 웨이트 코딩 모델
이 목록에서 확인한 바로는 소비자용 하드웨어에 들어가는 현행 모델은 Qwen3.8-27B뿐이며, DeepSeek V4는 모든 빌드가 서버급입니다. 아래 파라미터, 라이선스, 가중치 크기는 Hugging Face 모델 카드와 파일 목록(safetensors 파일 크기의 합계, 2026-10-20 확인) 및 Ollama 태그 페이지를 근거로 합니다.
배경: DeepSeek은 2026-04-24에 V4를 프리뷰로 공개한 뒤 V4-Flash-0731, V4-Pro-0813, V4.1-Flash, 그리고 소규모 업데이트인 V4.1-Flash-1017을 내놓았습니다. Qwen은 2026년 4월에 Qwen3.6을, 2026년 8월에 Qwen3.8을 공개했습니다. DeepSeek-V4-Pro(Preview)는 1.6T 파라미터에 활성 49B(864.7 GB)입니다. Qwen은 2.4T 파라미터의 Qwen3.8 모델도 공개했으나 로컬 사용 범위를 크게 벗어납니다. 더 작은 Qwen3.8 MoE는 찾지 못해 Qwen3.6-35B-A3B를 표에 유지했습니다. "HF"는 Hugging Face 메타데이터 기준 수치이며, 총합에는 언어 모델 외 구성 요소가 포함될 수 있습니다.
모델 | 파라미터 | 라이선스 | 가중치(Hugging Face) | 로컬 실행 |
|---|---|---|---|---|
| Qwen3.8-27B | 27B dense(비전 포함 28B) | Apache-2.0 | 55.6 GB (BF16) | 가능: Ollama 18 GB(Q4_K_M) |
| Qwen3.6-35B-A3B | 35B MoE, 활성 3B | Apache-2.0 | 71.9 GB (BF16) | Ollama 24 GB(Q4_K_M), 24 GB에서 여유 없음 |
| Qwen3.6-27B | 27B dense | Apache-2.0 | 55.6 GB (BF16) | 가능: Ollama 17 GB(Q4_K_M) |
| Qwen3.8-Flash-Next | 125B MoE, 활성 6B | qwen-community-1.0 | 360.0 GB | 불가: 서버급 |
| DeepSeek-V4-Flash (Preview) | 284B MoE, 활성 13B | MIT | 159.6 GB (FP4+FP8) | 불가: 서버급 |
| DeepSeek-V4-Flash-0731 | 304B (HF) | MIT | 166.9 GB | 불가: 서버급 |
| DeepSeek-V4.1-Flash | 763B (HF) | MIT | 510.3 GB | 불가: 서버급, Ollama는 클라우드 전용 |
| DeepSeek-V4-Pro-0813 | 1.65T (HF) | MIT | 892.7 GB | 불가: 서버급, Ollama는 클라우드 전용 |
벤더 공개 코딩 벤치마크
아래 수치는 모두 각 행에 표시된 벤더가 공개한 값이며, 벤치마크마다 버전, 하네스, 추론 강도, 샘플링이 달라 행끼리 직접 비교할 수 없습니다. "–"는 해당 모델 자체 카드에 그 벤치마크가 없다는 뜻입니다. PromptQuorum은 어떤 벤치마크도 실행하지 않았습니다.
모델 | Terminal-Bench | SWE-bench | LiveCodeBench | DeepSWE 1.1 |
|---|---|---|---|---|
| Qwen3.8-27B (Qwen) | 2.1: 73.0 | Pro: 61.7 | v6: 90.3 | 42.2 |
| Qwen3.8-Flash-Next (Qwen) | – | Pro: 62.5 | v6: 91.9 | 58.7 |
| Qwen3.6-27B (Qwen) | 2.0: 59.3 | Verified: 77.2 / Pro: 53.5 | v6: 83.9 | – |
| Qwen3.6-35B-A3B (Qwen) | 2.0: 51.5 | Verified: 73.4 / Pro: 49.5 | v6: 80.4 | – |
| DeepSeek-V4.1-Flash (DeepSeek) | 2.1: 90.6 | – | – | 74.2 |
| DeepSeek-V4.1-Flash-1017 (DeepSeek) | 4.0: 42.3 | – | – | 77.0 |
| DeepSeek-V4-Pro-0813 (DeepSeek) | 2.1: 87.9 | – | – | 62.7 |
| DeepSeek-V4-Flash-0731 (DeepSeek) | 2.1: 82.7 | – | – | 54.4 |
| DeepSeek-V4-Pro Max, Preview (DeepSeek) | 2.0: 67.9 | Verified: 80.6 / Pro: 55.4 | 93.5 | – |
| DeepSeek-V4-Flash Max, Preview (DeepSeek) | 2.0: 56.9 | Verified: 79.0 / Pro: 52.6 | 91.6 | – |
출처(Hugging Face 모델 카드, 2026-10-20 확인): Qwen3.8-27B, Qwen3.8-Flash-Next, Qwen3.6-27B, Qwen3.6-35B-A3B, DeepSeek-V4.1-Flash, V4.1-Flash-1017, V4-Pro-0813, V4-Flash-0731, V4-Flash, V4-Pro. 설정은 서로 다릅니다. Qwen3.8-27B는 Terminus 하네스의 Terminal-Bench 2.1과, 정제된 과제 세트에 Claude Code 하네스를 쓴 SWE-bench Pro입니다. Qwen3.6은 3시간 제한과 5회 평균의 Terminal-Bench 2.0입니다. DeepSeek V4.1-Flash와 V4-Pro-0813은 최대 추론 강도입니다(V4.1-Flash의 DeepSWE는 mini-SWE 하네스, V4-Pro-0813은 DeepSeek Harness 최소 모드). V4.1-Flash-1017 행은 Claude Code 하네스의 Terminal-Bench 4.0이며, Preview 행은 최대 추론 모드이고 LiveCodeBench 버전을 밝히지 않았습니다. Terminal-Bench 2.0, 2.1, 4.0은 점수 척도가 다른 별개의 버전이며, SWE-bench Verified와 Pro는 서로 다른 과제 세트입니다. V4.1과 V4-0813 카드에는 LiveCodeBench와 SWE-bench가 없습니다.
가중치 크기와 하드웨어: 무엇이 어디에 들어가는가
24 GB 그래픽 카드는 Qwen3.8-27B Q4_K_M을 약 6 GB 여유로 담을 수 있지만, DeepSeek V4 가중치는 같은 카드 7장 미만으로는 들어가지 않습니다. "필요한 24 GB 카드 수" 열은 표기된 가중치 크기를 24 GB로 나눈 단순 계산입니다. 가중치만 계산하며 KV 캐시, 활성화 값, 런타임 오버헤드는 제외했으므로 실제 필요량은 더 큽니다. 16 GB 카드는 18 GB 빌드의 Qwen3.8-27B를 VRAM에 담지 못합니다. 어떤 하드웨어에서도 속도나 최대 컨텍스트를 측정하지 않았으므로 tok/s 수치는 제시하지 않습니다.
모델 | 가중치(출처) | 필요한 24 GB 카드 수 | 24 GB 카드 1장 적합 |
|---|---|---|---|
| Qwen3.8-27B, Q4_K_M | 18 GB (Ollama) | 0.75 | 가능, 약 6 GB 남음 |
| Qwen3.8-27B, BF16 | 55.6 GB (HF) | 2.3 | 불가 |
| Qwen3.6-35B-A3B, Q4_K_M | 24 GB (Ollama) | 1.0 | 여유 없음 |
| Qwen3.8-Flash-Next | 360.0 GB (HF) | 15.0 | 불가 |
| DeepSeek-V4-Flash (Preview) | 159.6 GB (HF) | 6.7 | 불가 |
| DeepSeek-V4-Flash-0731 | 166.9 GB (HF) | 7.0 | 불가 |
| DeepSeek-V4.1-Flash | 510.3 GB (HF) | 21.3 | 불가 |
| DeepSeek-V4-Pro-0813 | 892.7 GB (HF) | 37.2 | 불가 |
Ollama 크기는 qwen3.8와 qwen3.6 태그 페이지 기준입니다(컨텍스트 창 256K, 2026-10-20 확인). Hugging Face 크기는 safetensors 파일 합계입니다. Ollama의 공식 deepseek-v4.1-flash와 deepseek-v4-pro 항목에는 클라우드 태그만 있습니다.
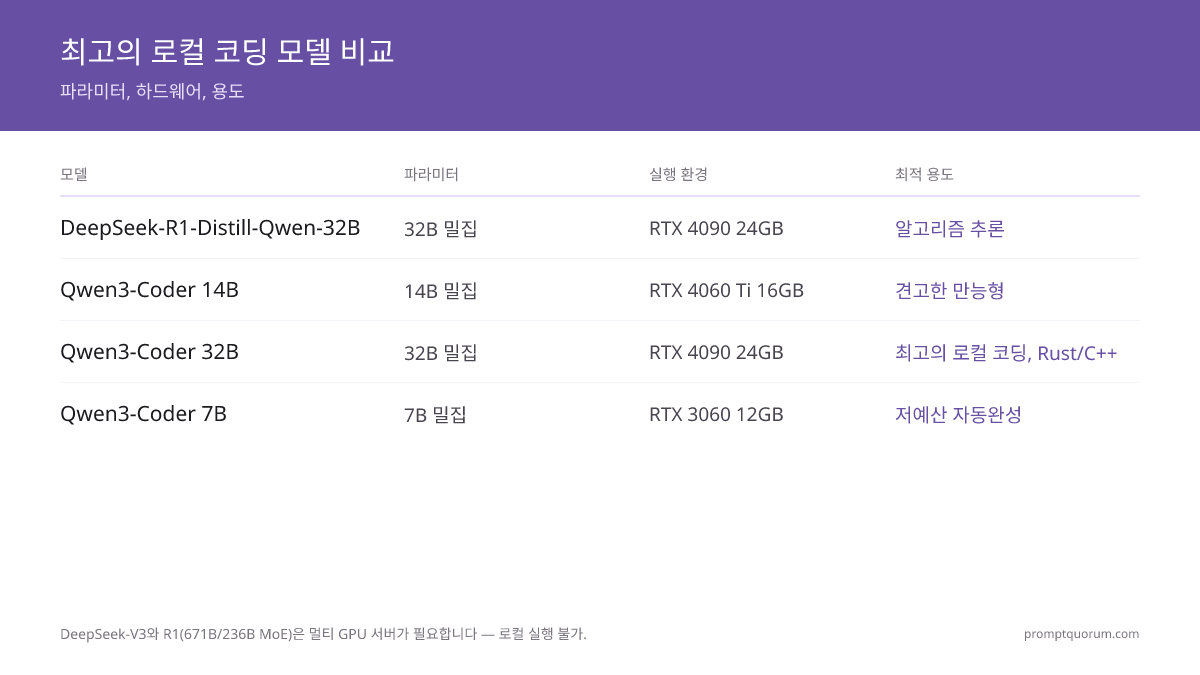
이전 세대: Qwen2.5-Coder vs DeepSeek-Coder-V2(기록)
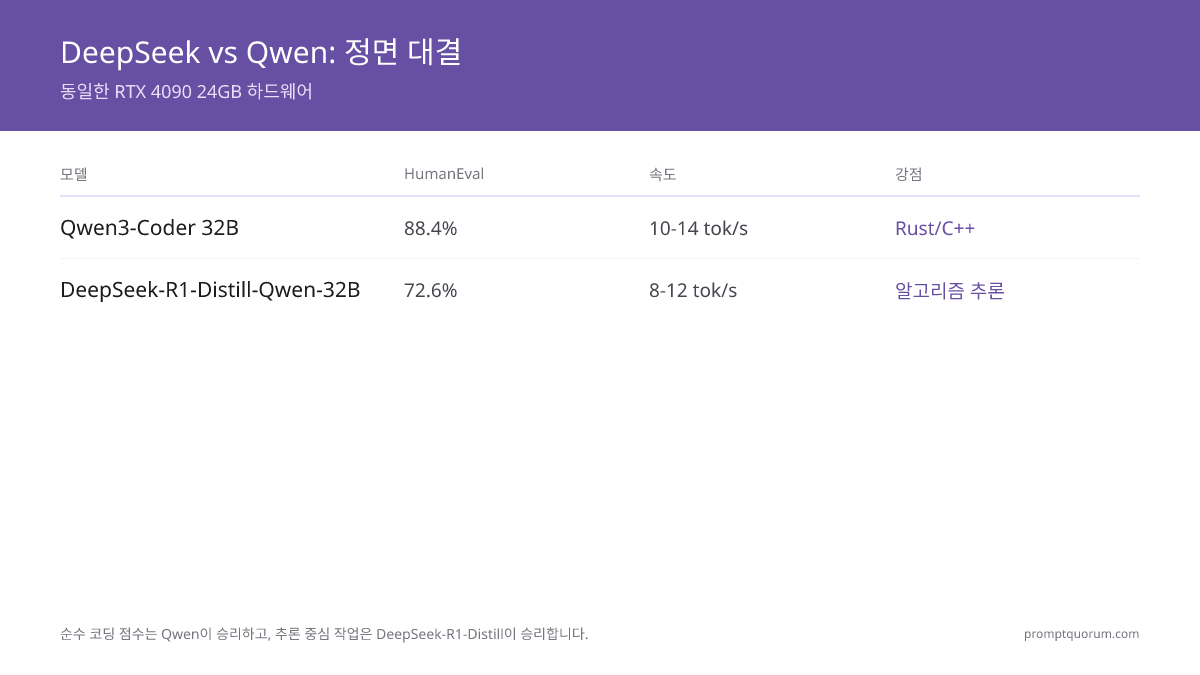
이전 버전의 이 페이지는 Qwen2.5-Coder 32B를 DeepSeek-Coder-V2, DeepSeek-V3, DeepSeek-R1-Distill-Qwen-32B와 비교했습니다. 이 모델들은 이전 세대이며 수치는 기록용으로만 남겼습니다. HumanEval은 단일 함수 Python 생성을 측정하는 훨씬 쉬운 벤치마크이므로 위 표의 수치와 비교해서는 안 됩니다.
모델 | Terminal-Bench | SWE-bench | LiveCodeBench | DeepSWE 1.1 |
|---|---|---|---|---|
| Qwen3.8-27B (Qwen) | 2.1: 73.0 | Pro: 61.7 | v6: 90.3 | 42.2 |
| Qwen3.8-Flash-Next (Qwen) | – | Pro: 62.5 | v6: 91.9 | 58.7 |
| Qwen3.6-27B (Qwen) | 2.0: 59.3 | Verified: 77.2 / Pro: 53.5 | v6: 83.9 | – |
| Qwen3.6-35B-A3B (Qwen) | 2.0: 51.5 | Verified: 73.4 / Pro: 49.5 | v6: 80.4 | – |
| DeepSeek-V4.1-Flash (DeepSeek) | 2.1: 90.6 | – | – | 74.2 |
| DeepSeek-V4.1-Flash-1017 (DeepSeek) | 4.0: 42.3 | – | – | 77.0 |
| DeepSeek-V4-Pro-0813 (DeepSeek) | 2.1: 87.9 | – | – | 62.7 |
| DeepSeek-V4-Flash-0731 (DeepSeek) | 2.1: 82.7 | – | – | 54.4 |
| DeepSeek-V4-Pro Max, Preview (DeepSeek) | 2.0: 67.9 | Verified: 80.6 / Pro: 55.4 | 93.5 | – |
| DeepSeek-V4-Flash Max, Preview (DeepSeek) | 2.0: 56.9 | Verified: 79.0 / Pro: 52.6 | 91.6 | – |
출처: Qwen2.5-Coder 기술 보고서(Qwen이 공개한 pass@1)와 DeepSeek-R1-Distill-Qwen-32B 모델 카드(다른 평가 프로토콜의 LiveCodeBench 57.2이므로 별표 값은 다른 행과 비교할 수 없음). PromptQuorum은 이 벤치마크를 실행하지 않았습니다.
IDE 통합: Continue.dev, Cline, Cursor 로컬 모드
두 모델 계열 모두 OpenAI 호환 엔드포인트를 통해 Continue.dev, Cline, Cursor 로컬 모델 모드와 함께 사용할 수 있습니다. Qwen3.8-27B는 Ollama로 로컬에서 실행하며, DeepSeek V4는 보통 DeepSeek 호스팅 API 또는 Ollama 클라우드 태그로 이용합니다.
- 1Ollama를 설치하고 모델을 받습니다: ollama pull qwen3.8:27b
Why it matters: Ollama가 GPU 추론을 처리하고 11434 포트에 API를 제공합니다. - 2Continue.dev config.json에서 provider를 "ollama", model을 "qwen3.8:27b"로 설정합니다
Why it matters: 클라우드 API 대신 로컬 Ollama 인스턴스를 사용하도록 지정합니다. - 3Cline에서는 baseUrl을 http://localhost:11434/v1, apiKey를 "ollama"로 설정합니다
Why it matters: Cline은 OpenAI SDK 형식을 사용하며 Ollama에서는 apiKey로 임의의 문자열을 쓸 수 있습니다. - 4DeepSeek API를 쓰려면 DeepSeek의 OpenAI 호환 엔드포인트에 DeepSeek API 키와, DeepSeek API 문서에 있는 현재 모델 이름(예: deepseek-flash 또는 deepseek-v4-pro)을 지정합니다
Why it matters: 기본 URL만 바꾸면 같은 통합을 사용할 수 있으며, 이 경우 코드는 DeepSeek 서버로 전송됩니다. - 5모델을 정하기 전에 본인 저장소의 실제 리팩터링 작업으로 답변을 비교합니다
Why it matters: 공개된 벤치마크 수치만으로는 내 코드베이스에서의 동작을 예측할 수 없습니다.
판정 매트릭스: 사용 사례별 DeepSeek V4 vs Qwen3.8
핵심 제약은 코드를 컴퓨터 밖으로 내보낼 수 있는지 여부이며, 공개된 수치는 우승자를 가리지 않습니다.
코딩 결정: DeepSeek V4 vs Qwen3.8
다음의 경우 로컬 LLM을 사용하십시오:
- •코드가 내 컴퓨터를 벗어나면 안 되는 경우(독점, 기밀, 규제 대상) → 24 GB 카드에서 Ollama로 Qwen3.8-27B
- •GPU가 16 GB뿐인 경우 → 18 GB 빌드의 Qwen3.8-27B는 VRAM에 들어가지 않으므로 더 작은 모델을 본인 작업으로 먼저 시험하십시오
- •MIT 라이선스 가중치를 직접 호스팅하고 서버 하드웨어가 있는 경우 → DeepSeek-V4-Flash 또는 V4.1-Flash(160~510 GB)
- •법무 검토에서 Apache-2.0이 중요한 경우 → Qwen3.8-27B 또는 Qwen3.6
다음의 경우 클라우드 모델을 사용하십시오:
- •코드가 외부로 나가도 되고 DeepSeek이 공개한 에이전트형 코딩 결과를 원하는 경우 → DeepSeek API 또는 Ollama 클라우드 태그
- •적합한 GPU나 서버가 없는 경우 → 벤더 API(DeepSeek API 또는 Qwen용 Alibaba Cloud)
- •가장 어려운 장시간 에이전트 작업 → 두 벤더의 API를 본인 저장소에서 실행해 비교
빠른 결정:
- →완전 로컬, 현행 세대: Qwen3.8-27B
- →직접 호스팅 가능한 가장 큰 오픈 DeepSeek: 서버급 V4(MIT)
- →이 페이지에서 가장 높은 Terminal-Bench 2.1: DeepSeek-V4.1-Flash 90.6(DeepSeek 설정이며 Qwen의 73.0과 비교 불가)
- →동일 조건 우승자: 공개된 것 없음. 본인 코드로 두 모델을 시험하십시오
관련 가이드
- Qwen 프로덕션 배포 가이드: /ko/power-local-llm/qwen-local-deployment-complete-guide-2026
- Continue.dev vs Cline vs Aider 비교: /ko/power-local-llm/continue-dev-vs-cline-vs-aider-local
- GitHub Copilot을 로컬 LLM으로 교체: /ko/power-local-llm/replace-github-copilot-with-local-llm
- 2026 최고 로컬 코딩 모델: /ko/power-local-llm/best-local-coding-models-2026
- 2026년 최고의 로컬 추론 모델 — 추론용 Distill(코딩 아님) 가이드: /ko/local-llms/best-local-reasoning-model-deepseek-r1-2026
- 2026년 최고의 로컬 LLM IDE 플러그인 5선 -- 로컬 코딩 모델을 연결하는 VS Code 및 JetBrains 플러그인
- Qwen 로컬 배포 완전 가이드 2026: 프로덕션 서버 구축 -- Qwen 코딩 모델을 영구 로컬 서버로 배포하기
자주 묻는 질문
2026년 로컬 코딩에는 DeepSeek과 Qwen 중 무엇이 더 좋습니까?
벤더마다 벤치마크 버전과 하네스가 다르므로 공개된 수치만으로는 결론을 낼 수 없습니다. Qwen이 공개한 바에 따르면 Qwen3.8-27B는 SWE-bench Pro 61.7, Terminal-Bench 2.1(Terminus 하네스) 73.0, LiveCodeBench v6 90.3을 기록했습니다. DeepSeek이 공개한 바에 따르면 DeepSeek-V4.1-Flash는 DeepSeek 자체의 최대 추론 강도 설정에서 Terminal-Bench 2.1 90.6, DeepSWE v1.1 74.2를 기록했습니다. 코드가 내 컴퓨터에 머물러야 한다면 소비자용 크기의 공식 빌드가 있는 쪽은 Qwen 모델뿐입니다(Ollama: Q4_K_M 18 GB).
DeepSeek-V4를 로컬에서 실행할 수 있습니까?
가중치는 공개(MIT 라이선스)되어 있지만 소비자용 크기가 아닙니다. Hugging Face 파일 크기는 V4-Flash(Preview) 159.6 GB, V4-Flash-0731 166.9 GB, V4.1-Flash 510.3 GB, V4-Pro-0813 892.7 GB입니다. 24 GB로 나누면 KV 캐시를 제외하고 가중치만으로 24 GB 카드 6.7~37.2장입니다. Ollama의 공식 deepseek-v4-pro와 deepseek-v4.1-flash 항목에는 클라우드 태그만 있습니다(2026-10-20 확인). 현실적인 방법은 직접 관리하는 서버 하드웨어, 임대 서버, 또는 DeepSeek API입니다.
Qwen3.8-27B를 로컬에서 실행하려면 무엇이 필요합니까?
Ollama는 qwen3.8:27b를 18 GB(Q4_K_M, 컨텍스트 창 256K), Q8_0 30 GB, BF16 56 GB로 표기합니다. 24 GB 카드에서는 18 GB 빌드가 컨텍스트 캐시와 런타임에 쓸 약 6 GB를 남기며, 16 GB 카드에서는 VRAM에 들어가지 않습니다. 어떤 카드에서도 속도나 최대 컨텍스트를 측정하지 않았으므로 이 페이지에는 tok/s 수치가 없습니다.
이 페이지의 벤치마크 수치는 서로 비교할 수 있습니까?
같은 벤치마크 버전과 같은 하네스 안에서만 가능합니다. Terminal-Bench 2.0, 2.1, 4.0은 서로 다른 버전이고, SWE-bench Verified와 Pro는 서로 다른 과제 세트이며, 벤더마다 고유한 하네스, 추론 강도, 샘플링을 사용했습니다. 표는 각 벤더가 공개한 내용의 기록이지 직접 대결 결과가 아닙니다. PromptQuorum은 이 벤치마크를 하나도 실행하지 않았습니다.
DeepSeek API 비용은 Qwen 로컬 실행과 비교해 어떻습니까?
API 가격은 자주 바뀌므로 여기에 적지 않습니다. 현재 요금은 DeepSeek 가격 페이지를 확인하십시오(Ollama의 deepseek-v4.1-flash 클라우드 목록에는 별도의 토큰당 요금이 표시됩니다). 로컬 환경은 토큰당 요금이 없지만 하드웨어와 전기 비용이 듭니다. 로컬 실행의 주된 이유는 비용 절감이 아니라 추론이 벤더의 클라우드 API로 가지 않고 내 컴퓨터에 머문다는 점입니다(사용하는 도구의 텔레메트리 설정은 확인하십시오).
DeepSeek-V3, R1, Qwen2.5-Coder는 아직 현행 모델입니까?
아닙니다. 이전 세대이며 기록 섹션에만 나옵니다. DeepSeek의 API 이름 deepseek-chat과 deepseek-reasoner(V3/R1 시기)는 2026-07-24에 종료될 예정이었습니다. 현행 오픈 세대는 DeepSeek V4 / V4.1과 Qwen3.8입니다. 35B-A3B MoE 크기는 Hugging Face의 Qwen 목록에서 Qwen3.8 후속 모델을 찾지 못해 Qwen3.6-35B-A3B를 표시했습니다.
업데이트 기록
- 2026-05-26: 최초 게시. 속도 수치는 참고용 추정치입니다.
- 2026-07-01: HumanEval 순위 정정 — Qwen2.5-Coder 32B가 약 88.4%로 DeepSeek-Coder-V2-Lite의 약 83.5%를 앞섭니다. DeepSeek-Coder를 준우승(repo-level / fill-in-the-middle 우세)으로 명확화. CodeLlama와 Llama 3를 구형 기준점으로 추가.
- 2026-10-19: 이전 세대 안내 추가(DeepSeek-V4와 Qwen3.6은 더 최신이며 다시 테스트하지 않음); DeepSeek-V3를 236B에서 671B 파라미터로 정정(활성 37B, Ollama의 deepseek-v3는 404 GB); 오래된 V3 API 가격을 현재 DeepSeek API 가격으로 교체; V3/R1 API 결과를 이전 세대로 표시; V3가 아직 현행인지 묻는 FAQ 추가. 출처 없는 HumanEval/LiveCodeBench/SWE-bench 표를 Qwen2.5-Coder 기술 보고서와 DeepSeek-R1 모델 카드로 추적 가능한 수치로 교체했습니다(SWE-bench 열 삭제). HumanEval 핵심 수치를 92.7% 대 81.1%로 정정했습니다(이전의 88.4% 대 83.5%는 출처를 추적할 수 없었습니다). 출처 없는 RTX 4090 가격과 단종 주장을 삭제했고, 전기료와 상각 수치는 설명용으로 표시했습니다.
- 2026-10-20: 현행 세대 기준으로 재구성했습니다. 이전 세대 판정을 Hugging Face 모델 카드의 Qwen3.8-27B, Qwen3.8-Flash-Next, Qwen3.6, DeepSeek V4(Preview, V4-Flash-0731, V4-Pro-0813, V4.1-Flash, V4.1-Flash-1017) 벤더 공개 수치로 교체하고, Hugging Face 가중치 크기와 Ollama 태그 크기를 추가했습니다(모두 2026-10-20 확인). 측정하지 않은 속도 표와 언어별 편집 판정을 삭제했고, Qwen2.5-Coder / DeepSeek-V3 비교는 기록 섹션으로 옮겼으며, 가격 기반 API FAQ를 가격 없는 내용으로 바꾸고, 제휴 GPU 링크를 RTX 4090 24 GB 검색으로 변경했습니다.
- 2026-10-20: 현행 세대 기준으로 재구성했습니다. 이전 세대 판정을 Hugging Face 모델 카드의 Qwen3.8-27B, Qwen3.8-Flash-Next, Qwen3.6, DeepSeek V4(Preview, V4-Flash-0731, V4-Pro-0813, V4.1-Flash, V4.1-Flash-1017) 벤더 공개 수치로 교체하고, Hugging Face 가중치 크기와 Ollama 태그 크기를 추가했습니다(모두 2026-10-20 확인). 측정하지 않은 속도 표와 언어별 편집 판정을 삭제했고, Qwen2.5-Coder / DeepSeek-V3 비교는 기록 섹션으로 옮겼으며, 가격 기반 API FAQ를 가격 없는 내용으로 바꾸고, 제휴 GPU 링크를 RTX 4090 24 GB 검색으로 변경했습니다.
- 2026-10-20: 현행 세대 기준으로 재구성했습니다. 이전 세대 판정을 Hugging Face 모델 카드의 Qwen3.8-27B, Qwen3.8-Flash-Next, Qwen3.6, DeepSeek V4(Preview, V4-Flash-0731, V4-Pro-0813, V4.1-Flash, V4.1-Flash-1017) 벤더 공개 수치로 교체하고, Hugging Face 가중치 크기와 Ollama 태그 크기를 추가했습니다(모두 2026-10-20 확인). 측정하지 않은 속도 표와 언어별 편집 판정을 삭제했고, Qwen2.5-Coder / DeepSeek-V3 비교는 기록 섹션으로 옮겼으며, 가격 기반 API FAQ를 가격 없는 내용으로 바꾸고, 제휴 GPU 링크를 RTX 4090 24 GB 검색으로 변경했습니다.
- 다음 검토 예정: 2027-04-20