코딩에 최적인 14B 모델은 무엇입니까?
빠른 답변
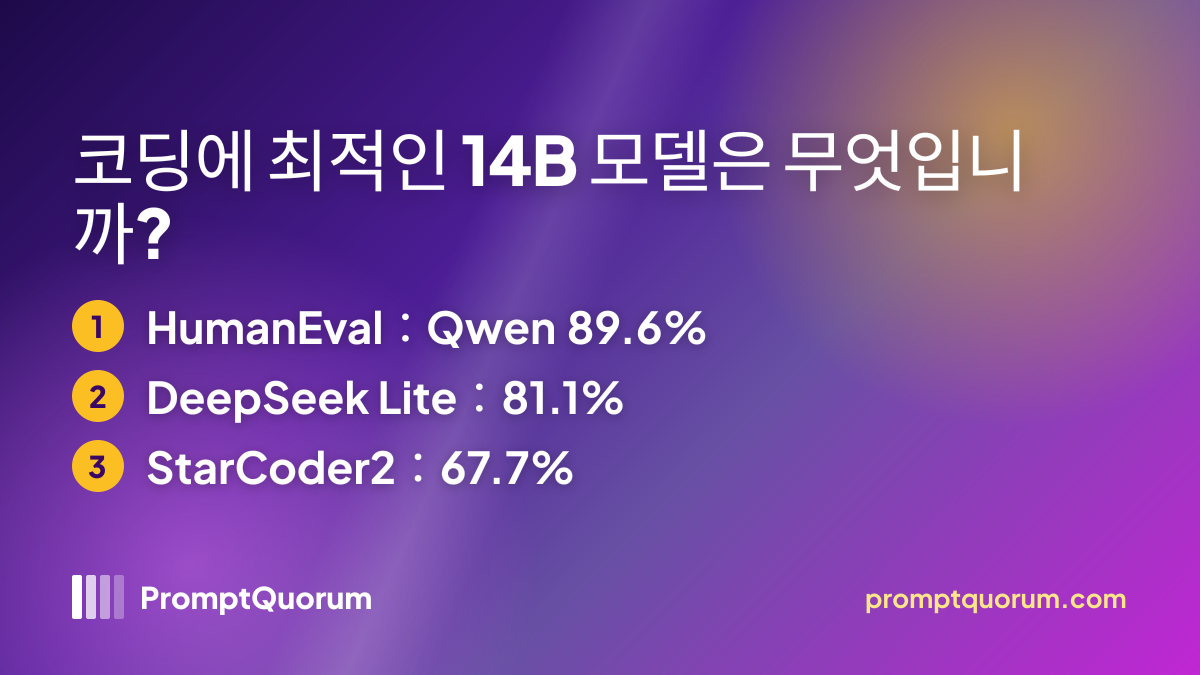
Qwen 자체 보고서에서 Qwen2.5-Coder 14B는 이 세 코딩 모델 중 가장 강력합니다. HumanEval(instruct) 89.6%로, DeepSeek-Coder-V2-Lite의 81.1%와 StarCoder2 15B의 67.7%를 앞섭니다. qwen2.5-coder:14b 다운로드는 9.0 GB이므로 약 10 GB VRAM을 예상하십시오.
- ▸Qwen2.5-Coder 14B Instruct: HumanEval 89.6%, 다운로드 9.0 GB(ollama run qwen2.5-coder:14b)
- ▸DeepSeek-Coder-V2-Lite(16B MoE, 활성 2.4B): HumanEval 81.1%, 다운로드 8.9 GB
- ▸StarCoder2 15B Instruct: HumanEval 67.7% — 모두 제조사 발표 수치이며 PromptQuorum 실측이 아닙니다
핵심 요점
- ✓Qwen2.5-Coder 14B Instruct는 Qwen 자체 보고서에서 HumanEval 89.6%로 비교한 세 모델 중 가장 높으며, 약 10 GB VRAM(다운로드 9.0 GB)이 필요합니다
- ✓DeepSeek-Coder-V2-Lite는 16B 전문가 혼합 모델(활성 파라미터 2.4B)로 8.9 GB 다운로드에 HumanEval 81.1%를 기록합니다
- ✓StarCoder2 15B Instruct는 HumanEval 67.7%로 이 벤치마크에서 나머지 두 모델에 뒤처집니다
- ✓12 GB VRAM이라면 Qwen2.5-Coder 14B를, 8 GB 미만이라면 7B 코딩 모델을 사용하십시오. 모든 HumanEval 수치는 제조사가 발표한 instruct 결과이며 PromptQuorum 실측이 아닙니다
Qwen2.5-Coder 14B가 HumanEval에서 선두입니다
Qwen2.5-Coder-14B-Instruct는 Qwen2.5-Coder 기술 보고서에서 HumanEval 89.6%를 기록하여 비교한 세 모델 중 가장 높습니다. 이는 제조사가 발표한 instruct 결과이며 PromptQuorum 실측도, Q4_K_M 결과도 아닙니다. 양자화된 로컬 빌드는 점수가 다소 다를 수 있습니다.
DeepSeek-Coder-V2-Lite-Instruct는 같은 표에서 81.1%입니다. 총 16B, 활성 2.4B 파라미터의 전문가 혼합 모델이라 밀집 14B 모델은 아니지만, 8.9 GB Ollama 다운로드로 같은 VRAM 등급에 속합니다. HumanEval 8.5점 차이는 Qwen에 유리하며, 이미 사용 중이라면 DeepSeek도 합리적인 대안입니다.
StarCoder2-15B-Instruct-v0.1은 같은 표에서 67.7%입니다. The Stack v2로 학습되어 저장소 중심 작업에 적합하지만 HumanEval에서는 위 두 모델에 뒤처집니다.
| 모델 | HumanEval(instruct) | 아키텍처 |
|---|---|---|
| Qwen2.5-Coder 14B | 89.6% | 14.7B 밀집 |
| DeepSeek-Coder-V2-Lite | 81.1% | 16B MoE(활성 2.4B) |
| StarCoder2 15B | 67.7% | 15B 밀집 |
VRAM 여유 공간이 선택을 결정합니다
Qwen2.5-Coder 14B와 DeepSeek-Coder-V2-Lite 모두 Q4_K_M에서 약 10 GB VRAM이 필요하며, 12 GB 카드에서는 여유 공간이 2 GB에 불과합니다. 이 여유 공간은 긴 컨텍스트 세션에서 부족합니다: 8k 컨텍스트에서 VRAM 사용량이 ~11.5 GB까지 증가합니다. 대용량 파일을 다루는 작업이라면 16 GB 이상의 카드를 권장합니다.
4k 토큰 미만의 컨텍스트 창(단일 파일 코드 완성의 일반적인 경우)에서는 세 모델 모두 RTX 3060 12 GB 또는 RTX 3080 Ti 12 GB에서 문제없이 실행됩니다. Qwen과 DeepSeek Coder의 속도는 약 14–18 tok/s이며, StarCoder2 15B는 유사한 VRAM 사용량을 감안할 때 비슷한 처리량으로 동작합니다. 저장소 규모 검색이나 오픈소스 기여 패턴에 집중하는 작업이라면 StarCoder2를 권장합니다.
다른 크기와 VRAM 계층의 코딩 모델에 대한 더 넓은 비교는 12 GB VRAM 최적 코딩 LLM 가이드를 참조하십시오.
범용 14B 모델 추천: Qwen3 14B와 Phi-4
코딩 외 용도에서 Ollama의 주요 범용 14B 모델은 Qwen3 14B(qwen3:14b, 다운로드 9.3 GB, 컨텍스트 40K)와 Phi-4(phi4:14b, 9.1 GB, 컨텍스트 16K)입니다. 두 모델 모두 기본 Q4 양자화에서 12 GB 카드에 들어가며, 위의 코딩 모델과 같은 VRAM 구간입니다.
Qwen3 14B는 긴 컨텍스트와 폭넓은 다국어 사용에 적합하고, Phi-4는 추론·수학 중심 프롬프트를 겨냥합니다. 순수 코드에서는 위의 전용 모델이 여전히 앞섭니다. 범용 모델끼리의 직접 벤치마크는 수행하지 않아 점수는 싣지 않았습니다.
| 모델 | Ollama 태그 | 다운로드 | 컨텍스트 |
|---|---|---|---|
| Qwen3 14B | qwen3:14b | 9.3 GB | 40K |
| Phi-4 | phi4:14b | 9.1 GB | 16K |