12 GB VRAM으로 코딩에 최적인 로컬 LLM은?
빠른 답변
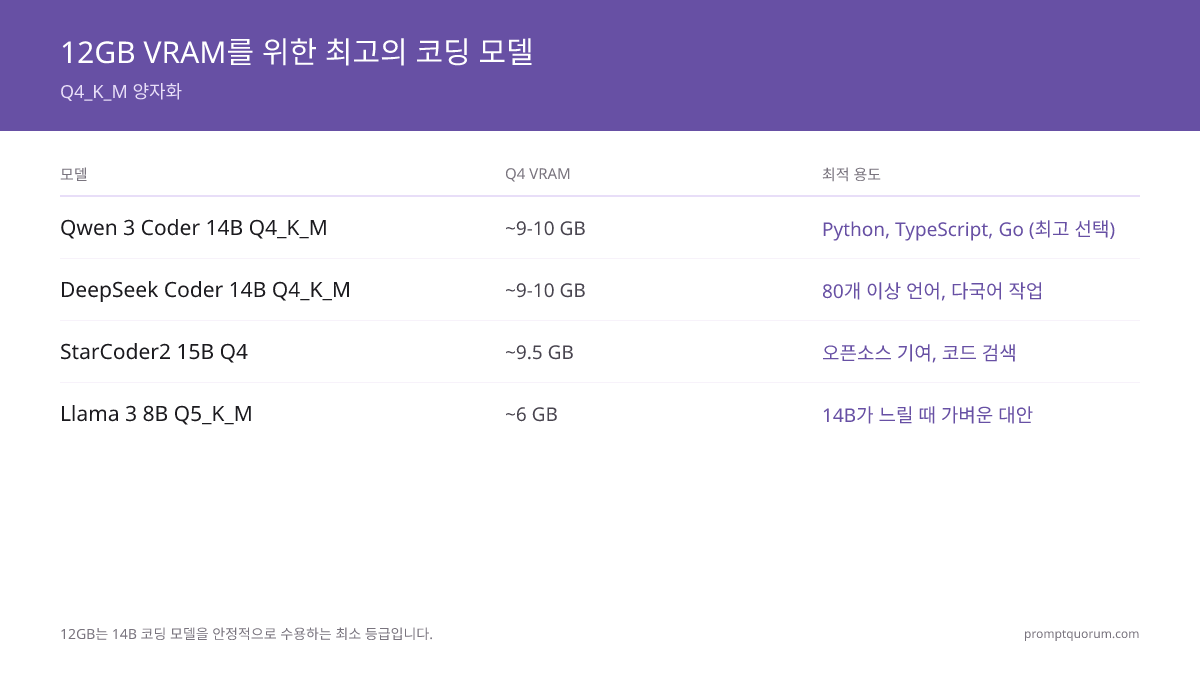
12 GB VRAM GPU에서 가장 좋은 코딩 모델은 Gemma 4 12B입니다. Ollama 다운로드는 7.7–8.0 GB이며, Google은 12B 모델의 LiveCodeBench v6 점수를 72.0%로 발표했습니다. 코드 특화 대안은 Qwen2.5-Coder 14B(약 9 GB)입니다. Qwen3.8 27B(18 GB)와 Devstral Small 2(15 GB)는 12 GB에 들어가지 않습니다.
- ▸Gemma 4 12B: 다운로드 7.7–8.0 GB, 256K 컨텍스트, Apache 2.0
- ▸Qwen2.5-Coder 14B Q4_K_M: 약 9 GB, 코드 특화, fill-in-the-middle 지원
- ▸Ornith 9B: 5.6 GB, MIT 라이선스, 에이전트형 코딩용
핵심 요점
- ✓Gemma 4 12B(Google, Apache 2.0): 다운로드 7.7–8.0 GB, 256K 컨텍스트, LiveCodeBench v6 72.0%(제조사 발표) — 12 GB GPU라면 최우선 코딩 모델
- ✓Qwen2.5-Coder 14B Q4_K_M(약 9 GB)은 여전히 탄탄한 코드 특화 선택지지만 2024년 모델이며, Qwen3.8 27B(18 GB) 같은 최신 Qwen 코더는 12 GB를 넘습니다
- ✓Devstral Small 2(24B, 15 GB)와 Qwen3.8 27B(18 GB)는 12 GB에서 CPU 오프로드로만 실행되며 생성 속도가 크게 떨어집니다
- ✓코딩에서는 컨텍스트 창을 8192 이상으로 올리세요(기본 창은 실제 소스 파일을 잘라냅니다). ollama ps로 모델이 GPU에 완전히 올라갔는지 확인하세요
12 GB에서 고를 코딩 모델
12 GB VRAM GPU에서 가장 좋은 코딩 모델은 Gemma 4 12B입니다. Ollama 다운로드는 7.7–8.0 GB라 KV 캐시용으로 약 4 GB가 남고, Google은 12B 모델의 LiveCodeBench v6 72.0%와 Codeforces Elo 1659를 발표했습니다. Apache 2.0 라이선스에 256K 컨텍스트 창을 지원하며 이미지 입력도 받아, 오류나 UI 버그 스크린샷을 그대로 붙여 넣을 수 있습니다. 이 벤치마크 수치는 제조사 발표값이며 직접 측정한 것이 아닙니다.
Qwen2.5-Coder 14B Q4_K_M(약 9 GB)도 들어가며 fill-in-the-middle을 지원하는 코드 특화 선택지지만 2024년 모델입니다. Ornith 9B(5.6 GB, MIT 라이선스)는 에이전트형 코딩을 겨냥하며 긴 컨텍스트를 위한 여유가 가장 큽니다. Devstral Small 2(24B, 15 GB)와 Qwen3.8 27B(18 GB)는 12 GB를 넘어 CPU 오프로드로만 실행됩니다.
8 GB 카드를 쓰신다면 AMD 5700X + RTX 3070 Ti용 최고의 LLM에서 8 GB 절충안을 확인하세요.
| 모델 | 다운로드 크기 | 적합한 용도 |
|---|---|---|
| Gemma 4 12B | 7.7–8.0 GB | 1순위: 코딩, 이미지, 256K |
| Qwen2.5-Coder 14B Q4_K_M | 약 9 GB | 코드 특화, fill-in-the-middle |
| Ornith 9B | 5.6 GB | 에이전트형 코딩, 긴 컨텍스트 여유 |
| Devstral Small 2 24B | 15 GB | 안 들어감, CPU 오프로드 필요 |
| Qwen3.8 27B | 18 GB | 안 들어감, 18 GB 이상 필요 |
코딩에서 중요한 설정
코딩에서는 컨텍스트 창을 최소 8k로 설정하세요. 짧은 기본 창은 수백 줄짜리 소스 파일을 잘라냅니다. Gemma 4 12B의 가중치 약 8 GB는 12 GB 카드에서 KV 캐시와 런타임용으로 약 4 GB를 남깁니다. Qwen2.5-Coder 14B는 약 9 GB라 여유가 적으니 컨텍스트를 적당히 유지하세요. 서버 시작 전에 OLLAMA_CONTEXT_LENGTH=8192를 설정하거나 ollama run 안에서 /set parameter num_ctx 8192를 실행한 뒤, ollama ps로 모델이 CPU와 분할되지 않고 GPU에 있는지 확인합니다.
Flash Attention(OLLAMA_FLASH_ATTENTION=1)을 켜고, 컨텍스트가 더 필요하면 OLLAMA_KV_CACHE_TYPE=q8_0을 설정하세요. 기본 f16 캐시보다 KV 캐시 메모리가 대략 절반으로 줄며 품질 저하는 작습니다. 환경 변수는 한 번의 실행에서 함께 쓸 수 있습니다.
12 GB를 넘는 전체 순위는 코딩용 최고의 로컬 LLM 가이드를 참고하세요.
ollama pull gemma4:12b
ollama run gemma4:12b

# code-specialised alternative
ollama pull qwen2.5-coder:14b-instruct-q4_K_M관련 가이드
- ▸코딩용 최고의 로컬 LLM -- 12 GB를 넘는 전체 순위
- ▸Best MoE Models for Local Coding -- MoE 코딩 모델
- ▸Continue.dev, Cursor에 인수: 종료와 대안 -- 코딩 도구 비교
12 GB VRAM 코딩 LLM 빠른 답변
12 GB VRAM에서 가장 좋은 코딩 모델은 무엇인가요?▾
12 GB VRAM에서 전반적으로 가장 좋은 로컬 LLM은 무엇인가요?▾
Qwen3.8 27B와 Devstral Small 2는 12 GB VRAM에 들어가나요?▾
12 GB에서는 Q4_K_M과 더 높은 양자화 중 무엇을 써야 하나요?▾
Ollama에서 이 모델들로 FIM(fill-in-the-middle) 자동완성을 쓸 수 있나요?▾
/api/generate의 suffix 필드로 커서 뒤 텍스트를 받습니다. 에디터에 연결하기 전에 각 모델의 Ollama 페이지에서 insert 지원을 확인하세요. 자동완성에는 Qwen2.5-Coder가 더 안전합니다.