일본어를 가장 잘 지원하는 로컬 LLM 모델은 무엇입니까?
빠른 답변
일본어에 최적화된 로컬 LLM은 사용 목적에 따라 다릅니다. 대화에는 Rinna 3.6B(4 GB RAM에서 실행 가능), 명령어 수행에는 ELYZA-7B, 일본어 코딩에는 Qwen3-Coder를 권장합니다. 모두 Ollama를 통해 실행됩니다.
- ▸Rinna 3.6B — 일본어 네이티브 모델, 최소 4 GB RAM, 일상 대화에 적합
- ▸ELYZA-7B — 명령어 수행 및 Q&A, 6 GB RAM 필요
- ▸Qwen3 8B — JA/ZH/EN 다국어 지원 및 코딩, 6 GB RAM
핵심 요점
- ✓Rinna 3.6B는 가장 가벼운 일본어 네이티브 모델입니다 — 파인튜닝 없이 Ollama를 통해 4 GB RAM으로 실행됩니다
- ✓ELYZA-7B(Llama 파인튜닝)는 일본어 명령어 수행에서 최고 성능을 발휘합니다; Q&A 및 작업 자동화에 활용하십시오
- ✓Qwen3 8B는 최고의 다국어 선택입니다: 일본어와 함께 중국어, 영어를 지원하며 코딩 기능도 포함합니다
- ✓일본어 토크나이제이션은 한자/가나 처리 오버헤드로 인해 영어 대비 유효 토큰/초가 약 20–30% 낮습니다 — 지연 시간 예상치 설정 시 이를 고려하십시오
- ✓Q4_K_M은 일본어 사용 시 권장되는 최소 양자화 수준입니다; Q3 이하는 측정 가능한 품질 저하를 보입니다
일본어 모델 비교표
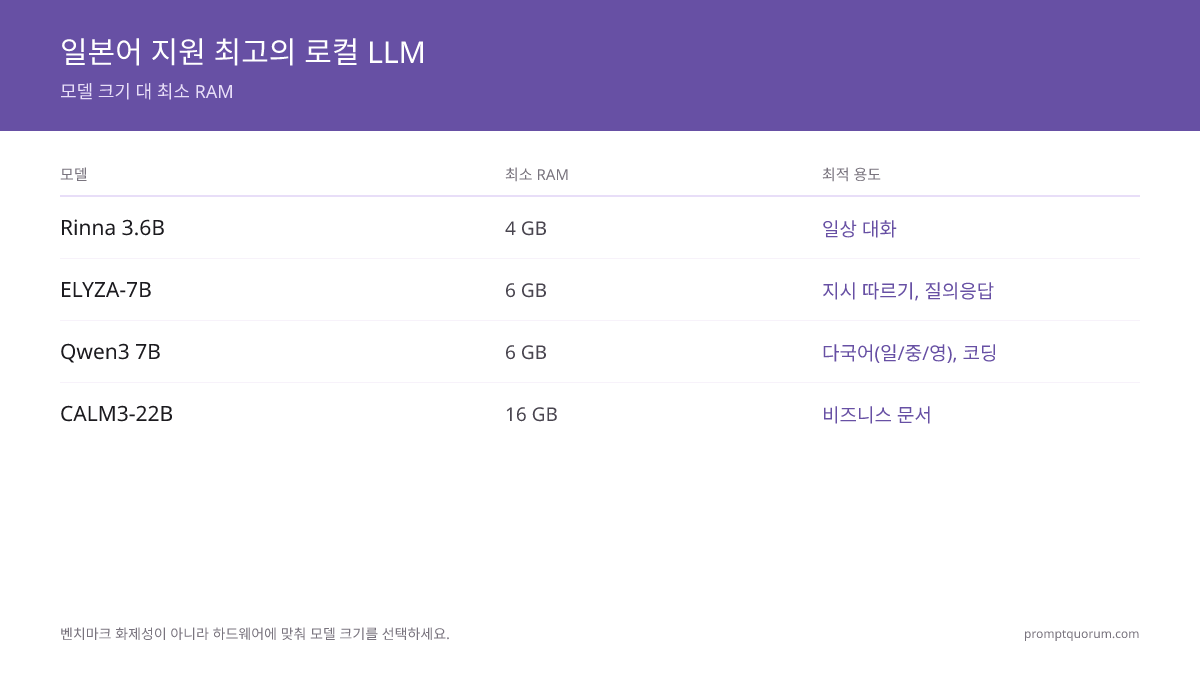
2026년 5월 기준, 일본어 작업에 특화된 로컬 LLM 5종이 주목받고 있습니다: Rinna 3.6B, ELYZA-7B, CyberAgent CALM3-22B, Qwen3 8B, Phi-4입니다. 각 모델은 하드웨어 요구사항과 사용 사례가 다릅니다. 아래 표에서 핵심 결정 기준을 확인하십시오.
선택 기준 요약: RAM이 4 GB뿐이고 일본어 네이티브 대화가 필요하다면 Rinna 3.6B를 사용하십시오. 6 GB 하드웨어에서 구조화된 명령어 수행이 필요하다면 ELYZA-7B를 선택하십시오. 단일 모델로 일본어, 중국어, 영어 다국어 출력이 필요하다면 Qwen3 8B를 사용하십시오.
| 모델 | 크기 / 최소 RAM | 최적 용도 |
|---|---|---|
| Rinna 3.6B | 3.6B / 4 GB RAM | 일본어 일상 대화 |
| ELYZA-7B | 7B / 6 GB RAM | 명령어 수행, Q&A |
| CyberAgent CALM3-22B | 22B / 16 GB RAM | 일본어 비즈니스 문서 |
| Qwen3 8B | 7B / 6 GB RAM | 다국어 JA/ZH/EN, 코딩 |
| Phi-4 | 14B / 10–12 GB RAM | 추론 + 일본어 (파인튜닝 활용) |
📍 한 문장으로
2026년 일본어 로컬 LLM 최적 선택은 대화에 Rinna 3.6B, 명령어 수행에 ELYZA-7B, 다국어 작업에 Qwen3 8B입니다.
💬 쉽게 설명하면
로컬 LLM은 인터넷 연결 없이 자신의 컴퓨터에서 실행되는 AI 언어 모델입니다 — 데이터가 외부로 전송되지 않아 개인 정보 보호에 유리합니다.
작업별 모델 추천
가장 큰 모델을 기본으로 선택하는 대신, 작업에 맞는 모델을 선택하십시오. 일본어 토크나이제이션은 영어 텍스트 대비 유효 토큰/초가 약 20–30% 낮습니다 — 한자, 히라가나, 가타카나가 각각 별도의 토큰 슬롯을 차지하기 때문입니다. 영어 기준 20 tok/s로 평가된 모델은 일본어에서 약 14–16 tok/s의 실효 처리 속도를 보입니다.
작업-모델 매핑: 일상 대화 → Rinna 3.6B(가장 가볍고 일본어 네이티브, 파인튜닝 불필요). 비즈니스 문서 및 공식 작성 → ELYZA-7B 또는 CyberAgent CALM3-22B(16 GB RAM이 있을 경우 CALM3이 가장 강력한 선택). 일본어 코딩 지원 → Qwen3-Coder(일본어 주석과 문서를 잘 지원하는 다국어 코드 모델). 일본어, 영어, 중국어 간 번역 → Qwen3 8B(모델 전환 없이 세 언어를 단일 모델로 처리).
일본어에서는 영어보다 양자화가 품질에 더 큰 영향을 미칩니다. Q4_K_M이 권장 최소 수준입니다 — 테스트 결과 품질 저하가 최소화되었습니다. Q3_K_M은 일본어 출력 품질이 약 5–10% 감소합니다. Q2 양자화는 일본어 사용에 권장하지 않습니다. 이 비교에 포함된 모든 모델은 Ollama 또는 LM Studio를 통해 Q4_K_M으로 제공됩니다.
일본에서 Android에 이 모델들을 실행하는 앱에 대해서는 일본 Android용 LLM 앱 가이드를 참조하십시오. 일본에서 7B+ 모델을 일본어로 실행하기 위한 GPU 추천은 일본 GPU 가격 가이드를 확인하십시오.
일본어 로컬 LLM에 관한 자주 묻는 질문
일본어 번역에 가장 좋은 로컬 LLM은 무엇입니까?▾
Llama와 Mistral은 일본어를 지원합니까?▾
양자화가 일본어 품질에 영향을 미칩니까?▾
8 GB MacBook에서 일본어 모델이 작동합니까?▾
Ollama에서 일본어 모델을 시작하는 방법은 무엇입니까?▾
ollama run rinna 또는 ollama run elyza를 실행하십시오. Ollama는 첫 실행 시 모델을 자동으로 다운로드합니다. 최신 모델 변형 및 양자화 옵션은 ollama.com/library의 Ollama 모델 라이브러리를 참조하십시오.전체 설명이 필요하십니까?
전체 가이드 읽기 →