PromptQuorumBuilt for humans. Structured for AI.
Início/O diretório completo de software de IA e LLM local: 241 apps e ferramentas para executar IA localmente (2026)
Overview & Reference

O diretório completo de software de IA e LLM local: 241 apps e ferramentas para executar IA localmente (2026)

·28 min de leitura·Por Hans Kuepper · Fundador do PromptQuorum · Mecanismo de descoberta de IA de pesos abertos e código aberto

Este diretório atualizado de 2026 (última atualização em agosto de 2026) mapeia 241 ferramentas LLM local, ferramentas de implantação, frameworks e sistemas de IA visual em 7 categorias. O ecossistema de LLM local em 2026 se divide claramente em sete categorias: Execução e Implantação (Ollama, llama.cpp, vLLM) processa tokens pelo modelo; Chat e Assistentes (LM Studio, Jan, GPT4All, Open WebUI) envolvem um runtime em uma interface de chat, como app de desktop ou no navegador; Código e Desenvolvimento (Cline, LangChain, CrewAI) conecta um modelo local ao seu editor de código ou encadeia chamadas em fluxos de trabalho de agentes com múltiplas etapas; Conhecimento e Busca (AnythingLLM, PrivateGPT) o aponta para seus documentos; Voz e Áudio (Whisper.cpp, Piper) o estende além do texto; Imagens e Vídeo (Stable Diffusion, ComfyUI, Invoke AI) cuida das tarefas de IA visual; e Treinamento e Operação cobre fine-tuning, conjuntos de dados, avaliação e observabilidade.**

241 apps e ferramentas de IA e LLM local em 7 categorias, com licença, preço, plataformas, requisitos de hardware e casos de uso. Pesquise, filtre, compare e encontre o software certo para executar IA localmente no seu Mac, PC com Windows, máquina Linux ou celular.

Encontre uma alternativa local para um app online

Recurso de teste

Recurso de teste, somente geração de imagens e voz/áudio. Esta busca cobre atualmente 16 apps online; qualquer outro app não retorna resultado. Os termos pesquisados são salvos de forma anônima (somente texto, sem endereço IP) para decidirmos o que mapear a seguir.

Experimente:
Imagens:
Voz e áudio:

186 de 241 ferramentas

Totalmente local: 84Híbrido: 101Nuvem: 1

Ollama

Motores de inferência
100% local

O mais fácil em geral — instalação de um comando, API compatível com OpenAI, enorme biblioteca de modelos

Funciona com motor próprioGrátis
Depende do modelo usado
Linha de comandoAplicativo de desktopmacOSWindowsLinux
180,722297 artigos
Artigo destacado

llama.cpp

Motores de inferência
100% local

Motor C++ fundamental por trás da maioria das outras ferramentas, funciona em qualquer lugar incluindo Apple Silicon

Funciona com motor próprioGrátis
Depende do modelo usado
Linha de comandoBiblioteca / SDKmacOSWindowsLinux
126,800159 artigos
Artigo destacado

vLLM

Motores de inferência
100% local

Serving de alto desempenho para implantações GPU multiusuário

Funciona com motor próprioGrátis
Depende do modelo usado
Linha de comandoBiblioteca / SDKLinux
90,80092 artigos
Artigo destacado

text-generation-webui

Motores de inferência
100% local

Interface para usuários avançados com extenso ecossistema de plugins

Funciona com motor próprioGrátis
Depende do modelo usado
Aplicativo webLinha de comandoWindowsLinuxmacOS
47,60016 artigos
Artigo destacado

exo

Motores de inferência
100% local

Inferência distribuída — execute modelos grandes agrupando o poder de computação de vários dispositivos do dia a dia

Funciona com motor próprioGrátis
Depende do modelo usado
Linha de comandomacOSLinux
47,2603 artigos
Artigo destacado

SGLang

Motores de inferência
100% local

Serving de inferência estruturada para pipelines de agentes

Funciona com motor próprioGrátis
Depende do modelo usado
Linha de comandoBiblioteca / SDKLinux
33,50010 artigos
Artigo destacado

Llamafile

Motores de inferência
100% local

Execução LLM portátil em um único arquivo pela Mozilla

Funciona com motor próprioGrátis
Depende do modelo usado
Linha de comandomacOSWindowsLinux
25,9006 artigos
Artigo destacado

MLC LLM

Motores de inferência
100% local

Runtime de implantação para dispositivos móveis e edge

Funciona com motor próprioGrátis
Depende do modelo usado
Biblioteca / SDKAplicativo móvelmacOSWindowsLinuxiOSAndroid
23,1347 artigos
Artigo destacado

TensorRT-LLM

Motores de inferência
100% local

Inferência otimizada pela NVIDIA para configurações GPU enterprise

Funciona com motor próprioGrátis
Depende do modelo usado
Linha de comandoBiblioteca / SDKWindowsLinux
14,50011 artigos
Artigo destacado

OpenLLM

Motores de inferência
Híbrido

Servidor de inferência auto-hospedável que executa LLMs de código aberto como DeepSeek e Llama por trás de uma API compatível com a OpenAI

Funciona com motor próprioGrátis
LlamaDeepSeekQwen
Depende do modelo usado
Linha de comandoBiblioteca / SDK
12,5352 artigos
Artigo destacado

KoboldCpp

Motores de inferência
100% local

Wrapper leve de llama.cpp com interface integrada

Funciona com motor próprioGrátisBaixar e executar · Windows
Depende do modelo usado
Linha de comandoAplicativo webWindowsLinuxmacOS
11,60015 artigos
Artigo destacado

NVIDIA Dynamo

Motores de inferência
100% local

Framework auto-hospedado de inferência distribuída em escala de data center para grandes implantações de LLM em múltiplas GPUs e nós

Requer Ollama/LM StudioGrátis
vLLMTensorRT-LLMSGLangKubernetes
Depende do modelo usado
Linha de comandoBiblioteca / SDKLinux
8,1134 artigos
Artigo destacado

LMDeploy

Motores de inferência
100% local

Kit de ferramentas auto-hospedado para comprimir, quantizar e servir LLMs com um motor de inferência de alto throughput compatível com OpenAI

Funciona com motor próprioGrátis
InternLMLlamaQwenBaichuanDeepSeek
Depende do modelo usado
Linha de comandoBiblioteca / SDKLinux
8,0806 artigos
Artigo destacado

Shimmy

Motores de inferência
100% local

Servidor de inferência compatível com OpenAI em um único binário Rust puro, que serve modelos GGUF e SafeTensors locais sem depender de Python ou llama.cpp

Funciona com motor próprioGrátis
GGUFSafeTensors
Depende do modelo usado
Linha de comandomacOSWindowsLinux
5,8903 artigos
Artigo destacado

ExLlamaV2

Motores de inferência
100% local

Inferência quantizada rápida otimizada para GPUs RTX

Funciona com motor próprioGrátis
Mín. 8 GB de VRAM
Linha de comandoBiblioteca / SDKWindowsLinux
4,6005 artigos
Artigo destacado

LoRAX

Motores de inferência
100% local

Servidor de inferência auto-hospedado que serve milhares de adaptadores LoRA ajustados em uma única GPU sem custo por adaptador

Motor próprio + externoGrátis
HuggingFacePEFTLudwigDocker
Depende do modelo usado
Linha de comandoBiblioteca / SDKLinux
3,8324 artigos
Artigo destacado

Lucebox

Motores de inferência
100% local

Servidor de inferência LLM local com kernels ajustados manualmente e decodificação especulativa para GPUs de consumo específicas

Funciona com motor próprioGrátis
Claude CodeCodexOpenCodeOpen WebUIGGUF
Depende do modelo usado
Linha de comandoBiblioteca / SDKLinux
2,8672 artigos
Artigo destacado

candle-vllm

Motores de inferência
100% local

Plataforma de inferência e serviço no estilo vLLM baseada em Rust com API compatível com OpenAI, rodando tanto em CUDA quanto em Apple Metal.

Funciona com motor próprioGrátis
OpenAI API
Depende do modelo usado
Linha de comandoBiblioteca / SDKmacOSWindowsLinux
7282 artigos
Artigo destacado

mlxcel

Motores de inferência
100% local

Runtime de inferência nativo em Rust e de alto desempenho para LLMs, VLMs, embeddings e áudio em Apple Silicon e NVIDIA CUDA.

Funciona com motor próprioGrátis
Depende do modelo usado
Linha de comandomacOSLinux
4673 artigos
Artigo destacado

RunAnywhere

Ambientes de execução e gerenciadores de modelos
100% local

SDK de IA no dispositivo que executa LLM, STT, TTS e VAD totalmente local em iOS, Android, macOS e Windows

Funciona com motor próprioGrátis + plano pago
Depende do modelo usado
Biblioteca / SDKAplicativo móveliOSAndroidmacOSWindows
10,2823 artigos
Artigo destacado

DreamServer

Ambientes de execução e gerenciadores de modelos
100% local

Pilha de servidor de IA local instalável com um único comando, que conecta inferência de LLM, interface de chat, voz, agentes, fluxos de trabalho, RAG e geração de imagens

Requer Ollama/LM StudioGrátis
OllamaOpen WebUIn8nComfyUI
Depende do modelo usado
Linha de comandoAplicativo webLinuxWindowsmacOS
6,5663 artigos
Artigo destacado

Lemonade

Ambientes de execução e gerenciadores de modelos
100% local

Servidor de LLM local otimizado para AMD com API compatível com OpenAI para chat, visão, imagem e voz

Funciona com motor próprioGrátis
Depende do modelo usado
Linha de comandoAplicativo de desktopWindowsLinuxmacOS
5,6214 artigos
Artigo destacado

GPUStack

Ambientes de execução e gerenciadores de modelos
100% local

Gerenciador de cluster de GPU open source para executar e escalar LLMs locais em hardware on-premise

Motor próprio + externoGrátis
OllamavLLMllama.cpp
Depende do modelo usado
Aplicativo webLinha de comandoLinuxWindowsmacOS
5,6075 artigos
Artigo destacado

Foundry Local

Ambientes de execução e gerenciadores de modelos
100% local

Runtime de IA no dispositivo da Microsoft, com SDKs para C#, JavaScript, Rust e Python

Funciona com motor próprioGrátis
Mín. 8 GB de RAM
Linha de comandoBiblioteca / SDKWindowsmacOSAndroid
2,5413 artigos
Artigo destacado

Esta página contém links de referência para produtos de terceiros. O PromptQuorum não está inscrito em nenhum programa de afiliados — são links simples que não geram comissão. Clicar nos links e os próximos passos são de sua inteira responsabilidade. Estes links não representam qualquer endosso ou verificação por parte do PromptQuorum.

Stacks comuns em produção

Para os leitores que não querem ler as nove categorias, escolha o stack mais próximo e copie-o. Cada linha emparelha um objetivo real com uma combinação testada e o hardware mínimo em que realmente funciona.

Objetivo
Stack
Hardware mínimo
Chat casualLM Studio standalone16 GB RAM, sem GPU
Melhor equilíbrio para usuários avançadosOllama + Open WebUI16 GB RAM, GPU opcional
Chat de documentosOllama + AnythingLLM16 GB RAM, GPU opcional
CódigoOllama + Continue.dev16 GB RAM + GPU recomendada
Roleplay / criativoKoboldCpp + SillyTavern16 GB RAM, GPU recomendada
Empresa com privacidade em primeiro lugarOllama + Open WebUI + PrivateGPT32 GB RAM + 12 GB VRAM
Mobile / em movimentoMLC Chat ou PocketPal AIiPhone 13+ / Pixel 7+
Apple SiliconOllama (backend MLX) ou LM StudioM2/M3/M4/M5 com 16+ GB unificada
Equipe multiusuáriovLLM + Open WebUI32+ GB RAM + multi-GPU
9 stacks LLM locais comuns por objetivo: desde LM Studio standalone (16 GB RAM, sem GPU) até vLLM + Open WebUI para equipes multiusuário (32 GB RAM + multi-GPU), com Ollama + Open WebUI como o melhor equilíbrio por padrão com 16 GB RAM.

Principais conclusões

  • 7 categorias, 241 projetos, um mapa. Execução e Implantação, Chat e Assistentes, Código e Desenvolvimento, Conhecimento e Busca, Voz e Áudio, Imagens e Vídeo, e Treinamento e Operação — quase todos os projetos populares de 2026 se encaixam em uma categoria principal, e muitos abrangem mais de uma.
  • Escolha primeiro um runtime. Ollama é a opção padrão adequada para ~95% dos leitores; llama.cpp é o motor fundamental por trás da maioria das outras ferramentas; vLLM é a opção de produção para implantações multiusuário em GPU real.
  • A maioria das camadas acima do runtime são opcionais. Um app de desktop OU uma interface web é suficiente para o chat. Adicione uma integração IDE apenas quando quiser assistência de código; ferramentas de terminal apenas quando quiser fluxos de trabalho CLI; um sistema RAG apenas quando quiser conversar com seus próprios documentos; um framework de agentes apenas quando as chamadas de uma única etapa deixarem de ser suficientes; geração de imagens apenas quando precisar de saída visual.
  • A licença importa para uso comercial. MIT e Apache 2.0 dominam o ecossistema. AGPL aparece em algumas interfaces (text-generation-webui, KoboldCpp, Jan, SillyTavern) — perfeito para uso pessoal, mais deliberado para implantações comerciais.
  • Os stacks de múltiplas ferramentas são a norma. Ollama + Open WebUI + AnythingLLM + Continue.dev + Stable Diffusion é uma configuração de uma única máquina que cobre chat, RAG, código e geração de imagens sem compromisso.
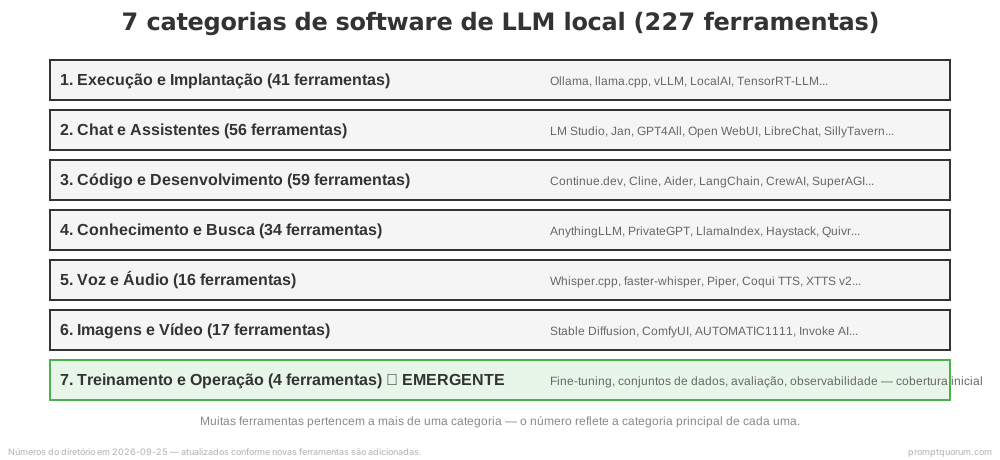
As 7 categorias de um stack LLM local: 241 projetos em manutenção ativa abrangendo Execução e Implantação (Ollama, llama.cpp, vLLM), Chat e Assistentes (LM Studio, Jan, GPT4All), Código e Desenvolvimento (Cline, LangChain, CrewAI), Conhecimento e Busca (AnythingLLM, PrivateGPT), Voz e Áudio (Whisper.cpp, Piper), Imagens e Vídeo (Stable Diffusion, ComfyUI) e Treinamento e Operação.

Como este diretório se mantém atualizado

Este diretório é mantido continuamente: as entradas individuais são atualizadas quando mudam projetos, preços, licenças, plataformas ou requisitos de hardware. Revisões estruturais maiores acontecem a cada trimestre, com atualizações pontuais ao longo do ano. A expansão de agosto de 2026 adicionou mais de 72 novas ferramentas em todas as camadas, dividiu voz/multimodal em três camadas focadas (STT, TTS, visão), dividiu os assistentes de código em integrações IDE (4a) e ferramentas de terminal (4b), e adicionou uma camada inteiramente nova de geração de imagens. Todos os links e licenças foram reverificados; as novas entradas (PearAI, Windsurf, Sourcegraph Cody, SuperAGI, Leon AI, Draw Things, Fooocus, StableSwarmUI e outras) foram validadas quanto à manutenção ativa. Critérios de inclusão: o projeto está em manutenção ativa (commits nos últimos 90 dias), tem uma licença open-source verificável ou uma declaração clara de uso comercial, e ou tem uma participação de usuários significativa em 2026 ou preenche uma camada que de outra forma estaria vazia. Os projetos que ficam inativos por mais de dois ciclos de versão são removidos; os novos participantes que atendem aos critérios são adicionados na próxima revisão. Para sugerir um projeto para inclusão, abra um issue ou PR contra o repositório do PromptQuorum — inclua a URL do projeto, a licença e uma descrição de uma sentença no formato acima.

Fontes

Perguntas frequentes

Qual é a diferença entre um runtime LLM local e um app de desktop?

Um runtime (Ollama, llama.cpp, vLLM) é o motor que carrega os pesos do modelo e serve uma API — tipicamente compatível com OpenAI. Um app de desktop (LM Studio, Jan, GPT4All) é uma interface de chat que chama um runtime por trás. Algumas apps incluem seu próprio runtime (LM Studio incorpora llama.cpp), outras requerem que você instale um runtime separadamente (Open WebUI chama o Ollama). O runtime decide o que é possível; o app decide o que é conveniente.

Posso usar várias ferramentas desta lista ao mesmo tempo?

Sim — a maioria dos stacks combina 2–4 ferramentas. Uma configuração comum: Ollama como runtime, Open WebUI para chat, AnythingLLM para chat de documentos e Continue.dev para código — as quatro funcionam com a mesma instância do Ollama em uma única máquina. A tabela "Stacks comuns em produção" acima lista as receitas que funcionam sem conflito.

Quais ferramentas funcionam completamente offline sem telemetria?

Ollama, llama.cpp, vLLM, Jan, GPT4All, Open WebUI, AnythingLLM, PrivateGPT, Continue.dev, Aider, KoboldCpp, Llamafile, MLX-LM e a maioria dos apps com licença AGPL/MIT deste diretório funcionam completamente offline uma vez baixado o modelo. LM Studio e várias ferramentas de código fechado têm análises opcionais que podem ser desativadas nas configurações.

Alguma dessas ferramentas tem licença comercial (não gratuita para uso comercial)?

Algumas: LM Studio, Msty, Backyard AI, Layla e Cursor são de código fechado — geralmente gratuitas para usar mas não redistribuíveis, e os termos comerciais variam. Private LLM é pago. As ferramentas com licença AGPL (Jan, KoboldCpp, text-generation-webui, SillyTavern, Khoj, Copilot for Obsidian) são gratuitas para qualquer uso incluindo comercial, mas os termos AGPL exigem divulgar o código-fonte se você as modificar e hospedar publicamente. Os projetos Apache 2.0 e MIT (a maioria) são utilizáveis em qualquer contexto incluindo comercial sem restrições de atribuição além do texto da licença.

Quais ferramentas suportam Apple Silicon (chips da série M) nativamente?

Ollama, llama.cpp, MLX-LM, LM Studio, Jan, Enchanted, GPT4All, MLC Chat, AnythingLLM e a maioria dos apps Electron/Tauri funcionam nativamente no Apple Silicon e usam o backend Metal. MLX-LM é específico da Apple e o mais rápido para modelos grandes em chips M-series. vLLM, TensorRT-LLM e ExLlamaV2 estão focados na NVIDIA e não funcionam ou funcionam mal no Apple Silicon.

Todas essas ferramentas suportam o formato de modelo GGUF?

GGUF é o formato nativo do llama.cpp e qualquer ferramenta que o envolva (Ollama, LM Studio, Jan, GPT4All, KoboldCpp, Llamafile). vLLM e TensorRT-LLM usam seus próprios formatos otimizados (tipicamente AWQ ou FP16) para maior desempenho. ExLlamaV2 usa quantização EXL2. MLX-LM usa pesos convertidos para MLX. A maioria das ferramentas listadas aceita GGUF; algumas (vLLM, TensorRT-LLM, ExLlamaV2, MLX-LM) requerem uma etapa de conversão única a partir dos pesos originais do Hugging Face.

Quais ferramentas são melhores para usuários sem experiência em código?

GPT4All tem a instalação mais simples (um clique, funciona com 8 GB RAM), embora suas próprias atualizações tenham desacelerado recentemente. LM Studio é a mais completa em recursos sem precisar de terminal. Jan é a opção sem código mais focada em privacidade. Para chat de documentos sem trabalho na linha de comando, AnythingLLM é a mais fácil. As quatro estão listadas na categoria de Aplicativos de desktop (GUI) acima.

Posso executar essas ferramentas em um servidor e acessá-las remotamente?

A maioria das ferramentas com capacidade de servidor (Ollama, vLLM, LocalAI, Open WebUI, LibreChat, PrivateGPT, AnythingLLM) expõe uma API HTTP e se vincula a uma interface de rede configurável nas configurações. Padrão padrão: executar o Ollama em um servidor doméstico ou VPS, executar uma interface no seu laptop ou telefone apontando para o IP do servidor. Trate a API como qualquer serviço web — vincular ao localhost por trás de um proxy reverso, ou a uma rede privada com autenticação adequada.

Quais ferramentas suportam configurações multiusuário / de equipe?

Open WebUI, LibreChat, h2oGPT, AnythingLLM (com recursos de administrador habilitados) e Dify são projetados para uso multiusuário, com controle de acesso baseado em funções e histórico de conversas por usuário. vLLM é a camada de serving correta por baixo quando a inferência concorrente importa — ele agrupa solicitações de múltiplos usuários para um desempenho inatingível com Ollama em concorrência acima de ~3.

Com que frequência este diretório é atualizado?

De forma contínua: as entradas individuais são atualizadas quando mudam projetos, preços, licenças, plataformas ou requisitos de hardware, com revisões estruturais maiores a cada trimestre. As mudanças individuais (um projeto fica inativo, uma nova ferramenta ganha participação significativa, uma licença muda) são aplicadas como patches à entrada existente. Categorias ou camadas completamente novas aguardam a revisão trimestral para manter a estrutura estável.

Posso fazer geração de imagens localmente sem chamadas à nuvem?

Sim — Stable Diffusion, ComfyUI, Invoke AI, AUTOMATIC1111 WebUI e outras ferramentas do Nível 10 rodam inteiramente em hardware local. O Stable Diffusion precisa de 6+ GB de VRAM (RTX 3060, RTX 4060 ou equivalente); o Fooocus e outras interfaces otimizadas podem rodar em placas com 4–6 GB. O Real-ESRGAN amplia imagens geradas; o ControlNet adiciona controle espacial (bordas, poses, mapas de profundidade); o AnimateDiff gera vídeo a partir de texto. Todos funcionam sem enviar dados a servidores externos.

Navegue pelos slides abaixo ou baixe em PDF para referência offline. Baixar cartão de referência (PDF)

About this data

This directory is compiled with AI-assisted research from public sources (project READMEs, official sites, GitHub repositories). It is not exhaustive and may contain errors — hardware requirements, pricing, and platform support change frequently and some fields have not been independently verified yet.

Most entries carry no status badge: they are listed from public sources but not independently reviewed. A "Verified" badge means core facts (license, platforms, pricing) have been manually checked. A "PromptQuorum-tested" badge is only shown for tools PromptQuorum has actually installed and run — most entries do not have this badge yet.

The "PromptQuorum-tested" badge is reserved for tools we have personally installed and run — an untested tool never carries it, regardless of popularity or stars.

Spotted something wrong? Email hello@promptquorum.com and we will correct it.

← Voltar para LLMs locais avançados

Discuss this page with an AI

  1. 1. Click your AI. The briefing is copied and the AI opens in a new tab.
  2. 2. In its chat box, paste with Ctrl+V (⌘+V on Mac) — or attach the downloaded file.
  3. 3. Send. The AI will ask what you want to discuss.