O que é o Haystack?
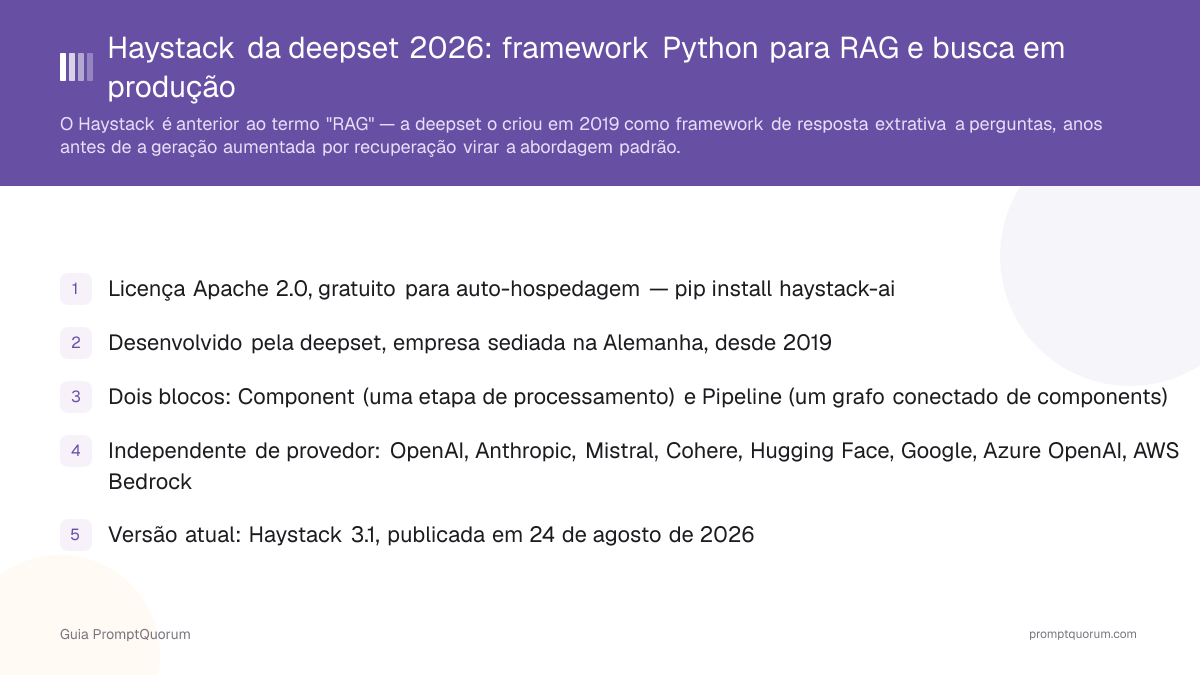
Haystack é um framework Python de código aberto (Apache 2.0, github.com/deepset-ai/haystack) para construir aplicações de busca, perguntas e respostas, e geração aumentada por recuperação (RAG). É mantido pela deepset, empresa sediada na Alemanha, e instalado via pip install haystack-ai.
- Iniciado em 2019 como framework de resposta extrativa a perguntas — encontrar o trecho exato da resposta dentro de um documento — antes de os LLMs generativos tornarem o RAG o padrão dominante
- Reescrito profundamente em torno do Haystack 2.0 rumo à arquitetura Component/Pipeline atual, agora na versão 3.2.0 (publicada em 24/09/2026)
- Traz components para conversão de documentos (PDF, HTML, DOCX), divisão de texto, embedding, retrieval (por palavra-chave BM25 e vetorial/semântico), geração e avaliação
- A abstração Document Store desacopla a lógica do pipeline do backend de armazenamento — trocar o store em memória por Elasticsearch, Weaviate ou Pinecone sem reescrever o pipeline
- Traz um document store em memória pronto para uso em desenvolvimento local e testes, sem exigir banco de dados externo para começar
- Suporta retrieval por palavra-chave (BM25) e vetorial/semântico no mesmo pipeline, além de retrieval híbrido combinando os dois
Como funciona a arquitetura Pipeline/Component do Haystack?
Uma Component é uma única etapa de processamento (um retriever, um embedder, um gerador), e um Pipeline é um grafo direcionado de components conectadas por chamadas explícitas .add_component() e .connect(), deixando o fluxo de dados entre etapas visível no código em vez de escondido em um objeto de cadeia.
- Pipelines são serializáveis em YAML — um pipeline construído em Python pode ser salvo, versionado e recarregado sem reexecutar o código que o construiu
- Ramificação e fusão são nativas do modelo de grafo — a saída de um retriever pode alimentar dois geradores diferentes, ou dois retrievers podem alimentar um ranker, sem código de ligação extra
- Como as conexões são explícitas, um pipeline quebrado (tipos incompatíveis, conexão ausente) falha no momento de construir o pipeline com um erro claro, em vez de falhar em tempo de execução no fundo de uma pilha de chamadas
Component
Uma Component encapsula uma unidade de trabalho — recuperar documentos, gerar embeddings de texto, construir um prompt, chamar um LLM, converter um arquivo. Cada component declara entradas e saídas tipadas, então uma component que produz uma lista de objetos Document só pode se conectar a uma entrada que aceite esse tipo. Components personalizadas podem ser escritas herdando da classe base Component e definindo run().
Pipeline
Uma instância Pipeline contém as components e as conexões entre elas. pipeline.add_component("nome", instancia_component) registra cada etapa, e pipeline.connect("origem.saida", "destino.entrada") as conecta. Chamar pipeline.run(...) executa o grafo na ordem de dependências e retorna as saídas de cada component que não foi consumida adiante.
Qual é a diferença entre Haystack e LangChain/LlamaIndex?
Haystack, LangChain e LlamaIndex são frameworks Python code-first, sem construtor visual em seu núcleo open source — a diferença está na abstração central. O Haystack organiza tudo em torno de grafos Pipeline explícitos de Components tipadas; o LlamaIndex organiza em torno de um Index construído sobre seus dados, com objetos Retriever e QueryEngine por cima; o LangChain organiza em torno de chains e, em sua extensão LangGraph, um state graph para agentes.
O modelo Pipeline/Component do Haystack
Cada etapa — retrieval, prompting, geração — é uma Component nomeada conectada em um Pipeline por chamadas .connect() explícitas. Nada é implícito: se duas components não estiverem conectadas, nenhum dado flui entre elas. Isso torna os pipelines fáceis de inspecionar, testáveis component por component e serializáveis em YAML para controle de versão.
O modelo centrado em índice do LlamaIndex
O LlamaIndex se concentra em construir um Index (vetorial, de lista, de árvore ou por palavra-chave) sobre uma coleção de documentos, consultado depois por um Retriever e um QueryEngine. É otimizado para conveniência de ingestão e indexação de dados — poucas linhas indexam uma pasta de arquivos e já permitem consultá-la — com menos da conexão explícita passo a passo do Haystack.
O que isso significa na prática
O grafo explícito do Haystack costuma compensar em sistemas de produção onde é preciso saber exatamente o que roda, em que ordem, e substituir uma etapa (outro retriever, outro gerador) sem mexer no resto. A abstração de índice do LlamaIndex costuma ser mais rápida para prototipar quando a tarefa é "indexar estes dados e me deixar consultá-los".
O Haystack suporta RAG e busca em produção?
Sim — geração aumentada por recuperação e busca em produção são os casos de uso centrais do Haystack, e o framework suporta busca por palavra-chave, busca vetorial e retrieval híbrido no mesmo pipeline.
- Pipelines RAG: um retriever (BM25, vetorial ou híbrido) entrega documentos relevantes a um construtor de prompt, que alimenta um gerador (uma chamada de LLM) — o padrão que este framework antecipou e hoje endereça diretamente
- Retrievers: retrieval por palavra-chave BM25 e retrieval baseado em embedding (vetorial/semântico) são ambos de primeira classe; o retrieval híbrido combina os dois e reordena os resultados combinados
- Document Stores: um store em memória vem pronto para desenvolvimento; implantações em produção se conectam a Elasticsearch, Weaviate, Pinecone ou outros bancos vetoriais suportados pela mesma interface Component
- Agentes: o Haystack inclui components de agente que deixam um modelo decidir qual ferramenta ou etapa do pipeline chamar em seguida, em vez de seguir uma sequência fixa
- Avaliação: o Haystack traz components de avaliação para medir a qualidade de retrieval e geração contra um conjunto de dados rotulado, relevante para busca em produção, onde a relevância precisa ser mensurável
Como construir um primeiro pipeline do Haystack?
Um pipeline RAG mínimo precisa de três components conectadas: um retriever, um construtor de prompt e um gerador, conectados em um objeto Pipeline e executados com uma consulta.
- 1Instalar o pacote: pip install haystack-ai.
- 2Importar as peças necessárias: from haystack import Pipeline, Document; from haystack.components.generators.chat import OpenAIChatGenerator; from haystack.components.retrievers import InMemoryBM25Retriever; from haystack.document_stores.in_memory import InMemoryDocumentStore; from haystack.components.builders import ChatPromptBuilder; from haystack.utils import Secret.
- 3Criar um document store e gravar documentos nele: document_store = InMemoryDocumentStore(), depois document_store.write_documents([Document(content="..."), ...]).
- 4Criar as components: retriever = InMemoryBM25Retriever(document_store=document_store), prompt_builder = ChatPromptBuilder(template=prompt_template, required_variables="*") e llm = OpenAIChatGenerator(api_key=Secret.from_env_var("OPENAI_API_KEY"), model="gpt-4o-mini").
- 5Montar o pipeline: rag_pipeline = Pipeline(), depois rag_pipeline.add_component("retriever", retriever), rag_pipeline.add_component("prompt_builder", prompt_builder) e rag_pipeline.add_component("llm", llm).
- 6Conectar as ligações: rag_pipeline.connect("retriever", "prompt_builder.documents") e rag_pipeline.connect("prompt_builder", "llm").
- 7Executar: results = rag_pipeline.run({"retriever": {"query": question}, "prompt_builder": {"question": question}}).
from haystack import Pipeline, Document
from haystack.components.generators.chat import OpenAIChatGenerator
from haystack.components.retrievers import InMemoryBM25Retriever
from haystack.document_stores.in_memory import InMemoryDocumentStore
from haystack.components.builders import ChatPromptBuilder
from haystack.utils import Secret

document_store = InMemoryDocumentStore()
document_store.write_documents([
    Document(content="My name is Jean and I live in Paris."),
    Document(content="My name is Mark and I live in Berlin."),
    Document(content="My name is Giorgio and I live in Rome."),
])

retriever = InMemoryBM25Retriever(document_store=document_store)
prompt_builder = ChatPromptBuilder(template=prompt_template, required_variables="*")
llm = OpenAIChatGenerator(api_key=Secret.from_env_var("OPENAI_API_KEY"), model="gpt-4o-mini")

rag_pipeline = Pipeline()
rag_pipeline.add_component("retriever", retriever)
rag_pipeline.add_component("prompt_builder", prompt_builder)
rag_pipeline.add_component("llm", llm)
rag_pipeline.connect("retriever", "prompt_builder.documents")
rag_pipeline.connect("prompt_builder", "llm")

results = rag_pipeline.run({"retriever": {"query": question}, "prompt_builder": {"question": question}})
Preciso de uma chave de API da OpenAI para testar o Haystack?
O exemplo acima usa OpenAIChatGenerator, mas o Haystack também tem components geradoras para Hugging Face, Anthropic, Mistral, Cohere, Google, Azure OpenAI e AWS Bedrock, além de integrações com modelos locais — você não fica preso a um único provedor de modelo.
Preciso de um banco de dados vetorial para começar?
Não. O InMemoryDocumentStore não exige nenhum serviço externo e já é suficiente para construir e testar um pipeline localmente. Troque por Elasticsearch, Weaviate ou Pinecone só ao migrar para escala de produção.
Para quem o Haystack é indicado?
O Haystack encaixa em equipes que precisam de controle explícito sobre um pipeline de busca ou RAG em produção e estão confortáveis escrevendo Python — em seu núcleo open source, não é uma ferramenta no-code ou visual.
Use o Haystack se
- Você está construindo um sistema de busca, perguntas e respostas ou RAG em produção onde a qualidade do retrieval precisa ser medida e ajustada, não apenas conectada
- Você quer um grafo de pipeline explícito e inspecionável, testável component por component, em vez de uma cadeia implícita
- Você precisa trocar retrievers, document stores ou provedores de modelo sem reescrever o resto do pipeline
- Você está confortável com Python e quer um framework, não um produto hospedado — o Haystack é auto-hospedado, code-first e gratuito sob Apache 2.0
Evite o Haystack se
- Você quer um construtor no-code ou visual como interface principal — o framework open source é code-first; uma camada visual só existe na Enterprise Platform paga da deepset
- Sua tarefa é mais "indexar esta pasta de arquivos e me deixar consultá-la" com configuração mínima — a API centrada em índice do LlamaIndex costuma chegar mais rápido a uma primeira resposta para esse tipo específico de tarefa
- Você precisa de um framework nativo JavaScript/TypeScript — o SDK open source do Haystack é somente Python
- Você não tem interesse em métricas de qualidade de busca (BM25 vs. vetorial vs. híbrido, avaliação de retrieval) e só quer que um LLM responda perguntas sobre alguns documentos sem ajustes
Haystack vs. alternativas
Os três frameworks abaixo são open source, orientados a Python e com manutenção ativa — a escolha depende de qual abstração central combina com a forma como sua equipe quer raciocinar sobre um pipeline.
Ferramenta | Abstração central | Licença | Melhor para |
|---|---|---|---|
| Haystack | Pipeline de Components tipadas | Apache 2.0 | Busca em produção / RAG mensurável |
| LlamaIndex | Index + Retriever + QueryEngine | MIT | Ingestão e indexação rápidas |
| LangChain | Chains / state graph LangGraph | MIT | Código de ligação de LLM e agentes generalista |
Erros comuns ao avaliar o Haystack
Esses erros vêm de tratar o Haystack como um produto SaaS hospedado, ou como um substituto direto da abstração de outro framework.
Erro 1: presumir que o Haystack é um produto hospedado
O framework open source (pip install haystack-ai) é código auto-hospedado, não um SaaS por assinatura. As ofertas comerciais da deepset — Haystack Enterprise Platform e Haystack Enterprise Starter — são camadas pagas separadas sobre o mesmo núcleo open source, não um requisito para usá-lo.
Erro 2: esperar a conveniência "indexar uma pasta em três linhas" do LlamaIndex
O modelo Pipeline/Component explícito do Haystack troca parte dessa conveniência de início rápido por visibilidade e controle. Se a tarefa é puramente "apontar para uma pasta e começar a consultar", espere mais configuração do que na API centrada em índice do LlamaIndex — o ganho aparece depois, quando é preciso trocar ou depurar uma etapa em produção.
Erro 3: ignorar a escolha do Document Store até a produção
O InMemoryDocumentStore é conveniente para desenvolvimento, mas não foi feito para escala ou persistência em produção. Decida o Document Store de produção (Elasticsearch, Weaviate, Pinecone ou outro backend suportado) cedo, já que o comportamento do retriever e a estratégia de indexação podem variar conforme o backend.
Perguntas frequentes
O que é o Haystack?
Haystack é um framework Python de código aberto da deepset, empresa sediada na Alemanha, para pipelines de busca, perguntas e respostas, e RAG. Tem licença Apache 2.0 e é instalado via pip install haystack-ai.
Quem desenvolve o Haystack?
A deepset, empresa sediada na Alemanha. A deepset iniciou o Haystack em 2019 como framework de resposta extrativa a perguntas, antes de a geração aumentada por recuperação virar um termo comum.
Sob qual licença o Haystack é publicado?
Apache License 2.0. O código-fonte está em github.com/deepset-ai/haystack e pode ser usado, modificado e auto-hospedado livremente.
Qual é a versão atual do Haystack?
Haystack 3.2.0, publicada em 24 de setembro de 2026. O framework foi profundamente reescrito em torno do Haystack 2.0 rumo à arquitetura Component/Pipeline atual.
Qual é a diferença entre uma Component e um Pipeline no Haystack?
Uma Component é uma única etapa de processamento — um retriever, um embedder, um construtor de prompt ou um gerador. Um Pipeline é um grafo de components conectadas por chamadas explícitas .add_component() e .connect(); executar o pipeline percorre o grafo na ordem de dependências.
Qual é a diferença entre Haystack e LlamaIndex?
O Haystack organiza pipelines em torno de Components explícitas e tipadas, conectadas em um grafo Pipeline. O LlamaIndex organiza em torno de construir um Index sobre seus dados e consultá-lo por um Retriever e um QueryEngine. O LlamaIndex costuma ser mais rápido para começar a indexar dados; o grafo explícito do Haystack oferece mais visibilidade e controle para pipelines em produção.
Qual é a diferença entre Haystack e LangChain?
Ambos são frameworks Python code-first sem construtor visual em seu núcleo open source. O LangChain gira em torno de chains e, via LangGraph, de um state graph para agentes. O Haystack gira em torno de um Pipeline de Components tipadas, tratando retrieval e busca como preocupações de primeira classe e mensuráveis, não como um elo de uma cadeia generalista.
O Haystack exige um banco de dados vetorial específico?
Não. O Haystack traz um Document Store em memória para desenvolvimento e se integra a vários bancos vetoriais e backends de busca, incluindo Elasticsearch, Weaviate e Pinecone, pela mesma interface Component — trocar de backend não exige reescrever o pipeline.
O que é a Haystack Enterprise Platform da deepset?
É a oferta comercial paga da deepset construída sobre o framework open source Haystack, adicionando um construtor visual de pipeline e opções de implantação gerenciada ou auto-hospedada. É separada do framework open source gratuito e auto-hospedado sob Apache 2.0 abordado nesta análise.