Haystackとは何か?
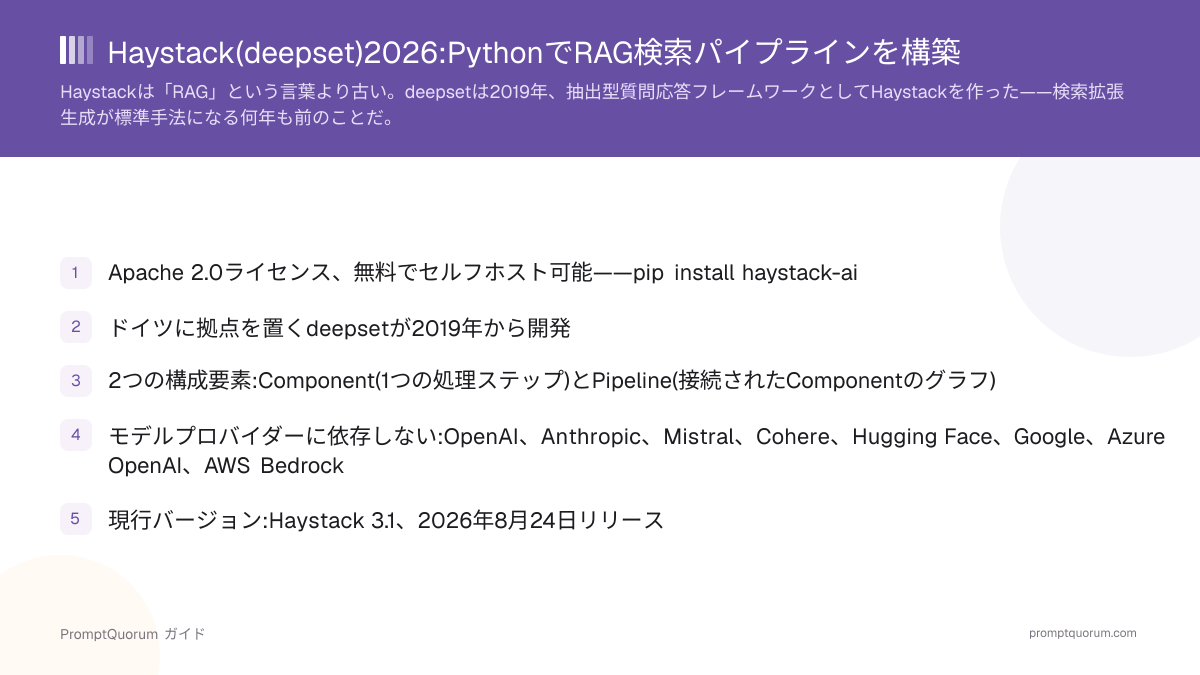
Haystackは検索・質問応答・検索拡張生成(RAG)アプリケーションを構築するためのオープンソースPythonフレームワーク(Apache 2.0、github.com/deepset-ai/haystack)。ドイツに拠点を置くdeepsetが保守しており、pip install haystack-aiでインストールする。
- 2019年に抽出型質問応答フレームワークとしてスタート——文書内から正確な回答箇所を見つける仕組み——生成AIがRAGを主流パターンにする前のこと
- Haystack 2.0前後で現行のComponent/Pipelineアーキテクチャへ大幅に書き換えられ、現在はバージョン3.2.0(2026年9月24日リリース)
- 文書変換(PDF、HTML、DOCX)、テキスト分割、embedding、retrieval(キーワードベースのBM25とベクトル/セマンティック)、生成、評価のためのComponentを提供
- Document Store抽象化がパイプラインロジックとストレージバックエンドを分離——パイプラインを書き換えずにインメモリストアをElasticsearch、Weaviate、Pineconeに差し替え可能
- ローカル開発・テスト向けにインメモリのdocument storeを標準搭載しており、外部データベースなしで始められる
- 同じパイプライン内でキーワードretrieval(BM25)とベクトル/セマンティックretrievalの両方に対応、両者を組み合わせたハイブリッドretrievalも可能
HaystackのPipeline/Componentアーキテクチャの仕組みは?
Componentは1つの処理ステップ(retriever、embedder、generatorなど)であり、Pipelineは.add_component()と.connect()の明示的な呼び出しで接続されたComponentの有向グラフだ。ステップ間のデータフローはコード上で可視化されており、チェーンオブジェクトの中に隠れていない。
- Pipelineはyamlへシリアライズ可能——Pythonで構築したpipelineを保存・バージョン管理し、構築コードを再実行せずに再読み込みできる
- 分岐と合流はグラフモデルにネイティブで対応——1つのretrieverの出力を2つの異なるgeneratorへ渡したり、2つのretrieverを1つのrankerへ渡したりでき、追加の接着コードは不要
- 接続が明示的なため、壊れたpipeline(型の不一致、接続漏れ)はコールスタックの奥深くで実行時に失敗するのではなく、pipeline構築時に明確なエラーで失敗する
Component
Componentは1つの作業単位をカプセル化する——文書の取得、テキストのembedding、プロンプトの構築、LLMの呼び出し、ファイルの変換など。各Componentは型付きの入出力を宣言するため、Documentオブジェクトのリストを出力するComponentは、その型を受け付ける入力にしか接続できない。カスタムComponentは、基底クラスComponentを継承しrun()を定義することで作成できる。
Pipeline
Pipelineインスタンスは各Componentとその接続を保持する。pipeline.add_component("名前", component_instance)で各ステップを登録し、pipeline.connect("出力元.出力", "接続先.入力")で配線する。pipeline.run(...)を呼び出すと依存関係の順序でグラフが実行され、下流で消費されなかった各Componentの出力が返される。
HaystackはLangChain・LlamaIndexと何が違うか?
Haystack、LangChain、LlamaIndexはいずれもコードファーストのPythonフレームワークで、オープンソースの中核にビジュアルビルダーは無い——違いは中心となる抽象化にある。Haystackは型付きComponentの明示的なPipelineグラフを中心に構築される。LlamaIndexは自分のデータ上に構築したIndexを中心に、RetrieverとQueryEngineオブジェクトをその上に置く。LangChainはchainを中心に、LangGraph拡張ではエージェント向けのstate graphを中心にする。
HaystackのPipeline/Componentモデル
retrieval、prompting、生成といった各ステップは名前付きComponentであり、.connect()呼び出しで明示的にPipelineへ配線される。暗黙の挙動は無い——2つのComponentが接続されていなければ、データはその間を流れない。これによりpipelineは検査しやすく、Component単位でユニットテストでき、バージョン管理のためにyamlへシリアライズできる。
LlamaIndexのインデックス中心モデル
LlamaIndexは、文書コレクション上にIndex(ベクトル、リスト、ツリー、キーワード)を構築し、RetrieverとQueryEngineを通じてそれを問い合わせることを中心にしている。データの取り込みとインデックス化の手軽さに最適化されており、数行のコードでフォルダ内のファイルをインデックス化して問い合わせを始められる——Haystackほど明示的なステップごとの配線は要求されない。
実務上の意味
Haystackの明示的なグラフは、何が・どの順序で実行されるかを正確に把握し、他を触らずに1ステップ(別のretriever、別のgenerator)を差し替える必要がある本番システムで効果を発揮しやすい。LlamaIndexのインデックス抽象化は「このデータをインデックス化してすぐ問い合わせたい」というタスクではプロトタイピングが速い傾向がある。
HaystackはRAGと本番検索に対応しているか?
はい——検索拡張生成と本番検索はHaystackの中核ユースケースであり、同じpipeline内でキーワード検索、ベクトル検索、ハイブリッドretrievalに対応する。
- RAGパイプライン:retriever(BM25、ベクトル、またはハイブリッド)が関連文書をprompt builderへ渡し、それがgenerator(LLM呼び出し)へ渡る——このフレームワークが用語の登場前から先取りし、今では直接ターゲットとしている標準パターン
- Retriever:BM25キーワードretrievalとembeddingベースの(ベクトル/セマンティック)retrievalはどちらも一級市民として扱われる。ハイブリッドretrievalは両者を組み合わせ、統合結果を再ランキングする
- Document Store:開発用にインメモリストアが標準搭載。本番デプロイでは同じComponentインターフェースを通じてElasticsearch、Weaviate、Pineconeなど対応するベクトルデータベースに接続する
- エージェント:Haystackにはエージェント用Componentが含まれ、固定シーケンスに従う代わりに、次にどのツールやpipelineステップを呼ぶかをモデルに判断させられる
- 評価:Haystackはラベル付きデータセットに対してretrievalと生成の品質を測定する評価用Componentを提供する——関連性を測定可能にする必要がある本番検索で重要
最初のHaystackパイプラインの作り方は?
最小構成のRAGパイプラインには、retriever、prompt builder、generatorという3つの接続されたComponentが必要で、これらをPipelineオブジェクトに配線し、クエリで実行する。
- 1パッケージをインストール:pip install haystack-ai。
- 2必要な要素をインポート:from haystack import Pipeline, Document; from haystack.components.generators.chat import OpenAIChatGenerator; from haystack.components.retrievers import InMemoryBM25Retriever; from haystack.document_stores.in_memory import InMemoryDocumentStore; from haystack.components.builders import ChatPromptBuilder; from haystack.utils import Secret。
- 3document storeを作成し、文書を書き込む:document_store = InMemoryDocumentStore()、続いて document_store.write_documents([Document(content="..."), ...])。
- 4Componentを作成:retriever = InMemoryBM25Retriever(document_store=document_store)、prompt_builder = ChatPromptBuilder(template=prompt_template, required_variables="*")、llm = OpenAIChatGenerator(api_key=Secret.from_env_var("OPENAI_API_KEY"), model="gpt-4o-mini")。
- 5パイプラインを組み立てる:rag_pipeline = Pipeline()、続いて rag_pipeline.add_component("retriever", retriever)、rag_pipeline.add_component("prompt_builder", prompt_builder)、rag_pipeline.add_component("llm", llm)。
- 6接続を配線:rag_pipeline.connect("retriever", "prompt_builder.documents") と rag_pipeline.connect("prompt_builder", "llm")。
- 7実行:results = rag_pipeline.run({"retriever": {"query": question}, "prompt_builder": {"question": question}})。
from haystack import Pipeline, Document
from haystack.components.generators.chat import OpenAIChatGenerator
from haystack.components.retrievers import InMemoryBM25Retriever
from haystack.document_stores.in_memory import InMemoryDocumentStore
from haystack.components.builders import ChatPromptBuilder
from haystack.utils import Secret

document_store = InMemoryDocumentStore()
document_store.write_documents([
    Document(content="My name is Jean and I live in Paris."),
    Document(content="My name is Mark and I live in Berlin."),
    Document(content="My name is Giorgio and I live in Rome."),
])

retriever = InMemoryBM25Retriever(document_store=document_store)
prompt_builder = ChatPromptBuilder(template=prompt_template, required_variables="*")
llm = OpenAIChatGenerator(api_key=Secret.from_env_var("OPENAI_API_KEY"), model="gpt-4o-mini")

rag_pipeline = Pipeline()
rag_pipeline.add_component("retriever", retriever)
rag_pipeline.add_component("prompt_builder", prompt_builder)
rag_pipeline.add_component("llm", llm)
rag_pipeline.connect("retriever", "prompt_builder.documents")
rag_pipeline.connect("prompt_builder", "llm")

results = rag_pipeline.run({"retriever": {"query": question}, "prompt_builder": {"question": question}})
Haystackを試すのにOpenAIのAPIキーは必要か?
上の例ではOpenAIChatGeneratorを使っているが、HaystackにはHugging Face、Anthropic、Mistral、Cohere、Google、Azure OpenAI、AWS Bedrock向けのgenerator Componentもあり、ローカルモデル連携も存在する——1つのモデルプロバイダーに縛られることはない。
始めるのにベクトルデータベースは必要か?
不要。InMemoryDocumentStoreは外部サービスを必要とせず、ローカルでpipelineを構築・テストするには十分。本番規模へ移行する段階でElasticsearch、Weaviate、Pineconeなどに差し替えればよい。
Haystackはどんな人に向いているか?
Haystackは、本番の検索・RAGパイプラインを明示的に制御する必要があり、Pythonでのコーディングに抵抗が無いチームに向いている——オープンソースの中核部分はノーコードやビジュアルツールではない。
こんな場合はHaystackを使う
- retrieval品質を単に接続するだけでなく、測定・調整する必要がある本番の検索・質問応答・RAGシステムを構築している
- 暗黙のチェーンではなく、Component単位でテストできる明示的で検査可能なpipelineグラフが欲しい
- パイプラインの他の部分を書き換えずに、retriever、document store、モデルプロバイダーを差し替える必要がある
- Pythonに抵抗が無く、ホスティング型製品ではなくフレームワークが欲しい——Haystackはセルフホスト・コードファーストで、Apache 2.0のもと無料
こんな場合はHaystackを避ける
- ノーコードやビジュアルビルダーを主要インターフェースとして求めている——オープンソースフレームワークはコードファーストで、ビジュアル層はdeepsetの有料Enterprise Platformにしか存在しない
- タスクが「このフォルダ内のファイルをインデックス化して最小限の設定で問い合わせたい」に近い——この種のタスクではLlamaIndexのインデックス中心APIの方が最初の回答に速くたどり着けることが多い
- JavaScript/TypeScriptネイティブのフレームワークが必要——Haystackのオープンソースsdkはpythonのみ
- 検索品質の指標(BM25 vs. ベクトル vs. ハイブリッド、retrieval評価)に関心が無く、少数の文書に対してチューニング無しでLLMに質問応答させたいだけ
Haystack vs. 代替ツール
以下の3つのフレームワークはいずれもオープンソースでPython中心、かつ活発に保守されている——選択は、チームがpipelineをどう捉えたいかに合った中心的な抽象化がどれかで決まる。
ツール | 中心的な抽象化 | ライセンス | 最適な用途 |
|---|---|---|---|
| Haystack | 型付きComponentのPipeline | Apache 2.0 | 本番検索/測定可能なRAG |
| LlamaIndex | Index + Retriever + QueryEngine | MIT | 高速なデータ取り込み/索引化 |
| LangChain | Chain / LangGraph state graph | MIT | 汎用LLMアプリ・エージェントの接着コード |
Haystack評価でよくある間違い
これらの間違いは、Haystackをホスティング型SaaS製品として扱ったり、別フレームワークの抽象化の代替品として扱ったりすることから生じる。
間違い1:Haystackをホスティング型製品だと思い込む
オープンソースフレームワーク(pip install haystack-ai)はセルフホスト型のコードであり、契約するSaaSではない。deepsetの商用製品——Haystack Enterprise PlatformとHaystack Enterprise Starter——は同じオープンソースの中核の上にある別個の有料レイヤーであり、利用の前提条件ではない。
間違い2:LlamaIndex流の「3行でフォルダをインデックス化」の手軽さを期待する
Haystackの明示的なPipeline/Componentモデルは、その手軽さの一部を可視性と制御力に置き換える。タスクが単に「フォルダを指定して問い合わせを始める」だけなら、LlamaIndexのインデックス中心APIより多くの設定が必要になる——見返りは、本番で1ステップを差し替えたりデバッグしたりする段階で現れる。
間違い3:Document Storeの選択を本番まで先送りする
InMemoryDocumentStoreは開発には便利だが、本番規模や永続化を想定していない。retrieverの挙動やインデックス化戦略はバックエンドによって異なりうるため、本番用のDocument Store(Elasticsearch、Weaviate、Pinecone、その他対応バックエンド)は早めに決めておく。
よくある質問
Haystackとは何か?
Haystackはドイツに拠点を置くdeepsetによるオープンソースPythonフレームワークで、検索・質問応答・RAGのパイプラインを構築する。ライセンスはApache 2.0で、pip install haystack-aiでインストールする。
誰がHaystackを開発しているか?
ドイツに拠点を置くdeepset。deepsetは2019年、検索拡張生成が一般的な用語になる前に、抽出型質問応答フレームワークとしてHaystackを開始した。
Haystackはどのライセンスで公開されているか?
Apache License 2.0。ソースコードはgithub.com/deepset-ai/haystackにあり、自由に利用・改変・セルフホストできる。
Haystackの現行バージョンは?
Haystack 3.2.0、2026年9月24日リリース。Haystack 2.0前後で現行のComponent/Pipelineアーキテクチャへ大幅に書き換えられた。
HaystackにおけるComponentとPipelineの違いは?
Componentは1つの処理ステップ——retriever、embedder、prompt builder、generatorなど。Pipelineは.add_component()と.connect()の明示的な呼び出しで接続されたComponentのグラフであり、pipelineの実行は依存関係の順序でグラフをたどる。
HaystackはLlamaIndexと何が違うか?
Haystackは明示的で型付きのComponentをPipelineグラフに配線することを中心にパイプラインを組む。LlamaIndexはデータ上にIndexを構築し、RetrieverとQueryEngineを通じて問い合わせることを中心にする。データのインデックス化を始めるのはLlamaIndexの方が概して速く、Haystackの明示的なグラフは本番パイプラインでより高い可視性と制御力を提供する。
HaystackはLangChainと何が違うか?
どちらもコードファーストのPythonフレームワークで、オープンソースの中核にビジュアルビルダーは無い。LangChainはchainを中心に、LangGraphを介してエージェント向けのstate graphを中心にする。Haystackは型付きComponentのPipelineを中心にし、retrievalと検索を汎用チェーンの一部としてではなく、一級市民の測定可能な関心事として扱う。
Haystackは特定のベクトルデータベースを必要とするか?
不要。Haystackは開発用にインメモリのDocument Storeを標準搭載し、Elasticsearch、Weaviate、Pineconeを含む複数のベクトルデータベースや検索バックエンドと同じComponentインターフェースで連携する——バックエンドの切り替えにpipelineの書き換えは不要。
deepsetのHaystack Enterprise Platformとは何か?
オープンソースのHaystackフレームワークの上に構築された、deepsetの有料商用製品で、ビジュアルパイプラインビルダーと、マネージドまたはセルフホストのデプロイオプションを追加する。本レビューが扱う無料・セルフホストのApache 2.0オープンソースフレームワークとは別物である。