¿Qué es Haystack?
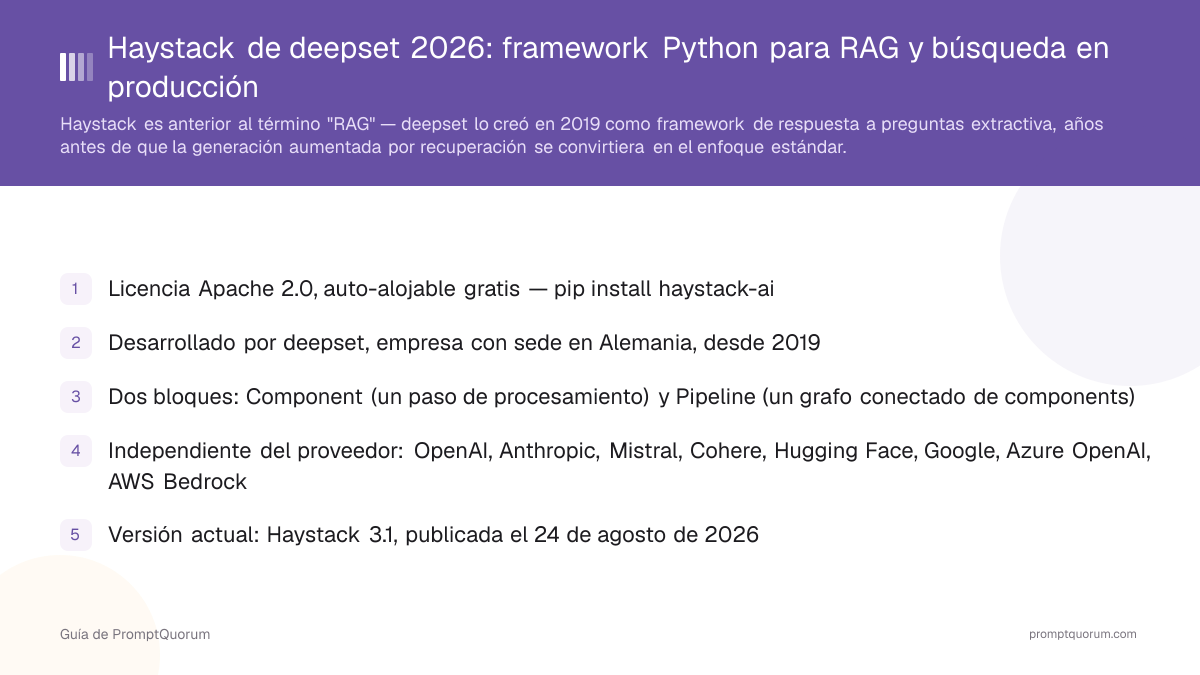
Haystack es un framework Python de código abierto (Apache 2.0, github.com/deepset-ai/haystack) para construir aplicaciones de búsqueda, preguntas y respuestas, y generación aumentada por recuperación (RAG). Lo mantiene deepset, una empresa con sede en Alemania, y se instala con pip install haystack-ai.
- Iniciado en 2019 como framework de respuesta a preguntas extractiva — encontrar el fragmento exacto de la respuesta dentro de un documento — antes de que los LLM generativos convirtieran el RAG en el patrón dominante
- Reescrito a fondo en torno a Haystack 2.0 hacia la arquitectura Component/Pipeline actual, ahora en la versión 3.2.0 (publicada el 24/09/2026)
- Incluye components para conversión de documentos (PDF, HTML, DOCX), división de texto, embedding, retrieval (por palabras clave BM25 y vectorial/semántico), generación y evaluación
- La abstracción Document Store separa la lógica del pipeline del backend de almacenamiento — cambiar el store en memoria por Elasticsearch, Weaviate o Pinecone sin reescribir el pipeline
- Incluye un document store en memoria listo para usar en desarrollo local y pruebas, sin necesidad de una base de datos externa para empezar
- Admite retrieval por palabras clave (BM25) y vectorial/semántico en el mismo pipeline, además de retrieval híbrido que combina ambos
¿Cómo funciona la arquitectura Pipeline/Component de Haystack?
Una Component es un único paso de procesamiento (un retriever, un embedder, un generador), y un Pipeline es un grafo dirigido de components conectadas mediante llamadas explícitas .add_component() y .connect(), de forma que el flujo de datos entre pasos es visible en el código en lugar de estar oculto en un objeto cadena.
- Los pipelines son serializables a YAML — un pipeline construido en Python puede guardarse, versionarse y recargarse sin volver a ejecutar el código que lo construyó
- La ramificación y la fusión son nativas del modelo de grafo — la salida de un retriever puede alimentar a dos generadores distintos, o dos retrievers pueden alimentar a un ranker, sin código adicional de conexión
- Como las conexiones son explícitas, un pipeline roto (tipos incompatibles, conexión faltante) falla en el momento de construir el pipeline con un error claro, no en tiempo de ejecución en lo profundo de una pila de llamadas
Component
Una Component encapsula una unidad de trabajo — recuperar documentos, generar embeddings de texto, construir un prompt, llamar a un LLM, convertir un archivo. Cada component declara entradas y salidas tipadas, de modo que una component que produce una lista de objetos Document solo puede conectarse a una entrada que acepte ese tipo. Se pueden escribir components personalizadas heredando de la clase base Component y definiendo run().
Pipeline
Una instancia Pipeline contiene las components y las conexiones entre ellas. pipeline.add_component("nombre", instancia_component) registra cada paso, y pipeline.connect("origen.salida", "destino.entrada") las conecta. Llamar a pipeline.run(...) ejecuta el grafo en orden de dependencias y devuelve las salidas de cada component que no se consumió aguas abajo.
¿En qué se diferencia Haystack de LangChain y LlamaIndex?
Haystack, LangChain y LlamaIndex son frameworks Python code-first, sin constructor visual en su núcleo open source — la diferencia está en su abstracción central. Haystack organiza todo en torno a grafos Pipeline explícitos de Components tipadas; LlamaIndex organiza en torno a un Index construido sobre los datos, con objetos Retriever y QueryEngine encima; LangChain organiza en torno a chains y, en su extensión LangGraph, un state graph para agentes.
El modelo Pipeline/Component de Haystack
Cada paso — retrieval, prompting, generación — es una Component con nombre conectada en un Pipeline mediante llamadas .connect() explícitas. Nada es implícito: si dos components no están conectadas, no fluyen datos entre ellas. Esto hace que los pipelines sean fáciles de inspeccionar, comprobables component por component y serializables a YAML para control de versiones.
El modelo centrado en el índice de LlamaIndex
LlamaIndex se centra en construir un Index (vectorial, de lista, de árbol o por palabras clave) sobre una colección de documentos, y consultarlo después mediante un Retriever y un QueryEngine. Está optimizado para la comodidad de ingesta e indexación de datos — unas pocas líneas indexan una carpeta de archivos y permiten empezar a consultarla — con menos del cableado explícito paso a paso de Haystack.
Qué significa esto en la práctica
El grafo explícito de Haystack suele merecer la pena en sistemas de producción donde hace falta saber exactamente qué se ejecuta, en qué orden, y sustituir un paso (otro retriever, otro generador) sin tocar el resto. La abstracción de índice de LlamaIndex suele ser más rápida para prototipar cuando la tarea es "indexar estos datos y dejarme consultarlos".
¿Haystack admite RAG y búsqueda en producción?
Sí — la generación aumentada por recuperación y la búsqueda en producción son los casos de uso centrales de Haystack, y el framework admite búsqueda por palabras clave, búsqueda vectorial y retrieval híbrido en el mismo pipeline.
- Pipelines RAG: un retriever (BM25, vectorial o híbrido) entrega documentos relevantes a un constructor de prompts, que alimenta a un generador (una llamada a un LLM) — el patrón estándar que este framework se adelantó a definir y hoy aborda directamente
- Retrievers: el retrieval por palabras clave BM25 y el retrieval basado en embeddings (vectorial/semántico) son ambos de primera clase; el retrieval híbrido combina los dos y reordena los resultados fusionados
- Document Stores: se incluye un store en memoria para desarrollo; los despliegues en producción se conectan a Elasticsearch, Weaviate, Pinecone u otras bases de datos vectoriales compatibles a través de la misma interfaz Component
- Agentes: Haystack incluye components de agente que permiten a un modelo decidir qué herramienta o paso del pipeline llamar a continuación, en lugar de seguir una secuencia fija
- Evaluación: Haystack incluye components de evaluación para medir la calidad del retrieval y la generación frente a un conjunto de datos etiquetado, algo relevante para la búsqueda en producción, donde la relevancia debe ser medible
¿Cómo construir un primer pipeline de Haystack?
Un pipeline RAG mínimo necesita tres components conectadas: un retriever, un constructor de prompts y un generador, conectadas en un objeto Pipeline y ejecutadas con una consulta.
- 1Instalar el paquete: pip install haystack-ai.
- 2Importar las piezas necesarias: from haystack import Pipeline, Document; from haystack.components.generators.chat import OpenAIChatGenerator; from haystack.components.retrievers import InMemoryBM25Retriever; from haystack.document_stores.in_memory import InMemoryDocumentStore; from haystack.components.builders import ChatPromptBuilder; from haystack.utils import Secret.
- 3Crear un document store y escribir documentos en él: document_store = InMemoryDocumentStore(), y luego document_store.write_documents([Document(content="..."), ...]).
- 4Crear las components: retriever = InMemoryBM25Retriever(document_store=document_store), prompt_builder = ChatPromptBuilder(template=prompt_template, required_variables="*") y llm = OpenAIChatGenerator(api_key=Secret.from_env_var("OPENAI_API_KEY"), model="gpt-4o-mini").
- 5Ensamblar el pipeline: rag_pipeline = Pipeline(), y luego rag_pipeline.add_component("retriever", retriever), rag_pipeline.add_component("prompt_builder", prompt_builder) y rag_pipeline.add_component("llm", llm).
- 6Conectar las components: rag_pipeline.connect("retriever", "prompt_builder.documents") y rag_pipeline.connect("prompt_builder", "llm").
- 7Ejecutarlo: results = rag_pipeline.run({"retriever": {"query": question}, "prompt_builder": {"question": question}}).
from haystack import Pipeline, Document
from haystack.components.generators.chat import OpenAIChatGenerator
from haystack.components.retrievers import InMemoryBM25Retriever
from haystack.document_stores.in_memory import InMemoryDocumentStore
from haystack.components.builders import ChatPromptBuilder
from haystack.utils import Secret

document_store = InMemoryDocumentStore()
document_store.write_documents([
    Document(content="My name is Jean and I live in Paris."),
    Document(content="My name is Mark and I live in Berlin."),
    Document(content="My name is Giorgio and I live in Rome."),
])

retriever = InMemoryBM25Retriever(document_store=document_store)
prompt_builder = ChatPromptBuilder(template=prompt_template, required_variables="*")
llm = OpenAIChatGenerator(api_key=Secret.from_env_var("OPENAI_API_KEY"), model="gpt-4o-mini")

rag_pipeline = Pipeline()
rag_pipeline.add_component("retriever", retriever)
rag_pipeline.add_component("prompt_builder", prompt_builder)
rag_pipeline.add_component("llm", llm)
rag_pipeline.connect("retriever", "prompt_builder.documents")
rag_pipeline.connect("prompt_builder", "llm")

results = rag_pipeline.run({"retriever": {"query": question}, "prompt_builder": {"question": question}})
¿Necesito una clave API de OpenAI para probar Haystack?
El ejemplo anterior usa OpenAIChatGenerator, pero Haystack también tiene components generadores para Hugging Face, Anthropic, Mistral, Cohere, Google, Azure OpenAI y AWS Bedrock, además de integraciones con modelos locales — no está atado a un único proveedor de modelos.
¿Necesito una base de datos vectorial para empezar?
No. InMemoryDocumentStore no requiere ningún servicio externo y es suficiente para construir y probar un pipeline en local. Cámbielo por Elasticsearch, Weaviate o Pinecone solo al pasar a escala de producción.
¿Para quién es Haystack?
Haystack encaja con equipos que necesitan control explícito sobre un pipeline de búsqueda o RAG en producción y se sienten cómodos escribiendo Python — no es una herramienta no-code ni visual en su núcleo open source.
Use Haystack si
- Construye un sistema de búsqueda, preguntas y respuestas o RAG en producción donde la calidad del retrieval debe medirse y ajustarse, no solo conectarse
- Quiere un grafo de pipeline explícito e inspeccionable que pueda probar component por component, en vez de una cadena implícita
- Necesita cambiar retrievers, document stores o proveedores de modelos sin reescribir el resto del pipeline
- Se siente cómodo con Python y quiere un framework, no un producto alojado — Haystack es auto-alojado, code-first y gratuito bajo Apache 2.0
Evite Haystack si
- Quiere un constructor no-code o visual como interfaz principal — el framework open source es code-first; una capa visual solo existe en la Enterprise Platform de pago de deepset
- Su tarea se parece más a "indexar esta carpeta de archivos y dejarme consultarla" con la mínima configuración — la API centrada en el índice de LlamaIndex suele llegar antes a una primera respuesta para ese tipo concreto de tarea
- Necesita un framework nativo de JavaScript/TypeScript — el SDK open source de Haystack es solo para Python
- No le interesan las métricas de calidad de búsqueda (BM25 vs. vectorial vs. híbrido, evaluación de retrieval) y solo quiere que un LLM responda preguntas sobre un puñado de documentos sin ajustes
Haystack vs. alternativas
Los tres frameworks siguientes son open source, orientados a Python y con mantenimiento activo — la elección depende de qué abstracción central encaja mejor con cómo su equipo quiere razonar sobre un pipeline.
Herramienta | Abstracción central | Licencia | Mejor para |
|---|---|---|---|
| Haystack | Pipeline de Components tipadas | Apache 2.0 | Búsqueda en producción / RAG medible |
| LlamaIndex | Index + Retriever + QueryEngine | MIT | Ingesta e indexación rápidas |
| LangChain | Chains / state graph LangGraph | MIT | Código de conexión LLM y agentes generalista |
Errores frecuentes al evaluar Haystack
Estos errores vienen de tratar Haystack como un producto SaaS alojado, o como un sustituto directo de la abstracción de otro framework.
Error 1: suponer que Haystack es un producto alojado
El framework open source (pip install haystack-ai) es código auto-alojado, no un SaaS al que se suscribe. Las ofertas comerciales de deepset — Haystack Enterprise Platform y Haystack Enterprise Starter — son capas de pago independientes sobre el mismo núcleo open source, no un requisito para usarlo.
Error 2: esperar la comodidad "indexar una carpeta en tres líneas" de LlamaIndex
El modelo Pipeline/Component explícito de Haystack cambia parte de esa comodidad de inicio rápido por visibilidad y control. Si la tarea es puramente "apuntar a una carpeta y empezar a consultar", espere más configuración que con la API centrada en el índice de LlamaIndex — el beneficio aparece más tarde, cuando hay que sustituir o depurar un paso en producción.
Error 3: ignorar la elección del Document Store hasta producción
InMemoryDocumentStore es cómodo para desarrollo pero no está pensado para escala o persistencia en producción. Decida el Document Store de producción (Elasticsearch, Weaviate, Pinecone u otro backend compatible) pronto, ya que el comportamiento del retriever y la estrategia de indexación pueden variar según el backend.
Preguntas frecuentes
¿Qué es Haystack?
Haystack es un framework Python de código abierto de deepset, una empresa con sede en Alemania, para pipelines de búsqueda, preguntas y respuestas, y RAG. Tiene licencia Apache 2.0 y se instala con pip install haystack-ai.
¿Quién desarrolla Haystack?
deepset, una empresa con sede en Alemania. deepset inició Haystack en 2019 como framework de respuesta a preguntas extractiva, antes de que la generación aumentada por recuperación fuera un término habitual.
¿Bajo qué licencia se publica Haystack?
Apache License 2.0. El código fuente está en github.com/deepset-ai/haystack y puede usarse, modificarse y auto-alojarse libremente.
¿Cuál es la versión actual de Haystack?
Haystack 3.2.0, publicada el 24 de septiembre de 2026. El framework se reescribió a fondo en torno a Haystack 2.0 hacia su arquitectura Component/Pipeline actual.
¿Cuál es la diferencia entre una Component y un Pipeline en Haystack?
Una Component es un único paso de procesamiento — un retriever, un embedder, un constructor de prompts o un generador. Un Pipeline es un grafo de components conectadas mediante llamadas explícitas .add_component() y .connect(); ejecutar el pipeline recorre el grafo en orden de dependencias.
¿En qué se diferencia Haystack de LlamaIndex?
Haystack organiza los pipelines en torno a Components explícitas y tipadas, conectadas en un grafo Pipeline. LlamaIndex organiza en torno a construir un Index sobre sus datos y consultarlo mediante un Retriever y un QueryEngine. LlamaIndex suele ser más rápido para empezar a indexar datos; el grafo explícito de Haystack ofrece más visibilidad y control para pipelines en producción.
¿En qué se diferencia Haystack de LangChain?
Ambos son frameworks Python code-first sin constructor visual en su núcleo open source. LangChain gira en torno a chains y, mediante LangGraph, a un state graph para agentes. Haystack gira en torno a un Pipeline de Components tipadas, donde el retrieval y la búsqueda se tratan como aspectos de primera clase y medibles, no como un eslabón de una cadena generalista.
¿Haystack necesita una base de datos vectorial específica?
No. Haystack incluye un Document Store en memoria para desarrollo y se integra con varias bases de datos vectoriales y backends de búsqueda, incluidos Elasticsearch, Weaviate y Pinecone, a través de la misma interfaz Component — cambiar de backend no requiere reescribir el pipeline.
¿Qué es la Haystack Enterprise Platform de deepset?
Es la oferta comercial de pago de deepset construida sobre el framework open source Haystack, que añade un constructor visual de pipelines y opciones de despliegue gestionado o auto-alojado. Es independiente del framework open source gratuito y auto-alojado bajo Apache 2.0 que cubre esta reseña.