Qu'est-ce que Haystack ?
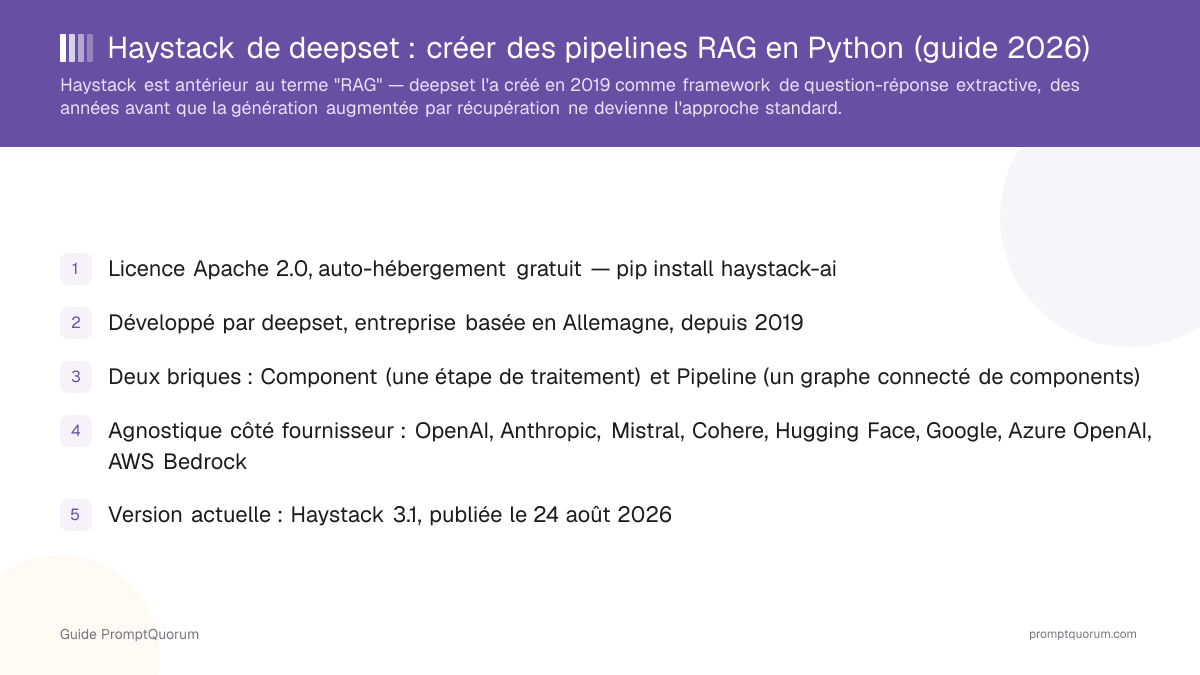
Haystack est un framework Python open source (Apache 2.0, github.com/deepset-ai/haystack) pour construire des applications de recherche, de question-réponse et de génération augmentée par récupération (RAG). Il est maintenu par deepset, une entreprise basée en Allemagne, et s'installe via pip install haystack-ai.
- Lancé en 2019 comme framework de question-réponse extractive — trouver le passage exact de la réponse dans un document — avant que les LLM génératifs ne fassent du RAG le modèle dominant
- Réécrit en profondeur autour de Haystack 2.0 vers l'architecture Component/Pipeline actuelle, désormais en version 3.2.0 (publiée le 24/09/2026)
- Fournit des components pour la conversion de documents (PDF, HTML, DOCX), le découpage de texte, l'embedding, le retrieval (par mots-clés BM25 et vectoriel/sémantique), la génération et l'évaluation
- L'abstraction Document Store découple la logique du pipeline du backend de stockage — remplacer le store en mémoire par Elasticsearch, Weaviate ou Pinecone sans réécrire le pipeline
- Fournit un document store en mémoire prêt à l'emploi pour le développement local et les tests, sans base de données externe pour démarrer
- Prend en charge le retrieval par mots-clés (BM25) et vectoriel/sémantique dans le même pipeline, plus un retrieval hybride combinant les deux
Comment fonctionne l'architecture Pipeline/Component de Haystack ?
Une Component est une seule étape de traitement (un retriever, un embedder, un générateur), et un Pipeline est un graphe orienté de components connectées via des appels explicites .add_component() et .connect(), rendant le flux de données entre les étapes visible dans le code plutôt que caché dans un objet chaîne.
- Les pipelines sont sérialisables en YAML — un pipeline construit en Python peut être enregistré, versionné et rechargé sans réexécuter le code qui l'a construit
- Les branchements et fusions sont natifs au modèle de graphe — la sortie d'un retriever peut alimenter deux générateurs différents, ou deux retrievers peuvent alimenter un ranker, sans code de liaison supplémentaire
- Les connexions étant explicites, un pipeline cassé (types incompatibles, connexion manquante) échoue dès la construction du pipeline avec une erreur claire, plutôt qu'à l'exécution, profondément dans une pile d'appels
Component
Une Component encapsule une unité de travail — récupérer des documents, encoder du texte, construire un prompt, appeler un LLM, convertir un fichier. Chaque component déclare des entrées et sorties typées, si bien qu'une component qui produit une liste d'objets Document ne peut se connecter qu'à une entrée acceptant ce type. Des components personnalisées s'écrivent en héritant de la classe de base Component et en définissant run().
Pipeline
Une instance Pipeline contient les components et les connexions entre elles. pipeline.add_component("nom", instance_component) enregistre chaque étape, puis pipeline.connect("source.sortie", "cible.entrée") les câble ensemble. Appeler pipeline.run(...) exécute le graphe dans l'ordre des dépendances et renvoie les sorties de chaque component non consommée en aval.
En quoi Haystack diffère-t-il de LangChain et LlamaIndex ?
Haystack, LangChain et LlamaIndex sont tous des frameworks Python code-first, sans constructeur visuel dans leur socle open source — la différence tient à leur abstraction centrale. Haystack organise tout autour de graphes Pipeline explicites de Components typées ; LlamaIndex organise autour d'un Index construit sur vos données, avec des objets Retriever et QueryEngine par-dessus ; LangChain organise autour de chains et, dans son extension LangGraph, d'un state graph pour les agents.
Le modèle Pipeline/Component de Haystack
Chaque étape — retrieval, prompting, génération — est une Component nommée câblée dans un Pipeline via des appels .connect() explicites. Rien n'est implicite : si deux components ne sont pas connectées, aucune donnée ne circule entre elles. Cela rend les pipelines faciles à inspecter, testables component par component, et sérialisables en YAML pour le contrôle de version.
Le modèle centré sur l'index de LlamaIndex
LlamaIndex se concentre sur la construction d'un Index (vectoriel, liste, arbre ou mots-clés) sur une collection de documents, puis son interrogation via un Retriever et un QueryEngine. Il est optimisé pour la commodité d'ingestion et d'indexation des données — quelques lignes suffisent à indexer un dossier de fichiers et à commencer à l'interroger — avec moins du câblage explicite étape par étape de Haystack.
Ce que cela signifie en pratique
Le graphe explicite de Haystack tend à payer dans les systèmes en production où il faut savoir précisément ce qui s'exécute, dans quel ordre, et remplacer une étape (un autre retriever, un autre générateur) sans toucher au reste. L'abstraction d'index de LlamaIndex tend à être plus rapide pour prototyper quand la tâche est "indexer ces données et me laisser les interroger".
Haystack prend-il en charge le RAG et la recherche en production ?
Oui — la génération augmentée par récupération et la recherche en production sont les cas d'usage centraux de Haystack, et le framework prend en charge la recherche par mots-clés, la recherche vectorielle et le retrieval hybride dans le même pipeline.
- Pipelines RAG : un retriever (BM25, vectoriel ou hybride) transmet les documents pertinents à un constructeur de prompt, qui alimente un générateur (un appel LLM) — le schéma standard que ce framework a devancé et cible désormais directement
- Retrievers : le retrieval par mots-clés BM25 et le retrieval par embedding (vectoriel/sémantique) sont tous deux de premier ordre ; le retrieval hybride combine les deux et reclasse les résultats fusionnés
- Document Stores : un store en mémoire est fourni pour le développement ; les déploiements en production se connectent à Elasticsearch, Weaviate, Pinecone ou d'autres bases vectorielles prises en charge, via la même interface Component
- Agents : Haystack inclut des components d'agent qui laissent un modèle décider quel outil ou quelle étape de pipeline appeler ensuite, plutôt que de suivre une séquence fixe
- Évaluation : Haystack fournit des components d'évaluation pour mesurer la qualité du retrieval et de la génération face à un jeu de données annoté, un enjeu pour la recherche en production où la pertinence doit être mesurable
Comment construire un premier pipeline Haystack ?
Un pipeline RAG minimal nécessite trois components connectées : un retriever, un constructeur de prompt et un générateur, câblés dans un objet Pipeline et exécutés avec une requête.
- 1Installer le paquet : pip install haystack-ai.
- 2Importer les éléments nécessaires : from haystack import Pipeline, Document; from haystack.components.generators.chat import OpenAIChatGenerator; from haystack.components.retrievers import InMemoryBM25Retriever; from haystack.document_stores.in_memory import InMemoryDocumentStore; from haystack.components.builders import ChatPromptBuilder; from haystack.utils import Secret.
- 3Créer un document store et y écrire des documents : document_store = InMemoryDocumentStore(), puis document_store.write_documents([Document(content="..."), ...]).
- 4Créer les components : retriever = InMemoryBM25Retriever(document_store=document_store), prompt_builder = ChatPromptBuilder(template=prompt_template, required_variables="*") et llm = OpenAIChatGenerator(api_key=Secret.from_env_var("OPENAI_API_KEY"), model="gpt-4o-mini").
- 5Assembler le pipeline : rag_pipeline = Pipeline(), puis rag_pipeline.add_component("retriever", retriever), rag_pipeline.add_component("prompt_builder", prompt_builder) et rag_pipeline.add_component("llm", llm).
- 6Câbler les connexions : rag_pipeline.connect("retriever", "prompt_builder.documents") et rag_pipeline.connect("prompt_builder", "llm").
- 7Exécuter : results = rag_pipeline.run({"retriever": {"query": question}, "prompt_builder": {"question": question}}).
from haystack import Pipeline, Document
from haystack.components.generators.chat import OpenAIChatGenerator
from haystack.components.retrievers import InMemoryBM25Retriever
from haystack.document_stores.in_memory import InMemoryDocumentStore
from haystack.components.builders import ChatPromptBuilder
from haystack.utils import Secret

document_store = InMemoryDocumentStore()
document_store.write_documents([
    Document(content="My name is Jean and I live in Paris."),
    Document(content="My name is Mark and I live in Berlin."),
    Document(content="My name is Giorgio and I live in Rome."),
])

retriever = InMemoryBM25Retriever(document_store=document_store)
prompt_builder = ChatPromptBuilder(template=prompt_template, required_variables="*")
llm = OpenAIChatGenerator(api_key=Secret.from_env_var("OPENAI_API_KEY"), model="gpt-4o-mini")

rag_pipeline = Pipeline()
rag_pipeline.add_component("retriever", retriever)
rag_pipeline.add_component("prompt_builder", prompt_builder)
rag_pipeline.add_component("llm", llm)
rag_pipeline.connect("retriever", "prompt_builder.documents")
rag_pipeline.connect("prompt_builder", "llm")

results = rag_pipeline.run({"retriever": {"query": question}, "prompt_builder": {"question": question}})
Ai-je besoin d'une clé API OpenAI pour essayer Haystack ?
L'exemple ci-dessus utilise OpenAIChatGenerator, mais Haystack propose aussi des components générateurs pour Hugging Face, Anthropic, Mistral, Cohere, Google, Azure OpenAI et AWS Bedrock, ainsi que des intégrations de modèles locaux — vous n'êtes lié à aucun fournisseur en particulier.
Ai-je besoin d'une base vectorielle pour démarrer ?
Non. InMemoryDocumentStore ne nécessite aucun service externe et suffit pour construire et tester un pipeline en local. Ne le remplacez par Elasticsearch, Weaviate ou Pinecone qu'au passage à l'échelle en production.
Pour qui Haystack est-il fait ?
Haystack convient aux équipes qui ont besoin d'un contrôle explicite sur un pipeline de recherche ou de RAG en production et sont à l'aise en Python — ce n'est pas un outil no-code ou visuel dans son socle open source.
Utilisez Haystack si
- Vous construisez un système de recherche, de question-réponse ou de RAG en production où la qualité du retrieval doit être mesurée et ajustée, pas seulement branchée
- Vous voulez un graphe de pipeline explicite et inspectable, testable component par component, plutôt qu'une chaîne implicite
- Vous devez remplacer des retrievers, des document stores ou des fournisseurs de modèles sans réécrire le reste du pipeline
- Vous êtes à l'aise en Python et voulez un framework, pas un produit hébergé — Haystack est auto-hébergé, code-first, et gratuit sous Apache 2.0
Évitez Haystack si
- Vous voulez un constructeur no-code ou visuel comme interface principale — le framework open source est code-first ; une couche visuelle n'existe que dans la Enterprise Platform payante de deepset
- Votre tâche se rapproche plutôt de "indexer ce dossier de fichiers et me laisser l'interroger" avec un minimum de configuration — l'API centrée sur l'index de LlamaIndex est généralement plus rapide pour arriver à une première réponse sur ce type de tâche précis
- Vous avez besoin d'un framework natif JavaScript/TypeScript — le SDK open source de Haystack est réservé à Python
- Vous ne vous intéressez pas aux métriques de qualité de recherche (BM25 vs. vectoriel vs. hybride, évaluation du retrieval) et voulez juste qu'un LLM réponde à des questions sur une poignée de documents sans réglage
Haystack vs. alternatives
Les trois frameworks ci-dessous sont open source, orientés Python et activement maintenus — le choix dépend de l'abstraction centrale la plus proche de la manière dont votre équipe veut raisonner un pipeline.
Outil | Abstraction centrale | Licence | Idéal pour |
|---|---|---|---|
| Haystack | Pipeline de Components typées | Apache 2.0 | Recherche en production / RAG mesurable |
| LlamaIndex | Index + Retriever + QueryEngine | MIT | Ingestion et indexation rapides |
| LangChain | Chains / state graph LangGraph | MIT | Code de liaison LLM et agents généraliste |
Erreurs fréquentes en évaluant Haystack
Ces erreurs viennent du fait de traiter Haystack soit comme un produit SaaS hébergé, soit comme un remplacement direct de l'abstraction d'un autre framework.
Erreur 1 : supposer que Haystack est un produit hébergé
Le framework open source (pip install haystack-ai) est du code auto-hébergé, pas un SaaS auquel on s'abonne. Les offres commerciales de deepset — Haystack Enterprise Platform et Haystack Enterprise Starter — sont des couches payantes distinctes au-dessus du même socle open source, pas un prérequis pour l'utiliser.
Erreur 2 : attendre la commodité "indexer un dossier en trois lignes" façon LlamaIndex
Le modèle Pipeline/Component explicite de Haystack échange une partie de cette commodité de démarrage rapide contre de la visibilité et du contrôle. Si la tâche est purement "pointer vers un dossier, commencer à interroger", attendez-vous à plus de configuration qu'avec l'API centrée sur l'index de LlamaIndex — le gain se voit plus tard, quand il faut remplacer ou déboguer une étape en production.
Erreur 3 : ignorer le choix du Document Store jusqu'à la production
InMemoryDocumentStore est pratique pour le développement mais n'est pas conçu pour l'échelle ou la persistance en production. Décidez du Document Store de production (Elasticsearch, Weaviate, Pinecone ou un autre backend pris en charge) tôt, car le comportement du retriever et la stratégie d'indexation peuvent varier selon le backend.
Questions fréquentes
Qu'est-ce que Haystack ?
Haystack est un framework Python open source de deepset, une entreprise basée en Allemagne, pour construire des pipelines de recherche, de question-réponse et de RAG. Il est sous licence Apache 2.0 et s'installe via pip install haystack-ai.
Qui développe Haystack ?
deepset, une entreprise basée en Allemagne. deepset a lancé Haystack en 2019 comme framework de question-réponse extractive, avant que la génération augmentée par récupération ne soit un terme courant.
Sous quelle licence Haystack est-il publié ?
Apache License 2.0. Le code source se trouve sur github.com/deepset-ai/haystack et peut être librement utilisé, modifié et auto-hébergé.
Quelle est la version actuelle de Haystack ?
Haystack 3.2.0, publiée le 24 septembre 2026. Le framework a été profondément réécrit autour de Haystack 2.0 vers son architecture Component/Pipeline actuelle.
Quelle est la différence entre une Component et un Pipeline dans Haystack ?
Une Component est une seule étape de traitement — un retriever, un embedder, un constructeur de prompt ou un générateur. Un Pipeline est un graphe de components connectées via des appels explicites .add_component() et .connect() ; exécuter le pipeline parcourt le graphe dans l'ordre des dépendances.
En quoi Haystack diffère-t-il de LlamaIndex ?
Haystack organise les pipelines autour de Components explicites et typées, câblées dans un graphe Pipeline. LlamaIndex organise autour de la construction d'un Index sur vos données, interrogé via un Retriever et un QueryEngine. LlamaIndex est généralement plus rapide pour commencer à indexer des données ; le graphe explicite de Haystack offre plus de visibilité et de contrôle pour les pipelines en production.
En quoi Haystack diffère-t-il de LangChain ?
Les deux sont des frameworks Python code-first sans constructeur visuel dans leur socle open source. LangChain se concentre sur les chains et, via LangGraph, sur un state graph pour les agents. Haystack se concentre sur un Pipeline de Components typées, où le retrieval et la recherche sont traités comme des enjeux de premier ordre et mesurables plutôt que comme un maillon d'une chaîne généraliste.
Haystack nécessite-t-il une base vectorielle spécifique ?
Non. Haystack fournit un Document Store en mémoire pour le développement et s'intègre à plusieurs bases vectorielles et backends de recherche, dont Elasticsearch, Weaviate et Pinecone, via la même interface Component — changer de backend ne nécessite pas de réécrire le pipeline.
Qu'est-ce que la Haystack Enterprise Platform de deepset ?
C'est l'offre commerciale payante de deepset construite sur le framework open source Haystack, ajoutant un constructeur de pipeline visuel et des options de déploiement géré ou auto-hébergé. Elle est distincte du framework open source gratuit et auto-hébergé sous Apache 2.0 couvert par cet article.