Was ist Haystack?
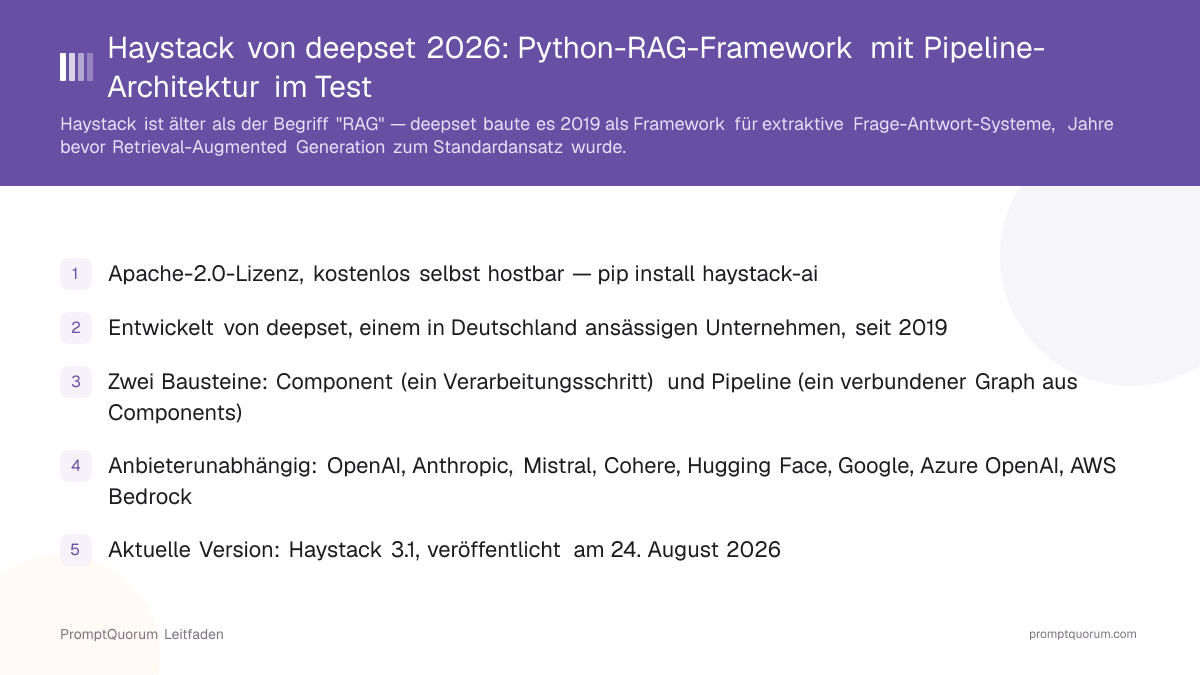
Haystack ist ein Open-Source-Python-Framework (Apache 2.0, github.com/deepset-ai/haystack) zum Bau von Such-, Frage-Antwort- und Retrieval-Augmented-Generation-Anwendungen (RAG). Es wird von deepset gepflegt, einem in Deutschland ansässigen Unternehmen, und per pip install haystack-ai installiert.
- Gestartet 2019 als Framework für extraktive Frage-Antwort-Systeme — die exakte Antwort-Textstelle in einem Dokument finden — bevor generative LLMs RAG zum dominanten Muster machten
- Rund um Haystack 2.0 grundlegend auf die aktuelle Component-/Pipeline-Architektur umgeschrieben, aktuell Version 3.2.0 (veröffentlicht am 24.09.2026)
- Liefert Components für Dokumentenkonvertierung (PDF, HTML, DOCX), Textsplitting, Embedding, Retrieval (schlüsselwortbasiert BM25 und vektor-/semantisch) sowie Generierung und Evaluation
- Die Document-Store-Abstraktion trennt Pipeline-Logik vom Speicher-Backend — den In-Memory-Store gegen Elasticsearch, Weaviate oder Pinecone tauschen, ohne die Pipeline neu zu schreiben
- Liefert einen In-Memory-Dokumentenspeicher direkt mit für lokale Entwicklung und Tests, ohne externe Datenbank zum Einstieg
- Unterstützt schlüsselwortbasiertes Retrieval (BM25) und Vektor-/semantisches Retrieval in derselben Pipeline, plus hybrides Retrieval, das beides kombiniert
Wie funktioniert Haystacks Pipeline-/Component-Architektur?
Eine Component ist ein einzelner Verarbeitungsschritt (ein Retriever, ein Embedder, ein Generator), und eine Pipeline ist ein gerichteter Graph aus Components, verbunden über explizite .add_component()- und .connect()-Aufrufe, sodass der Datenfluss zwischen den Schritten im Code sichtbar ist statt in einem Chain-Objekt verborgen.
- Pipelines lassen sich als YAML serialisieren — eine in Python gebaute Pipeline kann gespeichert, versioniert und neu geladen werden, ohne den erzeugenden Code erneut auszuführen
- Verzweigung und Zusammenführung sind im Graphenmodell nativ — die Ausgabe eines Retrievers kann zwei verschiedene Generatoren speisen, oder zwei Retriever können einen Ranker speisen, ohne zusätzlichen Klebe-Code
- Da Verbindungen explizit sind, scheitert eine fehlerhafte Pipeline (nicht passende Typen, fehlende Verbindung) bereits beim Pipeline-Aufbau mit einer klaren Fehlermeldung statt erst zur Laufzeit tief im Aufrufstapel
Component
Eine Component kapselt eine Arbeitseinheit — Dokumente abrufen, Text einbetten, einen Prompt bauen, ein LLM aufrufen, eine Datei konvertieren. Jede Component deklariert typisierte Ein- und Ausgaben, sodass eine Component, die eine Liste von Document-Objekten ausgibt, nur mit einer Eingabe verbunden werden kann, die diesen Typ akzeptiert. Eigene Components lassen sich durch Ableiten von der Basisklasse Component und Implementieren von run() schreiben.
Pipeline
Eine Pipeline-Instanz hält Components und die Verbindungen zwischen ihnen. Mit pipeline.add_component("name", component_instance) registriert man jeden Schritt, mit pipeline.connect("quelle.ausgabe", "ziel.eingabe") verdrahtet man sie. pipeline.run(...) führt den Graphen in Abhängigkeitsreihenfolge aus und liefert die Ausgaben jeder Component, die nicht nachgelagert konsumiert wurde.
Wie unterscheidet sich Haystack von LangChain und LlamaIndex?
Haystack, LangChain und LlamaIndex sind alle code-first-Python-Frameworks ohne visuellen Builder im Open-Source-Kern — der Unterschied liegt in der zentralen Abstraktion. Haystack organisiert alles um explizite Pipeline-Graphen aus typisierten Components; LlamaIndex organisiert um einen Index über den eigenen Daten mit Retriever- und QueryEngine-Objekten darüber; LangChain organisiert um Chains und, in der LangGraph-Erweiterung, um einen State-Graph für Agenten.
Haystacks Pipeline-/Component-Modell
Jeder Schritt — Retrieval, Prompting, Generierung — ist eine benannte Component, verdrahtet in eine Pipeline mit expliziten .connect()-Aufrufen. Nichts ist implizit: Sind zwei Components nicht verbunden, fließen keine Daten zwischen ihnen. Das macht Pipelines leicht inspizierbar, Component für Component testbar und als YAML für die Versionskontrolle serialisierbar.
LlamaIndex' indexzentriertes Modell
LlamaIndex dreht sich um den Bau eines Index (Vektor, Liste, Baum oder Schlüsselwort) über eine Dokumentsammlung, der dann über einen Retriever und QueryEngine abgefragt wird. Es ist auf Bequemlichkeit bei Dateneingabe und Indexierung optimiert — wenige Zeilen indexieren einen Ordner voller Dateien und starten die Abfrage — mit weniger von Haystacks expliziter Schritt-für-Schritt-Verdrahtung.
Was das in der Praxis bedeutet
Haystacks expliziter Graph zahlt sich tendenziell in Produktivsystemen aus, in denen genau nachvollziehbar sein muss, was in welcher Reihenfolge läuft, und ein Schritt (ein anderer Retriever, ein anderer Generator) getauscht werden kann, ohne den Rest anzufassen. LlamaIndex' Index-Abstraktion ist tendenziell schneller zum Prototyping geeignet, wenn die Aufgabe lautet: "Diese Daten indexieren und abfragbar machen."
Unterstützt Haystack RAG und produktive Suche?
Ja — Retrieval-Augmented Generation und produktive Suche sind Haystacks Kernanwendungsfälle, und das Framework unterstützt Schlüsselwortsuche, Vektorsuche und hybrides Retrieval in derselben Pipeline.
- RAG-Pipelines: Ein Retriever (BM25, Vektor oder hybrid) liefert relevante Dokumente an einen Prompt-Builder, der wiederum einen Generator (einen LLM-Aufruf) speist — das Standardmuster, das dieses Framework vorwegnahm und heute direkt adressiert
- Retriever: BM25-Schlüsselwort-Retrieval und Embedding-basiertes (vektor-/semantisches) Retrieval sind beide erstklassig; hybrides Retrieval kombiniert beides und rankt die zusammengeführten Ergebnisse neu
- Document Stores: Ein In-Memory-Store liefert für die Entwicklung; Produktivumgebungen verbinden sich über dieselbe Component-Schnittstelle mit Elasticsearch, Weaviate, Pinecone oder anderen unterstützten Vektordatenbanken
- Agenten: Haystack enthält Agenten-Components, die ein Modell entscheiden lassen, welches Tool oder welchen Pipeline-Schritt es als Nächstes aufruft, statt einer festen Abfolge zu folgen
- Evaluation: Haystack liefert Evaluations-Components zur Messung von Retrieval- und Generierungsqualität gegen einen gelabelten Datensatz — relevant für produktive Suche, wo Relevanz messbar sein muss
Wie baut man eine erste Haystack-Pipeline?
Eine minimale RAG-Pipeline braucht drei verbundene Components: einen Retriever, einen Prompt-Builder und einen Generator, verdrahtet in ein Pipeline-Objekt und mit einer Anfrage ausgeführt.
- 1Paket installieren: pip install haystack-ai.
- 2Benötigte Teile importieren: from haystack import Pipeline, Document; from haystack.components.generators.chat import OpenAIChatGenerator; from haystack.components.retrievers import InMemoryBM25Retriever; from haystack.document_stores.in_memory import InMemoryDocumentStore; from haystack.components.builders import ChatPromptBuilder; from haystack.utils import Secret.
- 3Einen Document Store erstellen und Dokumente schreiben: document_store = InMemoryDocumentStore(), dann document_store.write_documents([Document(content="..."), ...]).
- 4Die Components erstellen: retriever = InMemoryBM25Retriever(document_store=document_store), prompt_builder = ChatPromptBuilder(template=prompt_template, required_variables="*") und llm = OpenAIChatGenerator(api_key=Secret.from_env_var("OPENAI_API_KEY"), model="gpt-4o-mini").
- 5Die Pipeline zusammensetzen: rag_pipeline = Pipeline(), dann rag_pipeline.add_component("retriever", retriever), rag_pipeline.add_component("prompt_builder", prompt_builder) und rag_pipeline.add_component("llm", llm).
- 6Die Verbindungen verdrahten: rag_pipeline.connect("retriever", "prompt_builder.documents") und rag_pipeline.connect("prompt_builder", "llm").
- 7Ausführen: results = rag_pipeline.run({"retriever": {"query": question}, "prompt_builder": {"question": question}}).
from haystack import Pipeline, Document
from haystack.components.generators.chat import OpenAIChatGenerator
from haystack.components.retrievers import InMemoryBM25Retriever
from haystack.document_stores.in_memory import InMemoryDocumentStore
from haystack.components.builders import ChatPromptBuilder
from haystack.utils import Secret

document_store = InMemoryDocumentStore()
document_store.write_documents([
    Document(content="My name is Jean and I live in Paris."),
    Document(content="My name is Mark and I live in Berlin."),
    Document(content="My name is Giorgio and I live in Rome."),
])

retriever = InMemoryBM25Retriever(document_store=document_store)
prompt_builder = ChatPromptBuilder(template=prompt_template, required_variables="*")
llm = OpenAIChatGenerator(api_key=Secret.from_env_var("OPENAI_API_KEY"), model="gpt-4o-mini")

rag_pipeline = Pipeline()
rag_pipeline.add_component("retriever", retriever)
rag_pipeline.add_component("prompt_builder", prompt_builder)
rag_pipeline.add_component("llm", llm)
rag_pipeline.connect("retriever", "prompt_builder.documents")
rag_pipeline.connect("prompt_builder", "llm")

results = rag_pipeline.run({"retriever": {"query": question}, "prompt_builder": {"question": question}})
Brauche ich einen OpenAI-API-Schlüssel, um Haystack auszuprobieren?
Das obige Beispiel nutzt OpenAIChatGenerator, aber Haystack hat auch Generator-Components für Hugging Face, Anthropic, Mistral, Cohere, Google, Azure OpenAI und AWS Bedrock sowie Integrationen für lokale Modelle — Sie sind nicht an einen Modellanbieter gebunden.
Brauche ich zum Einstieg eine Vektordatenbank?
Nein. InMemoryDocumentStore benötigt keinen externen Dienst und reicht, um eine Pipeline lokal zu bauen und zu testen. Erst beim Wechsel in den Produktivmaßstab gegen Elasticsearch, Weaviate oder Pinecone tauschen.
Für wen eignet sich Haystack?
Haystack passt zu Teams, die explizite Kontrolle über eine produktive Such- oder RAG-Pipeline brauchen und mit Python vertraut sind — im Open-Source-Kern ist es kein No-Code- oder visuelles Tool.
Haystack nutzen, wenn
- Sie ein produktives Such-, Frage-Antwort- oder RAG-System bauen, bei dem Retrieval-Qualität gemessen und abgestimmt werden muss, statt nur angeschlossen zu werden
- Sie einen expliziten, inspizierbaren Pipeline-Graphen wollen, den Sie Component für Component testen können, statt einer impliziten Kette
- Sie Retriever, Document Stores oder Modellanbieter tauschen müssen, ohne den Rest der Pipeline neu zu schreiben
- Sie mit Python vertraut sind und ein Framework wollen, kein gehostetes Produkt — Haystack ist selbst gehostet, code-first und unter Apache 2.0 kostenlos
Haystack meiden, wenn
- Sie einen No-Code- oder visuellen Builder als primäre Oberfläche wollen — das Open-Source-Framework ist code-first; eine visuelle Schicht gibt es nur in deepsets kostenpflichtiger Enterprise Platform
- Ihre Aufgabe eher "diesen Ordner voller Dateien indexieren und abfragbar machen" mit minimalem Aufwand ist — LlamaIndex' indexzentrierte API kommt für diese spezielle Aufgabenform meist schneller zu einer ersten Antwort
- Sie ein JavaScript-/TypeScript-natives Framework brauchen — Haystacks Open-Source-SDK ist nur für Python
- Sie kein Interesse an Suchqualitäts-Metriken haben (BM25 vs. Vektor vs. hybrid, Retrieval-Evaluation) und einfach nur ein LLM Fragen über eine Handvoll Dokumente ohne Feinabstimmung beantworten lassen wollen
Haystack vs. Alternativen
Alle drei Frameworks unten sind Open Source, Python-first und aktiv gepflegt — die Wahl hängt davon ab, welche zentrale Abstraktion zur Denkweise Ihres Teams über eine Pipeline passt.
Tool | Kernabstraktion | Lizenz | Am besten für |
|---|---|---|---|
| Haystack | Pipeline aus typisierten Components | Apache 2.0 | Produktive Suche / messbares RAG |
| LlamaIndex | Index + Retriever + QueryEngine | MIT | Schnelle Dateneingabe / Indexierung |
| LangChain | Chains / LangGraph State-Graph | MIT | Allgemeiner LLM-App- und Agenten-Klebecode |
Häufige Fehler bei der Bewertung von Haystack
Diese Fehler entstehen dadurch, Haystack entweder als gehostetes SaaS-Produkt oder als direkten Ersatz für die Abstraktion eines anderen Frameworks zu behandeln.
Fehler 1: Annehmen, Haystack sei ein gehostetes Produkt
Das Open-Source-Framework (pip install haystack-ai) ist selbst gehosteter Code, kein SaaS-Abo. deepsets kommerzielle Angebote — Haystack Enterprise Platform und Haystack Enterprise Starter — sind separate kostenpflichtige Schichten auf demselben Open-Source-Kern, keine Voraussetzung für dessen Nutzung.
Fehler 2: LlamaIndex-artige "Ordner in drei Zeilen indexieren"-Bequemlichkeit erwarten
Haystacks explizites Pipeline-/Component-Modell tauscht einen Teil dieser Schnellstart-Bequemlichkeit gegen Sichtbarkeit und Kontrolle. Ist die Aufgabe rein "auf einen Ordner zeigen, abfragen starten", erwarten Sie mehr Einrichtungsaufwand als bei LlamaIndex' indexzentrierter API — der Nutzen zeigt sich später, wenn ein Schritt in Produktion getauscht oder debuggt werden muss.
Fehler 3: Die Wahl des Document Store bis zur Produktion ignorieren
InMemoryDocumentStore ist praktisch für die Entwicklung, aber nicht für Produktivmaßstab oder dauerhafte Speicherung gedacht. Den produktiven Document Store (Elasticsearch, Weaviate, Pinecone oder ein anderes unterstütztes Backend) früh festlegen, da sich Retriever-Verhalten und Indexierungsstrategie je nach Backend unterscheiden können.
Häufig gestellte Fragen
Was ist Haystack?
Haystack ist ein Open-Source-Python-Framework von deepset, einem in Deutschland ansässigen Unternehmen, für Such-, Frage-Antwort- und RAG-Pipelines. Es steht unter Apache-2.0-Lizenz und wird per pip install haystack-ai installiert.
Wer entwickelt Haystack?
deepset, ein Unternehmen mit Sitz in Deutschland. deepset startete Haystack 2019 als Framework für extraktive Frage-Antwort-Systeme, bevor Retrieval-Augmented Generation ein gängiger Begriff war.
Unter welcher Lizenz steht Haystack?
Apache License 2.0. Der Quellcode liegt auf github.com/deepset-ai/haystack und kann frei genutzt, verändert und selbst gehostet werden.
Was ist die aktuelle Version von Haystack?
Haystack 3.2.0, veröffentlicht am 24. September 2026. Das Framework wurde rund um Haystack 2.0 grundlegend auf die aktuelle Component-/Pipeline-Architektur umgeschrieben.
Was ist der Unterschied zwischen einer Component und einer Pipeline in Haystack?
Eine Component ist ein einzelner Verarbeitungsschritt — ein Retriever, Embedder, Prompt-Builder oder Generator. Eine Pipeline ist ein Graph aus Components, verbunden über explizite .add_component()- und .connect()-Aufrufe; das Ausführen der Pipeline durchläuft den Graphen in Abhängigkeitsreihenfolge.
Wie unterscheidet sich Haystack von LlamaIndex?
Haystack organisiert Pipelines um explizite, typisierte Components, verdrahtet in einen Pipeline-Graphen. LlamaIndex organisiert um den Bau eines Index über den eigenen Daten und die Abfrage über einen Retriever und QueryEngine. LlamaIndex ist meist schneller zum Indexieren von Daten geeignet; Haystacks expliziter Graph bietet mehr Sichtbarkeit und Kontrolle für Produktivpipelines.
Wie unterscheidet sich Haystack von LangChain?
Beide sind code-first-Python-Frameworks ohne visuellen Builder im Open-Source-Kern. LangChain dreht sich um Chains und, über LangGraph, um einen State-Graph für Agenten. Haystack dreht sich um eine Pipeline aus typisierten Components, wobei Retrieval und Suche als erstklassige, messbare Anliegen behandelt werden, statt als ein Glied in einer allgemeinen Chain.
Braucht Haystack eine bestimmte Vektordatenbank?
Nein. Haystack liefert einen In-Memory-Document-Store für die Entwicklung und integriert mehrere Vektordatenbanken und Such-Backends, darunter Elasticsearch, Weaviate und Pinecone, über dieselbe Component-Schnittstelle — ein Backend-Wechsel erfordert kein Neuschreiben der Pipeline.
Was ist deepsets Haystack Enterprise Platform?
Das ist deepsets kostenpflichtiges, kommerzielles Angebot auf Basis des Open-Source-Haystack-Frameworks, das einen visuellen Pipeline-Builder sowie verwaltete oder selbst gehostete Deployment-Optionen ergänzt. Es ist getrennt vom kostenlosen, selbst gehosteten Open-Source-Framework unter Apache 2.0, das diese Rezension behandelt.
Ist Haystack DSGVO-konform einsetzbar?
Bei Self-Hosting auf eigener Infrastruktur in der EU/DACH-Region verarbeiten Sie Dokumente und Anfragen selbst, was Artikel 28 DSGVO (Auftragsverarbeitung) vereinfacht, solange keine externen LLM-APIs außerhalb der EU eingebunden werden. Modellanbieter und Document-Store-Backend bestimmen den tatsächlichen Datenfluss — beides ist bei Haystack frei wählbar, prüfen Sie aber jede Integration einzeln auf ihren Serverstandort. Dies ist keine Rechtsberatung; lassen Sie die konkrete datenschutzrechtliche Einordnung für Ihren Anwendungsfall von einem Datenschutzbeauftragten oder einer Kanzlei prüfen.
Ist Haystack für den deutschen Mittelstand geeignet?
Für Teams mit Python-Kenntnissen, die eine produktive, messbare Such- oder RAG-Lösung selbst hosten wollen, ja — das Framework stammt von einem deutschen Unternehmen und wird aktiv gepflegt. Für Teams ohne Entwicklungsressourcen ist eine No-Code-RAG-Anwendung oder deepsets kostenpflichtige Enterprise Platform mit visuellem Builder meist der praktischere Einstieg.