ما هو Haystack؟
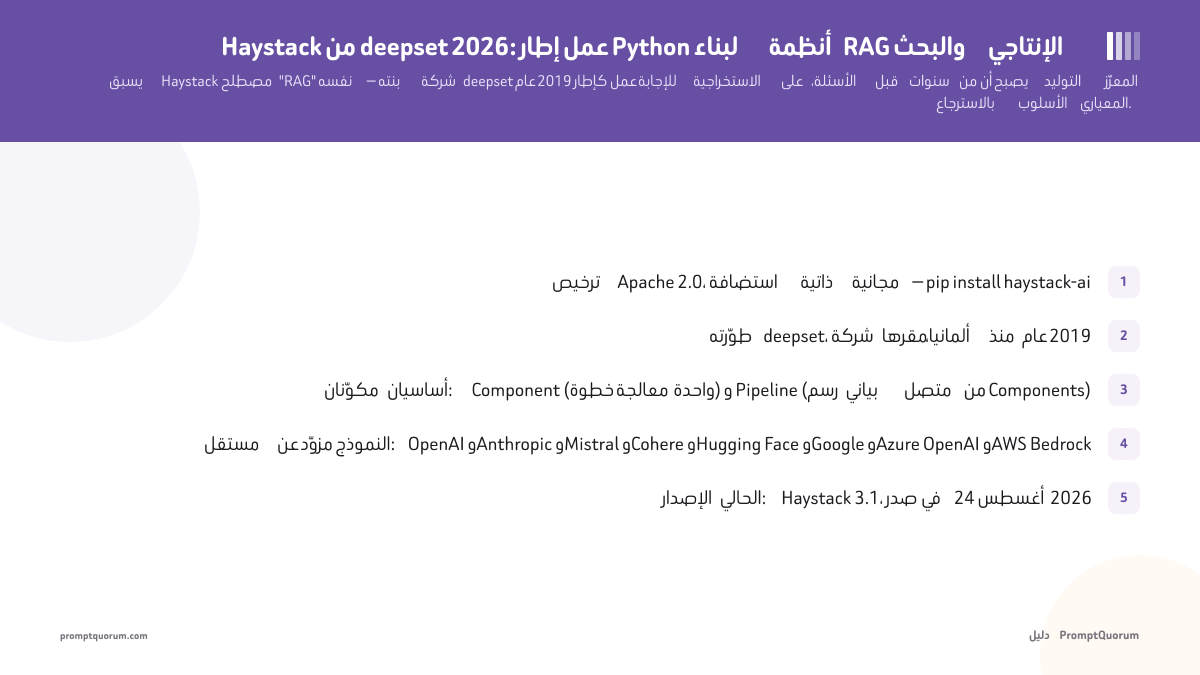
Haystack إطار عمل Python مفتوح المصدر (Apache 2.0، github.com/deepset-ai/haystack) لبناء تطبيقات البحث والإجابة على الأسئلة والتوليد المعزَّز بالاسترجاع (RAG). تتولى صيانته deepset، شركة مقرها ألمانيا، ويُثبَّت عبر pip install haystack-ai.
- بدأ عام 2019 كإطار عمل للإجابة الاستخراجية على الأسئلة — إيجاد المقطع الدقيق للإجابة داخل مستند — قبل أن تجعل النماذج التوليدية RAG النمط السائد
- أُعيدت كتابته بشكل جوهري حول Haystack 2.0 نحو بنية Component/Pipeline الحالية، وهو حاليًا في الإصدار 3.2.0 (صدر في 2026-09-24)
- يوفر Components لتحويل المستندات (PDF وHTML وDOCX) وتقسيم النصوص والـembedding والـretrieval (بالكلمات المفتاحية BM25 وبالمتجهات/الدلالي) والتوليد والتقييم
- تجريد Document Store يفصل منطق الـpipeline عن خلفية التخزين — استبدل المخزن في الذاكرة بـElasticsearch أو Weaviate أو Pinecone دون إعادة كتابة الـpipeline
- يوفر مخزن مستندات في الذاكرة جاهزًا للتطوير المحلي والاختبار، دون الحاجة إلى قاعدة بيانات خارجية للبدء
- يدعم retrieval بالكلمات المفتاحية (BM25) وretrieval بالمتجهات/الدلالي في نفس الـpipeline، إضافة إلى retrieval هجين يجمع بينهما
كيف تعمل بنية Pipeline/Component في Haystack؟
الـComponent خطوة معالجة واحدة (retriever أو embedder أو generator)، والـPipeline رسم بياني موجّه من Components متصلة عبر استدعاءات .add_component() و.connect() صريحة، بحيث يكون تدفق البيانات بين الخطوات مرئيًا في الشيفرة بدلًا من أن يكون مخفيًا داخل كائن سلسلة.
- يمكن تسلسل الـpipelines إلى YAML — يمكن حفظ pipeline مبني بلغة Python، وإدارة نسخه، وإعادة تحميله دون إعادة تشغيل الشيفرة التي بنته
- التفرع والدمج مدمجان في نموذج الرسم البياني — يمكن لمخرجات retriever واحد أن تغذّي مولّدين مختلفين، أو يمكن لـretrieverين أن يغذّيا ranker واحدًا، دون شيفرة ربط إضافية
- بما أن الاتصالات صريحة، فإن pipeline معطوبًا (أنواع غير متطابقة، اتصال ناقص) يفشل عند بناء الـpipeline برسالة خطأ واضحة، بدلًا من الفشل وقت التشغيل في أعماق سلسلة الاستدعاءات
Component
تُغلِّف الـComponent وحدة عمل واحدة — استرجاع مستندات، ترميز نص، بناء prompt، استدعاء نموذج لغوي، تحويل ملف. تعلن كل Component عن مدخلات ومخرجات محددة النوع، فلا يمكن لـComponent تُخرج قائمة من كائنات Document أن تتصل إلا بمدخل يقبل هذا النوع. يمكن كتابة Components مخصصة عبر الوراثة من الصنف الأساسي Component وتعريف run().
Pipeline
يحتفظ كائن Pipeline بالـComponents والاتصالات بينها. يسجّل pipeline.add_component("الاسم", نسخة_الcomponent) كل خطوة، ثم يوصلها pipeline.connect("المصدر.المخرج", "الهدف.المدخل"). يؤدي استدعاء pipeline.run(...) إلى تنفيذ الرسم البياني حسب ترتيب الاعتماديات وإرجاع مخرجات كل Component لم تُستهلَك في مرحلة لاحقة.
كيف يختلف Haystack عن LangChain و LlamaIndex؟
Haystack وLangChain وLlamaIndex جميعها أطر عمل Python تعتمد الشيفرة أولًا، دون أداة بناء مرئية في نواتها مفتوحة المصدر — يكمن الفرق في التجريد المركزي لكل منها. ينظّم Haystack كل شيء حول رسوم Pipeline صريحة من Components محددة النوع؛ ينظّم LlamaIndex حول Index مبني فوق بياناتك مع كائنات Retriever وQueryEngine فوقه؛ ينظّم LangChain حول chains، وفي امتداده LangGraph حول state graph للوكلاء.
نموذج Pipeline/Component في Haystack
كل خطوة — retrieval أو prompting أو التوليد — هي Component مسمّاة موصولة داخل Pipeline عبر استدعاءات .connect() صريحة. لا شيء ضمني: إن لم تتصل Componentان، لا تتدفق بيانات بينهما. هذا يجعل الـpipelines سهلة الفحص، قابلة للاختبار Component تلو الأخرى، وقابلة للتسلسل إلى YAML لإدارة الإصدارات.
نموذج LlamaIndex المتمحور حول الفهرس
يتمحور LlamaIndex حول بناء Index (متجهي أو قائمة أو شجرة أو كلمات مفتاحية) فوق مجموعة مستندات، ثم الاستعلام عنه عبر Retriever وQueryEngine. وهو مُحسَّن لسهولة استيعاب البيانات وفهرستها — عدة أسطر تكفي لفهرسة مجلد ملفات والبدء بالاستعلام عنه — مع أسلوب توصيل أقل صراحةً خطوة بخطوة مقارنة بـHaystack.
ماذا يعني هذا عمليًا
يميل الرسم البياني الصريح لـHaystack إلى إثبات جدواه في الأنظمة الإنتاجية حيث يجب معرفة ما يعمل بالضبط، وبأي ترتيب، واستبدال خطوة واحدة (retriever مختلف، generator مختلف) دون المساس بالباقي. يميل تجريد الفهرس في LlamaIndex إلى أن يكون أسرع في بناء النماذج الأولية عندما تكون المهمة "فهرسة هذه البيانات ودعني أستعلم عنها".
هل يدعم Haystack RAG والبحث الإنتاجي؟
نعم — التوليد المعزَّز بالاسترجاع والبحث الإنتاجي هما حالتا الاستخدام الأساسيتان لـHaystack، ويدعم إطار العمل البحث بالكلمات المفتاحية والبحث المتجهي وretrieval الهجين ضمن نفس الـpipeline.
- خطوط RAG: يمرّر retriever (BM25 أو متجهي أو هجين) المستندات ذات الصلة إلى prompt builder، الذي يغذّي بدوره generator (استدعاء نموذج لغوي) — النمط المعياري الذي سبقه هذا الإطار زمنيًا ويستهدفه اليوم مباشرة
- الـRetrievers: retrieval بالكلمات المفتاحية BM25 وretrieval القائم على الـembedding (متجهي/دلالي) كلاهما من الدرجة الأولى؛ يجمع retrieval الهجين بينهما ويعيد ترتيب النتائج المدمجة
- مخازن المستندات: يتوفر مخزن في الذاكرة للتطوير؛ تتصل عمليات النشر الإنتاجي بـElasticsearch أو Weaviate أو Pinecone أو قواعد بيانات متجهية أخرى مدعومة عبر واجهة Component نفسها
- الوكلاء: يتضمن Haystack Components للوكلاء تتيح للنموذج تقرير الأداة أو خطوة الـpipeline التالية بدلًا من اتّباع تسلسل ثابت
- التقييم: يوفر Haystack Components للتقييم لقياس جودة الـretrieval والتوليد مقابل مجموعة بيانات موسومة — أمر مهم للبحث الإنتاجي حيث يجب أن تكون الصلة قابلة للقياس
كيف تبني أول pipeline في Haystack؟
يحتاج pipeline RAG بسيط إلى ثلاث Components متصلة: retriever وprompt builder وgenerator، موصولة داخل كائن Pipeline ومُشغَّلة باستعلام.
- 1ثبّت الحزمة: pip install haystack-ai.
- 2استورد ما تحتاجه: from haystack import Pipeline, Document; from haystack.components.generators.chat import OpenAIChatGenerator; from haystack.components.retrievers import InMemoryBM25Retriever; from haystack.document_stores.in_memory import InMemoryDocumentStore; from haystack.components.builders import ChatPromptBuilder; from haystack.utils import Secret.
- 3أنشئ document store واكتب فيه المستندات: document_store = InMemoryDocumentStore()، ثم document_store.write_documents([Document(content="..."), ...]).
- 4أنشئ الـComponents: retriever = InMemoryBM25Retriever(document_store=document_store)، وprompt_builder = ChatPromptBuilder(template=prompt_template, required_variables="*")، وllm = OpenAIChatGenerator(api_key=Secret.from_env_var("OPENAI_API_KEY"), model="gpt-4o-mini").
- 5اجمع الـpipeline: rag_pipeline = Pipeline()، ثم rag_pipeline.add_component("retriever", retriever)، وrag_pipeline.add_component("prompt_builder", prompt_builder)، وrag_pipeline.add_component("llm", llm).
- 6وصّل الاتصالات: rag_pipeline.connect("retriever", "prompt_builder.documents") وrag_pipeline.connect("prompt_builder", "llm").
- 7شغّله: results = rag_pipeline.run({"retriever": {"query": question}, "prompt_builder": {"question": question}}).
from haystack import Pipeline, Document
from haystack.components.generators.chat import OpenAIChatGenerator
from haystack.components.retrievers import InMemoryBM25Retriever
from haystack.document_stores.in_memory import InMemoryDocumentStore
from haystack.components.builders import ChatPromptBuilder
from haystack.utils import Secret

document_store = InMemoryDocumentStore()
document_store.write_documents([
    Document(content="My name is Jean and I live in Paris."),
    Document(content="My name is Mark and I live in Berlin."),
    Document(content="My name is Giorgio and I live in Rome."),
])

retriever = InMemoryBM25Retriever(document_store=document_store)
prompt_builder = ChatPromptBuilder(template=prompt_template, required_variables="*")
llm = OpenAIChatGenerator(api_key=Secret.from_env_var("OPENAI_API_KEY"), model="gpt-4o-mini")

rag_pipeline = Pipeline()
rag_pipeline.add_component("retriever", retriever)
rag_pipeline.add_component("prompt_builder", prompt_builder)
rag_pipeline.add_component("llm", llm)
rag_pipeline.connect("retriever", "prompt_builder.documents")
rag_pipeline.connect("prompt_builder", "llm")

results = rag_pipeline.run({"retriever": {"query": question}, "prompt_builder": {"question": question}})
هل أحتاج مفتاح API من OpenAI لتجربة Haystack؟
يستخدم المثال أعلاه OpenAIChatGenerator، لكن Haystack يوفر أيضًا Components مولّدة لـHugging Face وAnthropic وMistral وCohere وGoogle وAzure OpenAI وAWS Bedrock، إضافة إلى تكاملات مع نماذج محلية — فأنت لست مقيدًا بمزوّد نموذج واحد.
هل أحتاج قاعدة بيانات متجهية للبدء؟
لا. لا يتطلب InMemoryDocumentStore أي خدمة خارجية، وهو كافٍ لبناء واختبار pipeline محليًا. استبدله بـElasticsearch أو Weaviate أو Pinecone فقط عند الانتقال إلى نطاق الإنتاج.
لمن يناسب Haystack؟
يناسب Haystack الفِرق التي تحتاج تحكمًا صريحًا في pipeline بحث أو RAG إنتاجي وتشعر بالراحة في كتابة Python — فهو ليس أداة بلا شيفرة أو مرئية في نواته مفتوحة المصدر.
استخدم Haystack إذا
- كنت تبني نظام بحث أو إجابة على أسئلة أو RAG إنتاجيًا حيث يجب قياس جودة الـretrieval وضبطها، لا مجرد توصيلها
- أردت رسمًا بيانيًا صريحًا وقابلًا للفحص للـpipeline، يمكن اختباره Component تلو الأخرى، بدلًا من سلسلة ضمنية
- احتجت إلى استبدال retrievers أو document stores أو مزوّدي نماذج دون إعادة كتابة بقية الـpipeline
- كنت تشعر بالراحة في Python وتريد إطار عمل لا منتجًا مستضافًا — Haystack ذاتي الاستضافة، يعتمد الشيفرة أولًا، ومجاني بموجب Apache 2.0
تجنّب Haystack إذا
- أردت أداة بناء بلا شيفرة أو مرئية كواجهة أساسية — إطار العمل مفتوح المصدر يعتمد الشيفرة أولًا؛ الطبقة المرئية موجودة فقط في Enterprise Platform المدفوعة من deepset
- كانت مهمتك أقرب إلى "فهرسة هذا المجلد من الملفات ودعني أستعلم عنه" بأقل إعداد ممكن — واجهة LlamaIndex المتمحورة حول الفهرس تصل عادةً إلى إجابة أولى أسرع لهذا النوع المحدد من المهام
- احتجت إطار عمل أصيل بلغة JavaScript/TypeScript — حزمة Haystack مفتوحة المصدر مخصصة لـPython فقط
- لم يكن لديك اهتمام بمقاييس جودة البحث (BM25 مقابل المتجهي مقابل الهجين، تقييم الـretrieval) وأردت فقط أن يجيب نموذج لغوي عن أسئلة حول حفنة من المستندات دون أي ضبط
Haystack مقابل البدائل
أطر العمل الثلاثة أدناه جميعها مفتوحة المصدر، تعتمد Python بشكل أساسي، ويُصان كل منها بنشاط — يعتمد الاختيار على أي تجريد مركزي يناسب طريقة تفكير فريقك حول الـpipeline.
الأداة | التجريد المركزي | الترخيص | الأنسب لـ |
|---|---|---|---|
| Haystack | Pipeline من Components محددة النوع | Apache 2.0 | البحث الإنتاجي / RAG قابل للقياس |
| LlamaIndex | Index + Retriever + QueryEngine | MIT | استيعاب وفهرسة سريعان |
| LangChain | Chains / LangGraph state graph | MIT | شيفرة ربط عامة لتطبيقات LLM والوكلاء |
أخطاء شائعة عند تقييم Haystack
تنشأ هذه الأخطاء من التعامل مع Haystack إما كمنتج SaaS مستضاف أو كبديل مباشر لتجريد إطار عمل آخر.
الخطأ الأول: افتراض أن Haystack منتج مستضاف
إطار العمل مفتوح المصدر (pip install haystack-ai) هو شيفرة ذاتية الاستضافة، لا خدمة SaaS تشترك بها. عروض deepset التجارية — Haystack Enterprise Platform وHaystack Enterprise Starter — طبقات مدفوعة منفصلة فوق النواة مفتوحة المصدر نفسها، وليست شرطًا لاستخدامها.
الخطأ الثاني: توقع سهولة "فهرسة مجلد بثلاثة أسطر" على طريقة LlamaIndex
يستبدل نموذج Pipeline/Component الصريح في Haystack جزءًا من تلك السهولة السريعة برؤية وتحكم. إذا كانت المهمة مجرد "الإشارة إلى مجلد والبدء بالاستعلام"، توقع إعدادًا أكبر مقارنة بواجهة LlamaIndex المتمحورة حول الفهرس — تظهر الفائدة لاحقًا، عند الحاجة إلى استبدال خطوة أو تصحيحها في الإنتاج.
الخطأ الثالث: تجاهل اختيار Document Store حتى مرحلة الإنتاج
InMemoryDocumentStore عملي للتطوير لكنه غير مصمم لنطاق الإنتاج أو الاستمرارية. حدّد Document Store الإنتاجي (Elasticsearch أو Weaviate أو Pinecone أو خلفية مدعومة أخرى) مبكرًا، إذ قد يختلف سلوك الـretriever واستراتيجية الفهرسة باختلاف الخلفية.
الأسئلة الشائعة
ما هو Haystack؟
Haystack إطار عمل Python مفتوح المصدر من deepset، شركة مقرها ألمانيا، لبناء خطوط البحث والإجابة على الأسئلة وRAG. مرخّص بموجب Apache 2.0، ويُثبَّت عبر pip install haystack-ai.
من يطوّر Haystack؟
deepset، شركة مقرها ألمانيا. أطلقت deepset Haystack عام 2019 كإطار عمل للإجابة الاستخراجية على الأسئلة، قبل أن يصبح التوليد المعزَّز بالاسترجاع مصطلحًا شائعًا.
بأي ترخيص يُنشَر Haystack؟
Apache License 2.0. الشيفرة المصدرية على github.com/deepset-ai/haystack ويمكن استخدامها وتعديلها واستضافتها ذاتيًا بحرية.
ما هو الإصدار الحالي من Haystack؟
Haystack 3.2.0، صدر في 24 سبتمبر 2026. أُعيدت كتابة إطار العمل بشكل جوهري حول Haystack 2.0 نحو بنية Component/Pipeline الحالية.
ما الفرق بين Component وPipeline في Haystack؟
الـComponent خطوة معالجة واحدة — retriever أو embedder أو prompt builder أو generator. الـPipeline رسم بياني من Components متصلة عبر استدعاءات .add_component() و.connect() صريحة؛ يمر تشغيل الـpipeline عبر الرسم البياني حسب ترتيب الاعتماديات.
كيف يختلف Haystack عن LlamaIndex؟
ينظّم Haystack الـpipelines حول Components صريحة ومحددة النوع، موصولة داخل رسم Pipeline. ينظّم LlamaIndex حول بناء Index فوق بياناتك، والاستعلام عنه عبر Retriever وQueryEngine. عادةً ما يكون LlamaIndex أسرع للبدء في فهرسة البيانات؛ يوفر رسم Haystack الصريح رؤية وتحكمًا أكبر للـpipelines الإنتاجية.
كيف يختلف Haystack عن LangChain؟
كلاهما إطارا عمل Python يعتمدان الشيفرة أولًا، دون أداة بناء مرئية في النواة مفتوحة المصدر. يتمحور LangChain حول chains، وعبر LangGraph حول state graph للوكلاء. يتمحور Haystack حول Pipeline من Components محددة النوع، ويعامل الـretrieval والبحث كاهتمامات من الدرجة الأولى وقابلة للقياس، لا كحلقة في سلسلة عامة.
هل يتطلب Haystack قاعدة بيانات متجهية محددة؟
لا. يوفر Haystack Document Store في الذاكرة للتطوير، ويتكامل مع عدة قواعد بيانات متجهية وخلفيات بحث، منها Elasticsearch وWeaviate وPinecone، عبر واجهة Component نفسها — تبديل الخلفية لا يتطلب إعادة كتابة الـpipeline.
ما هي منصة Haystack Enterprise Platform من deepset؟
هي عرض deepset التجاري المدفوع المبني فوق إطار عمل Haystack مفتوح المصدر، ويضيف أداة بناء pipeline مرئية وخيارات نشر مُدار أو ذاتي الاستضافة. وهي منفصلة عن إطار العمل المجاني ذاتي الاستضافة بموجب Apache 2.0 الذي تتناوله هذه المراجعة.