Haystack이란 무엇인가?
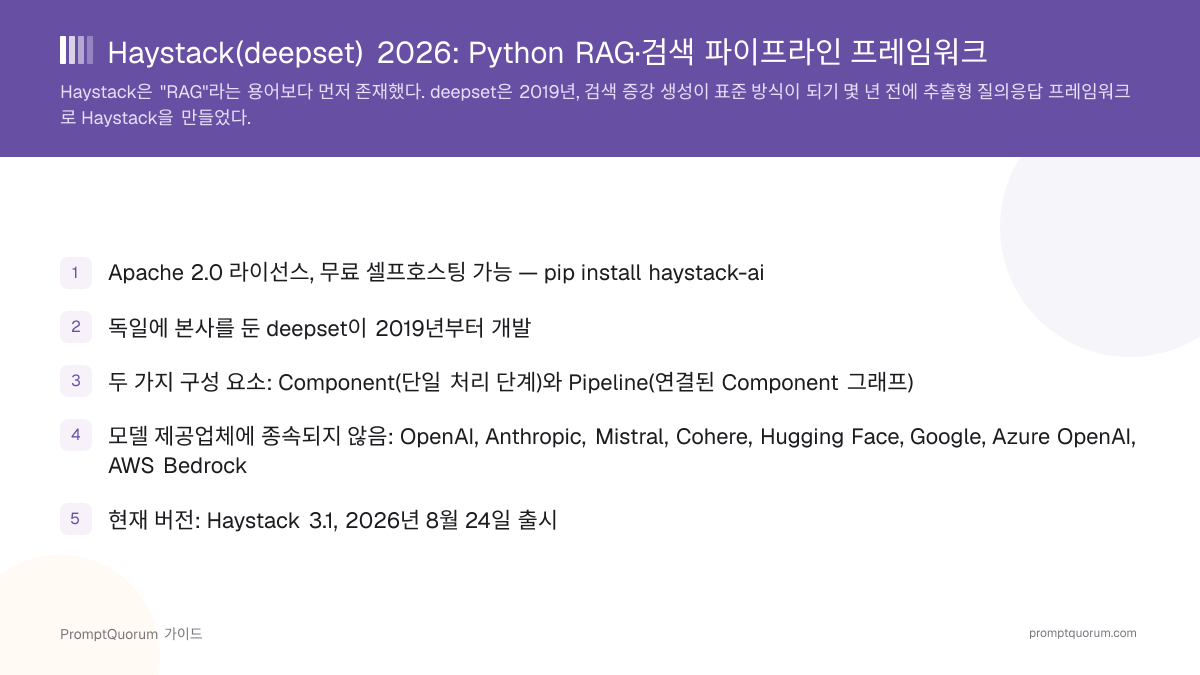
Haystack은 검색·질의응답·검색 증강 생성(RAG) 애플리케이션을 구축하는 오픈소스 Python 프레임워크(Apache 2.0, github.com/deepset-ai/haystack)다. 독일에 본사를 둔 deepset이 유지 관리하며 pip install haystack-ai로 설치한다.
- 2019년 추출형 질의응답 프레임워크로 시작 — 문서 안에서 정확한 답변 구간을 찾는 방식 — 생성형 LLM이 RAG를 주류 패턴으로 만들기 전
- Haystack 2.0을 전후로 현재의 Component/Pipeline 아키텍처로 대폭 재작성되었고, 현재는 버전 3.2.0(2026-09-24 출시)
- 문서 변환(PDF, HTML, DOCX), 텍스트 분할, embedding, retrieval(키워드 기반 BM25 및 벡터/의미 기반), 생성, 평가를 위한 Component 제공
- Document Store 추상화가 파이프라인 로직을 저장소 백엔드에서 분리 — 파이프라인을 다시 작성하지 않고 인메모리 스토어를 Elasticsearch, Weaviate, Pinecone로 교체 가능
- 로컬 개발과 테스트를 위한 인메모리 문서 저장소를 기본 제공하며, 시작에 외부 데이터베이스가 필요 없음
- 동일 파이프라인 안에서 키워드 retrieval(BM25)과 벡터/의미 기반 retrieval을 모두 지원하며, 둘을 결합한 하이브리드 retrieval도 지원
Haystack의 Pipeline/Component 아키텍처는 어떻게 동작하는가?
Component는 하나의 처리 단계(retriever, embedder, generator 등)이며, Pipeline은 .add_component()와 .connect()의 명시적 호출로 연결된 Component의 방향 그래프다. 단계 간 데이터 흐름이 체인 객체 속에 숨지 않고 코드에서 그대로 보인다.
- 파이프라인은 YAML로 직렬화할 수 있다 — Python으로 만든 파이프라인을 저장·버전 관리하고, 이를 만든 코드를 다시 실행하지 않고도 다시 불러올 수 있다
- 분기와 병합은 그래프 모델에 기본 내장되어 있다 — 하나의 retriever 출력이 서로 다른 두 generator에 흘러가거나, 두 retriever가 하나의 ranker로 흘러갈 수 있으며, 별도의 접합 코드가 필요 없다
- 연결이 명시적이므로, 깨진 파이프라인(타입 불일치, 연결 누락)은 실행 중 호출 스택 깊은 곳에서 실패하는 대신 파이프라인 구성 시점에 명확한 오류로 실패한다
Component
Component는 하나의 작업 단위를 캡슐화한다 — 문서 검색, 텍스트 embedding, 프롬프트 구성, LLM 호출, 파일 변환 등. 각 Component는 타입이 지정된 입출력을 선언하므로, Document 객체 목록을 출력하는 Component는 그 타입을 받아들이는 입력에만 연결될 수 있다. 커스텀 Component는 기본 클래스 Component를 상속하고 run()을 정의해 작성할 수 있다.
Pipeline
Pipeline 인스턴스는 Component들과 그 사이의 연결을 보관한다. pipeline.add_component("이름", component_instance)로 각 단계를 등록하고, pipeline.connect("출처.출력", "대상.입력")으로 연결한다. pipeline.run(...)을 호출하면 의존성 순서에 따라 그래프를 실행하고, 하류에서 소비되지 않은 각 Component의 출력을 반환한다.
Haystack은 LangChain·LlamaIndex와 어떻게 다른가?
Haystack, LangChain, LlamaIndex 모두 코드 우선 Python 프레임워크로, 오픈소스 코어에는 시각적 빌더가 없다 — 차이는 핵심 추상화에 있다. Haystack은 타입이 지정된 Component로 이뤄진 명시적 Pipeline 그래프를 중심으로 모든 것을 구성한다. LlamaIndex는 데이터 위에 구축한 Index를 중심으로, 그 위에 Retriever와 QueryEngine 객체를 둔다. LangChain은 chain을 중심으로, LangGraph 확장에서는 에이전트를 위한 state graph를 중심으로 구성한다.
Haystack의 Pipeline/Component 모델
retrieval, prompting, 생성 등 모든 단계는 .connect() 호출로 Pipeline에 명시적으로 연결된 이름 붙은 Component다. 암묵적인 것은 없다 — 두 Component가 연결되어 있지 않으면 그 사이에 데이터가 흐르지 않는다. 이 덕분에 파이프라인을 검사하기 쉽고, Component 단위로 유닛 테스트할 수 있으며, 버전 관리를 위해 YAML로 직렬화할 수 있다.
LlamaIndex의 인덱스 중심 모델
LlamaIndex는 문서 컬렉션 위에 Index(벡터, 리스트, 트리, 키워드)를 구축하고, 이를 Retriever와 QueryEngine을 통해 조회하는 방식에 초점을 맞춘다. 데이터 수집과 인덱싱의 편의성에 최적화되어 있어, 몇 줄만으로 폴더 안의 파일을 인덱싱하고 곧바로 조회를 시작할 수 있다 — Haystack만큼 명시적인 단계별 연결을 요구하지 않는다.
실무에서 의미하는 바
Haystack의 명시적 그래프는 정확히 무엇이 어떤 순서로 실행되는지 알아야 하고, 나머지는 건드리지 않은 채 한 단계(다른 retriever, 다른 generator)를 교체해야 하는 프로덕션 시스템에서 효과를 보는 경향이 있다. LlamaIndex의 인덱스 추상화는 "이 데이터를 인덱싱하고 바로 조회하게 해달라"는 작업에서 프로토타이핑이 더 빠른 경향이 있다.
Haystack은 RAG와 프로덕션 검색을 지원하는가?
그렇다 — 검색 증강 생성과 프로덕션 검색은 Haystack의 핵심 사용 사례이며, 이 프레임워크는 동일한 파이프라인 안에서 키워드 검색, 벡터 검색, 하이브리드 retrieval을 지원한다.
- RAG 파이프라인: retriever(BM25, 벡터, 또는 하이브리드)가 관련 문서를 prompt builder에 전달하고, 이것이 다시 generator(LLM 호출)에 전달된다 — 이 프레임워크가 용어가 생기기도 전에 앞서 다뤘고 지금은 직접 겨냥하는 표준 패턴이다
- Retriever: BM25 키워드 retrieval과 embedding 기반(벡터/의미) retrieval 모두 1급 기능으로 지원되며, 하이브리드 retrieval은 둘을 결합해 병합된 결과를 재순위화한다
- Document Store: 개발용으로 인메모리 스토어가 기본 제공되며, 프로덕션 배포는 동일한 Component 인터페이스를 통해 Elasticsearch, Weaviate, Pinecone 등 지원되는 벡터 데이터베이스에 연결된다
- 에이전트: Haystack에는 에이전트 Component가 포함되어 있어, 고정된 순서를 따르는 대신 모델이 다음에 어떤 도구나 파이프라인 단계를 호출할지 결정하게 할 수 있다
- 평가: Haystack은 레이블이 붙은 데이터셋을 기준으로 retrieval과 생성 품질을 측정하는 평가용 Component를 제공한다 — 관련성이 측정 가능해야 하는 프로덕션 검색에서 중요하다
첫 Haystack 파이프라인은 어떻게 만드는가?
최소한의 RAG 파이프라인에는 retriever, prompt builder, generator라는 연결된 세 Component가 필요하며, 이를 Pipeline 객체에 연결하고 쿼리로 실행한다.
- 1패키지 설치: pip install haystack-ai.
- 2필요한 요소 임포트: from haystack import Pipeline, Document; from haystack.components.generators.chat import OpenAIChatGenerator; from haystack.components.retrievers import InMemoryBM25Retriever; from haystack.document_stores.in_memory import InMemoryDocumentStore; from haystack.components.builders import ChatPromptBuilder; from haystack.utils import Secret.
- 3document store를 생성하고 문서를 기록: document_store = InMemoryDocumentStore(), 그다음 document_store.write_documents([Document(content="..."), ...]).
- 4Component 생성: retriever = InMemoryBM25Retriever(document_store=document_store), prompt_builder = ChatPromptBuilder(template=prompt_template, required_variables="*"), llm = OpenAIChatGenerator(api_key=Secret.from_env_var("OPENAI_API_KEY"), model="gpt-4o-mini").
- 5파이프라인 조립: rag_pipeline = Pipeline(), 그다음 rag_pipeline.add_component("retriever", retriever), rag_pipeline.add_component("prompt_builder", prompt_builder), rag_pipeline.add_component("llm", llm).
- 6연결 배선: rag_pipeline.connect("retriever", "prompt_builder.documents") 및 rag_pipeline.connect("prompt_builder", "llm").
- 7실행: results = rag_pipeline.run({"retriever": {"query": question}, "prompt_builder": {"question": question}}).
from haystack import Pipeline, Document
from haystack.components.generators.chat import OpenAIChatGenerator
from haystack.components.retrievers import InMemoryBM25Retriever
from haystack.document_stores.in_memory import InMemoryDocumentStore
from haystack.components.builders import ChatPromptBuilder
from haystack.utils import Secret

document_store = InMemoryDocumentStore()
document_store.write_documents([
    Document(content="My name is Jean and I live in Paris."),
    Document(content="My name is Mark and I live in Berlin."),
    Document(content="My name is Giorgio and I live in Rome."),
])

retriever = InMemoryBM25Retriever(document_store=document_store)
prompt_builder = ChatPromptBuilder(template=prompt_template, required_variables="*")
llm = OpenAIChatGenerator(api_key=Secret.from_env_var("OPENAI_API_KEY"), model="gpt-4o-mini")

rag_pipeline = Pipeline()
rag_pipeline.add_component("retriever", retriever)
rag_pipeline.add_component("prompt_builder", prompt_builder)
rag_pipeline.add_component("llm", llm)
rag_pipeline.connect("retriever", "prompt_builder.documents")
rag_pipeline.connect("prompt_builder", "llm")

results = rag_pipeline.run({"retriever": {"query": question}, "prompt_builder": {"question": question}})
Haystack을 사용해 보려면 OpenAI API 키가 필요한가?
위 예제는 OpenAIChatGenerator를 사용하지만, Haystack에는 Hugging Face, Anthropic, Mistral, Cohere, Google, Azure OpenAI, AWS Bedrock용 generator Component도 있고 로컬 모델 통합도 존재한다 — 특정 모델 제공업체에 묶이지 않는다.
시작하는 데 벡터 데이터베이스가 필요한가?
아니다. InMemoryDocumentStore는 외부 서비스가 필요 없으며 로컬에서 파이프라인을 만들고 테스트하기에 충분하다. 프로덕션 규모로 전환할 때만 Elasticsearch, Weaviate, Pinecone 등으로 교체하면 된다.
Haystack은 누구에게 적합한가?
Haystack은 프로덕션 검색·RAG 파이프라인에 대한 명시적 제어가 필요하고 Python 작성에 익숙한 팀에 적합하다 — 오픈소스 코어 자체는 노코드나 시각적 도구가 아니다.
이럴 때 Haystack을 사용하라
- retrieval 품질을 단순히 연결하는 것을 넘어 측정하고 튜닝해야 하는 프로덕션 검색·질의응답·RAG 시스템을 구축하는 경우
- 암묵적인 체인이 아니라 Component 단위로 테스트 가능한 명시적이고 검사 가능한 파이프라인 그래프를 원하는 경우
- 파이프라인의 나머지 부분을 다시 작성하지 않고 retriever, document store, 모델 제공업체를 교체해야 하는 경우
- Python에 익숙하고 호스팅형 제품이 아니라 프레임워크를 원하는 경우 — Haystack은 셀프호스팅형이며 코드 우선이고 Apache 2.0 하에 무료다
이럴 때는 Haystack을 피하라
- 노코드나 시각적 빌더를 주요 인터페이스로 원하는 경우 — 오픈소스 프레임워크는 코드 우선이며, 시각적 계층은 deepset의 유료 Enterprise Platform에만 존재한다
- 작업이 최소한의 설정으로 "이 파일 폴더를 인덱싱하고 바로 조회하게 해달라"에 가까운 경우 — 이런 특정 형태의 작업에서는 LlamaIndex의 인덱스 중심 API가 대체로 첫 답변에 더 빨리 도달한다
- JavaScript/TypeScript 네이티브 프레임워크가 필요한 경우 — Haystack의 오픈소스 SDK는 Python 전용이다
- 검색 품질 지표(BM25 vs. 벡터 vs. 하이브리드, retrieval 평가)에 관심이 없고 튜닝 없이 소수의 문서에 대해 LLM이 질문에 답하기만 하면 되는 경우
Haystack vs. 대안
아래 세 프레임워크 모두 오픈소스이고 Python 중심이며 활발히 유지 관리된다 — 선택은 팀이 파이프라인을 어떻게 사고하고 싶은지에 어떤 핵심 추상화가 맞는지에 달려 있다.
도구 | 핵심 추상화 | 라이선스 | 적합한 용도 |
|---|---|---|---|
| Haystack | 타입 지정 Component의 Pipeline | Apache 2.0 | 프로덕션 검색 / 측정 가능한 RAG |
| LlamaIndex | Index + Retriever + QueryEngine | MIT | 빠른 데이터 수집·인덱싱 |
| LangChain | Chains / LangGraph state graph | MIT | 범용 LLM 앱·에이전트 접착 코드 |
Haystack 평가 시 흔한 실수
이런 실수들은 Haystack을 호스팅형 SaaS 제품으로 취급하거나, 다른 프레임워크의 추상화를 직접 대체하는 것으로 취급하는 데서 비롯된다.
실수 1: Haystack을 호스팅형 제품으로 오해
오픈소스 프레임워크(pip install haystack-ai)는 셀프호스팅 코드이지 구독형 SaaS가 아니다. deepset의 상용 제품인 Haystack Enterprise Platform과 Haystack Enterprise Starter는 동일한 오픈소스 코어 위의 별도 유료 계층이며, 사용을 위한 필수 조건이 아니다.
실수 2: LlamaIndex 식 "세 줄로 폴더 인덱싱" 편의성 기대
Haystack의 명시적 Pipeline/Component 모델은 그런 빠른 시작 편의성 일부를 가시성과 제어력과 맞바꾼다. 작업이 순전히 "폴더 하나를 가리키고 바로 조회 시작"이라면, LlamaIndex의 인덱스 중심 API보다 더 많은 설정을 예상해야 한다 — 그 대가는 나중에, 프로덕션에서 한 단계를 교체하거나 디버깅해야 할 때 드러난다.
실수 3: Document Store 선택을 프로덕션 단계까지 미루기
InMemoryDocumentStore는 개발에 편리하지만 프로덕션 규모나 영속성을 위해 설계되지 않았다. retriever 동작과 인덱싱 전략이 백엔드에 따라 달라질 수 있으므로, 프로덕션용 Document Store(Elasticsearch, Weaviate, Pinecone, 또는 다른 지원 백엔드)는 일찍 정해야 한다.
자주 묻는 질문
Haystack이란 무엇인가?
Haystack은 독일에 본사를 둔 deepset이 만든 오픈소스 Python 프레임워크로, 검색·질의응답·RAG 파이프라인을 구축하는 데 쓰인다. Apache 2.0 라이선스이며 pip install haystack-ai로 설치한다.
Haystack은 누가 만드는가?
독일에 본사를 둔 deepset이다. deepset은 검색 증강 생성이 일반적인 용어가 되기 전인 2019년, 추출형 질의응답 프레임워크로 Haystack을 시작했다.
Haystack은 어떤 라이선스로 배포되는가?
Apache License 2.0이다. 소스코드는 github.com/deepset-ai/haystack에 있으며 자유롭게 사용·수정·셀프호스팅할 수 있다.
Haystack의 현재 버전은 무엇인가?
Haystack 3.2.0로, 2026년 9월 24일 출시되었다. 이 프레임워크는 Haystack 2.0을 전후로 현재의 Component/Pipeline 아키텍처로 대폭 재작성되었다.
Haystack에서 Component와 Pipeline의 차이는 무엇인가?
Component는 하나의 처리 단계다 — retriever, embedder, prompt builder, 또는 generator. Pipeline은 .add_component()와 .connect()의 명시적 호출로 연결된 Component의 그래프이며, 파이프라인 실행은 의존성 순서로 이 그래프를 순회한다.
Haystack은 LlamaIndex와 어떻게 다른가?
Haystack은 Pipeline 그래프에 연결된 명시적이고 타입이 지정된 Component를 중심으로 파이프라인을 구성한다. LlamaIndex는 데이터 위에 Index를 구축하고 Retriever와 QueryEngine을 통해 조회하는 것을 중심으로 구성한다. 데이터 인덱싱을 시작하는 데는 대체로 LlamaIndex가 더 빠르며, Haystack의 명시적 그래프는 프로덕션 파이프라인에 더 높은 가시성과 제어력을 제공한다.
Haystack은 LangChain과 어떻게 다른가?
둘 다 코드 우선 Python 프레임워크로, 오픈소스 코어에는 시각적 빌더가 없다. LangChain은 chain을 중심으로, LangGraph를 통해 에이전트를 위한 state graph를 중심으로 구성된다. Haystack은 타입이 지정된 Component의 Pipeline을 중심으로 구성되며, retrieval과 검색을 범용 체인의 한 고리가 아니라 1급이면서 측정 가능한 관심사로 다룬다.
Haystack은 특정 벡터 데이터베이스가 필요한가?
아니다. Haystack은 개발용으로 인메모리 Document Store를 제공하며, Elasticsearch, Weaviate, Pinecone를 포함한 여러 벡터 데이터베이스·검색 백엔드와 동일한 Component 인터페이스로 통합된다 — 백엔드를 바꿔도 파이프라인을 다시 작성할 필요가 없다.
deepset의 Haystack Enterprise Platform이란 무엇인가?
오픈소스 Haystack 프레임워크 위에 구축된 deepset의 유료 상용 제품으로, 시각적 파이프라인 빌더와 매니지드 또는 셀프호스팅 배포 옵션을 추가한다. 이 리뷰가 다루는 무료·셀프호스팅형 Apache 2.0 오픈소스 프레임워크와는 별개다.