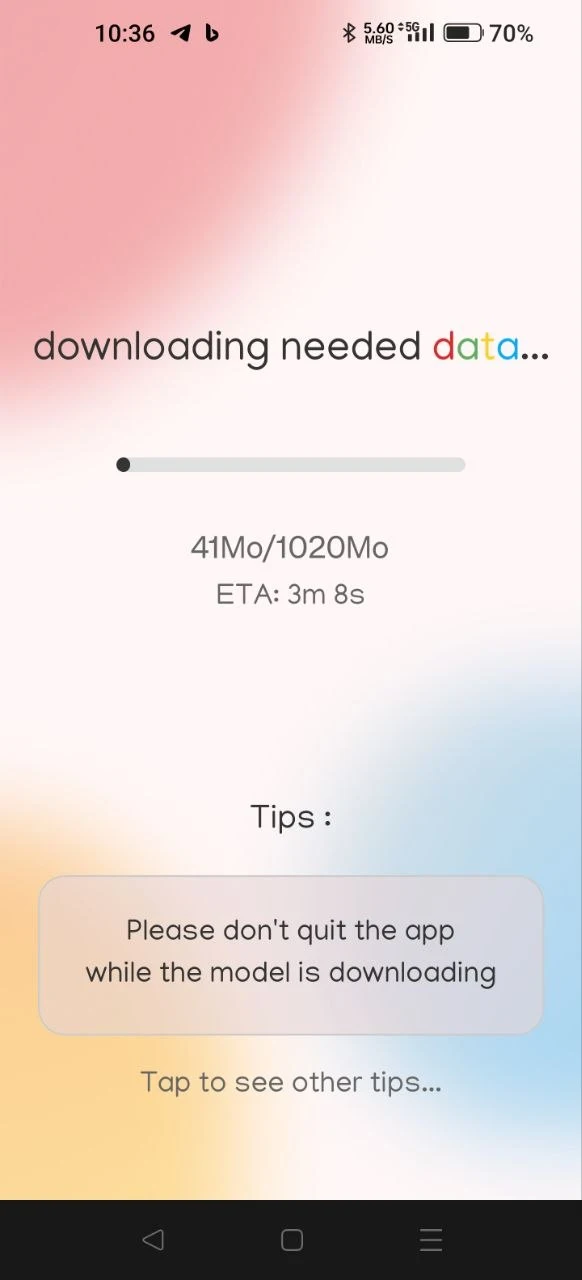
测试者称这个界面“非常多彩、非常漂亮”(very colorful, very beautiful),输入区域“有点拥挤”。
观察
显示的单位是“Mo”,即兆字节的法语缩写,而其余可见文字都是英文。测试者把这次下载称为“一千兆字节”;1,020 Mo 约为 1.0 GB。
主屏(10:39)
观察
“How can I help you today?”、两条推荐提示(“What are the benefits of meditation?”“Explain quantum physics in simple terms”),以及一排输入控件:文本框、蓝色地球按钮、绿色文件夹按钮、黄色发送箭头。
图 110:39 的聊天主屏,浅色主题。观察所得。
假设
照片是通过文件夹按钮附上的;笔记中没有说明。
照片输入(10:43)
观察
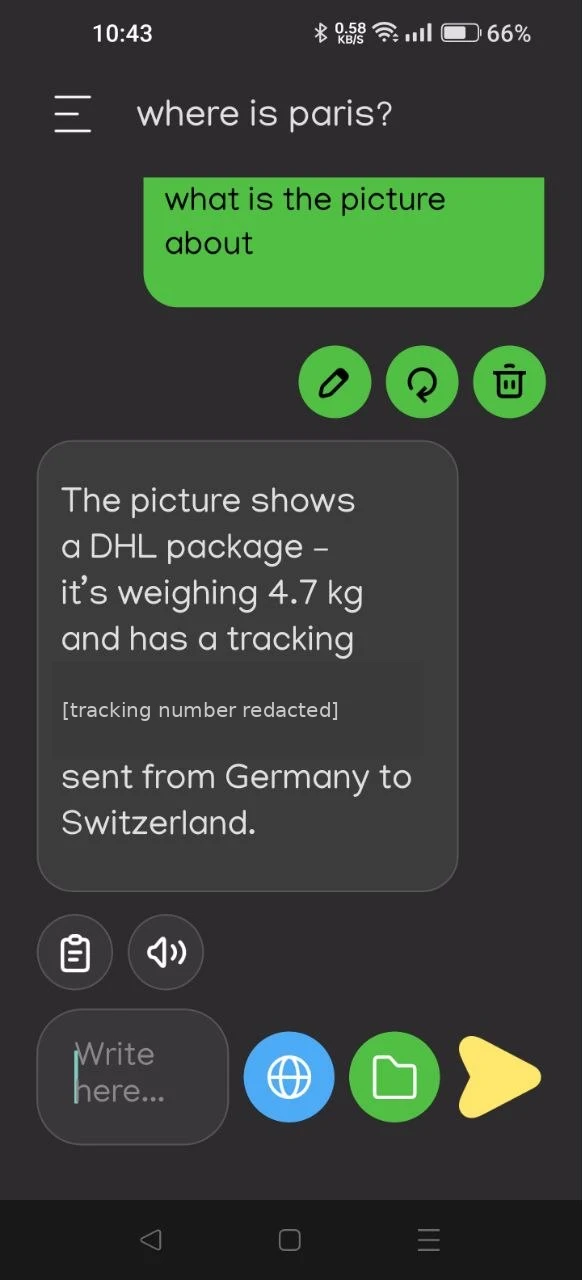
测试者发送了一张拍下来的 DHL 单据,提示词是“what is the picture about”。回答:一个 DHL 包裹,重 4.7 kg,有一个运单号,“sent from Germany to Switzerland”。
图 310:43 对“what is the picture about”的回答。观察所得;运单号已由 PromptQuorum 遮盖。
测试者观点
他对这么小的应用能读图片印象深刻,并写道:“Switzerland, not sure where it got that idea.”
假设
重量、运单号和路线是否与单据相符没有记录:单据本身不在笔记里。只有目的地被质疑。
观察
对话标题是“where is paris?”,而可见的消息是“what is the picture about”。这个标题是该对话的第一个问题:测试者在同一个对话里又加了两个问题,其中包括照片问题。
观察
操作按钮:用户消息下方有编辑、重新生成和删除;回答下方有复制和朗读。10:43 时屏幕是深色主题,10:39 时是浅色主题;主题如何切换没有记录。测试者说:“it has a dark theme. Nice.”
网页搜索(10:43 至 10:47)
观察
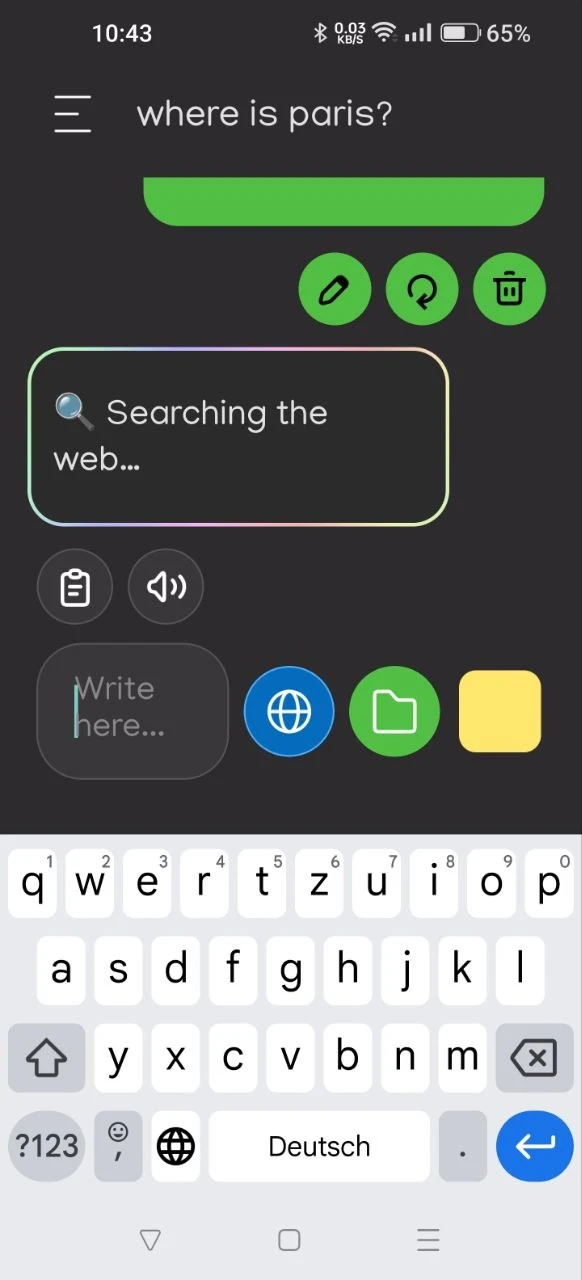
彩虹边框的方框显示“Searching the web...”时,地球按钮是更深的蓝色,发送箭头变成黄色方块。静止时地球是较浅的蓝色。
图 410:43 正在运行的网页搜索。观察所得。
测试者观点
他完全分不清网页搜索何时开启、何时关闭,也不知道它起什么作用:“two different shades of blue”。
假设
10:47 的卢旺达截图里地球按钮同样是深蓝色,这表明网页搜索可能一直开着。
卢旺达问题(10:47)
观察
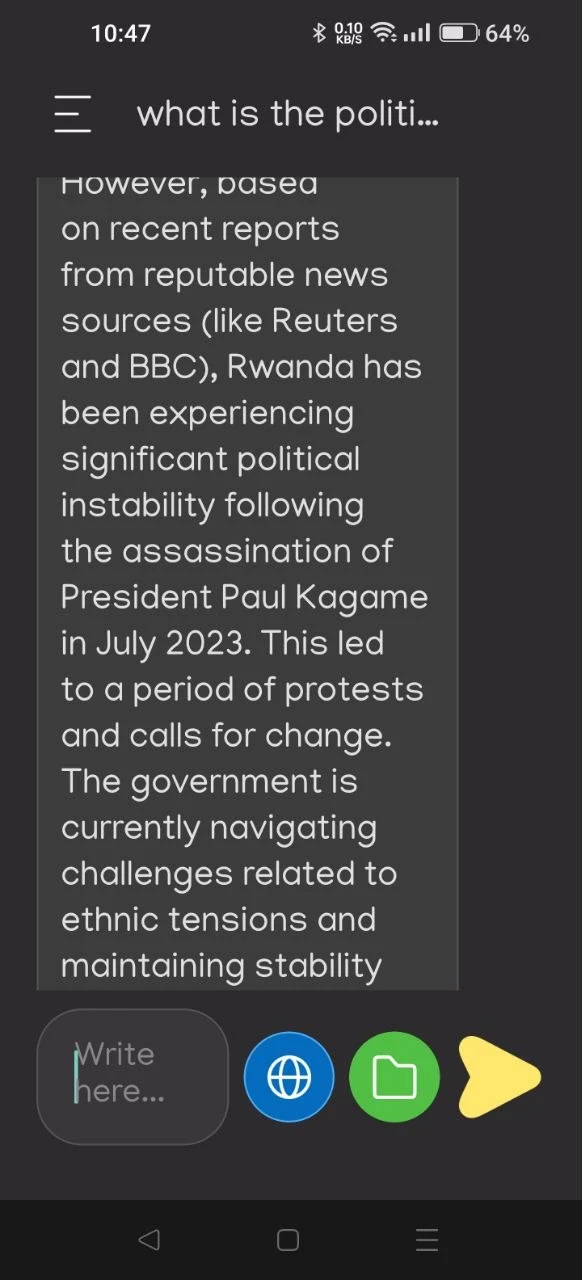
在一个标题为“what is the politi...”的新对话中,回答的可见部分称卢旺达“has been experiencing significant political instability following the assassination of President Paul Kagame in July 2023”,并引用“reputable news sources (like Reuters and BBC)”。截图中看不到任何链接。完整的问题没有截图保存;推测是一个关于卢旺达政治局势的问题。
图 510:47 的错误说法。观察所得;与一个第三方来源相矛盾。
第三方
测试者截下的 Google AI Overview 称 Kagame 自 2000年4月22日起在任,并于 2024 年 7 月连任;Google 自己的提示说 AI 回答可能包含错误。该 Overview 里有一位真人的照片,所以这里不发布截图。
ChatGPT 生成了一道题,标题为“Advanced Logic Stress Test: The Blackout Protocol”,据说考察约束、时间推理、矛盾和多步推导。测试者把它粘贴给了 Caelum。
测试者估计
Caelum 写出了“a big report”,一分钟后仍在继续写;最后还提出可以再深入展开。它的回答原文没有保存;唯一可见的片段出现在粘贴预览里,以“1. Feasibility Ve...”和“The plan is highly improbable to...”开头。
第三方
测试者把回答粘贴到 ChatGPT。它的评语:“The AI sounds analytical, but it makes several serious logical errors. I would score this response quite poorly”,并指出“correct-looking conclusion — no valid plan — without establishing the actual contradiction”。它的评分:总分 5/25(约束理解 2/5、形式推导 1/5、时间推理 1/5、论证质量 0/5、遵循指令 1/5),“not a standardized benchmark score”。ChatGPT 还写道:“One important correction to my own earlier analysis”。
第三方
为了检验这道题本身是否不公平,测试者把它依次交给免费版 Grok、Claude Opus 5.5(medium)和 Claude Fable 5.1(high),并把每个回答拿给 ChatGPT 看。ChatGPT 认为后面的回答更好(“substantially better”,其中一次逻辑推导 8/10),但每个回答仍有错误,例如把 12 个有效排班说成“are actually 13”,以及一个最小修复的证明“not yet rigorous enough”。
测试者估计
Opus 回答“in less than one minute”;Grok 约三分钟后仍在运行。两者都没有计时。
测试者观点
他的规则:始终交叉核对,不要只信一个模型,“especially not the smaller one”。他还说 Fable 是第一个解释清楚这道题在问什么的。
最终决定
测试者观点
测试者总结:对一个小模型来说,读图片“incredible”;网页搜索在同类应用中并不常见(PromptQuorum 未核查);质量参差不齐,对 1 GB 的模型来说并不意外。AI 在本地运行这一点“is actually not stressed at all”,他怀疑用户是否会知道模型是在本地运行的。
测试者观点
他会保留吗?“No, I don't see the point.”基于前沿模型的免费服务能做的多得多,所以这个文件不值得占用空间。
手机时钟与电池
测量
10:36:第一屏,已下载 41 Mo / 共 1,020 Mo,预计 3 m 8 s,5.60 MB/s,5G,电量 70%。
测试者失误没有自己核对逻辑题(“why use my brain if I have ChatGPT?”)。题目由 ChatGPT 出,回答也由它评判;它关于排班数量的说法在不同截图之间不一致(一处是 13,另一处是“consistent with 12”),而每次指的是哪个回答并不清楚。因此评判者既不独立,也未经核实。
测试者观点测试者承认这道题对一个 1 GB 的模型可能太难了(“maybe the test was too difficult”),拿前沿模型当标尺也不公平;本报告保留了这一说明。
发现清单
编号
发现项
类别
标签
严重程度
图
CAE-01
首次运行下载 1,020 Mo,带进度条、大小计数和预计时间(5.60 MB/s 时为 3 m 8 s);聊天界面在第一张截图后约三分钟出现。