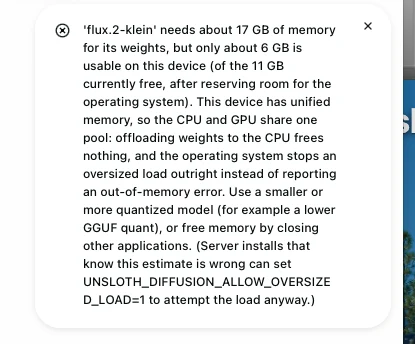
图 1 加载图像模型 flux.2-klein 被拒绝。应用报告需要约 17 GB,可用约 2 GB(当前空闲 7 GB,减去为操作系统预留的空间)。它给出了一个覆盖用的环境变量 UNSLOTH_DIFFUSION_ALLOW_OVERSIZED_LOAD=1,测试者没有试。结论 总体评价 应用看起来、用起来都很精致:24 MB 的安装包,会展示各个步骤的安装窗口,带硬件读数、大小警告和下载计时器的模型中心,以及能找到磁盘上已有的 LM Studio 和 Ollama 模型的聊天。一道计算题在 27B 模型上以 11.0 tokens/秒运行。但测试目标,也就是生成图片,没有达成。图像模型被拒绝加载,因为应用只把 2 GB(重启前)和 6 GB(重启后)算作可用,而需要约 17 GB;网页搜索和活动搜索都以'Ran out of memory'告终;有一次模型启动,几分钟都没有任何进度提示。测试者在开着许多其他应用的情况下做了最初几项测试,部分运行所用的模型和设置也没有记录。
是否适合测试者的使用场景 目前不适合这位测试者的这台机器。用他的话说:'一切都能用,只是最终结果是我没能让它跑起来。'聊天和模型管理在 24 GB 上可以用;图片生成在这次测试中不行。训练没有试。测试者打算三到六个月后再看。
已观察 聊天可以用:LM Studio 文件夹里的 27B 4-bit 模型以 11.0 tokens/秒回答了一道计算题。Ollama 和 LM Studio 的模型都会显示在应用里。 已测量 图像模型被拒绝加载:flux.2-klein 需要约 17 GB;应用算出约 2 GB 可用(7 GB 空闲),重启后约 6 GB 可用(11 GB 空闲)。没有生成图片。 测试者观点 界面很漂亮,一切都能用,但在 24 GB 的 Mac 上没有得到最终结果。 评分卡 状态: 部分完成 安装 4/5 24 MB 的 DMG;安装窗口带详细日志。没有时间或磁盘占用估算;测试者估计要四到五分钟。测试是从已有的安装开始的。 引导与模型选择 3/5 选择器、模型中心、硬件读数、大小警告和下载计时器都很出色。选择器显示的是参数量而不是 GB;'7 GB'和'17 GB'的提示让测试者困惑。 核心功能 2/5 聊天回答了一道计算题。读取网页和活动搜索以内存不足错误告终;没有生成图片。 引导与迭代 3/5 拒绝加载的提示说明了原因,并给出了一个覆盖选项。模型启动时没有进度;也没有解释为什么'空闲'的是 7 GB。 性能 2/5 27B 4-bit 模型 11.0 tok/s;在开着其他应用的 24 GB Mac 上,34.4k 上下文时内存不足。 文档 不适用 未测试。 信任与隐私 不适用 未做审计。供应商宣称可以 100% 离线使用;网页搜索和下载需要联网。离线运行没有测试。 卸载 不适用 未测试。 评分是根据下方证据提出的建议值(1 = 差,5 = 很好),需由测试者确认。图片生成是测试者的目标,因为在这台机器上没有生成任何图片,所以得分较低。
测试详情
应用 Unsloth 桌面应用(Unsloth Studio)。笔记里写作'Unsloth'、'Unslothh'和'Onslaught'(语音转写);本报告采用'Unsloth'。 已观察
版本 安装日志:'unsloth 2026.8.18 -> 2026.10.3 available, updating'。更新后使用的版本假定为 2026.10.3。窗口带有 BETA 标记。桌面应用自身的版本未记录。 假设
测试者 Hans Kuepper,PromptQuorum 创始人
开始时间 2026 年 10 月 9 日下午 1 点(按笔记)。有一张截图显示下午 5:13,所以测试至少持续了四个小时。 已观察
结束时间 未记录
硬件 24 GB 的 Mac。笔记写的是'macOS M3 24 GB',后来又写'M3 24 GB Pro MacBook'。应用的 Model hub 显示'24 GiB RAM'、'0 GiB VRAM + 24 GiB shared'和'12/12 CPU'。具体芯片未记录。 已观察
系统 macOS;版本未记录
安装状态 不是全新安装。安装日志写着'Updating existing Unsloth install'和'existing install detected';测试者说'和以前一样'。此前用过,可能就是应用已经认得 LM Studio 和 Ollama 模型的原因。 已观察
下载 24 MB 的 DMG(按测试者读到的数值)。首次启动时会运行一个依赖安装步骤(见第 1 章)。 已观察
测试原因 想看看 Unsloth 怎么用,'尤其是图片功能'。测试者没打算用模型优化(训练)功能。
测试目标 在 24 GB 的 Mac 上本地生成图片。过程中顺便试了聊天和模型中心。 已观察
使用的 AI 辅助 笔记里有一段几百字的纽约天际线提示词,其中的 Markdown 粗体标记表明它可能由 AI 撰写,但未经确认。聊天模型的回答(例如关于它从哪里得到模型)在这里没有作为依据。 假设 每条陈述都带有标签: 已观察 已测量 测试者估计 厂商声明 第三方 假设 测试者观点 测试者失误 标签含义
利益披露。 测试者创办了 PromptQuorum(promptquorum.com),一个关于本地 AI 应用的内容网站和目录。Unsloth 收录在该目录中,网站上已有一篇单独撰写的评测页。笔记中没有与供应商联系、付款或赞助的记录。
原始笔记 PDF: 待补充
左右这次测试的六个时刻 一切都能用,只是最终结果是我没能让它跑起来。
测试者笔记,由语音转写稍作整理。 测试经过 下载、安装与首次启动 已观察
安装包是一个 24 MB 的 DMG,测试者形容它是'我见过的最小的文件'。
已观察
第一个窗口:'Getting things ready... This won't take long.',旁边有链接'Show setup details'。测试者说:'比其他应用感觉精致多了……沟通很清楚。'
图 2 打开 24 MB DMG 应用后的第一个窗口。文字说不会花很久;测试者没有计时,估计要四到五分钟(更新日志见正文)。窗口没有显示时间或磁盘估算。已观察
详细日志写着:'Updating existing Unsloth install'、'frontend bundled (Tauri)'、'node v24.13.0 | npm 11.6.2 (system)'、'unsloth 2026.8.18 -> 2026.10.3 available, updating',然后是一个 13 步的依赖进度条(pip bootstrap、面向 Apple Silicon 的 MLX 栈、基础包、unsloth extras、编解码器、overrides、studio deps、data designer、本地插件、diffusers pin、收尾)。备注:'torch 2.10.0 detected -- installing torchao==0.16.0';'transformers 5.3.0, 5.5.0, 5.10.2 pre-installed';'gpu Apple Silicon (Metal, unified memory)';'installing prebuilt llama.cpp'。
已观察
测试者说大约运行了四五分钟,然后应用打开。日志里没有时间估算,也没有磁盘空间估算。
假设
这个很小的 DMG 很可能是在这第一步里下载大部分软件。未核实。
测试者观点
'它告诉我它在做什么——很好——但没有告诉我预计耗时、数据量,或者会占多少磁盘空间。'
已观察
主窗口打开,显示'How can I help?',侧边栏有:New chat、Model hub、Library、Images、Train、More。标志上带有 BETA 标记。
图 3 安装完成后的主窗口。侧边栏:New chat、Model hub、Library、Images、Train、More。标志上带有 BETA 标记。窗口后面的浏览器标签页显示的是该项目的 GitHub 页面。测试者失误
测试是从已有的安装开始的('和以前一样'),所以这是一次更新,而不是首次运行测试。引导方面的结论需要在全新安装上确认。
模型选择器与第一次聊天 已观察
模型选择器列出了 Recommended 模型,数字如 27.3B 和 271.0M。这些是参数量,不是 GB。有两个条目呈灰色(176.9B 和 320.8B)。
图 4 模型选择器,Recommended 标签页。这些数字是参数量(B = 十亿,M = 百万),不是 GB。有两个条目呈灰色(Qwen3.8-Flash-Next-GGUF 176.9B、GLM-5.3-Flash-GGUF 320.8B)。灰色和黄点是什么意思,截取到的应用界面没有说明。假设
灰色条目大概是对这台机器来说太大了。截取到的应用界面没有这么说。
测试者观点
'列出了很多模型,还带着大小。非常好。'但显示的数字是参数量,所以读者看不出模型需要多少内存。
已观察
测试者没有选模型,而是直接输入了一个计算请求。应用自己开始加载模型。按笔记,一个 Qwen3.8-27B MLX 4-bit 模型不到一分钟就启动了;第二个提示显示 Mistral-7B-Instruct-v0.3-4bit 正在加载(截图未收录,与图 5 同类)。
已观察
加载提示显示路径 /Users/hanskuepper/.lmstudio/models/lmstudio-community/Qwen3.8-27B-MLX-4bit。模型是从磁盘上 LM Studio 的文件夹读取的。
图 5 第一次聊天开始时显示的提示。路径指向 LM Studio 的模型文件夹:/Users/hanskuepper/.lmstudio/models/lmstudio-community/Qwen3.8-27B-MLX-4bit。模型是从磁盘加载的,不是下载的。测试者观点
他怀疑是从硬盘来的,因为'这么大的模型不可能一分钟内从网上下完'。路径印证了这一点。Unsloth 为什么选了这个模型和那个 Mistral 模型,没有记录。
已观察
问题'what is 5 times 866'在'Worked for 10s'之后得到回答'5 x 866 = 4,330'(正确),速度 11.0 tok/s。标题栏显示'Local'和上下文计量'120 / 262.1k'。
图 6 第一次聊天。答案 4,330 是正确的(5 x 866)。屏幕显示'Worked for 10s'、11.0 tok/s,以及上下文计量'120 / 262.1k'。已观察
测试者接着问模型,它是从哪里得到这个模型的。截取到的回答部分谈到了 MLX 权重和 Apple Silicon 统一内存;完整回答没有截取。按笔记,回答是应用不会搜索磁盘。
假设
聊天模型对这个应用的自述不是可靠的证据。其中一个回答把模型称为'Qwen 3 27B MLX 4-bit',而应用里的名称是 Qwen3.8-27B-MLX-4bit。
磁盘上已有的模型:LM Studio 和 Ollama 已观察
On Device 标签页按来源列出模型。在 CUSTOM FOLDERS 下出现两个路径(.lmstudio/models 和 .ollama/models),Ollama 模型有 gemma4:latest、gemma3:1b 和 qwen3-coder:30b。在 LM STUDIO 下,Qwen3.8-27B 模型标着'Loaded'。
图 7 On Device 标签页。在 CUSTOM FOLDERS 下列出两个路径(.lmstudio/models 和 .ollama/models),Ollama 模型有 gemma4:latest、gemma3:1b 和 qwen3-coder:30b;在 LM STUDIO 下,Qwen3.8-27B 模型标着'Loaded'。列表后面隐约可见的一段聊天回答谈到了 MLX 权重。这些文件夹是测试者添加的还是自动发现的,没有记录。假设
这两个文件夹要么是测试者添加的,要么是应用自己找到的。没有记录。此前使用应用时可能已经设置好了。
已观察
切换到 qwen3-coder:30b(30.5B、Q4_K_M、GGUF)时显示'Starting model... Switching models. Loading cached model into memory.',带一个 Cancel 按钮。上下文计量显示'1.3k / 8.2k',比第一个模型的 262.1k 小得多。
图 8 切换到 Ollama 模型 qwen3-coder:30b(30.5B、Q4_K_M、GGUF)。上下文计量'1.3k / 8.2k'。提示写着'Starting model... Switching models. Loading cached model into memory.',带一个 Cancel 按钮。测试者观点
'我喜欢切换模型这么容易。''有些 Ollama 模型在 Unsloth 里不能用,但至少它试了,这很好。'
已观察
按笔记,一个较旧的模型能用,一个较新的崩溃了。具体指哪些模型,没有记录。
测试者观点
他说它'试着去用'他的 Ollama 模型,这很好;而且直接读取磁盘上已有的模型,可以避免再下载一次大文件。
模型中心与下载 已观察
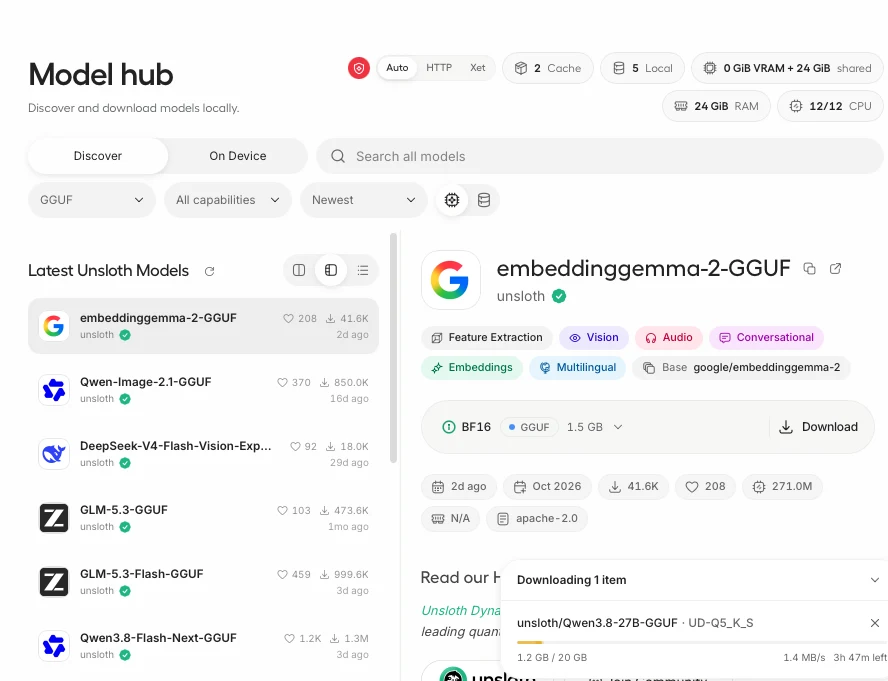
模型中心显示设备信息:'0 GiB VRAM + 24 GiB shared'、'24 GiB RAM'、'12/12 CPU',以及筛选项(格式、能力、最新)。卡片显示点赞数、下载量、发布时间和许可证(embeddinggemma-2-GGUF:apache-2.0,1.5 GB)。
图 9 Model hub。右上角:'0 GiB VRAM + 24 GiB shared'、'24 GiB RAM'、'12/12 CPU'。下载面板:unsloth/Qwen3.8-27B-GGUF UD-Q5_K_S,20 GB 中的 1.2 GB,1.4 MB/s,剩余 3 小时 47 分。打开的模型卡片 embeddinggemma-2-GGUF(1.5 GB,apache-2.0)并不是正在下载的模型。测试者观点
'是的,很棒的模型中心。'中心里列有 Qwen-Image-2.1-GGUF(85.0 万次下载,发布 16 天)、GLM-5.3-GGUF 和 Qwen3.8-Flash-Next-GGUF 等。
已观察
按笔记,点击一个对这台 Mac 来说太大的文件时出现了好几条警告('this file is 30 to 40 gigabytes total');但仍然允许下载。没有截图。
已测量
unsloth/Qwen3.8-27B-GGUF UD-Q5_K_S 的下载面板显示 20 GB 中的 1.2 GB,1.4 MB/s,剩余 3 小时 47 分;之后是 20 GB 中的 7.1 GB,983 KB/s,剩余 3 小时 31 分。
图 10 同一个下载的稍后状态:20 GB 中的 7.1 GB,983 KB/s,剩余 3 小时 31 分。这张与上一张截图之间相隔多久,没有记录。测试者观点
'这个应用的专业性看得出来。它带着计时器,还告诉你下载速度。'
假设
这些速度说明测试地点的网络较慢;测试者没有这么说。下载是否完成,没有记录。
已测量
Z-Image (BF16) 对话框列出模型文件 12.3 GB,加上必需的编码器和解码器 8.2 GB,共 20.5 GB。这说明了测试者在别处提到的'模型本身的 GB 数和另外那部分之间的差别'。
图 19 Z-Image (BF16) 的下载对话框:模型文件 12.3 GB,'Include required files' 8.2 GB(编码器和解码器,兼容的变体之间共用),共 20.5 GB。'Downloading will not load this model or switch your current model.'测试者观点
笔记里写着'图像 LLM 已经下载了'。具体是哪一个,没有记录;截图显示设备上有图像模型 FLUX.2-klein-4B 及其 GGUF 版本(图 18)。
网页搜索、语音与崩溃 已观察
测试者粘贴了一个 PromptQuorum 页面的网址,问'from a seo perspective will this help me?'。聊天显示'Using tool: Reading promptquorum.com'和'Waiting for approval: web_search',按钮有 Allow、Always allow 和 Deny。时间戳下午 5:13;上下文'648 / 34.4k'。
图 11 与 Qwen3.8-27B-MLX-4bit 的聊天,上下文'648 / 34.4k',时间戳下午 5:13。提示词给出了一个 PromptQuorum 网址并询问 SEO。应用显示'Waiting for approval: web_search'和按钮 Allow、Always allow、Deny。模式为'Approve for me'。已观察
按笔记,第一次尝试说读不了这个页面;点击 Search 功能后,第二次成功了。'第一次也许应该给个警告。'
假设
第一次失败可能是因为没有批准网页搜索,或者 Search 开关是关着的。未核实。
已观察
这次运行在 168.10 秒后以'Ran out of memory. Try a smaller model or shorter input.'结束,带一个 Retry 按钮。
图 12 同一个聊天在 168.10 秒后以'Ran out of memory. Try a smaller model or shorter input.'结束。已观察
语音输入是内置的。使用它会要求下载'Qwen3-ASR 0.6B'语音模型,约 1.0 GB,提示说会一次性下载到 Hugging Face 缓存里。测试者是否下载了,没有记录。
图 13 语音输入:'Local dictation runs entirely offline, but it needs the Qwen3-ASR 0.6B speech model first. About 1.0 GB, fetched once into your Hugging Face cache.'测试者是否下载了,没有记录。已观察
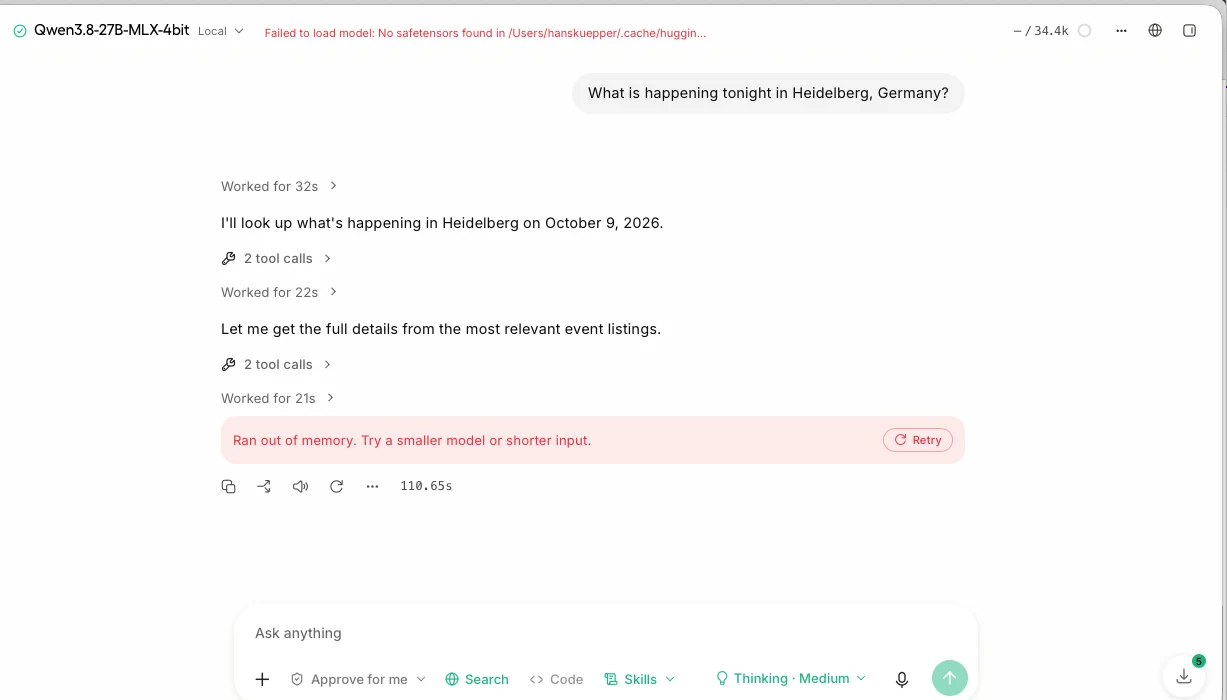
一次本地活动搜索('What is happening tonight in Heidelberg, Germany?')经过两轮工具调用,在 110.65 秒后以'Ran out of memory'结束。标题栏有一条红色提示:'Failed to load model: No safetensors found in /Users/.../.cache/huggin...'。
图 14 本地活动搜索。标题栏(红色):'Failed to load model: No safetensors found in /Users/.../.cache/huggin...'。聊天里有两轮'tool calls',然后在 110.65 秒后出现'Ran out of memory. Try a smaller model or shorter input.'上下文'- / 34.4k'。下载角标显示 5。假设
加载错误和内存不足的提示可能有关(内存紧张时正在切换模型)。截图没有显示两者之间的联系。
测试者观点
'不过是啊,本地 AI,总是有些问题。'
图像模型:因内存被拒绝 已观察
测试者的目标是图片。侧边栏有一个'Images'条目。笔记里有一段很长的纽约天际线提示词(布鲁克林视角、布鲁克林大桥、黄金时刻、8K 细节),附带构图和避免项列表。没有记录它的结果、错误或设置。
已测量
加载图像模型 flux.2-klein 被拒绝:'needs about 17 GB of memory for its weights, but only about 2 GB is usable on this device (of the 7 GB currently free, after reserving room for the operating system)'。提示还补充说,Mac 只有一个内存池,卸载到 CPU 并不能释放内存,并建议换更小的模型、更低的量化或关闭其他应用。它给出了 UNSLOTH_DIFFUSION_ALLOW_OVERSIZED_LOAD=1 作为覆盖选项。
图 1 加载图像模型 flux.2-klein 被拒绝。应用报告需要约 17 GB,可用约 2 GB(当前空闲 7 GB,减去为操作系统预留的空间)。它给出了一个覆盖用的环境变量 UNSLOTH_DIFFUSION_ALLOW_OVERSIZED_LOAD=1,测试者没有试。已测量
干净重启之后,提示变成:需要约 17 GB,可用约 6 GB,当前空闲 11 GB。
图 15 flux.2-klein 第二次被拒绝:需要约 17 GB,可用约 6 GB(当前空闲 11 GB)。按笔记中的顺序,这里视为干净重启之后截取的。假设
两条提示中,两组数字都相差 5 GB(7 - 2 和 11 - 6),所以应用似乎为操作系统预留了约 5 GB。只有两个数据点。
已观察
设备列表显示 FLUX.2-klein-4B-GGUF(7.8 GB)、FLUX.2-klein-4B(16 GB)和 mistral-7b-v0.3-bnb-4bit(4.1 GB)。测试者:'这个应该够小了。'测试者说,中心里最小的图像模型会让他的 24 GB 机器崩溃,而且他点开的模型都说太大,因为只有'七个 GB'可用。
图 18 UNSLOTH 下设备上的模型:FLUX.2-klein-4B-GGUF(BF16,图片图标,4B,7.8 GB)、FLUX.2-klein-4B(图片图标,4B,16 GB)、mistral-7b-v0.3-bnb-4bit(7B,4.1 GB)。测试者失误
测试者不明白为什么只有七个 GB 可用('我的内存多得多')。对话框写明,当时空闲的是 7 GB,其他应用都在运行;重启之后则显示 11 GB。笔记把'7 GB'这句话放在 Z-Image 对话框旁边;而 7 GB 这个数字出现在 flux.2-klein 的提示里。
测试者观点
'我迷茫了……我有一台 24 GB 的机器,却找不到一个能为我所用、能把事情做完的 LLM。'他认为 24 GB 已经超过他读者所用内存的 80%(他自己的估计,不是实测数据)。
测试者估计
'我的读者中超过 80%'的内存不超过 24 GB。未给出来源。
Mac 上的内存 已观察
测试者的结论是,本地模型和日常工作在争用同一份内存,Chrome 和其他应用就要占 5 到 8 GB。他通篇写的都是'VRAM';Apple Silicon 只有一个内存池,模型中心也是这么显示的('0 GiB VRAM + 24 GiB shared')。
已测量
活动监视器,一次截取:已使用内存 12.92 GB,缓存文件 10.95 GB,App 内存 9.81 GB,联动内存 1.83 GB,交换 0。
图 16 内存面板,历史曲线长而平。已使用内存 12.92 GB,缓存文件 10.95 GB,App 内存 9.81 GB,联动内存 1.83 GB,已用交换 0 字节。截取的时刻和当时打开的应用都没有记录。已测量
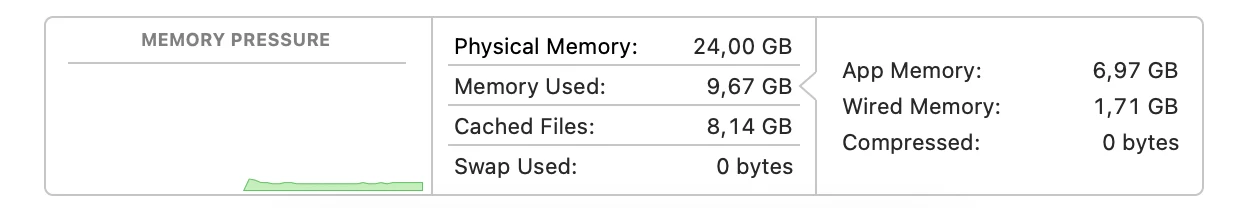
活动监视器,另一次截取:已使用内存 9.67 GB,缓存文件 8.14 GB,App 内存 6.97 GB,联动内存 1.71 GB,交换 0。较短的历史曲线与刚启动不久相符。
图 17 内存面板,历史曲线较短,在图的后段才开始。已使用内存 9.67 GB,缓存文件 8.14 GB,App 内存 6.97 GB,联动内存 1.71 GB,交换 0。与笔记中'启动时 10 GB'的说法相符;它显示的是哪个时刻,没有记录。假设
图 15 中'当前空闲'的 11 GB,与图 16 的 24.00 - 12.92 = 11.08 GB 吻合。两者是否在同一时刻截取,没有记录。
测试者观点
'即使重启之后,通用的东西就已经占掉九个 GB 了。''要么我关机、重启、停掉所有进程……要么就没法运行 LLM。'
测试者观点
两种可能的出路:模型必须变得更小更好,或者电脑需要 48 或 64 GB。'所有那些说在你的电脑上也能跑的话,有点假。'
假设
48 或 64 GB 能'稳稳地'解决这个问题,未经测试。
加载时没有反馈,以及最后的看法 已观察
启动模型时会出现一个提示'Starting model... Loading cached model into memory.',带一个转圈图标和 Cancel。没有百分比、大小或时间。
图 20 模型启动。提示显示一个转圈图标和'Loading cached model into memory.'没有百分比,没有大小,没有时间。测试者说持续了两三分钟以上(估计)。测试者观点
'对待客户最糟糕的方式,就是把活干了却不告诉客户进展。'测试者称这是用户界面问题。
已观察
标题栏的计量显示已用 token 与上下文的对比(例如'648 / 34.4k')以及每秒 token 数(11.0 tok/s)。
测试者失误
笔记里写着'没有 token 计数器'。但截图显示有上下文计量和每秒 token 数。他指的可能是每条消息的 token 数(假设)。
测试者失误
笔记把本地聊天模型称为'最蠢的主意',因为它'不会上网查资料'。而同一份笔记和截图里却有 Search 功能、网页搜索批准提示,以及读取页面的工具调用。
测试者观点
他不想训练模型;聊天功能对他用处不大;他想要的是图片和视频工具,而'目前还没看到'。训练和'Train'标签页没有试。
测试者观点
'也许问题出在我这边,但不,不适合我。我三个月或六个月后会再看看,但目前在 M3 24 GB 的 Pro MacBook 上不行。'
官方说法与测试者所见 说法 来源 已观察 标签 'Run and train image and video diffusion or multimodal models',本地运行(GitHub README;文档页面) 供应商,2026 年 10 月 16 日查阅 没有生成图片。flux.2-klein 被拒绝加载(需要约 17 GB;可用 2 GB 和 6 GB)。更小的图像版本没有显示能够加载。训练没有试。 已观察 macOS 上'Training, MLX and GGUF inference all work inside of Unsloth'(文档) 供应商,2026 年 10 月 16 日查阅 一个 MLX 模型(Qwen3.8-27B 4-bit)和一个 GGUF 模型(qwen3-coder:30b)都加载并回答了。训练没有试。 已观察 'Can be used 100% offline and locally on your computer'(文档) 供应商,2026 年 10 月 16 日查阅 网页搜索和下载使用了互联网。离线使用没有测试。 已观察 网页搜索'visits pages directly'(文档) 供应商,2026 年 10 月 16 日查阅 尝试过读取页面;按笔记,第一次失败,第二次读取成功。随后这次运行内存不足。 已观察 桌面应用'free and open source'(发布说明) 供应商,2026 年 10 月 16 日查阅 笔记和截图中都没有出现付款提示。 已观察 模型中心显示的硬件 应用 模型中心显示 24 GiB RAM、0 GiB VRAM + 24 GiB shared 和 12/12 CPU。RAM 数值与这台 Mac 的 24.00 GB 相符。 已测量 'No hardware requirements stated'(已读页面) 供应商,2026 年 10 月 16 日查阅 GitHub 页面和文档页面返回的文本中都没有写明内存要求。应用在加载时会说明自己的需求(flux.2-klein 为 17 GB)。 已观察
能装进 24 GB 吗? 24 GB 内存
flux.2-klein 权重,按拒绝加载的提示 需要约 17 GB 低于 24 GB 已测量 FLUX.2-klein-4B(设备列表) 文件大小 16 GB 低于 24 GB 已测量 FLUX.2-klein-4B-GGUF(设备列表) 文件大小 7.8 GB 低于 24 GB 已测量 应用算出的可用内存,重启前 7 GB 空闲中约 2 GB 可用 低于 24 GB 已测量 应用算出的可用内存,重启后 11 GB 空闲中约 6 GB 可用 低于 24 GB 已测量 Mac 已用内存,活动监视器(第一次截取) 已用 12.92 GB 低于 24 GB 已测量 Mac 已用内存,活动监视器(第二次截取) 已用 9.67 GB 低于 24 GB 已测量 Z-Image BF16 总下载量 12.3 GB 模型 + 8.2 GB 必需文件(下载大小) 低于 24 GB 已测量 第 2、3 和 8 行是文件或下载大小,不是运行时的内存占用。17 GB 是应用自己对 flux.2-klein 的估算;它指的是哪个文件版本,没有记录。'可用'是应用在为操作系统预留空间之后的数值。Qwen3.8-27B MLX 4-bit 模型在聊天中运行过;它的内存占用没有读取。
使用记录 # 任务 模型 结果 用时 状态 图 1 打开 24 MB 的应用、更新、首次启动 Unsloth 2026.8.18 -> 2026.10.3(假定) 安装日志之后打开;已有安装 约 4-5 分钟(测试者估计) 通过 图 2 , 图 3 2 从选择器里选一个模型 未记录 列表带参数量;测试者没有选 未记录 通过 图 4 3 聊天:计算题(5 x 866) Qwen3.8-27B-MLX-4bit 4,330,正确;11.0 tok/s;10 秒 10 秒(已测量) 通过 图 6 4 问聊天模型这个模型是从哪来的 Qwen3.8-27B-MLX-4bit 回答只截取到一部分 未记录 部分完成 图 7 5 切换到一个 Ollama 模型 qwen3-coder:30b(Q4_K_M,GGUF) 已加载;上下文 8.2k。按笔记,有些 Ollama 模型不能用 未记录 部分完成 图 8 6 浏览模型中心并开始一个 20 GB 的下载 unsloth/Qwen3.8-27B-GGUF UD-Q5_K_S 下载已开始;剩余 3 小时 47 分,随后 3 小时 31 分;结束情况未记录 未记录 部分完成 图 9 , 图 10 7 对过大模型(30-40 GB)的警告 未记录 出现多条警告,仍允许下载(仅见于笔记) - 通过 - 8 从 SEO 角度评估一个网页 Qwen3.8-27B-MLX-4bit 出现批准提示;以'Ran out of memory'结束 168.10 秒 失败 图 11 , 图 12 9 语音输入 Qwen3-ASR 0.6B(约 1.0 GB) 下载对话框;结果未记录 未记录 未完成 图 13 10 本地活动搜索(海德堡) Qwen3.8-27B-MLX-4bit 加载错误和内存不足 110.65 秒 失败 图 14 11 纽约天际线图片,长提示词 未记录 没有记录结果 未记录 未完成 - 12 加载 flux.2-klein,开着许多应用 flux.2-klein 被拒绝:需要 17 GB,7 GB 空闲中 2 GB 可用 - 失败 图 1 13 干净重启后加载 flux.2-klein flux.2-klein 被拒绝:需要 17 GB,11 GB 空闲中 6 GB 可用 - 失败 图 15 14 试用设备上更小的图像模型 FLUX.2-klein-4B-GGUF 7.8 GB;FLUX.2-klein-4B 16 GB 按笔记'都太大';没有每个模型的截图 - 失败 图 18 15 Z-Image BF16 下载对话框 Z-Image BF16 共 20.5 GB;下载情况未记录 - 未完成 图 19 16 启动一个模型(已缓存) 未记录 转圈图标和'Loading cached model into memory',没有进度;结果未记录 超过 2-3 分钟(测试者估计) 部分完成 图 20
测试者出错的地方 测试者失误 测试的是已有安装的更新('和以前一样'),不是首次运行的安装。 测试者失误 在 24 GB 的 Mac 上,开着 Chrome、Claude 应用、Word、WhatsApp 和其他应用的情况下做了最初的内存测试。第一次被拒绝时显示空闲 7 GB。 测试者失误 通篇用'VRAM'指内存,尽管应用显示的是'0 GiB VRAM + 24 GiB shared'。 测试者失误 写道'没有 token 计数器';而截图显示有上下文计量和每秒 token 数。 测试者失误 写道本地聊天模型'不会上网查资料';而截图显示有 Search 功能和网页搜索工具调用。 测试者失误 把模型选择器里的数字当成了大小;它们其实是参数量。 测试者失误 记下只有七个 GB 可用,却没有说明当时还开着什么;对话框写的是当时空闲 7 GB。 测试者失误 记录有缺口:桌面应用的版本、macOS 版本、芯片型号、结束时间、纽约提示词用的是哪个模型以及结果如何、哪些 Ollama 模型失败了、20 GB 的下载是否完成、图像运行的设置,以及卸载。 测试者失误 在笔记里把应用写成了'Onslaught'和'Unslothh'(语音转写)。 假设 笔记把 Z-Image 对话框放在'只有七个 GB'那句话旁边;而 7 GB 这个数字出现在 flux.2-klein 的提示里。截图是根据其内容与文字对应的,而不只是按顺序。 发现清单 全部 已观察 已测量 测试者估计 厂商声明 第三方 假设 测试者观点 测试者失误
编号 发现项 类别 标签 严重程度 图 UN-01 DMG 只有 24 MB,比测试者见过的其他应用小得多。 安装 已观察 正面 图 2 UN-02 首次启动会运行一个 13 步的依赖安装,约四到五分钟,没有时间或磁盘估算。详细日志可见。 安装 测试者估计 中 图 2 UN-03 测试是从已有的安装开始的(2026.8.18 到 2026.10.3),所以首次运行的表现没有测试。 测试局限 已观察 中 图 3 UN-04 模型选择器显示的是参数量(27.3B、271.0M),而不是下载或内存大小;有些条目呈灰色,截图中没有说明原因。 引导 已观察 中 图 4 UN-05 一个 27B 4-bit 模型以 11.0 tok/s 在 10 秒内正确回答了'5 x 866'。 核心功能 已测量 正面 图 6 UN-06 第一次聊天从 LM Studio 的文件夹加载了模型,没有下载,也没有提示。 模型处理 已观察 中 图 5 UN-07 LM Studio 和 Ollama 文件夹里的模型都出现在 On Device 列表中。 模型处理 已观察 正面 图 7 UN-08 有些 Ollama 模型在 Unsloth 里不能用;具体是哪些,没有记录。 兼容性 已观察 中 - UN-09 模型中心显示 RAM、共享内存、CPU 数量,以及带速度和剩余时间的下载面板。 模型中心 已观察 正面 图 9 , 图 10 UN-10 一个 20 GB 的下载在 1.4 MB/s 时显示剩余 3 小时 47 分(取决于网络)。 模型中心 已测量 低 图 9 UN-11 过大的模型会触发多条警告,但仍可下载(仅见于笔记)。 模型中心 已观察 正面 - UN-12 下载对话框把模型文件和必需文件分开列出(12.3 + 8.2 = 20.5 GB)。 模型中心 已测量 正面 图 19 UN-13 网页搜索需要批准;按笔记,第一次尝试在没有任何警告的情况下读取页面失败。 用户体验 已观察 低 图 11 UN-14 用 27B 模型读取网页,在 168.10 秒后以'Ran out of memory'结束。 稳定性 已观察 高 图 12 UN-15 一次活动搜索以'Failed to load model: No safetensors found'失败,并在 110.65 秒后出现'Ran out of memory'。 稳定性 已观察 高 图 14 UN-16 语音输入是内置的,但需要另外下载 1.0 GB 的语音模型。 功能 已观察 低 图 13 UN-17 flux.2-klein 拒绝加载:需要约 17 GB,可用约 2 GB(空闲 7 GB)。 核心功能 已测量 高 图 1 UN-18 干净重启后:11 GB 空闲中约 6 GB 可用;再次被拒绝加载。 核心功能 已测量 高 图 15 UN-19 应用似乎为操作系统预留了约 5 GB(两个数据点)。 内存 假设 中 图 1 , 图 15 UN-20 拒绝加载的提示解释了原因(只有一个内存池,卸载到 CPU 没有帮助),并给出了一个覆盖用的环境变量。 引导 已观察 正面 图 1 UN-21 Mac 在刚启动后、还没加载模型时就已用掉约 9.67 GB。 内存 已测量 中 图 17 UN-22 在 24 GB 的 Mac 上没有生成图片;笔记里提到,列出的最小图像模型(7.8 GB、16 GB)也被说成'太大'。 核心功能 已观察 高 图 18 UN-23 启动模型时显示一个没有百分比或时间的转圈图标,持续两三分钟甚至更久。 用户体验 已观察 中 图 20 UN-24 聊天标题栏显示上下文计量和每秒 token 数,与'没有 token 计数器'的笔记相反。 用户体验 已观察 正面 图 6 UN-25 测试者认为界面漂亮、流畅,但没能得到结果,现在也看不出有什么理由使用这个应用。 总体 测试者观点 中 - UN-26 目录里把许可证列为 Apache-2.0;GitHub 页面说 Studio UI 是 AGPL-3.0,核心是 Apache-2.0。 维护 第三方 中 -
严重程度指对第一次使用的用户的影响。为建议值,并非实测。
适合谁 可能适合 假设 内存超过 24 GB,或机器干净、开着的应用很少,并希望在一个应用里同时拥有聊天、模型中心以及来自 LM Studio 和 Ollama 的本地模型的用户。 厂商声明 想训练或微调模型的人,按供应商的说法,这是该项目的主要用途(这里没有测试)。 可能不适合 测试者观点 想在开着其他应用的 24 GB Mac 上本地生成图片的人。对测试者来说,这行不通。 测试者观点 想不了解模型、内存和训练就快速得到结果的人。 复测。 测试者打算三到六个月后再看(大约 2027 年 1 月到 4 月)。在此之前,请先记录桌面应用版本、macOS 版本和芯片型号;从全新安装开始;关闭其他应用并记下空闲内存;试一个能放得下的图像模型(例如 7.8 GB 的 GGUF),并记录每项设置和结果;测试训练、离线使用和卸载。
对待客户最糟糕的方式,就是把活干了却不告诉客户进展。
测试者笔记,由语音转写稍作整理。 常见问题 Unsloth 能在 24 GB 的 Mac 上生成图片吗? 这次测试中不能。加载图像模型 flux.2-klein 被拒绝了两次:一开始需要约 17 GB,可用约 2 GB(空闲 7 GB),重启后可用约 6 GB(空闲 11 GB)。没有生成图片。 已测量
Unsloth 能找到我已经在 LM Studio 或 Ollama 里的模型吗? 在这次测试中可以。第一次聊天直接从 LM Studio 的模型文件夹加载了一个 Qwen3.8-27B 4-bit 模型,没有下载;On Device 列表还显示了 gemma4:latest 和 qwen3-coder:30b 等 Ollama 模型。有些 Ollama 模型不能用,具体是哪些没有记录。 已观察
Unsloth 在 24 GB 的 Mac 上聊天有多快? 一个 27B 4-bit 模型在 10 秒内以 11.0 tokens/秒回答了'what is 5 times 866'(4,330,正确)。在开着其他应用的情况下,用同一个模型读取网页和做活动搜索都以'Ran out of memory'结束。 已测量
Unsloth 的安装包有多大,安装要多久? DMG 为 24 MB。首次启动运行了一个 13 步的依赖更新,测试者估计需要四到五分钟;窗口没有显示时间或磁盘估算。测试是从已有的安装开始的,不是全新安装。 已观察
Unsloth 可以完全离线使用吗? 供应商的文档说可以 100% 离线、在本地使用。离线使用没有测试;网页搜索和模型下载用到了互联网。 厂商声明
开发方背景 不属于上手测试过程。以下内容来自供应商的 GitHub 页面、文档和发布页面,以及 PromptQuorum 目录,由一个会概述页面的网页抓取工具于 2026 年 10 月 16 日读取,未经独立验证。
厂商声明 GitHub 页面把 Unsloth 描述为'first desktop app to run and train models'和'Local UI to run and train LLMs and diffusion models'。它提供 Unsloth Studio(网页界面)和 Unsloth Core(代码)。已读的页面没有写明公司或个人名称。 厂商声明 许可证:核心包为 Apache 2.0;'certain optional components, such as the Unsloth Studio UI'为 AGPL-3.0。 厂商声明 平台:Windows、Linux、WSL 和 macOS。安装方式:桌面应用(macOS 上为 .dmg)、shell 脚本、Homebrew 和 Docker。返回的文本中没有写明硬件要求。 厂商声明 Studio 文档:在本地运行 GGUF、MLX 以及扩散式图像和视频模型;macOS 上'Training, MLX and GGUF inference all work inside of Unsloth';网页搜索'visits pages directly';'can be used 100% offline'。 第三方 PromptQuorum 目录把 Unsloth 列为免费、Apache-2.0,支持 Mac、Windows 和 Linux,类别为微调与 LoRA,GitHub 星标约 76,100(数据于 2026 年 9 月 13 日核实)。目录记录了 v0.1.905-beta 版本中的 macOS DMG(2026 年 10 月 9 日查阅)以及 2026 年 10 月 16 日的最近一次上游更新。在这份报告之前,PromptQuorum 没有对它做过上手测试。 假设 2026 年 10 月 16 日读取的发布页面返回的最新版本是 v0.1.806-beta(9 月 2 日),与目录中的 v0.1.905-beta 不一致;可能是概述页面的工具读到了过期页面。安装日志里的 Python 包版本(2026.10.3)与桌面应用的标签使用的是不同的编号。 如何理解标签
已观察 在应用、截图或测试者笔记中亲眼所见。
已测量 从对话框、计数器或工具中读取的数值,并给出了该数字。
测试者估计 测试者自己的估计;未计时或计数。
厂商声明 由应用、其商店页面或其网站所述;未经核实。
第三方 来自其他来源(AI 助手、文章);此处未核实。
假设 一种推断,可能有误。
测试者观点 测试者的判断或看法。
测试者失误 测试者出错或遗漏之处。 资料来源 测试者的上手笔记,2026 年 10 月 9 日(原始 Word 文档'20261009_Unslothh';原始笔记 PDF 待补充)。 Unsloth 的 GitHub 项目(github.com/unslothai/unsloth)、其发布页面和 Unsloth Studio 文档页面(unsloth.ai/docs/new/studio),2026 年 10 月 16 日查阅。 PromptQuorum 目录中的 Unsloth 条目(slug:unsloth),数据于 2026 年 9 月 13 日核实。 测试编号 pq-test-unsloth-2026-10-09 · 测试标准 v0.1 · 原始笔记 PDF:待补充
我如何测试应用——以及为什么没有固定标准 — 这些测试是我的个人观点,并非保证。