Test pratique PromptQuorum · Unsloth · 9 octobre 2026
Unsloth sur un Mac de 24 GB : une application soignée, mais mémoire saturée avant la première image
Test pratique sur un Mac de 24 GB, centré sur la génération d'images. Le chat a fonctionné ; les modèles d'image ont été refusés faute de mémoire, et aucune image n'a été produite.
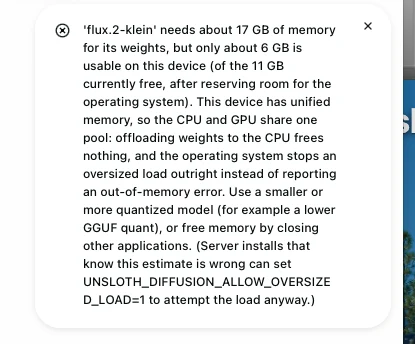
Figure 1Refus de charger le modèle d'image flux.2-klein. L'application indique environ 17 GB nécessaires, environ 2 GB utilisables (7 GB actuellement libres, moins l'espace réservé au système d'exploitation). Elle nomme une variable de contournement, UNSLOTH_DIFFUSION_ALLOW_OVERSIZED_LOAD=1, qui n'a pas été essayée.
Verdict
Appréciation générale
L'application paraît soignée : un installateur de 24 MB, une fenêtre de configuration qui montre ce qu'elle fait, un hub de modèles avec relevé du matériel, avertissements de taille et minuteur de téléchargement, et un chat qui retrouve les modèles déjà présents sur le disque via LM Studio et Ollama. Un calcul a tourné à 11,0 tokens par seconde sur un modèle de 27B. L'objectif du test, une image, n'a pas été atteint. Les modèles d'image ont été refusés parce que l'application ne comptait que 2 GB (avant un redémarrage) puis 6 GB (après) d'utilisables pour environ 17 GB nécessaires ; une recherche web et une recherche d'événements ont fini sur 'Ran out of memory' ; et le démarrage d'un modèle n'a affiché aucune progression pendant des minutes. Le testeur a réalisé les premiers essais avec de nombreuses autres applications ouvertes et n'a pas consigné les modèles ni les réglages de certains essais.
Adéquation à l’usage du testeur
Pas pour ce testeur sur cette machine, pour l'instant. Selon ses mots : 'Everything works, except that the end result is I didn't get it to work.' Le chat et la gestion des modèles fonctionnent avec 24 GB ; la génération d'images n'a pas fonctionné dans ce test. L'entraînement n'a pas été essayé. Le testeur compte y revenir dans trois à six mois.
ObservéLe chat fonctionne : un modèle de 27B en 4 bits, pris dans le dossier de LM Studio, a répondu à un calcul à 11,0 tokens par seconde. Les modèles d'Ollama et de LM Studio apparaissent dans l'application.
MesuréLes modèles d'image ont été refusés : flux.2-klein demande environ 17 GB ; l'application comptait environ 2 GB d'utilisables (7 GB libres) puis, après un redémarrage, environ 6 GB (11 GB libres). Aucune image n'a été produite.
Avis du testeurUne interface magnifique où tout fonctionne, mais le résultat final n'a pas été atteint sur un Mac de 24 GB.
Grille de scores Statut : Partiel
Installation4/5DMG de 24 MB ; fenêtre de configuration avec journal détaillé. Aucune estimation de durée ni d'espace disque ; quatre à cinq minutes (estimation du testeur). Le test est parti d'une installation existante.
Prise en main et choix du modèle3/5Le sélecteur, le hub, le relevé du matériel, les avertissements de taille et le minuteur de téléchargement sont des points forts. Le sélecteur affiche des nombres de paramètres, pas des gigaoctets ; les messages '7 GB' et '17 GB' ont dérouté le testeur.
Fonction principale2/5Le chat a répondu à un calcul. La lecture d'une page web et une recherche d'événements se sont terminées par des erreurs de mémoire ; aucune image n'a été produite.
Guidage et itération3/5Le message de refus explique la cause et nomme un contournement. Aucune progression pendant le démarrage d'un modèle ; aucune explication de la raison pour laquelle 7 GB étaient 'libres'.
Performances2/511,0 tok/s sur un modèle de 27B en 4 bits ; mémoire saturée à 34,4k de contexte sur un Mac de 24 GB, avec d'autres applications ouvertes.
Documentationn/dNon testée.
Confiance et confidentialitén/dNon audité. L'éditeur revendique un usage 100 % hors ligne ; la recherche web et les téléchargements nécessitent Internet. Le fonctionnement hors ligne n'a pas été testé.
Désinstallationn/dNon testée.
Les scores sont des propositions tirées des éléments de preuve ci-dessous (1 = médiocre, 5 = très bon). Il revient au testeur de les confirmer. La génération d'images, objectif du testeur, obtient un score bas car aucune image n'a été produite sur cette machine.
Détails du test
Application
Unsloth, l'application de bureau (Unsloth Studio). Les notes l'écrivent 'Unsloth', 'Unslothh' et 'Onslaught' ; ce rapport utilise 'Unsloth'. Observé
Version
Journal d'installation : 'unsloth 2026.8.18 -> 2026.10.3 available, updating'. La version utilisée après la mise à jour est supposée être 2026.10.3. La fenêtre porte la mention BETA. La version propre de l'application de bureau n'est pas consignée. Hypothèse
Testeur
Hans Kuepper, fondateur de PromptQuorum
Début
9 octobre 2026, 13 h (d'après les notes). Une capture d'écran affiche 17 h 13 ; le test a donc duré au moins quatre heures. Observé
Fin
Non consigné
Matériel
Mac de 24 GB. Les notes disent 'macOS M3 24 GB', puis 'M3 24 GB Pro MacBook'. Le Model hub de l'application affiche '24 GiB RAM', '0 GiB VRAM + 24 GiB shared' et '12/12 CPU'. La puce exacte n'est pas consignée. Observé
Système
macOS ; version non consignée
État de l'installation
Pas une installation propre. Le journal d'installation indique 'Updating existing Unsloth install' et 'existing install detected' ; le testeur dit 'same as before'. Un usage antérieur peut expliquer que les modèles de LM Studio et d'Ollama étaient déjà connus. Observé
Téléchargement
DMG de 24 MB (tel que lu par le testeur). Une étape de dépendances s'est exécutée au premier démarrage (voir le chapitre 1). Observé
Pourquoi ce test
Voir comment fonctionne Unsloth, 'especially the picture functions'. Le testeur ne prévoyait pas d'utiliser l'optimisation de modèles (entraînement).
Objectif
Générer des images en local sur le Mac de 24 GB. Le chat et le hub de modèles ont été essayés en chemin. Observé
Assistance IA utilisée
Les notes contiennent un prompt de plusieurs centaines de mots sur l'horizon de New York ; ses marques de gras Markdown suggèrent qu'il a été rédigé par une IA. Non confirmé. Les réponses du modèle de chat (par exemple sur l'origine du modèle) n'ont pas été prises comme référence ici. Hypothèse
Chaque affirmation porte une étiquette :ObservéMesuréEstim. testeurAnnonce éditeurSource tierceHypothèseAvis du testeurErreur testeurSignification des étiquettes
Déclaration d’intérêts. Le testeur a fondé PromptQuorum (promptquorum.com), un site de contenus et un annuaire consacrés aux applications d'IA locale. Unsloth figure dans cet annuaire et dispose sur le site d'une page d'avis distincte, rédigée auparavant. Les notes ne consignent aucun contact avec l'éditeur, aucun paiement et aucun parrainage.
Tout fonctionne, sauf que le résultat final, c'est que je n'ai pas réussi à le faire marcher.
Notes du testeur, légèrement retouchées à partir d’une transcription vocale.
Déroulement du test
Téléchargement, configuration et premier démarrage
Observé
L'installateur est un DMG de 24 MB, que le testeur décrit comme 'the smallest file I've ever seen'.
Observé
Première fenêtre : 'Getting things ready... This won't take long.' avec un lien 'Show setup details'. Le testeur : 'Already feels much more polished than the other apps... a clear communication.'
Figure 2Première fenêtre après l'ouverture de l'application DMG de 24 MB. Le texte dit que ce ne sera pas long ; le testeur n'a rien chronométré et estime quatre à cinq minutes (le journal de mise à jour figure dans le texte). Aucune estimation de durée ni d'espace disque n'est affichée.
Observé
Le journal détaillé indique : 'Updating existing Unsloth install', 'frontend bundled (Tauri)', 'node v24.13.0 | npm 11.6.2 (system)', 'unsloth 2026.8.18 -> 2026.10.3 available, updating', puis une barre de dépendances en 13 étapes (amorçage de pip, pile MLX pour Apple Silicon, paquets de base, extras d'unsloth, codecs, remplacements, dépendances de Studio, data designer, plugin local, version figée de diffusers, finalisation). Notes : 'torch 2.10.0 detected -- installing torchao==0.16.0' ; 'transformers 5.3.0, 5.5.0, 5.10.2 pre-installed' ; 'gpu Apple Silicon (Metal, unified memory)' ; 'installing prebuilt llama.cpp'.
Observé
Le testeur dit que cela a duré environ quatre ou cinq minutes, puis l'application s'est ouverte. Le journal n'affiche aucune estimation de durée ni d'espace disque.
Estim. testeur
Quatre à cinq minutes pour la configuration. Non chronométré.
Hypothèse
Le petit DMG télécharge probablement l'essentiel du logiciel pendant cette première étape. Non vérifié.
Avis du testeur
'It gives me the details about what it does -- great -- but it doesn't tell me anything about estimated time, volumes, how much disk space it takes up.'
Observé
La fenêtre principale s'ouvre sur 'How can I help?' avec une barre latérale : New chat, Model hub, Library, Images, Train, More. Le logo porte la mention BETA.
Figure 3Fenêtre principale après la configuration. Barre latérale : New chat, Model hub, Library, Images, Train, More. Le logo porte la mention BETA. Un onglet de navigateur derrière la fenêtre montre une page GitHub du projet.
Erreur testeur
Parti d'une installation existante ('same as before') : il s'agit donc d'une mise à jour, pas d'un test de premier lancement. Les conclusions sur la prise en main demandent une installation propre pour être confirmées.
Sélecteur de modèles et premier chat
Observé
Le sélecteur de modèles liste des modèles Recommended avec des chiffres comme 27.3B et 271.0M. Ce sont des nombres de paramètres, pas des gigaoctets. Deux entrées sont grisées (176.9B et 320.8B).
Figure 4Sélecteur de modèles, onglet Recommended. Les chiffres sont des nombres de paramètres (B = milliards, M = millions), pas des gigaoctets. Deux entrées sont grisées (Qwen3.8-Flash-Next-GGUF 176.9B, GLM-5.3-Flash-GGUF 320.8B). Ce que signifient le gris et le point jaune n'est pas indiqué dans la vue capturée.
Hypothèse
Les entrées grisées sont probablement trop grandes pour cette machine. La vue de l'application capturée ne le dit pas.
Avis du testeur
'There were lots of models listed with the size. Very good.' Les nombres affichés sont des nombres de paramètres : ils n'indiquent donc pas au lecteur la mémoire dont un modèle a besoin.
Observé
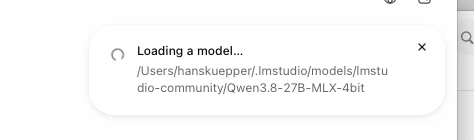
Au lieu de choisir un modèle, le testeur a tapé une demande de calcul. L'application a commencé à charger des modèles d'elle-même. Un modèle Qwen3.8-27B MLX 4 bits a démarré en moins d'une minute, selon les notes ; une seconde notification montrait le chargement de Mistral-7B-Instruct-v0.3-4bit (capture non reprise, même type que la figure 5).
Observé
La notification de chargement affiche le chemin /Users/hanskuepper/.lmstudio/models/lmstudio-community/Qwen3.8-27B-MLX-4bit. Le modèle a été lu depuis le dossier de LM Studio sur le disque.
Figure 5Notification affichée au démarrage du premier chat. Le chemin pointe dans le dossier de modèles de LM Studio : /Users/hanskuepper/.lmstudio/models/lmstudio-community/Qwen3.8-27B-MLX-4bit. Le modèle a été chargé depuis le disque, pas téléchargé.
Avis du testeur
Il soupçonnait qu'il venait du disque dur, car 'that's a big model that doesn't go over the internet in one minute'. Le chemin le confirme. Pourquoi Unsloth a choisi ce modèle et celui de Mistral n'est pas consigné.
Observé
La question 'what is 5 times 866' a reçu la réponse '5 x 866 = 4,330' (correcte), après 'Worked for 10s', à 11,0 tok/s. L'en-tête affiche 'Local' et un compteur de contexte '120 / 262.1k'.
Figure 6Premier chat. La réponse 4,330 est correcte (5 x 866). L'écran affiche 'Worked for 10s', 11.0 tok/s et un compteur de contexte '120 / 262.1k'.
Observé
Le testeur a ensuite demandé au modèle d'où il tenait le modèle. La partie capturée de la réponse parle de poids MLX et de mémoire unifiée d'Apple Silicon ; la réponse complète n'est pas capturée. Selon les notes, la réponse était que l'application ne cherche pas sur le disque.
Hypothèse
Le récit que fait le modèle de chat de l'application n'est pas une preuve fiable. Une réponse l'appelle 'Qwen 3 27B MLX 4-bit', alors que l'application le nomme Qwen3.8-27B-MLX-4bit.
Modèles déjà sur le disque : LM Studio et Ollama
Observé
L'onglet On Device liste les modèles par source. Sous CUSTOM FOLDERS apparaissent deux chemins (.lmstudio/models et .ollama/models) avec les modèles Ollama gemma4:latest, gemma3:1b et qwen3-coder:30b. Sous LM STUDIO, le modèle Qwen3.8-27B est marqué 'Loaded'.
Figure 7Onglet On Device. Sous CUSTOM FOLDERS, deux chemins sont listés (.lmstudio/models et .ollama/models) avec les modèles Ollama gemma4:latest, gemma3:1b et qwen3-coder:30b ; sous LM STUDIO, le modèle Qwen3.8-27B est marqué 'Loaded'. Une réponse de chat en partie visible derrière la liste parle de poids MLX. Que les dossiers aient été ajoutés par le testeur ou trouvés automatiquement n'est pas consigné.
Hypothèse
Soit le testeur a ajouté les deux dossiers, soit l'application les a trouvés seule. Non consigné. Un usage antérieur de l'application a pu les configurer.
Observé
Le passage à qwen3-coder:30b (30.5B, Q4_K_M, GGUF) affiche 'Starting model... Switching models. Loading cached model into memory.' avec un bouton Cancel. Le compteur de contexte indique '1.3k / 8.2k', bien moins que les 262.1k du premier modèle.
Figure 8Passage au modèle Ollama qwen3-coder:30b (30.5B, Q4_K_M, GGUF). Compteur de contexte '1.3k / 8.2k'. La notification indique 'Starting model... Switching models. Loading cached model into memory.' avec un bouton Cancel.
Avis du testeur
'I like how easy to change models.' 'Some Ollama models do not work inside Unsloth, but great that it tried at least.'
Observé
Selon les notes, un modèle plus ancien a fonctionné et un plus récent a planté. Les modèles concernés ne sont pas consignés.
Avis du testeur
Il juge 'great that it tried' d'utiliser ses modèles Ollama, et lire les modèles déjà présents sur le disque évite un nouveau gros téléchargement.
Hub de modèles et téléchargements
Observé
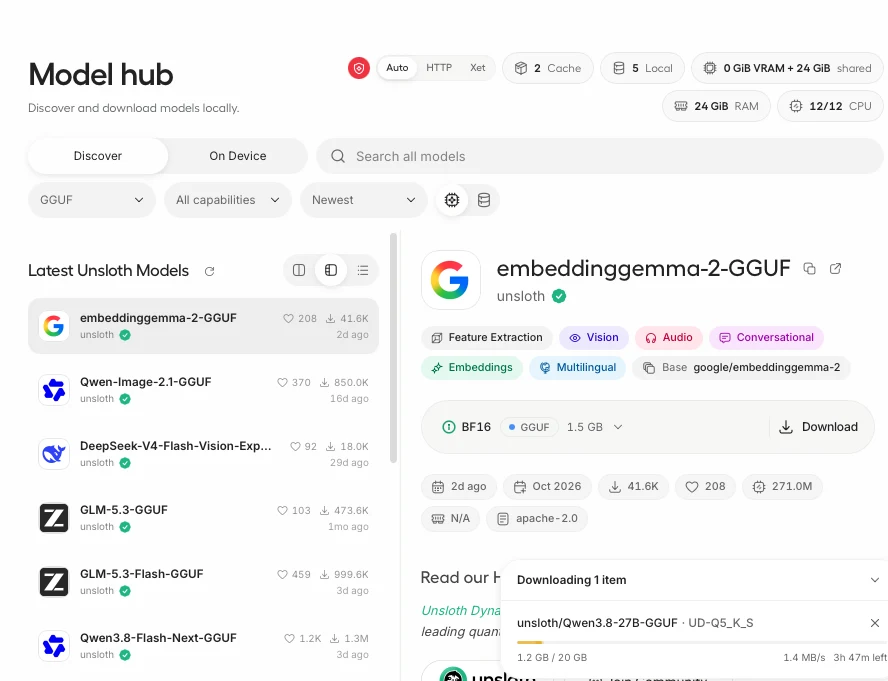
Le hub affiche l'appareil : '0 GiB VRAM + 24 GiB shared', '24 GiB RAM', '12/12 CPU', ainsi que des filtres (format, capacités, nouveautés). Les cartes montrent les mentions j'aime, les téléchargements, l'ancienneté et la licence (embeddinggemma-2-GGUF : apache-2.0, 1,5 GB).
Figure 9Model hub. En haut à droite : '0 GiB VRAM + 24 GiB shared', '24 GiB RAM', '12/12 CPU'. Panneau de téléchargement : unsloth/Qwen3.8-27B-GGUF UD-Q5_K_S, 1.2 GB sur 20 GB, 1.4 MB/s, 3 h 47 m restantes. La carte de modèle ouverte, embeddinggemma-2-GGUF (1,5 GB, apache-2.0), n'est pas le modèle en cours de téléchargement.
Avis du testeur
'Yes, great model hub.' Le hub liste notamment Qwen-Image-2.1-GGUF (850.0K téléchargements, 16 jours), GLM-5.3-GGUF et Qwen3.8-Flash-Next-GGUF.
Observé
Selon les notes, cliquer sur un fichier trop gros pour le Mac a produit plusieurs avertissements ('this file is 30 to 40 gigabytes total') ; le téléchargement reste autorisé. Pas de capture d'écran.
Mesuré
Le panneau de téléchargement d'unsloth/Qwen3.8-27B-GGUF UD-Q5_K_S indique 1.2 GB sur 20 GB à 1.4 MB/s, 3 h 47 m restantes ; plus tard 7.1 GB sur 20 GB à 983 KB/s, 3 h 31 m restantes.
Figure 10Même téléchargement plus tard : 7.1 GB sur 20 GB à 983 KB/s avec 3 h 31 m restantes. Le temps écoulé entre cette capture et la précédente n'est pas consigné.
Avis du testeur
'The professionalism of this app is visible. It has a timer attached. It tells you the download speed.'
Hypothèse
Les vitesses suggèrent une connexion lente sur le lieu du test ; le testeur ne le dit pas. Le téléchargement est-il allé à son terme ? Non consigné.
Mesuré
La boîte de dialogue de Z-Image (BF16) liste des fichiers de modèle de 12,3 GB plus un encodeur et un décodeur requis de 8,2 GB, soit 20,5 GB au total. Cela explique la 'difference between the gigabytes that the model has and then something else' que le testeur mentionne ailleurs.
Figure 19Boîte de dialogue de téléchargement de Z-Image (BF16) : fichiers de modèle 12.3 GB, 'Include required files' 8.2 GB (encodeur et décodeur, partagés entre variantes compatibles), total 20.5 GB. 'Downloading will not load this model or switch your current model.'
Avis du testeur
Les notes disent 'the picture LLM was downloaded'. Lequel ? Non consigné ; les captures montrent sur l'appareil les modèles d'image FLUX.2-klein-4B et sa variante GGUF (figure 18).
Recherche web, voix et plantages
Observé
Le testeur a collé l'URL d'une page de PromptQuorum et demandé 'from a seo perspective will this help me?'. Le chat affiche 'Using tool: Reading promptquorum.com' et 'Waiting for approval: web_search' avec les boutons Allow, Always allow et Deny. Horodatage 17 h 13 ; contexte '648 / 34.4k'.
Figure 11Chat avec Qwen3.8-27B-MLX-4bit, contexte '648 / 34.4k', horodatage 17 h 13. Le prompt donne une URL de PromptQuorum et pose une question sur le SEO. L'application affiche 'Waiting for approval: web_search' et les boutons Allow, Always allow, Deny. Le mode est 'Approve for me'.
Observé
Selon les notes, le premier essai a dit qu'il ne pouvait pas lire la page ; après un clic sur la fonction Search, cela a marché au second essai. 'Maybe the first time should have had a warning.'
Hypothèse
Le premier échec vient peut-être de l'approbation de la recherche web manquante ou de l'interrupteur Search désactivé. Non vérifié.
Observé
L'exécution s'est terminée par 'Ran out of memory. Try a smaller model or shorter input.' après 168,10 s, avec un bouton Retry.
Figure 12Le même chat se termine par 'Ran out of memory. Try a smaller model or shorter input.' après 168,10 s.
Observé
La saisie vocale est intégrée. Son utilisation demande de télécharger le modèle vocal 'Qwen3-ASR 0.6B', environ 1,0 GB, qui sera récupéré une seule fois dans le cache Hugging Face, indique l'application. Le testeur l'a-t-il téléchargé ? Non consigné.
Figure 13Saisie vocale : 'Local dictation runs entirely offline, but it needs the Qwen3-ASR 0.6B speech model first. About 1.0 GB, fetched once into your Hugging Face cache.' Le testeur l'a-t-il téléchargé ? Non consigné.
Observé
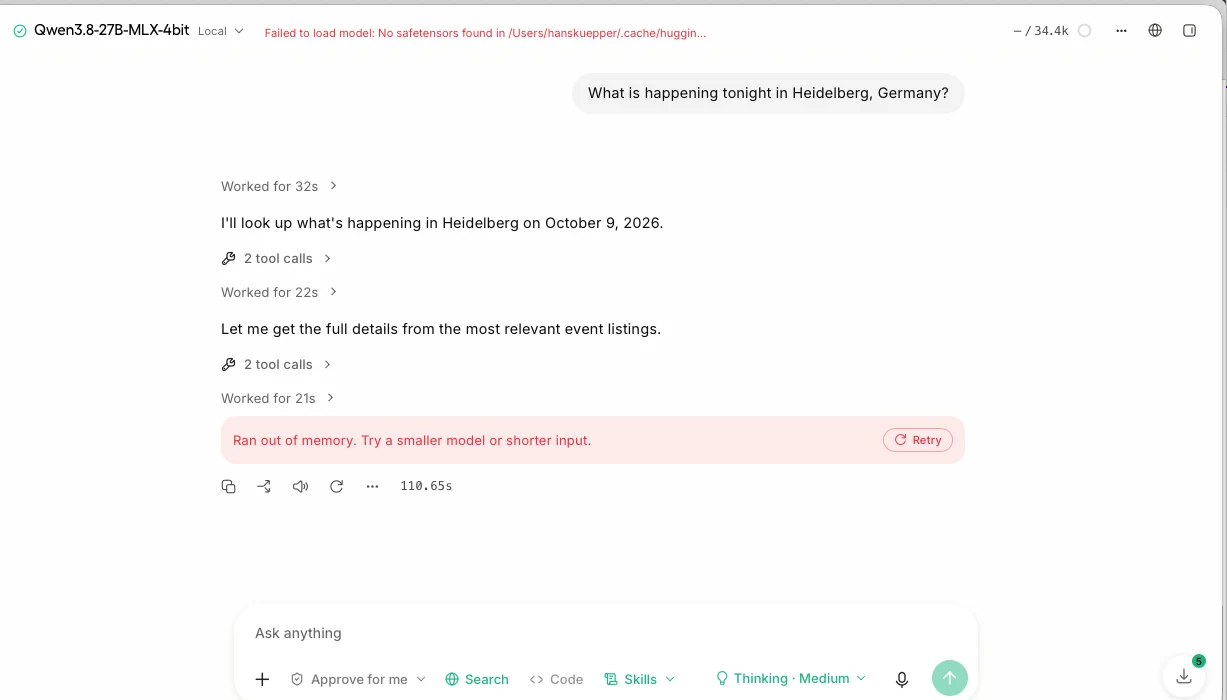
Une recherche locale d'événements ('What is happening tonight in Heidelberg, Germany?') a effectué deux séries d'appels d'outils et s'est terminée par 'Ran out of memory' après 110,65 s. L'en-tête affiche une note rouge : 'Failed to load model: No safetensors found in /Users/.../.cache/huggin...'.
Figure 14Recherche locale d'événements. En-tête (rouge) : 'Failed to load model: No safetensors found in /Users/.../.cache/huggin...'. Dans le chat, deux séries d'appels d'outils, puis 'Ran out of memory. Try a smaller model or shorter input.' après 110,65 s. Contexte '- / 34.4k'. Le badge de téléchargement affiche 5.
Hypothèse
L'erreur de chargement et le message de mémoire saturée sont peut-être liés (un modèle remplacé alors que la mémoire manquait). La capture n'établit aucun lien.
Avis du testeur
'But yes, local AI, always some issues.'
Modèles d'image : refusés pour cause de mémoire
Observé
L'objectif du testeur était les images. La barre latérale comporte une entrée 'Images'. Les notes contiennent un long prompt sur l'horizon de New York (vue de Brooklyn, pont de Brooklyn, heure dorée, détail 8K) avec des listes de composition et d'éléments à éviter. Aucun résultat, erreur ni réglage n'est consigné.
Mesuré
Le chargement du modèle d'image flux.2-klein a été refusé : 'needs about 17 GB of memory for its weights, but only about 2 GB is usable on this device (of the 7 GB currently free, after reserving room for the operating system)'. Le message ajoute que le Mac a un seul pool de mémoire, que le déchargement sur le CPU ne libère rien, et suggère un modèle plus petit, une quantification plus basse ou la fermeture d'autres applications. Il nomme UNSLOTH_DIFFUSION_ALLOW_OVERSIZED_LOAD=1 comme contournement.
Figure 1Refus de charger le modèle d'image flux.2-klein. L'application indique environ 17 GB nécessaires, environ 2 GB utilisables (7 GB actuellement libres, moins l'espace réservé au système d'exploitation). Elle nomme une variable de contournement, UNSLOTH_DIFFUSION_ALLOW_OVERSIZED_LOAD=1, qui n'a pas été essayée.
Mesuré
Après un redémarrage propre, le message indique : environ 17 GB nécessaires, environ 6 GB utilisables, sur 11 GB actuellement libres.
Figure 15Second refus de flux.2-klein : environ 17 GB nécessaires, environ 6 GB utilisables (11 GB actuellement libres). Lu ici comme pris après le redémarrage propre, d'après l'ordre des notes.
Hypothèse
Les deux messages diffèrent de 5 GB dans les deux paires (7 - 2 et 11 - 6) : l'application semble donc réserver environ 5 GB pour le système d'exploitation. Deux points de données seulement.
Observé
La liste de l'appareil affiche FLUX.2-klein-4B-GGUF (7,8 GB), FLUX.2-klein-4B (16 GB) et mistral-7b-v0.3-bnb-4bit (4,1 GB). Le testeur : 'This should be small enough.' Il dit que le plus petit modèle d'image du hub fait planter sa machine de 24 GB, et que les modèles sur lesquels il a cliqué disaient tous être trop gros parce que seuls 'seven gigabytes' étaient disponibles.
Le testeur se demande pourquoi seuls sept gigaoctets sont disponibles ('I have much more'). La boîte de dialogue indique que 7 GB étaient libres à ce moment-là et que les autres applications tournaient ; après le redémarrage, elle indique 11 GB. Les notes placent la remarque sur les '7 GB' à côté de la boîte de dialogue de Z-Image ; le chiffre de 7 GB figure dans le message de flux.2-klein.
Avis du testeur
'I'm lost... I have a 24-gigabyte machine and I cannot find an LLM that can serve me and can do the job.' Il pense que 24 GB représentent plus de 80 % de ce qu'ont ses lecteurs (son estimation, pas un chiffre mesuré).
Estim. testeur
'More than 80% of my readers' ont 24 GB ou moins. Source non indiquée.
La mémoire sur le Mac
Observé
Le testeur conclut que les modèles locaux et le travail quotidien se disputent la même mémoire, et que Chrome et d'autres applications prennent 5 à 8 GB. Il a écrit 'VRAM' partout ; Apple Silicon n'a qu'un seul pool de mémoire, comme le dit le hub ('0 GiB VRAM + 24 GiB shared').
Mesuré
Moniteur d'activité, une capture : mémoire utilisée 12,92 GB, fichiers en cache 10,95 GB, mémoire des apps 9,81 GB, mémoire résidente 1,83 GB, swap 0.
Figure 16Panneau de mémoire avec un long historique plat. Mémoire utilisée 12,92 GB, fichiers en cache 10,95 GB, mémoire des apps 9,81 GB, mémoire résidente 1,83 GB, swap utilisé 0 octet. Le moment de la capture et les applications ouvertes ne sont pas consignés.
Mesuré
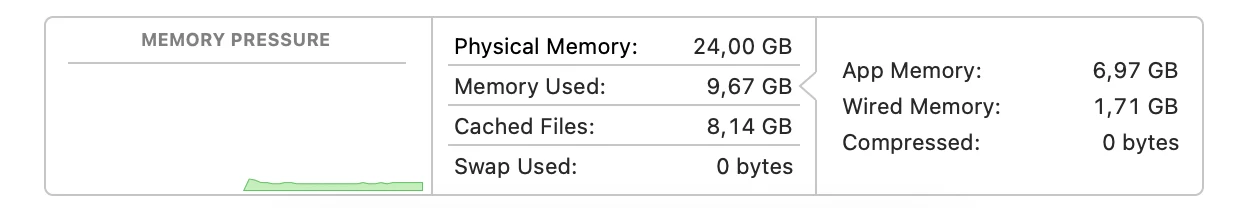
Moniteur d'activité, une autre capture : mémoire utilisée 9,67 GB, fichiers en cache 8,14 GB, mémoire des apps 6,97 GB, mémoire résidente 1,71 GB, swap 0. Le court historique correspond à un démarrage récent.
Figure 17Panneau de mémoire avec un court historique qui commence tard dans le graphique. Mémoire utilisée 9,67 GB, fichiers en cache 8,14 GB, mémoire des apps 6,97 GB, mémoire résidente 1,71 GB, swap 0. Correspond à la remarque '10 GB at startup' des notes ; le moment montré n'est pas consigné.
Hypothèse
Les 11 GB 'currently free' de la figure 15 sont cohérents avec 24,00 - 12,92 = 11,08 GB de la figure 16. Que les deux aient été prises au même moment n'est pas consigné.
Avis du testeur
'Even after reboot, already nine gigabytes gone for general things.' 'Either I shut the computer down, reboot, stop all the processes... or I cannot run the LLM.'
Avis du testeur
Deux réponses possibles : les modèles doivent devenir plus petits et meilleurs, ou les ordinateurs ont besoin de 48 ou 64 GB. 'All of this talk about this works on your computer is a little bit fake.'
Hypothèse
Qu'avec 48 ou 64 GB le problème serait résolu 'confidently' n'a pas été testé.
Chargement sans retour, et avis final
Observé
Le démarrage d'un modèle affiche une notification 'Starting model... Loading cached model into memory.' avec une roue de chargement et Cancel. Aucun pourcentage, aucune taille, aucune durée.
Figure 20Démarrage d'un modèle. La notification montre une roue de chargement et 'Loading cached model into memory.' Aucun pourcentage, aucune taille, aucune durée. Le testeur dit que cela a duré plus de deux ou trois minutes (estimation).
Estim. testeur
L'attente a duré plus de deux ou trois minutes (non chronométré).
Avis du testeur
'The worst way you can treat a client is to do the work and not update the client.' Le testeur y voit un problème d'interface utilisateur.
Observé
Les compteurs de l'en-tête montrent les tokens utilisés par rapport au contexte (par exemple '648 / 34.4k') et les tokens par seconde (11,0 tok/s).
Erreur testeur
Les notes disent 'no token counter'. Les captures montrent un compteur de contexte et un chiffre de tokens par seconde. Il voulait peut-être parler d'un décompte de tokens par message (hypothèse).
Erreur testeur
Les notes qualifient un modèle de chat local de 'the most stupid idea' parce qu'il 'does not research the internet'. Les mêmes notes et captures montrent une fonction Search, une demande d'approbation de recherche web et des appels d'outils lisant une page.
Avis du testeur
Il ne veut pas entraîner de modèles ; la fonction de chat lui sert peu ; il veut un outil d'image et de vidéo et 'is not seeing it yet'. L'entraînement et l'onglet 'Train' n'ont pas été essayés.
Avis du testeur
'Maybe it's on my side, but no, not for me. I'll check again in three or six months, but currently not on a M3 24 GB Pro MacBook.'
Affirmations et observations du testeur
Affirmation
Source
Observé
Étiquette
'Run and train image and video diffusion or multimodal models', en local (README GitHub ; page de documentation)
Éditeur, lu le 16 oct. 2026
Aucune image n'a été produite. flux.2-klein a été refusé (environ 17 GB nécessaires ; 2 GB puis 6 GB utilisables). Il n'est pas montré que de plus petites variantes d'image se chargent. Entraînement non essayé.
Observé
'Training, MLX and GGUF inference all work inside of Unsloth' sur macOS (documentation)
Éditeur, lu le 16 oct. 2026
Un modèle MLX (Qwen3.8-27B 4 bits) et un modèle GGUF (qwen3-coder:30b) se sont chargés et ont répondu. Entraînement non essayé.
Observé
'Can be used 100% offline and locally on your computer' (documentation)
Éditeur, lu le 16 oct. 2026
La recherche web et les téléchargements ont utilisé Internet. L'usage hors ligne n'a pas été testé.
Observé
La recherche web 'visits pages directly' (documentation)
Éditeur, lu le 16 oct. 2026
La lecture d'une page a été tentée ; selon les notes, le premier essai a échoué et le second a lu la page. L'exécution a ensuite manqué de mémoire.
Observé
L'application de bureau est 'free and open source' (notes de version)
Éditeur, lu le 16 oct. 2026
Aucune demande de paiement n'apparaît dans les notes ni sur les captures.
Observé
Matériel affiché dans le hub
Application
Le hub affichait 24 GiB RAM, 0 GiB VRAM + 24 GiB shared et 12/12 CPU. Le chiffre de RAM correspond aux 24,00 GB du Mac.
Mesuré
'No hardware requirements stated' (pages lues)
Éditeur, lu le 16 oct. 2026
Ni la page GitHub ni la page de documentation n'indiquaient de mémoire requise dans le texte renvoyé. L'application indique elle-même son besoin au moment du chargement (17 GB pour flux.2-klein).
Observé
Tient-il dans 24 GB ?
24 GB de mémoire
Poids de flux.2-klein, d'après le message de refusenviron 17 GB nécessaires en dessous de 24 GBMesuré
FLUX.2-klein-4B (liste de l'appareil)fichier de 16 GB en dessous de 24 GBMesuré
FLUX.2-klein-4B-GGUF (liste de l'appareil)fichier de 7,8 GB en dessous de 24 GBMesuré
Utilisable selon l'application, avant le redémarrageenviron 2 GB sur 7 GB libres en dessous de 24 GBMesuré
Utilisable selon l'application, après le redémarrageenviron 6 GB sur 11 GB libres en dessous de 24 GBMesuré
Mémoire utilisée du Mac, Moniteur d'activité (première capture)12,92 GB utilisés en dessous de 24 GBMesuré
Mémoire utilisée du Mac, Moniteur d'activité (seconde capture)9,67 GB utilisés en dessous de 24 GBMesuré
Z-Image BF16, téléchargement total12,3 GB de modèle + 8,2 GB de fichiers requis (taille du téléchargement) en dessous de 24 GBMesuré
Les lignes 2, 3 et 8 sont des tailles de fichier ou de téléchargement, pas l'usage de mémoire à l'exécution. Les 17 GB sont l'estimation propre de l'application pour flux.2-klein ; la variante de fichier concernée n'est pas consignée. 'Usable' est le chiffre de l'application après réservation d'espace pour le système d'exploitation. Le modèle Qwen3.8-27B MLX 4 bits a tourné dans le chat ; son usage de mémoire n'a pas été relevé.
Journal d’usage
#
Tâche
Modèle
Résultat
Durée
Statut
Figures
1
Ouvrir l'application de 24 MB, mettre à jour, premier démarrage
Unsloth 2026.8.18 -> 2026.10.3 (supposé)
Ouverte après le journal de configuration ; installation existante
Erreur testeurA testé une mise à jour d'une installation existante ('same as before'), pas une installation de premier lancement.
Erreur testeurA réalisé les premiers tests de mémoire avec Chrome, l'application Claude, Word, WhatsApp et d'autres applications ouvertes sur un Mac de 24 GB. Le premier refus affichait 7 GB libres.
Erreur testeurA employé 'VRAM' pour la mémoire partout, alors que l'application indique '0 GiB VRAM + 24 GiB shared'.
Erreur testeurA écrit qu'il n'y a 'no token counter' ; les captures montrent un compteur de contexte et des tokens par seconde.
Erreur testeurA écrit qu'un modèle de chat local 'does not research the internet' ; les captures montrent une fonction Search et des appels d'outils de recherche web.
Erreur testeurA lu les chiffres du sélecteur de modèles comme des tailles ; ce sont des nombres de paramètres.
Erreur testeurA noté que seuls sept gigaoctets étaient disponibles sans dire ce qui était ouvert par ailleurs ; la boîte de dialogue indique que 7 GB étaient libres à ce moment-là.
Erreur testeurA laissé des lacunes dans le relevé : version de l'application de bureau, version de macOS, puce, heure de fin, modèle utilisé pour le prompt de New York et ce qu'il est devenu, modèles Ollama en échec, achèvement ou non du téléchargement de 20 GB, réglages des essais d'image, et désinstallation.
Erreur testeurA écrit l'application 'Onslaught' et 'Unslothh' dans les notes (transcription vocale).
HypothèseLes notes placent la boîte de dialogue de Z-Image à côté de la remarque sur 'only seven gigabytes' ; le chiffre de 7 GB figure dans les messages de flux.2-klein. Les captures ont été associées au texte d'après ce qu'elles montrent, et pas seulement d'après leur ordre.
Registre des constats
ID
Constat
Catégorie
Étiquette
Gravité
Figures
UN-01
Le DMG fait 24 MB, bien plus petit que les autres applications vues par le testeur.
Le premier démarrage lance une installation de dépendances en 13 étapes d'environ quatre à cinq minutes, sans estimation de durée ni d'espace disque. Le journal détaillé est visible.
Le sélecteur de modèles affiche des nombres de paramètres (27.3B, 271.0M), pas la taille de téléchargement ou de mémoire ; certaines entrées sont grisées sans explication dans la capture.
Aucune image n'a été produite sur le Mac de 24 GB ; les plus petits modèles d'image listés (7,8 GB, 16 GB) ont aussi été jugés 'too big' dans les notes.
Le testeur juge l'interface belle et fluide, mais n'a pas obtenu de résultat et ne voit aucune raison d'utiliser l'application maintenant.
Vue d'ensemble
Avis du testeur
Moyenne
-
UN-26
L'annuaire indique la licence Apache-2.0 ; la page GitHub indique que l'interface Studio est sous AGPL-3.0 et le cœur sous Apache-2.0.
Maintenance
Source tierce
Moyenne
-
La gravité mesure l’impact sur un utilisateur novice. Proposée, non mesurée.
À qui il s’adresse
Adéquation probable
HypothèsePersonnes disposant de plus de 24 GB de mémoire, ou d'une machine propre avec peu d'applications ouvertes, qui veulent un chat, un hub de modèles et les modèles locaux de LM Studio et d'Ollama dans une seule application.
Annonce éditeurPersonnes qui veulent entraîner ou affiner des modèles, ce qui est la finalité principale du projet selon l'éditeur (non testé ici).
Mauvaise adéquation probable
Avis du testeurQuiconque veut générer des images en local sur un Mac de 24 GB avec d'autres applications ouvertes. Cela n'a pas fonctionné pour le testeur.
Avis du testeurQuiconque veut un résultat rapide sans se pencher sur les modèles, la mémoire et l'entraînement.
Nouveau test. Le testeur compte vérifier à nouveau dans trois à six mois (environ janvier à avril 2027). D'ici là, consigner la version de l'application de bureau, la version de macOS et la puce ; partir d'une installation propre ; fermer les autres applications et noter la mémoire libre ; essayer un modèle d'image qui tient (par exemple le GGUF de 7,8 GB) en consignant chaque réglage et résultat ; tester l'entraînement, l'usage hors ligne et la désinstallation.
La pire façon de traiter un client, c'est de faire le travail sans le tenir informé.
Notes du testeur, légèrement retouchées à partir d’une transcription vocale.
Questions fréquentes
Unsloth peut-il générer des images sur un Mac de 24 GB ?
Pas dans ce test. Le chargement du modèle d'image flux.2-klein a été refusé deux fois : environ 17 GB nécessaires, environ 2 GB utilisables (7 GB libres) au début, puis environ 6 GB utilisables (11 GB libres) après un redémarrage. Aucune image n'a été produite. Mesuré
Unsloth retrouve-t-il les modèles que j'ai déjà dans LM Studio ou Ollama ?
Oui, dans ce test. Le premier chat a chargé un modèle Qwen3.8-27B 4 bits depuis le dossier de modèles de LM Studio sans téléchargement, et la liste On Device montrait des modèles Ollama comme gemma4:latest et qwen3-coder:30b. Certains modèles Ollama n'ont pas fonctionné ; lesquels n'est pas consigné. Observé
Quelle est la vitesse du chat d'Unsloth sur un Mac de 24 GB ?
Un modèle de 27B en 4 bits a répondu à 'what is 5 times 866' (4,330, correct) en 10 secondes à 11,0 tokens par seconde. La lecture d'une page web et une recherche d'événements avec le même modèle se sont terminées par 'Ran out of memory', avec d'autres applications ouvertes. Mesuré
Quelle est la taille de l'installateur d'Unsloth et combien de temps dure la configuration ?
Le DMG fait 24 MB. Le premier démarrage a exécuté une mise à jour de dépendances en 13 étapes que le testeur estime à quatre à cinq minutes ; la fenêtre n'affiche aucune estimation de durée ni d'espace disque. Le test est parti d'une installation existante, pas d'une installation propre. Observé
Unsloth peut-il s'utiliser entièrement hors ligne ?
La documentation de l'éditeur indique qu'il peut s'utiliser à 100 % hors ligne et en local. L'usage hors ligne n'a pas été testé ; la recherche web et les téléchargements de modèles ont utilisé Internet. Annonce éditeur
Contexte sur le créateur
Hors de la session pratique. Les éléments ci-dessous viennent de la page GitHub de l'éditeur, de sa documentation et de sa page de versions, ainsi que de l'annuaire PromptQuorum. Ils ont été lus le 16 octobre 2026 avec un outil de récupération web qui résume les pages, et n'ont pas été vérifiés de façon indépendante.
Annonce éditeurLa page GitHub décrit Unsloth comme la 'first desktop app to run and train models' et 'Local UI to run and train LLMs and diffusion models'. Elle propose Unsloth Studio (interface web) et Unsloth Core (code). Les pages lues ne nomment ni entreprise ni personne.
Annonce éditeurLicence : paquet principal sous Apache 2.0 ; 'certain optional components, such as the Unsloth Studio UI' sont sous AGPL-3.0.
Annonce éditeurPlateformes : Windows, Linux, WSL et macOS. Options d'installation : application de bureau (un .dmg pour macOS), un script shell, Homebrew et Docker. Les exigences matérielles n'étaient pas indiquées dans le texte renvoyé.
Annonce éditeurDocumentation de Studio : exécute en local des modèles GGUF, MLX et de diffusion d'images et de vidéos ; 'Training, MLX and GGUF inference all work inside of Unsloth' sur macOS ; la recherche web 'visits pages directly' ; 'can be used 100% offline'.
Source tierceL'annuaire PromptQuorum présente Unsloth comme gratuit, Apache-2.0, pour Mac, Windows et Linux, dans la catégorie fine-tuning et LoRA, avec environ 76 100 étoiles GitHub (données vérifiées le 13 sept. 2026). Il consigne un DMG macOS dans la version v0.1.905-beta (vérifiée le 9 oct. 2026) et une dernière mise à jour amont le 16 oct. 2026. PromptQuorum ne l'avait pas testé en pratique avant ce rapport.
HypothèseLa page de versions lue le 16 oct. 2026 renvoyait v0.1.806-beta (2 sept.) comme la plus récente, ce qui diffère de la v0.1.905-beta de l'annuaire ; l'outil de résumé a peut-être lu une page périmée. La version du paquet Python dans le journal de configuration (2026.10.3) suit une autre numérotation que les tags de l'application de bureau.