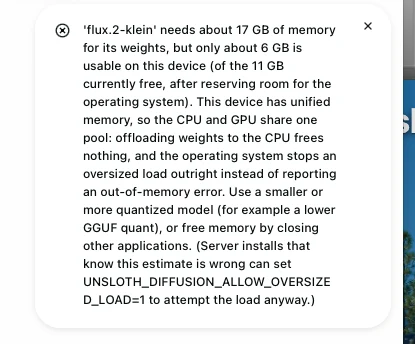
図 1 画像モデルflux.2-kleinの読み込み拒否。アプリは必要約17 GB、使用可能約2 GB(現在の空き7 GBからOS用の余地を差し引いた値)と表示しています。上書き用の変数UNSLOTH_DIFFUSION_ALLOW_OVERSIZED_LOAD=1が示されていますが、試していません。結論 総合評価 アプリは洗練された印象です。24 MBのインストーラー、作業内容を表示するセットアップウィンドウ、ハードウェア表示・サイズ警告・ダウンロードタイマー付きのModel hub、そしてLM StudioとOllamaのモデルがディスク上にあれば見つけてくれるチャット。27Bモデルでの計算は11.0 tokens/秒で動作しました。しかしテストの目標だった画像は達成できませんでした。アプリが使用可能と数えたのは2 GB(再起動前)と6 GB(再起動後)で、必要な約17 GBに届かず、画像モデルは拒否されました。ウェブ検索とイベント検索は'Ran out of memory'で終わり、モデルの起動では数分間進捗が表示されませんでした。テスターは最初のテストを他のアプリを多数開いたまま行い、一部の実行のモデルと設定を記録していません。
テスターの用途への適合度 現時点では、このテスターのこのマシンには不向きです。本人の言葉では'Everything works, except that the end result is I didn't get it to work.'。24 GBでもチャットとモデル管理は動きますが、画像生成はこのテストでは動きませんでした。学習は試していません。テスターは3〜6か月後に再確認する予定です。
観察 チャットは動作します。LM Studioのフォルダにある27Bの4-bitモデルが、計算に11.0 tokens/秒で答えました。OllamaとLM Studioのモデルはアプリに表示されます。 実測 画像モデルは拒否されました。flux.2-kleinには約17 GBが必要ですが、アプリが使用可能と数えたのは約2 GB(空き7 GB)、再起動後は約6 GB(空き11 GB)でした。画像は生成されませんでした。 テスター見解 すべてが動く美しいインターフェースですが、24 GBのMacでは最終的な結果にたどり着けませんでした。 スコアカード ステータス: 一部成功 インストール 4/5 24 MBのDMG。詳細ログ付きのセットアップウィンドウ。時間やディスク容量の見積もりはなし。所要時間は4〜5分(テスター推定)。テストは既存のインストールから始めました。 初回体験とモデル選択 3/5 ピッカー、ハブ、ハードウェア表示、サイズ警告、ダウンロードタイマーは優れています。ピッカーが示すのはギガバイトではなくパラメータ数で、'7 GB'と'17 GB'のメッセージはテスターを混乱させました。 中核機能 2/5 チャットは計算に答えました。ウェブページの読み取りとイベント検索はメモリ不足エラーで終わり、画像は生成されませんでした。 ガイダンスと反復修正 3/5 拒否メッセージは原因を説明し、上書きの方法も示しています。モデル起動中は進捗が出ず、7 GBがなぜ'free'だったのかの説明もありません。 性能 2/5 27Bの4-bitモデルで11.0 tok/s。他のアプリを開いた24 GBのMacで、34.4kコンテキストでメモリ不足になりました。 ドキュメント 該当なし 未テスト。 信頼性とプライバシー 該当なし 監査していません。ベンダーは100パーセントのオフライン利用が可能と述べていますが、ウェブ検索とダウンロードにはインターネットが必要です。オフライン動作は試していません。 アンインストール 該当なし 未テスト。 スコアは、以下の根拠から導いた案です(1 = 不良、5 = 非常に良い)。確定はテスターが行います。テスターの目標だった画像生成は、このマシンでは画像が作れなかったため低スコアです。
テストの詳細
アプリ デスクトップアプリのUnsloth(Unsloth Studio)。メモでは'Unsloth'、'Unslothh'、'Onslaught'と書かれていますが、このレポートでは'Unsloth'を使います。 観察
バージョン セットアップログ:'unsloth 2026.8.18 -> 2026.10.3 available, updating'。更新後のバージョンは2026.10.3と仮定しています。ウィンドウにはBETAのラベルが付いています。デスクトップアプリ自体のバージョンは記録されていません。 仮定
テスター Hans Kuepper(PromptQuorum創設者)
開始 2026年10月9日午後1時(メモによる)。スクリーンショット1枚に午後5:13とあるため、テストは少なくとも4時間続いたことになります。 観察
終了 未記録
ハードウェア 24 GBのMac。メモには'macOS M3 24 GB'、のちに'M3 24 GB Pro MacBook'とあります。アプリのModel hubには'24 GiB RAM'、'0 GiB VRAM + 24 GiB shared'、'12/12 CPU'と表示されています。正確なチップは記録されていません。 観察
システム macOS。バージョンは記録なし
インストール状態 クリーンインストールではありません。セットアップログに'Updating existing Unsloth install'と'existing install detected'とあり、テスターも'same as before'と述べています。以前に使っていたため、LM StudioとOllamaのモデルがすでに認識されていた可能性があります。 観察
ダウンロード 24 MBのDMG(テスターが読み取った値)。初回起動時に依存関係のステップが実行されました(第1章を参照)。 観察
テスト理由 Unslothの動作、特に'the picture functions'(画像機能)を確かめるため。テスターはモデルの最適化(学習)を使うつもりはありませんでした。
目的 24 GBのMacでローカルに画像を生成する。途中でチャットとModel hubも試しました。 観察
使用したAI支援 メモには数百語のニューヨークのスカイラインのプロンプトがあり、Markdownの太字記号からAIが書いたものと思われますが、未確認です。チャットモデルの回答(たとえばモデルの入手元について)は、ここでは根拠として使っていません。 仮定 すべての記述にラベルが付いています: 観察 実測 テスター推定 開発元主張 第三者情報 仮定 テスター見解 テスター誤り ラベルの意味
開示事項。 テスターはPromptQuorum(promptquorum.com)の創設者です。同サイトはローカルAIアプリに関するコンテンツサイト兼ディレクトリで、Unslothはそのディレクトリに掲載されており、別途書かれた既存のレビューページもあります。メモには、ベンダーとの接触、支払い、スポンサーの記録はありません。
元ノートのPDF: 追加予定
このテストを形作った6つの場面 すべては動きます。ただ、最終的な結果として、動かせなかったのです。
テスターのノートより。音声の文字起こしを軽く編集しています。 テストの経過 ダウンロード、セットアップ、初回起動 観察
インストーラーは24 MBのDMGで、テスターは'the smallest file I've ever seen'と受け止めました。
観察
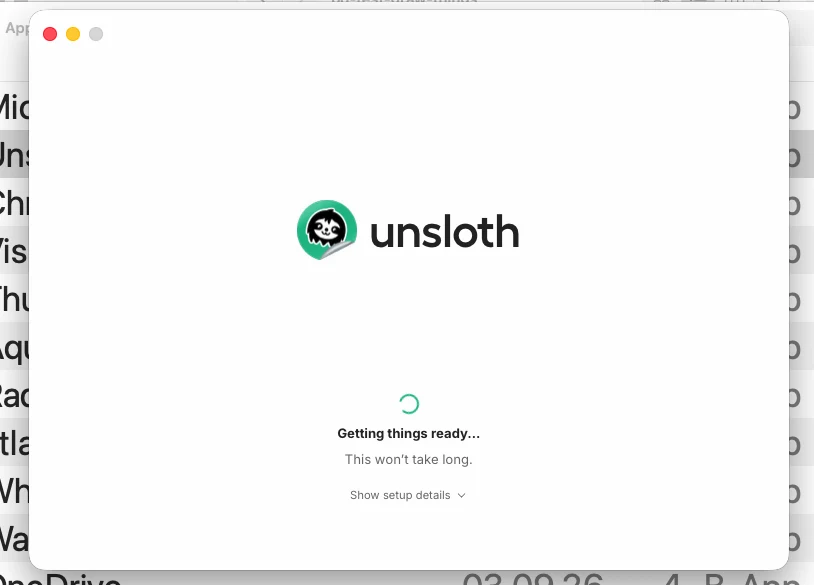
最初のウィンドウ:'Getting things ready... This won't take long.'と、'Show setup details'のリンク。テスター:'Already feels much more polished than the other apps... a clear communication.'
図 2 24 MBのDMGアプリを開いた直後の最初のウィンドウ。すぐ終わると表示されますが、テスターは計時しておらず、4〜5分と推定しています(更新ログは本文を参照)。時間やディスク容量の見積もりは表示されません。観察
詳細ログには次のように表示されます。'Updating existing Unsloth install'、'frontend bundled (Tauri)'、'node v24.13.0 | npm 11.6.2 (system)'、'unsloth 2026.8.18 -> 2026.10.3 available, updating'。続いて13ステップの依存関係バー(pipブートストラップ、Apple Silicon向けMLXスタック、基本パッケージ、unslothエクストラ、コーデック、オーバーライド、studio依存、data designer、ローカルプラグイン、diffusersのピン留め、仕上げ)。注記:'torch 2.10.0 detected -- installing torchao==0.16.0'、'transformers 5.3.0, 5.5.0, 5.10.2 pre-installed'、'gpu Apple Silicon (Metal, unified memory)'、'installing prebuilt llama.cpp'。
観察
テスターによれば、約4〜5分動いたあとでアプリが開きました。ログには時間の見積もりもディスク容量の見積もりもありません。
テスター推定
セットアップに4〜5分。計時はしていません。
仮定
小さなDMGは、この最初のステップでソフトウェアの大半をダウンロードしているのかもしれません。未確認。
テスター見解
'It gives me the details about what it does -- great -- but it doesn't tell me anything about estimated time, volumes, how much disk space it takes up.'
観察
メインウィンドウは'How can I help?'と、サイドバー(New chat、Model hub、Library、Images、Train、More)で開きます。ロゴにはBETAのラベルが付いています。
図 3 セットアップ後のメインウィンドウ。サイドバー:New chat、Model hub、Library、Images、Train、More。ロゴにはBETAのラベルが付いています。ウィンドウの背後のブラウザタブには、プロジェクトのGitHubページが写っています。テスター誤り
既存のインストール('same as before')から始めたため、初回起動ではなく更新のテストです。オンボーディングについての結論は、クリーンインストールでの確認が必要です。
モデルピッカーと最初のチャット 観察
モデルピッカーのRecommendedには、27.3Bや271.0Mといった数値が並びます。これらはギガバイトではなくパラメータ数です。2件はグレーアウトしています(176.9Bと320.8B)。
図 4 モデルピッカー、Recommendedタブ。数値はパラメータ数(B=10億、M=100万)で、ギガバイトではありません。2件はグレーアウトしています(Qwen3.8-Flash-Next-GGUF 176.9B、GLM-5.3-Flash-GGUF 320.8B)。グレーと黄色の点の意味は、撮影したアプリ画面には示されていません。仮定
グレーアウトした項目は、おそらくこのマシンには大きすぎるのでしょう。撮影した画面にはその説明がありません。
テスター見解
'There were lots of models listed with the size. Very good.'表示されている数値はパラメータ数なので、モデルに必要なメモリ量は読者には分かりません。
観察
モデルを選ぶ代わりに、テスターは計算の依頼を入力しました。アプリは自動でモデルの読み込みを始めました。メモによると、Qwen3.8-27B MLX 4-bitモデルは1分足らずで起動し、2つ目のトーストにはMistral-7B-Instruct-v0.3-4bitの読み込みが表示されました(スクリーンショットは非掲載。図5と同じ種類)。
観察
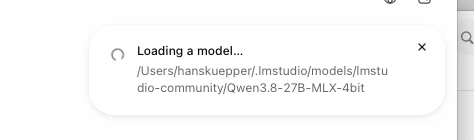
読み込みのトーストにはパス /Users/hanskuepper/.lmstudio/models/lmstudio-community/Qwen3.8-27B-MLX-4bit が表示されます。モデルはディスク上のLM Studioのフォルダから読み込まれました。
図 5 最初のチャットを始めたときに表示されたトースト。パスはLM Studioのモデルフォルダを指しています:/Users/hanskuepper/.lmstudio/models/lmstudio-community/Qwen3.8-27B-MLX-4bit。モデルはダウンロードではなく、ディスクから読み込まれました。テスター見解
彼はハードディスクから来たのではと推測しました。'that's a big model that doesn't go over the internet in one minute'だからです。パスはこの推測を裏づけます。UnslothがなぜこのモデルとMistralのモデルを選んだのかは記録されていません。
観察
'what is 5 times 866'という質問に、'Worked for 10s'のあと、11.0 tok/sで'5 x 866 = 4,330'と答えました(正解)。ヘッダーには'Local'と、コンテキストメーター'120 / 262.1k'が表示されています。
図 6 最初のチャット。答えの4,330は正解です(5 x 866)。画面には'Worked for 10s'、11.0 tok/s、コンテキストメーター'120 / 262.1k'が表示されています。観察
続いてテスターは、モデルにそのモデルをどこから入手したのかを尋ねました。回答の撮影部分はMLXの重みとApple Siliconのユニファイドメモリについてで、全文は残っていません。メモによると、回答は「アプリはドライブを検索しない」という内容でした。
仮定
チャットモデル自身によるアプリの説明は、信頼できる根拠ではありません。ある回答はモデルを'Qwen 3 27B MLX 4-bit'と呼んでいますが、アプリでの名前はQwen3.8-27B-MLX-4bitです。
ディスク上にあるモデル:LM StudioとOllama 観察
On Deviceタブは、モデルをソース別に一覧表示します。CUSTOM FOLDERSには2つのパス(.lmstudio/modelsと.ollama/models)があり、Ollamaのモデルとしてgemma4:latest、gemma3:1b、qwen3-coder:30bが並びます。LM STUDIOの下ではQwen3.8-27Bモデルに'Loaded'と付いています。
図 7 On Deviceタブ。CUSTOM FOLDERSには2つのパス(.lmstudio/modelsと.ollama/models)があり、Ollamaモデルとしてgemma4:latest、gemma3:1b、qwen3-coder:30bが並びます。LM STUDIOの下ではQwen3.8-27Bモデルに'Loaded'と付いています。一覧の背後には、MLXの重みについて述べるチャット回答が一部見えています。フォルダをテスターが追加したのか、自動で見つかったのかは記録されていません。仮定
2つのフォルダはテスターが追加したか、アプリが自動で見つけたかのどちらかですが、記録されていません。以前の使用で設定された可能性もあります。
観察
qwen3-coder:30b(30.5B、Q4_K_M、GGUF)に切り替えると、'Starting model... Switching models. Loading cached model into memory.'とCancelボタンが表示されます。コンテキストメーターは'1.3k / 8.2k'で、最初のモデルの262.1kよりずっと小さい値です。
図 8 Ollamaモデルqwen3-coder:30b(30.5B、Q4_K_M、GGUF)への切り替え。コンテキストメーターは'1.3k / 8.2k'。トーストには'Starting model... Switching models. Loading cached model into memory.'とCancelボタンが表示されています。テスター見解
'I like how easy to change models.' 'Some Ollama models do not work inside Unsloth, but great that it tried at least.'
観察
メモによると、古いモデルは動き、新しいモデルはクラッシュしました。どのモデルを指すのかは記録されていません。
テスター見解
彼はOllamaのモデルを使おうと'tried'した点を評価し、ディスク上のモデルを読み込めば、大きなダウンロードをもう一度しなくて済むと述べています。
Model hubとダウンロード 観察
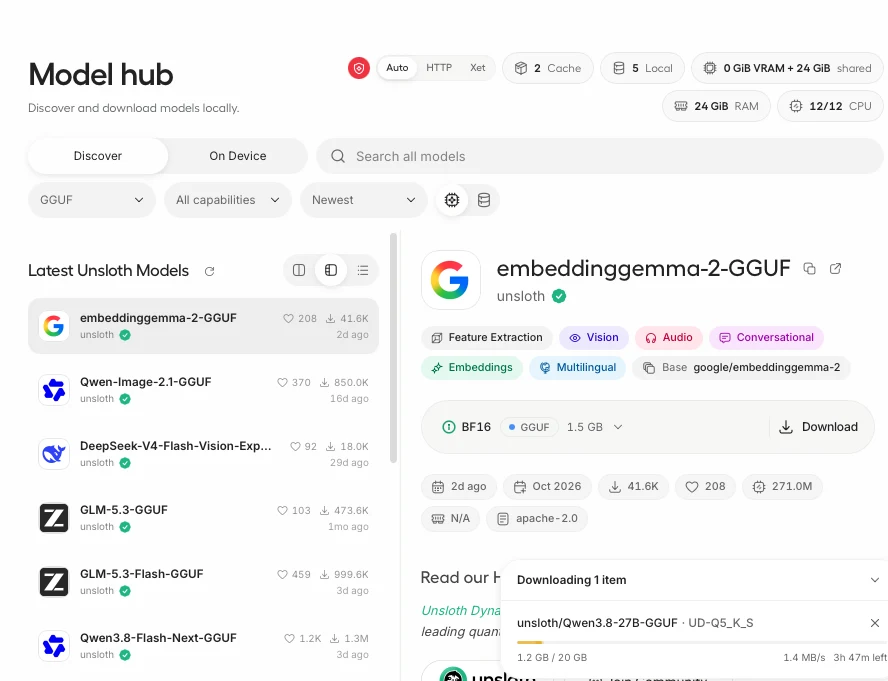
ハブにはデバイス情報が表示されます:'0 GiB VRAM + 24 GiB shared'、'24 GiB RAM'、'12/12 CPU'。フィルタ(形式、機能、新着)もあります。カードにはいいね数、ダウンロード数、公開からの期間、ライセンスが表示されます(embeddinggemma-2-GGUF:apache-2.0、1.5 GB)。
図 9 Model hub。右上:'0 GiB VRAM + 24 GiB shared'、'24 GiB RAM'、'12/12 CPU'。ダウンロードパネル:unsloth/Qwen3.8-27B-GGUF UD-Q5_K_S、20 GB中1.2 GB、1.4 MB/s、残り3時間47分。開いているモデルカードのembeddinggemma-2-GGUF(1.5 GB、apache-2.0)は、ダウンロード中のモデルではありません。テスター見解
'Yes, great model hub.'ハブにはQwen-Image-2.1-GGUF(ダウンロード85.0万件、公開16日)、GLM-5.3-GGUF、Qwen3.8-Flash-Next-GGUFなどが載っています。
観察
メモによると、Macには大きすぎるファイルをクリックすると複数の警告('this file is 30 to 40 gigabytes total')が出ますが、ダウンロード自体は許可されます。スクリーンショットなし。
実測
unsloth/Qwen3.8-27B-GGUF UD-Q5_K_Sのダウンロードパネルは、20 GB中1.2 GB、1.4 MB/s、残り3時間47分と表示。のちに20 GB中7.1 GB、983 KB/s、残り3時間31分。
図 10 同じダウンロードの後の様子:20 GB中7.1 GB、983 KB/s、残り3時間31分。前のスクリーンショットとの間隔は記録されていません。テスター見解
'The professionalism of this app is visible. It has a timer attached. It tells you the download speed.'
仮定
この速度は、テスト場所の回線が遅いことを示唆しますが、テスター自身はそうは述べていません。ダウンロードが完了したかどうかは記録されていません。
実測
Z-Image(BF16)のダイアログには、モデルファイル12.3 GBに必須のエンコーダとデコーダ8.2 GBを加えた合計20.5 GBと表示されます。これは、テスターが別の箇所で述べている'difference between the gigabytes that the model has and then something else'の説明になります。
図 19 Z-Image(BF16)のダウンロードダイアログ:モデルファイル12.3 GB、'Include required files' 8.2 GB(エンコーダとデコーダ。互換性のある版で共有)、合計20.5 GB。'Downloading will not load this model or switch your current model.'テスター見解
メモには'the picture LLM was downloaded'とあります。どれかは記録されていません。スクリーンショットには、デバイス上の画像モデルFLUX.2-klein-4BとそのGGUF版が写っています(図18)。
ウェブ検索、音声、クラッシュ 観察
テスターはPromptQuorumのページURLを貼り付け、'from a seo perspective will this help me?'と尋ねました。チャットには'Using tool: Reading promptquorum.com'と'Waiting for approval: web_search'が表示され、Allow、Always allow、Denyのボタンが出ます。時刻は午後5:13、コンテキストは'648 / 34.4k'。
図 11 Qwen3.8-27B-MLX-4bitとのチャット。コンテキスト'648 / 34.4k'、時刻は午後5:13。プロンプトにはPromptQuorumのURLとSEOについての質問があります。アプリは'Waiting for approval: web_search'とAllow、Always allow、Denyのボタンを表示しています。モードは'Approve for me'です。観察
メモによると、1回目はページを読めないと言われ、Search機能をクリックしたあとの2回目は動きました。'Maybe the first time should have had a warning.'
仮定
最初の失敗は、ウェブ検索の承認がなかったか、Searchのトグルがオフだったことが原因かもしれません。未確認。
観察
実行は168.10秒後に'Ran out of memory. Try a smaller model or shorter input.'で終わり、Retryボタンが表示されました。
図 12 同じチャットは、168.10秒後に'Ran out of memory. Try a smaller model or shorter input.'で終わります。観察
音声入力は内蔵されています。使うと、約1.0 GBの音声モデル'Qwen3-ASR 0.6B'のダウンロードを求められ、Hugging Faceのキャッシュに1回だけ取得されると表示されます。テスターがダウンロードしたかどうかは記録されていません。
図 13 音声入力:'Local dictation runs entirely offline, but it needs the Qwen3-ASR 0.6B speech model first. About 1.0 GB, fetched once into your Hugging Face cache.'テスターがダウンロードしたかどうかは記録されていません。観察
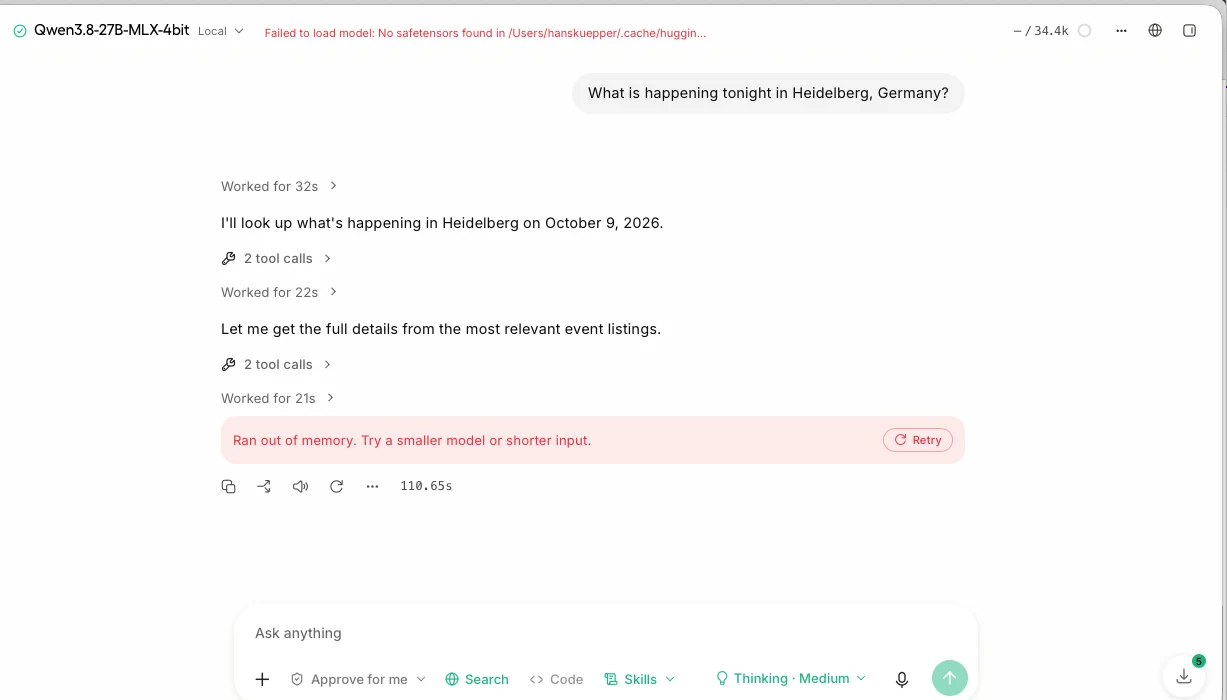
ローカルのイベント検索('What is happening tonight in Heidelberg, Germany?')は、ツール呼び出しを2ラウンド実行し、110.65秒後に'Ran out of memory'で終わりました。ヘッダーには赤い注記'Failed to load model: No safetensors found in /Users/.../.cache/huggin...'が出ています。
図 14 ローカルのイベント検索。ヘッダー(赤):'Failed to load model: No safetensors found in /Users/.../.cache/huggin...'。チャットでは'tool calls'が2ラウンド続き、110.65秒後に'Ran out of memory. Try a smaller model or shorter input.'となります。コンテキストは'- / 34.4k'。ダウンロードのバッジは5を示しています。仮定
読み込みエラーとメモリ不足のメッセージは関連しているのかもしれません(メモリが足りない状態でモデルが入れ替えられた場合)。スクリーンショットからは関連は読み取れません。
テスター見解
'But yes, local AI, always some issues.'
画像モデル:メモリ不足で拒否 観察
テスターの目標は画像でした。サイドバーには'Images'の項目があります。メモには、構図と避ける要素のリスト付きで、ニューヨークのスカイラインを描く長いプロンプトが載っています(ブルックリンからの眺め、ブルックリン橋、ゴールデンアワー、8Kのディテール)。これについて、結果・エラー・設定の記録はありません。
実測
画像モデルflux.2-kleinの読み込みは拒否されました:'needs about 17 GB of memory for its weights, but only about 2 GB is usable on this device (of the 7 GB currently free, after reserving room for the operating system)'。さらに、Macのメモリは1つのプールであり、CPUへのオフロードでは何も空かないと説明し、より小さなモデル、より低いquant、他のアプリを閉じることを提案しています。上書き用にUNSLOTH_DIFFUSION_ALLOW_OVERSIZED_LOAD=1を挙げています。
図 1 画像モデルflux.2-kleinの読み込み拒否。アプリは必要約17 GB、使用可能約2 GB(現在の空き7 GBからOS用の余地を差し引いた値)と表示しています。上書き用の変数UNSLOTH_DIFFUSION_ALLOW_OVERSIZED_LOAD=1が示されていますが、試していません。実測
クリーンな再起動後のメッセージ:必要約17 GB、使用可能約6 GB、現在の空き11 GB。
図 15 flux.2-kleinの2回目の拒否:必要約17 GB、使用可能約6 GB(現在の空き11 GB)。メモの順序から、クリーンな再起動後に撮影されたものと読んでいます。仮定
2つのメッセージは、どちらの組でも差が5 GBです(7 - 2と11 - 6)。そのため、アプリはOS用に約5 GBを確保しているようです。データ点は2つだけです。
観察
デバイス一覧にはFLUX.2-klein-4B-GGUF(7.8 GB)、FLUX.2-klein-4B(16 GB)、mistral-7b-v0.3-bnb-4bit(4.1 GB)が載っています。テスター:'This should be small enough.'テスターによれば、ハブで最も小さい画像モデルでも24 GBのマシンがクラッシュし、クリックしたモデルはどれも、利用可能なのが'seven gigabytes'だけなので大きすぎると表示されました。
図 18 UNSLOTHの下にあるデバイス上のモデル:FLUX.2-klein-4B-GGUF(BF16、画像アイコン、4B、7.8 GB)、FLUX.2-klein-4B(画像アイコン、4B、16 GB)、mistral-7b-v0.3-bnb-4bit(7B、4.1 GB)。テスター誤り
テスターは、なぜ7 GBしか使えないのかと疑問を述べています('I have much more')。ダイアログは、その時点で7 GBが空いており、他のアプリが動いていたと説明し、再起動後は11 GBと表示しています。メモは'7 GB'の発言をZ-Imageのダイアログの隣に置いていますが、7 GBという数字が出てくるのはflux.2-kleinのメッセージです。
テスター見解
'I'm lost... I have a 24-gigabyte machine and I cannot find an LLM that can serve me and can do the job.'彼は、24 GBは読者の80パーセント超が持つ容量より大きいと考えています(本人の推定であり、測定値ではありません)。
テスター推定
'More than 80% of my readers'は24 GB以下だといいます。出典は示されていません。
Macのメモリ 観察
テスターは、ローカルモデルと日常の作業が同じメモリを奪い合い、Chromeなどのアプリが5〜8 GBを使うと結論づけています。彼は一貫して'VRAM'と書いていますが、Apple Siliconのメモリは1つのプールで、ハブも'0 GiB VRAM + 24 GiB shared'と表示しています。
実測
アクティビティモニタ、1回目のキャプチャ:使用メモリ12.92 GB、キャッシュされたファイル10.95 GB、アプリメモリ9.81 GB、確保されているメモリ1.83 GB、スワップ0。
図 16 長く平らな履歴が表示されたメモリのパネル。使用メモリ12.92 GB、キャッシュされたファイル10.95 GB、アプリメモリ9.81 GB、確保されているメモリ1.83 GB、使用スワップ0バイト。撮影した時点と、開いていたアプリは記録されていません。実測
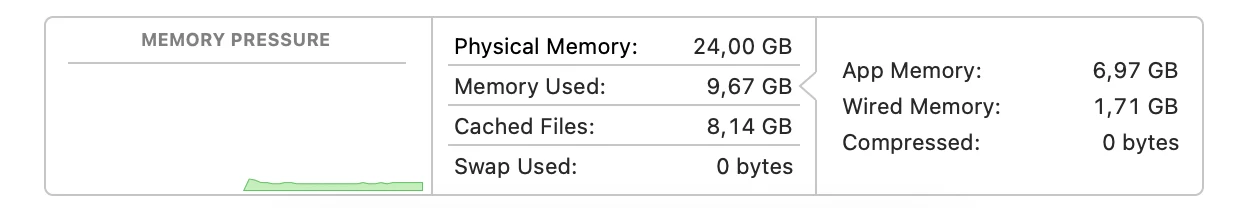
アクティビティモニタ、別のキャプチャ:使用メモリ9.67 GB、キャッシュされたファイル8.14 GB、アプリメモリ6.97 GB、確保されているメモリ1.71 GB、スワップ0。短い履歴グラフは、起動直後であることと整合します。
図 17 グラフの後半から始まる短い履歴が表示されたメモリのパネル。使用メモリ9.67 GB、キャッシュされたファイル8.14 GB、アプリメモリ6.97 GB、確保されているメモリ1.71 GB、スワップ0。メモの'起動時に10 GB'という発言と一致しますが、どの時点かは記録されていません。仮定
図15の'currently free' 11 GBは、図16の24.00 - 12.92 = 11.08 GBと整合します。2つが同時に撮影されたかどうかは記録されていません。
テスター見解
'Even after reboot, already nine gigabytes gone for general things.' 'Either I shut the computer down, reboot, stop all the processes... or I cannot run the LLM.'
テスター見解
考えられる答えは2つ:モデルがもっと小さく優れたものになるか、コンピュータが48 GBや64 GBを必要とするか。'All of this talk about this works on your computer is a little bit fake.'
仮定
48 GBや64 GBなら'confidently'解決するというのは、未検証です。
フィードバックのない読み込みと、締めくくりの見解 観察
モデルの起動時には、スピナーとCancel付きのトースト'Starting model... Loading cached model into memory.'が表示されます。割合もサイズも時間も出ません。
図 20 モデルの起動。トーストにはスピナーと'Loading cached model into memory.'が表示されます。割合もサイズも時間も出ません。テスターによれば、2〜3分より長くかかりました(推定)。テスター推定
待ち時間は2〜3分より長くかかりました(計時はしていません)。
テスター見解
'The worst way you can treat a client is to do the work and not update the client.'テスターはこれをユーザーインターフェースの問題だとしています。
観察
ヘッダーのメーターには、コンテキストに対する使用トークン数(たとえば'648 / 34.4k')と、毎秒トークン数(11.0 tok/s)が表示されます。
テスター誤り
メモには'no token counter'とあります。スクリーンショットにはコンテキストメーターと毎秒トークン数が写っています。彼が言いたかったのは、メッセージごとのトークン数かもしれません(仮定)。
テスター誤り
メモはローカルのチャットモデルを'the most stupid idea'と呼び、'does not research the internet'からだとしています。同じメモとスクリーンショットには、Search機能、ウェブ検索の承認プロンプト、ページを読むツール呼び出しが示されています。
テスター見解
彼はモデルを学習させたくありません。チャット機能はあまり役に立たず、欲しいのは画像と動画のツールで、'is not seeing it yet'とのこと。学習と'Train'タブは試していません。
テスター見解
'Maybe it's on my side, but no, not for me. I'll check again in three or six months, but currently not on a M3 24 GB Pro MacBook.'
主張とテスターが確認した内容 主張 入手元 観察 ラベル 'Run and train image and video diffusion or multimodal models'、ローカルで(GitHubのREADME、ドキュメントページ) ベンダー、2026年10月16日確認 画像は生成されませんでした。flux.2-kleinは拒否されました(必要約17 GB、使用可能は2 GBと6 GB)。より小さい画像モデルが読み込めるかは確認していません。学習は試していません。 観察 macOSでは'Training, MLX and GGUF inference all work inside of Unsloth'(ドキュメント) ベンダー、2026年10月16日確認 MLXモデル(Qwen3.8-27B 4-bit)とGGUFモデル(qwen3-coder:30b)は読み込まれ、応答しました。学習は試していません。 観察 'Can be used 100% offline and locally on your computer'(ドキュメント) ベンダー、2026年10月16日確認 ウェブ検索とダウンロードではインターネットを使いました。オフライン利用は試していません。 観察 ウェブ検索は'visits pages directly'(ドキュメント) ベンダー、2026年10月16日確認 ページの読み取りを試みました。メモによると1回目は失敗し、2回目はページを読めました。その後メモリ不足になりました。 観察 デスクトップアプリは'free and open source'(リリースノート) ベンダー、2026年10月16日確認 メモにもスクリーンショットにも、支払いを求める表示はありません。 観察 ハブに表示されるハードウェア アプリ ハブには24 GiB RAM、0 GiB VRAM + 24 GiB shared、12/12 CPUと表示されました。RAMの値はMacの24.00 GBと一致します。 実測 'No hardware requirements stated'(読んだページ) ベンダー、2026年10月16日確認 返されたテキストには、GitHubのページにもドキュメントページにも必要メモリの記載はありませんでした。アプリは読み込み時に自分で必要量を表示します(flux.2-kleinで17 GB)。 観察
24 GBに収まるか 24 GBメモリ
flux.2-kleinの重み(拒否メッセージによる) 約17 GB必要 24 GB未満 実測 FLUX.2-klein-4B(デバイス一覧) ファイルサイズ16 GB 24 GB未満 実測 FLUX.2-klein-4B-GGUF(デバイス一覧) ファイルサイズ7.8 GB 24 GB未満 実測 アプリが示す使用可能量(再起動前) 空き7 GBのうち約2 GB 24 GB未満 実測 アプリが示す使用可能量(再起動後) 空き11 GBのうち約6 GB 24 GB未満 実測 Macの使用メモリ、アクティビティモニタ(1回目のキャプチャ) 12.92 GB使用中 24 GB未満 実測 Macの使用メモリ、アクティビティモニタ(2回目のキャプチャ) 9.67 GB使用中 24 GB未満 実測 Z-Image BF16のダウンロード合計 モデル12.3 GB+必須ファイル8.2 GB(ダウンロードサイズ) 24 GB未満 実測 2、3、8行目はファイルまたはダウンロードのサイズで、実行時のメモリ使用量ではありません。17 GBはflux.2-kleinに対するアプリ自身の見積もりで、どのファイル版を指すのかは記録されていません。'Usable'は、OS用の余地を差し引いたあとのアプリの値です。Qwen3.8-27B MLX 4-bitモデルはチャットで動作しましたが、メモリ使用量は読み取っていません。
利用ログ # タスク モデル 結果 時間 ステータス 図 1 24 MBのアプリを開く、更新、初回起動 Unsloth 2026.8.18 -> 2026.10.3(仮定) セットアップログのあとに開いた。既存のインストール 約4〜5分(テスター推定) 合格 図 2 , 図 3 2 ピッカーからモデルを選ぶ 未記録 パラメータ数付きの一覧。テスターは選ばなかった 未記録 合格 図 4 3 チャット:計算(5 x 866) Qwen3.8-27B-MLX-4bit 4,330、正解。11.0 tok/s、10秒 10秒(実測) 合格 図 6 4 モデルの入手元をチャットモデルに尋ねる Qwen3.8-27B-MLX-4bit 回答は一部しか記録されていない 未記録 一部成功 図 7 5 Ollamaモデルに切り替える qwen3-coder:30b(Q4_K_M、GGUF) 読み込み済み。コンテキスト8.2k。メモによると一部のOllamaモデルは動かない 未記録 一部成功 図 8 6 ハブを見て、20 GBのダウンロードを開始 unsloth/Qwen3.8-27B-GGUF UD-Q5_K_S ダウンロード開始。残り3時間47分、のち3時間31分。終了は未記録 未記録 一部成功 図 9 , 図 10 7 大きすぎるモデル(30〜40 GB)への警告 未記録 複数の警告。ダウンロードは許可される(メモのみ) - 合格 - 8 ウェブページをSEOの観点でレビュー Qwen3.8-27B-MLX-4bit 承認プロンプトが出て、'Ran out of memory'で終了 168.10秒 失敗 図 11 , 図 12 9 音声入力 Qwen3-ASR 0.6B(約1.0 GB) ダウンロードのダイアログ。結果は未記録 未記録 未完了 図 13 10 ローカルのイベント検索(ハイデルベルク) Qwen3.8-27B-MLX-4bit 読み込みエラーとメモリ不足 110.65秒 失敗 図 14 11 ニューヨークのスカイラインの画像、長いプロンプト 未記録 結果の記録なし 未記録 未完了 - 12 flux.2-kleinを読み込む、多数のアプリを開いた状態 flux.2-klein 拒否:必要17 GB、空き7 GBのうち使用可能2 GB - 失敗 図 1 13 クリーンな再起動後にflux.2-kleinを読み込む flux.2-klein 拒否:必要17 GB、空き11 GBのうち使用可能6 GB - 失敗 図 15 14 デバイス上のより小さい画像モデルを試す FLUX.2-klein-4B-GGUF 7.8 GB、FLUX.2-klein-4B 16 GB メモでは'All too big'。それぞれのスクリーンショットはなし - 失敗 図 18 15 Z-Image BF16のダウンロードダイアログ Z-Image BF16 合計20.5 GB。ダウンロードの記録なし - 未完了 図 19 16 モデルを起動する(キャッシュ済み) 未記録 スピナーと'Loading cached model into memory'のみで進捗なし。結果は未記録 2〜3分超(テスター推定) 一部成功 図 20
テスターが誤った点 テスター誤り 既存のインストールの更新('same as before')をテストしており、初回起動のインストールではない。 テスター誤り 最初のメモリテストを、24 GBのMacでChrome、Claudeアプリ、Word、WhatsAppなどを開いたまま実行した。最初の拒否では空きが7 GBだった。 テスター誤り アプリが'0 GiB VRAM + 24 GiB shared'と表示しているのに、一貫してメモリを'VRAM'と呼んだ。 テスター誤り 'no token counter'と書いたが、スクリーンショットにはコンテキストメーターと毎秒トークン数が写っている。 テスター誤り ローカルのチャットモデルは'does not research the internet'と書いたが、スクリーンショットにはSearch機能とウェブ検索のツール呼び出しが写っている。 テスター誤り モデルピッカーの数値をサイズと読み違えた。実際はパラメータ数である。 テスター誤り 他に何を開いていたかを書かずに、使えるのは7 GBだけと記した。ダイアログによれば、その時点で空きが7 GBだった。 テスター誤り 記録に抜けがある:デスクトップアプリのバージョン、macOSのバージョン、チップ、終了時刻、ニューヨークのプロンプトに使ったモデルとその結果、動かなかったOllamaモデル、20 GBのダウンロードが完了したか、画像実行の設定、アンインストール。 テスター誤り メモで、アプリ名を'Onslaught'や'Unslothh'と綴った(音声の文字起こしによる)。 仮定 メモはZ-Imageのダイアログを'only seven gigabytes'の発言の隣に置いているが、7 GBという数字はflux.2-kleinのメッセージにある。スクリーンショットは、順序だけでなく、写っている内容で本文と対応づけた。 所見一覧 すべて 観察 実測 テスター推定 開発元主張 第三者情報 仮定 テスター見解 テスター誤り
ID 所見 カテゴリ ラベル 重要度 図 UN-01 DMGは24 MBで、テスターがこれまで見た他のアプリよりずっと小さい。 インストール 観察 良好 図 2 UN-02 初回起動では13ステップの依存関係のインストールが約4〜5分動き、時間やディスク容量の見積もりはない。詳細ログは見られる。 インストール テスター推定 中 図 2 UN-03 テストは既存のインストール(2026.8.18から2026.10.3)から始めたため、初回起動の挙動は確認していない。 テストの限界 観察 中 図 3 UN-04 モデルピッカーが示すのはパラメータ数(27.3B、271.0M)で、ダウンロードサイズやメモリ量ではない。一部の項目はグレーアウトしているが、撮影した画面に説明はない。 オンボーディング 観察 中 図 4 UN-05 27Bの4-bitモデルが'5 x 866'に正しく答えた。11.0 tok/s、10秒。 中核機能 実測 良好 図 6 UN-06 最初のチャットは、ダウンロードも確認もなく、LM Studioのフォルダからモデルを読み込んだ。 モデルの扱い 観察 中 図 5 UN-07 LM StudioとOllamaのフォルダにあるモデルがOn Deviceの一覧に表示される。 モデルの扱い 観察 良好 図 7 UN-08 一部のOllamaモデルはUnsloth内で動かなかった。どれかは記録されていない。 互換性 観察 中 - UN-09 ハブにはRAM、共有メモリ、CPU数と、速度と残り時間付きのダウンロードパネルが表示される。 Model hub 観察 良好 図 9 , 図 10 UN-10 20 GBのダウンロードは、1.4 MB/sで残り3時間47分と表示された(回線に依存)。 Model hub 実測 低 図 9 UN-11 大きすぎるモデルには複数の警告が出るが、ダウンロードはできる(メモのみ)。 Model hub 観察 良好 - UN-12 ダウンロードのダイアログは、モデルファイルと必須ファイルを分けて示す(12.3+8.2=20.5 GB)。 Model hub 実測 良好 図 19 UN-13 ウェブ検索には承認が必要。メモによると、最初の試行は警告なしにページを読めず失敗した。 UX 観察 低 図 11 UN-14 27Bモデルでのウェブページの読み取りは、168.10秒後に'Ran out of memory'で終了した。 安定性 観察 高 図 12 UN-15 イベント検索は'Failed to load model: No safetensors found'と、110.65秒後の'Ran out of memory'で失敗した。 安定性 観察 高 図 14 UN-16 音声入力は内蔵されているが、1.0 GBの専用音声モデルのダウンロードが必要。 機能 観察 低 図 13 UN-17 flux.2-kleinは読み込みを拒否された:必要約17 GB、使用可能約2 GB(空き7 GB)。 中核機能 実測 高 図 1 UN-18 クリーンな再起動後:空き11 GBのうち使用可能約6 GB。やはり読み込みは拒否された。 中核機能 実測 高 図 15 UN-19 アプリはOS用に約5 GBを確保しているようだ(データ点は2つ)。 メモリ 仮定 中 図 1 , 図 15 UN-20 拒否メッセージは原因(メモリは1つのプール、CPUオフロードの効果なし)を説明し、上書き用の変数も示している。 ガイダンス 観察 良好 図 1 UN-21 Macは、モデルを読み込む前の起動直後で、約9.67 GBを使用している。 メモリ 実測 中 図 17 UN-22 24 GBのMacでは画像が1枚も生成されなかった。一覧にある最小の画像モデル(7.8 GB、16 GB)も、メモでは'too big'とされた。 中核機能 観察 高 図 18 UN-23 モデルの起動では、割合も時間も出ないスピナーが2〜3分以上続く。 UX 観察 中 図 20 UN-24 チャットのヘッダーにはコンテキストメーターと毎秒トークン数が表示されており、'no token counter'というメモとは異なる。 UX 観察 良好 図 6 UN-25 テスターはインターフェースを美しく滑らかだと評価する一方、結果にたどり着けず、今このアプリを使う理由は見いだせないとしている。 総合 テスター見解 中 - UN-26 ディレクトリはライセンスをApache-2.0としているが、GitHubのページではStudio UIはAGPL-3.0、コアはApache-2.0とされている。 メンテナンス 第三者情報 中 -
重要度は、初めて使う人への影響度です。提案値であり、測定値ではありません。
こんな人に向いています 向いている可能性が高い人 仮定 24 GBより多いメモリを持つ人や、アプリをあまり開いていないクリーンなマシンで、チャット、Model hub、LM StudioとOllamaのローカルモデルを1つのアプリで使いたい人。 開発元主張 モデルの学習やファインチューニングをしたい人。ベンダーによれば、これがプロジェクトの主な目的です(ここでは未テスト)。 向いていない可能性が高い人 テスター見解 他のアプリを開いたまま、24 GBのMacでローカルの画像生成をしたい人。テスターには動作しませんでした。 テスター見解 モデルやメモリ、学習について学ばずに、すぐ結果を得たい人。 再テスト。 テスターは3〜6か月後(2027年1月〜4月ごろ)に再確認する予定です。それまでに、デスクトップアプリのバージョン、macOSのバージョン、チップを記録し、クリーンインストールから始め、他のアプリを閉じて空きメモリを記録し、収まる画像モデル(たとえば7.8 GBのGGUF)を試して各設定と結果を記録し、学習、オフライン利用、アンインストールをテストしてください。
顧客への最悪の扱い方は、仕事をしておきながら状況を伝えないことです。
テスターのノートより。音声の文字起こしを軽く編集しています。 よくある質問 24 GBのMacでUnslothは画像を生成できますか? このテストではできませんでした。画像モデルflux.2-kleinの読み込みは2回拒否されました。最初は必要約17 GBに対し使用可能約2 GB(空き7 GB)、再起動後は使用可能約6 GB(空き11 GB)でした。画像は生成されませんでした。 実測
UnslothはLM StudioやOllamaに入れ済みのモデルを見つけてくれますか? このテストでは見つけました。最初のチャットは、ダウンロードなしでLM Studioのモデルフォルダから、Qwen3.8-27Bの4-bitモデルを読み込みました。On Deviceの一覧にはgemma4:latestやqwen3-coder:30bなどのOllamaモデルも表示されました。動かなかったOllamaモデルもありましたが、どれかは記録されていません。 観察
24 GBのMacでUnslothのチャットはどのくらい速いですか? 27Bの4-bitモデルは、'what is 5 times 866'(4,330、正解)に毎秒11.0トークンで、10秒で答えました。同じモデルでのウェブページの読み取りとイベント検索は、他のアプリを開いた状態で'Ran out of memory'で終わりました。 実測
Unslothのインストーラーはどのくらい大きく、セットアップにどのくらいかかりますか? DMGは24 MBです。初回起動では13ステップの依存関係の更新が実行され、テスターは4〜5分と推定しています。ウィンドウには時間やディスク容量の見積もりは表示されません。テストはクリーンインストールではなく、既存のインストールから始めました。 観察
Unslothは完全にオフラインで使えますか? ベンダーのドキュメントには、100パーセントオフラインでローカルに使えると書かれています。オフライン利用は試していません。ウェブ検索とモデルのダウンロードではインターネットを使いました。 開発元主張
開発元の背景 ハンズオンの範囲外です。以下は、ベンダーのGitHubページ、ドキュメント、リリースページと、PromptQuorumのディレクトリから、2026年10月16日にページを要約するウェブ取得ツールで読み取ったもので、独自には検証していません。
開発元主張 GitHubのページはUnslothを'first desktop app to run and train models'、'Local UI to run and train LLMs and diffusion models'と説明しています。Unsloth Studio(ウェブUI)とUnsloth Core(コード)を提供しています。読んだページには企業名も個人名もありませんでした。 開発元主張 ライセンス:コアパッケージはApache 2.0。'certain optional components, such as the Unsloth Studio UI'はAGPL-3.0です。 開発元主張 対応プラットフォーム:Windows、Linux、WSL、macOS。インストール方法:デスクトップアプリ(macOSは.dmg)、シェルスクリプト、Homebrew、Docker。返されたテキストにハードウェア要件の記載はありませんでした。 開発元主張 Studioのドキュメント:GGUF、MLX、diffusionの画像・動画モデルをローカルで実行。macOSでは'Training, MLX and GGUF inference all work inside of Unsloth'。ウェブ検索は'visits pages directly'。'can be used 100% offline'。 第三者情報 PromptQuorumのディレクトリは、Unslothを無料、Apache-2.0、Mac・Windows・Linux対応、ファインチューニングとLoRAのカテゴリで、GitHubのスター数約76,100として掲載しています(データ確認は2026年9月13日)。リリースv0.1.905-betaのmacOS DMG(2026年10月9日確認)と、2026年10月16日の最終アップストリーム更新も記録しています。PromptQuorumは、このレポート以前にはハンズオンテストをしていません。 仮定 2026年10月16日に読んだリリースページでは、最新がv0.1.806-beta(9月2日)と返され、ディレクトリのv0.1.905-betaと異なります。要約ツールが古いページを読んだ可能性があります。セットアップログのPythonパッケージのバージョン(2026.10.3)は、デスクトップアプリのタグとは別の番号体系です。 ラベルの見方
観察 アプリ、スクリーンショット、またはテスターのノートで直接確認した内容。
実測 ダイアログ、カウンター、ツールから読み取った値。数値を明記しています。
テスター推定 テスター自身の推定。計時も計数もしていません。
開発元主張 アプリ、ストア掲載情報、またはウェブサイトの記載。未検証です。
第三者情報 ほかの情報源(AIアシスタントや記事)によるもの。ここでは未検証です。
仮定 推論です。誤っている可能性があります。
テスター見解 テスターの判断または意見。
テスター誤り テスターが間違えた、または見落とした点。 出典 テスターのハンズオンメモ、2026年10月9日(元のWord文書'20261009_Unslothh'。元ノートのPDFは追加予定)。 UnslothのGitHubプロジェクト(github.com/unslothai/unsloth)、そのリリースページ、Unsloth Studioのドキュメントページ(unsloth.ai/docs/new/studio)。2026年10月16日確認。 PromptQuorumディレクトリのUnsloth掲載ページ(スラッグ:unsloth)。データ確認は2026年9月13日。 テストID pq-test-unsloth-2026-10-09 · テスト標準 v0.1 · 元ノートのPDF:追加予定
アプリの試し方:なぜ決まった基準がないのか — これらのテストは私個人の見解であり、保証ではありません。