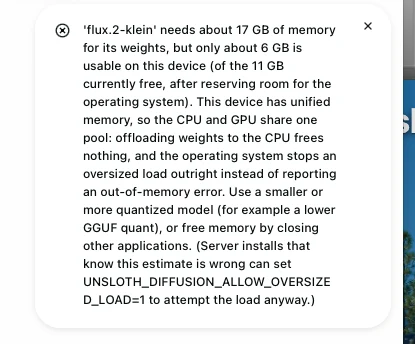
그림 1이미지 모델 flux.2-klein 로드 거부. 앱은 약 17 GB 필요, 사용 가능 약 2 GB(현재 여유 7 GB에서 운영체제 몫을 뺀 값)라고 알립니다. 우회 변수 UNSLOTH_DIFFUSION_ALLOW_OVERSIZED_LOAD=1도 알려 주는데, 시도하지 않았습니다.
결론
종합 평가
앱은 완성도가 높아 보이고 그렇게 느껴집니다. 설치 파일은 24 MB이고, 설정 창은 진행 내용을 보여 주며, 모델 허브에는 하드웨어 정보, 크기 경고, 다운로드 타이머가 있고, 채팅은 LM Studio와 Ollama에서 받아 둔 모델을 디스크에서 찾아냅니다. 27B 모델로 계산 문제를 11.0 tok/s에 풀었습니다. 그러나 테스트의 목표였던 이미지는 만들지 못했습니다. 이미지 모델은 약 17 GB가 필요한데 앱이 사용 가능한 메모리를 2 GB(재부팅 전)와 6 GB(재부팅 후)로만 계산해 거부되었습니다. 웹 검색과 행사 검색은 'Ran out of memory'로 끝났고, 모델을 시작할 때는 몇 분 동안 진행 표시가 없었습니다. 테스터는 처음 테스트를 다른 앱을 많이 열어 둔 채 진행했으며, 일부 실행의 모델과 설정은 기록하지 않았습니다.
테스터의 사용 목적과의 적합성
지금은 이 테스터의 이 기기에는 맞지 않습니다. 그의 말로는 'Everything works, except that the end result is I didn't get it to work.' 24 GB에서 채팅과 모델 관리는 동작하지만, 이 테스트에서 이미지 생성은 동작하지 않았습니다. 학습은 시도하지 않았습니다. 테스터는 3~6개월 뒤 다시 살펴볼 계획입니다.
관찰LM Studio 폴더의 27B 4-bit 모델이 계산 문제에 11.0 tok/s로 답하며 채팅이 동작했습니다. Ollama와 LM Studio의 모델이 앱에 나타납니다.
측정이미지 모델이 거부되었습니다. flux.2-klein에는 약 17 GB가 필요한데 앱은 사용 가능 메모리를 약 2 GB(여유 7 GB)로, 재부팅 후에는 약 6 GB(여유 11 GB)로 계산했습니다. 이미지는 생성되지 않았습니다.
테스터 의견모든 것이 동작하는 아름다운 인터페이스지만, 24 GB Mac에서는 최종 결과에 도달하지 못했습니다.
점수표 상태: 부분 성공
설치4/524 MB DMG. 설정 창에 상세 로그가 있습니다. 소요 시간이나 디스크 용량 안내는 없고, 4~5분 걸렸다는 것은 테스터의 추정입니다. 테스트는 기존 설치에서 시작했습니다.
온보딩과 모델 선택3/5선택기, 허브, 하드웨어 정보, 크기 경고, 다운로드 타이머는 강점입니다. 선택기는 기가바이트가 아니라 파라미터 수를 보여 주며, '7 GB'와 '17 GB' 메시지가 테스터를 혼란스럽게 했습니다.
핵심 기능2/5채팅은 계산 문제에 답했습니다. 웹 페이지 읽기와 행사 검색은 메모리 부족 오류로 끝났고, 이미지는 생성되지 않았습니다.
안내와 반복 작업3/5거부 메시지는 원인을 설명하고 우회 방법을 알려 줍니다. 모델이 시작되는 동안에는 진행 표시가 없고, 왜 7 GB가 '여유'로 나오는지 설명도 없습니다.
성능2/527B 4-bit 모델에서 11.0 tok/s. 다른 앱을 열어 둔 24 GB Mac에서 34.4k 컨텍스트로 메모리가 부족했습니다.
문서해당 없음테스트하지 않았습니다.
신뢰와 개인정보해당 없음감사하지 않았습니다. 공급자는 100퍼센트 오프라인 사용이 가능하다고 내세우지만, 웹 검색과 다운로드에는 인터넷이 필요합니다. 오프라인 동작은 테스트하지 않았습니다.
삭제해당 없음테스트하지 않았습니다.
점수는 아래 증거에서 도출한 제안값입니다(1 = 나쁨, 5 = 매우 좋음). 확정은 테스터의 몫입니다. 테스터의 목표였던 이미지 생성은 이 기기에서 이미지가 만들어지지 않았으므로 낮게 평가됩니다.
테스트 상세 정보
앱
Unsloth 데스크톱 앱(Unsloth Studio). 메모에는 'Unsloth', 'Unslothh', 'Onslaught'로 적혀 있으며, 이 보고서는 'Unsloth'로 통일합니다. 관찰
버전
설정 로그: 'unsloth 2026.8.18 -> 2026.10.3 available, updating'. 업데이트 후 사용한 버전은 2026.10.3으로 가정합니다. 창에는 BETA 표시가 붙어 있습니다. 데스크톱 앱 자체의 버전은 기록되지 않았습니다. 가정
테스터
Hans Kuepper, PromptQuorum 설립자
시작
2026년 10월 9일 오후 1시(메모 기준). 스크린샷 한 장에 오후 5:13이 찍혀 있어, 테스트는 최소 네 시간 진행되었습니다. 관찰
종료
기록되지 않음
하드웨어
24 GB Mac. 메모에는 'macOS M3 24 GB'와 이후 'M3 24 GB Pro MacBook'이라고 적혀 있습니다. 앱의 Model hub에는 '24 GiB RAM', '0 GiB VRAM + 24 GiB shared', '12/12 CPU'가 표시됩니다. 정확한 칩은 기록되지 않았습니다. 관찰
시스템
macOS. 버전은 기록 없음
설치 상태
새로 설치한 상태가 아닙니다. 설정 로그에 'Updating existing Unsloth install'과 'existing install detected'가 나오고, 테스터도 '이전과 같다'고 말합니다. 이전에 써 본 적이 있어서 LM Studio와 Ollama의 모델을 이미 알아봤을 수 있습니다. 관찰
다운로드
24 MB DMG(테스터가 읽은 값). 첫 실행 때 의존성 설치 단계가 진행되었습니다(1장 참조). 관찰
테스트 이유
Unsloth가 어떻게 동작하는지, 특히 '이미지 기능'을 보기 위해서입니다. 테스터는 모델 최적화(학습)를 쓸 계획은 없었습니다.
목표
24 GB Mac에서 이미지를 로컬로 생성하기. 그 과정에서 채팅과 모델 허브도 써 보았습니다. 관찰
사용한 AI 도움
메모에는 수백 단어 분량의 뉴욕 스카이라인 프롬프트가 있으며, Markdown 굵은 글씨 표시로 보아 AI가 쓴 것으로 보입니다. 확인되지는 않았습니다. 채팅 모델의 답변(예: 모델을 어디서 가져왔는지)은 여기서 근거로 삼지 않았습니다. 가정
모든 진술에는 라벨이 붙습니다:관찰측정테스터 추정개발사 주장제3자 출처가정테스터 의견테스터 오류라벨의 의미
공개 사항. 테스터는 로컬 AI 앱을 다루는 콘텐츠 사이트 겸 디렉터리인 PromptQuorum(promptquorum.com)을 창립했습니다. Unsloth는 그 디렉터리에 등록되어 있고, 사이트에는 따로 작성된 기존 리뷰 페이지가 있습니다. 메모에는 공급자와의 접촉, 대가 지급, 후원에 대한 기록이 없습니다.
모든 게 동작합니다. 다만 최종 결과, 즉 제가 그걸 동작하게 만들지 못했다는 것만 빼고요.
테스터 노트이며, 음성 받아쓰기 내용을 가볍게 다듬었습니다.
테스트는 이렇게 진행되었습니다
다운로드, 설정, 첫 실행
관찰
설치 파일은 24 MB의 DMG이며, 테스터는 이를 '내가 본 가장 작은 파일'이라고 읽었습니다.
관찰
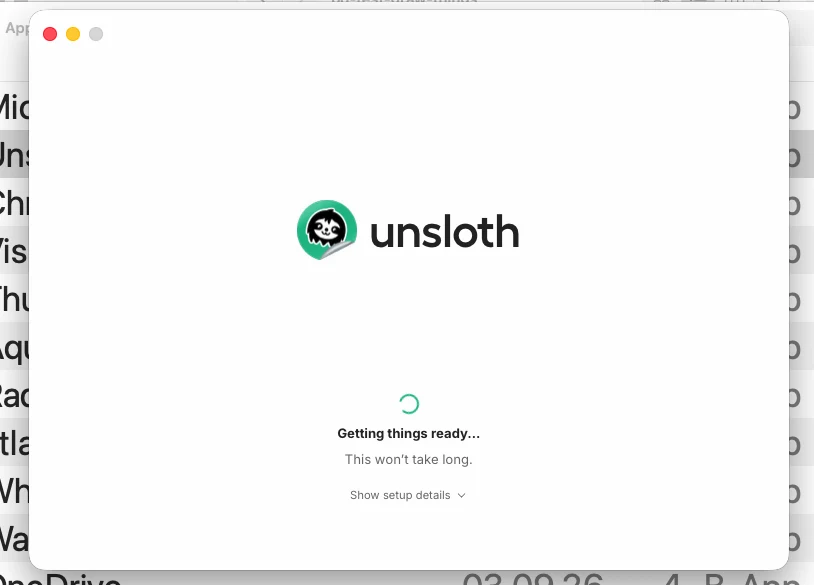
첫 창: 'Getting things ready... This won't take long.'과 'Show setup details' 링크. 테스터: '다른 앱들보다 훨씬 세련돼 보이네요... 명확한 안내입니다.'
그림 224 MB DMG 앱을 연 뒤 처음 나오는 창. 오래 걸리지 않는다고 안내하지만, 테스터는 시간을 재지 않았고 4~5분으로 추정합니다(업데이트 로그는 본문에 있음). 소요 시간이나 디스크 용량 안내는 없습니다.
관찰
상세 로그에는 'Updating existing Unsloth install', 'frontend bundled (Tauri)', 'node v24.13.0 | npm 11.6.2 (system)', 'unsloth 2026.8.18 -> 2026.10.3 available, updating'이 나오고, 이어서 13단계 의존성 진행 막대(pip bootstrap, Apple Silicon용 MLX stack, base packages, unsloth extras, codecs, overrides, studio deps, data designer, local plugin, diffusers pin, finalizing)가 표시됩니다. 참고: 'torch 2.10.0 detected -- installing torchao==0.16.0', 'transformers 5.3.0, 5.5.0, 5.10.2 pre-installed', 'gpu Apple Silicon (Metal, unified memory)', 'installing prebuilt llama.cpp'.
관찰
테스터는 약 4~5분 동안 진행된 뒤 앱이 열렸다고 말합니다. 로그에는 소요 시간 안내도 디스크 용량 안내도 없습니다.
테스터 추정
설정에 4~5분 걸렸다는 추정입니다. 시간을 재지는 않았습니다.
가정
용량이 작은 DMG는 이 첫 단계에서 소프트웨어 대부분을 내려받는 것으로 보입니다. 확인하지 않았습니다.
테스터 의견
'무엇을 하는지 자세히 알려 주는 건 좋은데, 예상 시간이나 용량, 디스크를 얼마나 차지하는지는 전혀 알려 주지 않는다.'
관찰
메인 창은 'How can I help?'와 사이드바(New chat, Model hub, Library, Images, Train, More)와 함께 열립니다. 로고에 BETA 표시가 붙어 있습니다.
그림 3설정이 끝난 뒤의 메인 창. 사이드바: New chat, Model hub, Library, Images, Train, More. 로고에 BETA 표시가 있습니다. 창 뒤의 브라우저 탭에는 이 프로젝트의 GitHub 페이지가 보입니다.
테스터 오류
기존 설치에서 시작했으므로('이전과 같다') 처음 실행하는 테스트가 아니라 업데이트입니다. 온보딩에 대한 결론은 새로 설치해서 확인해야 합니다.
모델 선택기와 첫 채팅
관찰
모델 선택기는 Recommended 모델을 27.3B, 271.0M 같은 수치와 함께 나열합니다. 이는 기가바이트가 아니라 파라미터 수입니다. 두 항목(176.9B, 320.8B)은 회색으로 비활성화되어 있습니다.
그림 4모델 선택기, Recommended 탭. 수치는 기가바이트가 아니라 파라미터 수입니다(B = 십억, M = 백만). 두 항목은 회색입니다(Qwen3.8-Flash-Next-GGUF 176.9B, GLM-5.3-Flash-GGUF 320.8B). 회색과 노란 점의 의미는 캡처한 앱 화면에 나와 있지 않습니다.
가정
회색 항목은 이 기기에는 너무 큰 모델인 것으로 보입니다. 캡처한 앱 화면에는 그런 설명이 없습니다.
테스터 의견
'크기와 함께 모델이 많이 나열되어 있었다. 아주 좋다.' 표시된 수치는 파라미터 수이므로, 모델에 메모리가 얼마나 필요한지는 알려 주지 않습니다.
관찰
모델을 고르는 대신 테스터는 계산을 요청하는 문장을 입력했습니다. 앱이 스스로 모델을 불러오기 시작했습니다. 메모에 따르면 Qwen3.8-27B MLX 4-bit 모델이 1분도 안 되어 시작되었고, 두 번째 토스트에는 Mistral-7B-Instruct-v0.3-4bit 로딩이 표시되었습니다(스크린샷은 제외, 그림 5와 같은 유형).
관찰
로딩 토스트에는 /Users/hanskuepper/.lmstudio/models/lmstudio-community/Qwen3.8-27B-MLX-4bit 경로가 나옵니다. 모델은 디스크의 LM Studio 폴더에서 읽혔습니다.
그림 5첫 채팅이 시작될 때 나온 토스트. 경로는 LM Studio의 모델 폴더를 가리킵니다: /Users/hanskuepper/.lmstudio/models/lmstudio-community/Qwen3.8-27B-MLX-4bit. 모델은 내려받은 것이 아니라 디스크에서 불러왔습니다.
테스터 의견
그는 하드 드라이브에서 가져온 것 같다고 의심했는데, '그렇게 큰 모델이 1분 만에 인터넷으로 오지는 않기' 때문입니다. 경로가 이를 뒷받침합니다. Unsloth가 왜 이 모델과 Mistral 모델을 골랐는지는 기록되지 않았습니다.
관찰
'what is 5 times 866'이라는 질문에 '5 x 866 = 4,330'(정답)이라고 'Worked for 10s' 뒤에 11.0 tok/s로 답했습니다. 헤더에는 'Local'과 컨텍스트 미터 '120 / 262.1k'가 표시됩니다.
그림 6첫 채팅. 답 4,330은 정답입니다(5 x 866). 화면에는 'Worked for 10s', 11.0 tok/s, 컨텍스트 미터 '120 / 262.1k'가 표시됩니다.
관찰
이어서 테스터는 모델에게 그 모델을 어디서 가져왔는지 물었습니다. 캡처된 답변 일부는 MLX 가중치와 Apple Silicon 통합 메모리를 다루며, 전체 답변은 캡처되지 않았습니다. 메모에 따르면 답은 앱이 드라이브를 검색하지 않는다는 내용이었습니다.
가정
채팅 모델이 말하는 앱 설명은 믿을 만한 증거가 아닙니다. 한 답변은 모델을 'Qwen 3 27B MLX 4-bit'라고 부르지만, 앱에서는 Qwen3.8-27B-MLX-4bit로 표시됩니다.
디스크에 이미 있는 모델: LM Studio와 Ollama
관찰
On Device 탭은 모델을 출처별로 나열합니다. CUSTOM FOLDERS 아래에 경로 두 개(.lmstudio/models와 .ollama/models)가 있고 Ollama 모델 gemma4:latest, gemma3:1b, qwen3-coder:30b가 보입니다. LM STUDIO 아래에서는 Qwen3.8-27B 모델에 'Loaded' 표시가 있습니다.
그림 7On Device 탭. CUSTOM FOLDERS 아래에 경로 두 개(.lmstudio/models와 .ollama/models)와 Ollama 모델 gemma4:latest, gemma3:1b, qwen3-coder:30b가 있고, LM STUDIO 아래에서는 Qwen3.8-27B 모델에 'Loaded' 표시가 있습니다. 목록 뒤로 일부 보이는 채팅 답변은 MLX 가중치를 다룹니다. 폴더를 테스터가 추가했는지, 자동으로 찾았는지는 기록되지 않았습니다.
가정
테스터가 두 폴더를 추가했는지, 앱이 스스로 찾았는지는 기록되지 않았습니다. 이전에 앱을 쓰면서 설정되어 있었을 수 있습니다.
관찰
qwen3-coder:30b(30.5B, Q4_K_M, GGUF)로 전환하면 'Starting model... Switching models. Loading cached model into memory.'와 Cancel 버튼이 나타납니다. 컨텍스트 미터는 '1.3k / 8.2k'로, 첫 모델의 262.1k보다 훨씬 작습니다.
그림 8Ollama 모델 qwen3-coder:30b(30.5B, Q4_K_M, GGUF)로 전환. 컨텍스트 미터 '1.3k / 8.2k'. 토스트에는 'Starting model... Switching models. Loading cached model into memory.'와 Cancel 버튼이 표시됩니다.
테스터 의견
'모델을 바꾸기 쉬워서 좋다.' '일부 Ollama 모델은 Unsloth 안에서 동작하지 않지만, 시도해 준 것만으로도 훌륭하다.'
관찰
메모에 따르면 이전 모델은 동작했고 더 새로운 모델은 비정상 종료되었습니다. 어떤 모델을 말하는지는 기록되지 않았습니다.
테스터 의견
그는 자신의 Ollama 모델을 쓰려고 '시도해 준' 것이 훌륭하고, 디스크에 있는 모델을 읽으면 또 큰 다운로드를 피할 수 있다고 말합니다.
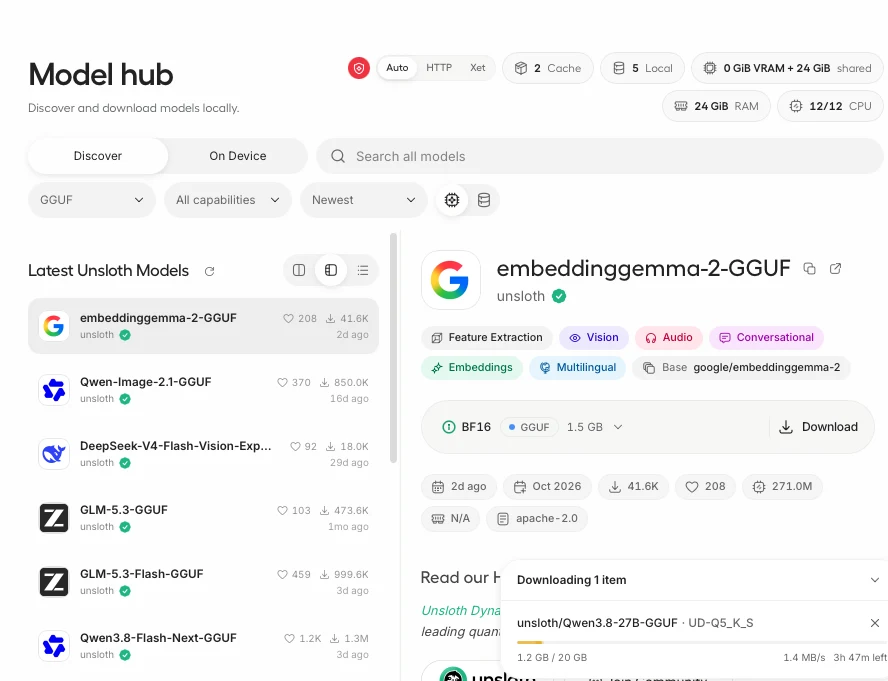
그림 9모델 허브. 오른쪽 위: '0 GiB VRAM + 24 GiB shared', '24 GiB RAM', '12/12 CPU'. 다운로드 패널: unsloth/Qwen3.8-27B-GGUF UD-Q5_K_S, 20 GB 중 1.2 GB, 1.4 MB/s, 3 h 47 m 남음. 열려 있는 모델 카드 embeddinggemma-2-GGUF(1.5 GB, apache-2.0)는 다운로드 중인 모델이 아닙니다.
테스터 의견
'네, 훌륭한 모델 허브입니다.' 허브에는 Qwen-Image-2.1-GGUF(다운로드 850.0K, 16일 전), GLM-5.3-GGUF, Qwen3.8-Flash-Next-GGUF 등이 나옵니다.
관찰
메모에 따르면 Mac에 너무 큰 파일을 클릭하자 여러 경고('이 파일은 총 30~40 기가바이트입니다')가 나왔지만 다운로드는 여전히 허용됩니다. 스크린샷은 없습니다.
측정
unsloth/Qwen3.8-27B-GGUF UD-Q5_K_S의 다운로드 패널에는 20 GB 중 1.2 GB, 1.4 MB/s, 3 h 47 m 남음이 표시되고, 나중에는 20 GB 중 7.1 GB, 983 KB/s, 3 h 31 m 남음이 표시됩니다.
그림 10나중의 같은 다운로드: 20 GB 중 7.1 GB, 983 KB/s, 3 h 31 m 남음. 이 스크린샷과 이전 스크린샷 사이의 시간은 기록되지 않았습니다.
테스터 의견
'이 앱의 전문성이 눈에 보입니다. 타이머가 붙어 있고, 다운로드 속도도 알려 줍니다.'
가정
속도로 보아 테스트 장소의 회선이 느린 것 같지만, 테스터는 그렇게 말하지 않았습니다. 다운로드가 끝났는지는 기록되지 않았습니다.
측정
Z-Image(BF16) 대화 상자에는 모델 파일 12.3 GB와 필수 인코더·디코더 8.2 GB, 합계 20.5 GB가 나옵니다. 테스터가 다른 곳에서 언급한 '모델의 기가바이트와 그 밖의 무언가 사이의 차이'가 이것으로 설명됩니다.
그림 19Z-Image(BF16) 다운로드 대화 상자: 모델 파일 12.3 GB, 'Include required files' 8.2 GB(인코더와 디코더, 호환되는 변형끼리 공유), 합계 20.5 GB. 'Downloading will not load this model or switch your current model.'
테스터 의견
메모에는 '이미지 LLM을 내려받았다'고 적혀 있습니다. 어느 것인지는 기록되지 않았으며, 스크린샷에는 기기에 있는 이미지 모델 FLUX.2-klein-4B와 그 GGUF 변형이 보입니다(그림 18).
웹 검색, 음성, 그리고 오류
관찰
테스터는 PromptQuorum 페이지 URL을 붙여 넣고 'from a seo perspective will this help me?'라고 물었습니다. 채팅에는 'Using tool: Reading promptquorum.com'과 'Waiting for approval: web_search', 그리고 Allow, Always allow, Deny 버튼이 표시됩니다. 시각 오후 5:13, 컨텍스트 '648 / 34.4k'.
그림 11Qwen3.8-27B-MLX-4bit와의 채팅, 컨텍스트 '648 / 34.4k', 시각 오후 5:13. 프롬프트에는 PromptQuorum URL이 있고 SEO에 대해 묻습니다. 앱은 'Waiting for approval: web_search'와 Allow, Always allow, Deny 버튼을 보여 줍니다. 모드는 'Approve for me'입니다.
관찰
메모에 따르면 첫 시도에서는 페이지를 읽을 수 없다고 했고, Search 기능을 클릭하자 두 번째에는 동작했습니다. '첫 번째에 경고가 있었어야 할지도 모른다.'
가정
첫 실패는 웹 검색 승인이 없었거나 Search 토글이 꺼져 있었기 때문일 수 있습니다. 확인하지 않았습니다.
관찰
실행은 168.10 s 뒤 'Ran out of memory. Try a smaller model or shorter input.'로 끝났고, Retry 버튼이 표시되었습니다.
그림 12같은 채팅이 168.10 s 뒤 'Ran out of memory. Try a smaller model or shorter input.'로 끝납니다.
관찰
음성 입력이 내장되어 있습니다. 사용하려면 'Qwen3-ASR 0.6B' 음성 모델(약 1.0 GB)을 내려받아야 하며, Hugging Face 캐시에 한 번만 받는다고 안내합니다. 테스터가 내려받았는지는 기록되지 않았습니다.
그림 13음성 입력: 'Local dictation runs entirely offline, but it needs the Qwen3-ASR 0.6B speech model first. About 1.0 GB, fetched once into your Hugging Face cache.' 테스터가 내려받았는지는 기록되지 않았습니다.
관찰
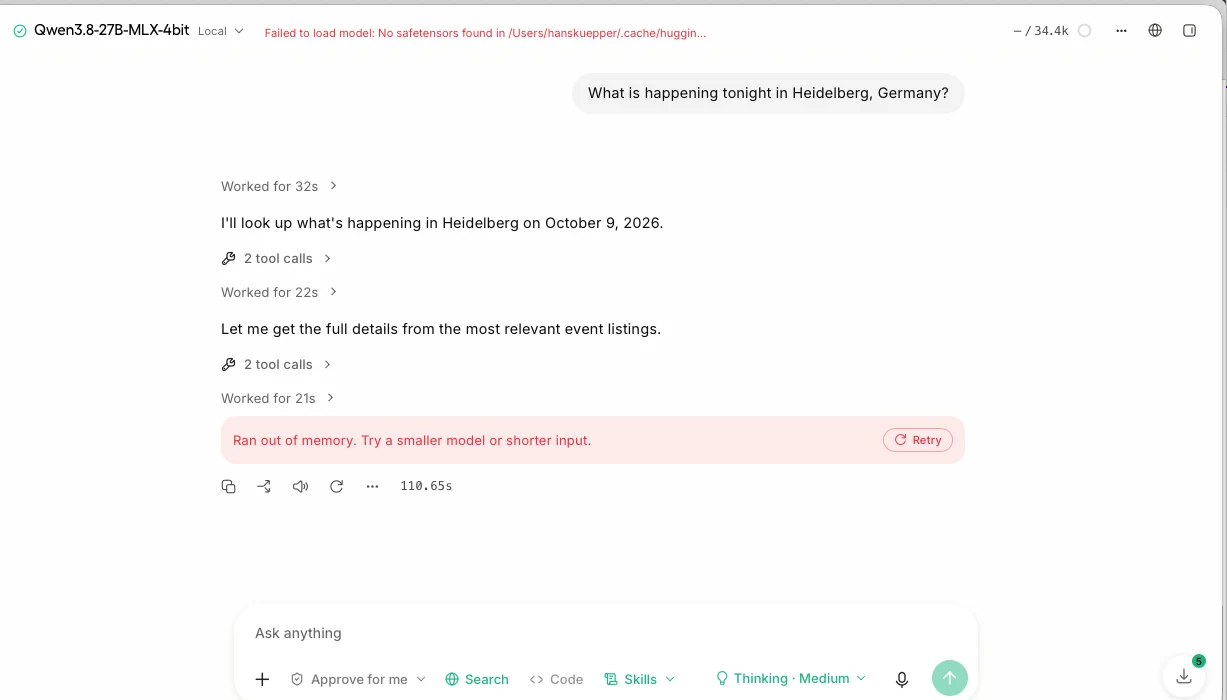
지역 행사 검색('What is happening tonight in Heidelberg, Germany?')은 도구 호출을 두 차례 실행한 뒤 110.65 s 후 'Ran out of memory'로 끝났습니다. 헤더에는 빨간 안내 'Failed to load model: No safetensors found in /Users/.../.cache/huggin...'가 표시됩니다.
그림 14지역 행사 검색. 헤더(빨간색): 'Failed to load model: No safetensors found in /Users/.../.cache/huggin...'. 채팅에는 'tool calls'가 두 차례 나온 뒤 110.65 s 후 'Ran out of memory. Try a smaller model or shorter input.'가 표시됩니다. 컨텍스트 '- / 34.4k'. 다운로드 배지에는 5가 표시됩니다.
가정
로드 오류와 메모리 부족 메시지는 서로 관련이 있을 수 있습니다(메모리가 부족한 상태에서 모델이 교체되는 경우). 스크린샷에는 그 연관성이 나타나지 않습니다.
테스터 의견
'하지만 그렇죠, 로컬 AI는 늘 문제가 좀 있어요.'
이미지 모델: 메모리 부족으로 거부됨
관찰
테스터의 목표는 이미지였습니다. 사이드바에는 'Images' 항목이 있습니다. 메모에는 구도와 제외 목록이 딸린 긴 뉴욕 스카이라인 프롬프트(브루클린 전망, 브루클린 브리지, 골든 아워, 8K 디테일)가 있습니다. 그 결과나 오류, 설정은 기록되지 않았습니다.
측정
이미지 모델 flux.2-klein 로드가 거부되었습니다. 'needs about 17 GB of memory for its weights, but only about 2 GB is usable on this device (of the 7 GB currently free, after reserving room for the operating system)'. 또한 Mac은 메모리 풀이 하나뿐이라 CPU로 오프로드해도 확보되는 것이 없다고 설명하고, 더 작은 모델, 더 낮은 양자화, 다른 앱 종료를 권합니다. 우회 방법으로 UNSLOTH_DIFFUSION_ALLOW_OVERSIZED_LOAD=1을 알려 줍니다.
그림 1이미지 모델 flux.2-klein 로드 거부. 앱은 약 17 GB 필요, 사용 가능 약 2 GB(현재 여유 7 GB에서 운영체제 몫을 뺀 값)라고 알립니다. 우회 변수 UNSLOTH_DIFFUSION_ALLOW_OVERSIZED_LOAD=1도 알려 주는데, 시도하지 않았습니다.
측정
깨끗하게 재부팅한 뒤의 메시지는 약 17 GB 필요, 사용 가능 약 6 GB, 현재 여유 11 GB입니다.
그림 15flux.2-klein의 두 번째 거부: 약 17 GB 필요, 사용 가능 약 6 GB(현재 여유 11 GB). 메모의 순서에 따라 깨끗하게 재부팅한 뒤에 찍힌 것으로 읽었습니다.
가정
두 메시지는 두 쌍 모두 5 GB 차이가 나므로(7 - 2, 11 - 6) 앱은 운영체제용으로 약 5 GB를 남겨 두는 것으로 보입니다. 데이터는 두 건뿐입니다.
관찰
기기 목록에는 FLUX.2-klein-4B-GGUF(7.8 GB), FLUX.2-klein-4B(16 GB), mistral-7b-v0.3-bnb-4bit(4.1 GB)가 보입니다. 테스터: 'This should be small enough.' 테스터는 허브에서 가장 작은 이미지 모델도 24 GB 기기를 비정상 종료시킨다고 하며, 클릭한 모델마다 '7 기가바이트'만 쓸 수 있어 너무 크다고 나왔다고 말합니다.
그림 18UNSLOTH 아래 기기에 있는 모델: FLUX.2-klein-4B-GGUF(BF16, 이미지 아이콘, 4B, 7.8 GB), FLUX.2-klein-4B(이미지 아이콘, 4B, 16 GB), mistral-7b-v0.3-bnb-4bit(7B, 4.1 GB).
테스터 오류
테스터는 왜 7 기가바이트만 쓸 수 있는지 의아해합니다('훨씬 더 많이 있는데'). 대화 상자에는 그 순간 7 GB가 비어 있었고 다른 앱이 실행 중이었다고 나오며, 재부팅 후에는 11 GB로 나옵니다. 메모는 '7 GB' 발언을 Z-Image 대화 상자 옆에 두었지만, 7 GB라는 수치는 flux.2-klein 메시지에 있습니다.
테스터 의견
'길을 잃었어요... 24 기가바이트 기기가 있는데, 저를 도와 일을 해 줄 수 있는 LLM을 찾을 수가 없어요.' 그는 24 GB가 독자의 80퍼센트 넘게 가진 사양이라고 생각합니다(그의 추정이며 측정값이 아닙니다).
테스터 추정
'독자의 80% 넘게'가 24 GB 이하를 쓴다고 합니다. 출처는 제시되지 않았습니다.
Mac의 메모리
관찰
테스터는 로컬 모델과 일상 작업이 같은 메모리를 놓고 경쟁하며, Chrome과 다른 앱이 5~8 GB를 차지한다고 결론짓습니다. 그는 내내 'VRAM'이라고 썼지만, 허브가 보여 주듯('0 GiB VRAM + 24 GiB shared') Apple Silicon은 메모리 풀이 하나입니다.
측정
Activity Monitor 캡처 한 장: 사용한 메모리 12.92 GB, 캐시된 파일 10.95 GB, 앱 메모리 9.81 GB, 와이어드 1.83 GB, 스왑 0.
그림 16길고 평평한 이력 그래프가 있는 메모리 패널. 사용한 메모리 12.92 GB, 캐시된 파일 10.95 GB, 앱 메모리 9.81 GB, 와이어드 1.83 GB, 사용한 스왑 0바이트. 캡처 시점과 열려 있던 앱은 기록되지 않았습니다.
측정
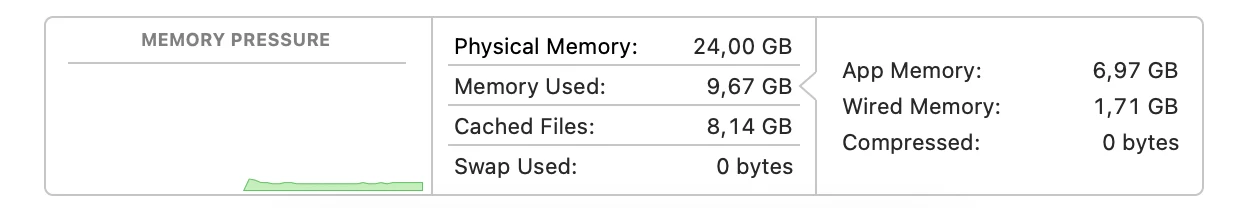
Activity Monitor의 다른 캡처: 사용한 메모리 9.67 GB, 캐시된 파일 8.14 GB, 앱 메모리 6.97 GB, 와이어드 1.71 GB, 스왑 0. 짧은 이력 그래프는 최근에 시작했다는 것과 맞습니다.
그림 17그래프 뒤쪽에서 시작하는 짧은 이력이 있는 메모리 패널. 사용한 메모리 9.67 GB, 캐시된 파일 8.14 GB, 앱 메모리 6.97 GB, 와이어드 1.71 GB, 스왑 0. 메모의 '시작 시 10 GB' 발언과 일치하며, 어느 시점인지는 기록되지 않았습니다.
가정
그림 15의 '현재 여유' 11 GB는 그림 16의 24.00 - 12.92 = 11.08 GB와 일치합니다. 두 캡처가 같은 시점에 찍혔는지는 기록되지 않았습니다.
테스터 의견
'재부팅한 뒤에도 일반적인 용도로 이미 9 기가바이트가 사라졌어요.' '컴퓨터를 끄고, 재부팅하고, 모든 프로세스를 멈추거나... 아니면 LLM을 돌릴 수 없는 거죠.'
테스터 의견
가능한 답은 두 가지입니다. 모델이 더 작고 좋아지거나, 컴퓨터에 48 또는 64 GB가 필요하다는 것입니다. '당신의 컴퓨터에서 된다는 이런 이야기는 전부 좀 가짜예요.'
가정
48 또는 64 GB면 '확실히' 해결된다는 것은 테스트하지 않았습니다.
피드백 없는 로딩, 그리고 마무리 의견
관찰
모델을 시작하면 'Starting model... Loading cached model into memory.' 토스트가 스피너와 Cancel 버튼과 함께 나타납니다. 퍼센트, 크기, 시간 표시는 없습니다.
그림 20모델 시작. 토스트에는 스피너와 'Loading cached model into memory.'가 표시됩니다. 퍼센트, 크기, 시간 표시는 없습니다. 테스터는 2~3분 넘게 걸렸다고 말합니다(추정).
테스터 추정
대기 시간은 2~3분을 넘었습니다(시간을 재지는 않았습니다).
테스터 의견
'고객을 대하는 가장 나쁜 방식은 일을 해 놓고 고객에게 알려 주지 않는 것입니다.' 테스터는 이것을 사용자 인터페이스 문제라고 부릅니다.
관찰
헤더의 미터는 컨텍스트 대비 사용한 토큰 수(예: '648 / 34.4k')와 초당 토큰 수(11.0 tok/s)를 보여 줍니다.
테스터 오류
메모에는 '토큰 카운터 없음'이라고 적혀 있습니다. 스크린샷에는 컨텍스트 미터와 초당 토큰 수가 보입니다. 그가 말한 것은 메시지별 토큰 수일 수 있습니다(가정).
테스터 오류
메모는 로컬 채팅 모델을 '인터넷을 조사하지 못하기' 때문에 '가장 멍청한 아이디어'라고 부릅니다. 같은 메모와 스크린샷에는 Search 기능, 웹 검색 승인 안내, 페이지를 읽는 도구 호출이 나옵니다.
테스터 의견
그는 모델을 학습시키고 싶지 않고, 채팅 기능은 별로 쓸모가 없으며, 이미지와 영상 도구를 원하는데 '아직 보이지 않는다'고 말합니다. 학습과 'Train' 탭은 시도하지 않았습니다.
테스터 의견
'어쩌면 제 쪽 문제일 수도 있지만, 아니요, 저에게는 아닙니다. 3개월이나 6개월 뒤에 다시 확인해 보겠지만, 지금은 M3 24 GB Pro MacBook에서는 아닙니다.'
주장과 테스터가 확인한 내용
주장
입수처
관찰
라벨
'Run and train image and video diffusion or multimodal models'를 로컬에서(GitHub README, 문서 페이지)
공급자, 2026년 10월 16일 확인
이미지는 생성되지 않았습니다. flux.2-klein은 거부되었습니다(약 17 GB 필요, 사용 가능 2 GB와 6 GB). 더 작은 이미지 변형이 로드되는지는 확인하지 못했습니다. 학습은 시도하지 않았습니다.
관찰
macOS에서 'Training, MLX and GGUF inference all work inside of Unsloth'(문서)
확인한 GitHub 페이지와 문서 페이지 모두, 반환된 본문에는 메모리 요구 사항이 적혀 있지 않았습니다. 앱은 로드 시점에 자체적으로 필요량을 알려 줍니다(flux.2-klein은 17 GB).
관찰
24 GB에 들어갈까요?
24 GB 메모리
거부 메시지에 따른 flux.2-klein 가중치약 17 GB 필요 24 GB 미만측정
FLUX.2-klein-4B(기기 목록)파일 크기 16 GB 24 GB 미만측정
FLUX.2-klein-4B-GGUF(기기 목록)파일 크기 7.8 GB 24 GB 미만측정
앱 기준 사용 가능량, 재부팅 전여유 7 GB 중 약 2 GB 24 GB 미만측정
앱 기준 사용 가능량, 재부팅 후여유 11 GB 중 약 6 GB 24 GB 미만측정
Mac 메모리 사용량, Activity Monitor(첫 번째 캡처)12.92 GB 사용 24 GB 미만측정
Mac 메모리 사용량, Activity Monitor(두 번째 캡처)9.67 GB 사용 24 GB 미만측정
Z-Image BF16 전체 다운로드모델 12.3 GB + 필수 파일 8.2 GB(다운로드 크기) 24 GB 미만측정
2, 3, 8행은 파일 또는 다운로드 크기이며 실행 시 메모리 사용량이 아닙니다. 17 GB는 flux.2-klein에 대한 앱 자체의 추정치이며, 어느 파일 변형을 가리키는지는 기록되지 않았습니다. '사용 가능'은 앱이 운영체제용 공간을 따로 남기고 계산한 값입니다. Qwen3.8-27B MLX 4-bit 모델은 채팅에서 실행되었지만 메모리 사용량은 읽지 못했습니다.
테스터는 인터페이스가 아름답고 부드럽다고 평가하지만, 결과에 이르지 못했고 지금 이 앱을 쓸 이유는 없다고 본다.
종합
테스터 의견
보통
-
UN-26
디렉터리에는 라이선스가 Apache-2.0으로 올라 있지만, GitHub 페이지에는 Studio UI는 AGPL-3.0, 코어는 Apache-2.0이라고 나와 있다.
유지보수
제3자 출처
보통
-
심각도는 처음 쓰는 사용자에게 미치는 영향입니다. 제안값이며 측정한 값이 아닙니다.
추천 대상
적합할 가능성이 높음
가정24 GB보다 메모리가 많거나, 열어 둔 앱이 적은 깨끗한 기기에서 채팅, 모델 허브, LM Studio와 Ollama의 로컬 모델을 하나의 앱에서 쓰고 싶은 사람.
개발사 주장모델을 학습하거나 파인튜닝하고 싶은 사람. 공급자에 따르면 이것이 프로젝트의 주된 목적입니다(여기서는 테스트하지 않음).
적합하지 않을 가능성이 높음
테스터 의견다른 앱을 연 채 24 GB Mac에서 이미지를 로컬로 생성하고 싶은 사람. 테스터에게는 동작하지 않았습니다.
테스터 의견모델, 메모리, 학습에 대해 배우지 않고 빠르게 결과를 얻고 싶은 사람.
재테스트. 테스터는 3~6개월 뒤(2027년 1~4월경) 다시 확인할 계획입니다. 그 전에 데스크톱 앱 버전, macOS 버전, 칩을 기록하고, 새로 설치한 상태에서 시작하며, 다른 앱을 닫고 여유 메모리를 적어 두고, 들어가는 이미지 모델(예: 7.8 GB GGUF)을 시도해 설정과 결과를 각각 기록하고, 학습, 오프라인 사용, 삭제를 테스트하세요.
고객을 대하는 가장 나쁜 방식은 일을 해 놓고 고객에게 알려 주지 않는 것입니다.
테스터 노트이며, 음성 받아쓰기 내용을 가볍게 다듬었습니다.
자주 묻는 질문
24 GB Mac에서 Unsloth로 이미지를 생성할 수 있나요?
이 테스트에서는 못 했습니다. 이미지 모델 flux.2-klein 로드는 두 번 거부되었습니다. 처음에는 약 17 GB가 필요한데 사용 가능은 약 2 GB(여유 7 GB)였고, 재부팅 후에는 사용 가능 약 6 GB(여유 11 GB)였습니다. 이미지는 생성되지 않았습니다. 측정
Unsloth는 LM Studio나 Ollama에 이미 있는 모델을 찾아 주나요?
이 테스트에서는 그랬습니다. 첫 채팅은 다운로드 없이 LM Studio의 모델 폴더에서 Qwen3.8-27B 4-bit 모델을 불러왔고, On Device 목록에는 gemma4:latest, qwen3-coder:30b 같은 Ollama 모델이 보였습니다. 일부 Ollama 모델은 동작하지 않았으며, 어느 모델인지는 기록되지 않았습니다. 관찰
24 GB Mac에서 Unsloth 채팅은 얼마나 빠른가요?
27B 4-bit 모델이 'what is 5 times 866'(4,330, 정답)에 11.0 tok/s로 10초 만에 답했습니다. 같은 모델로 웹 페이지를 읽거나 행사를 검색하는 작업은 다른 앱을 열어 둔 상태에서 'Ran out of memory'로 끝났습니다. 측정
Unsloth 설치 파일은 얼마나 크고, 설정에는 얼마나 걸리나요?
DMG는 24 MB입니다. 첫 실행에서는 13단계 의존성 업데이트가 진행되었고 테스터는 4~5분으로 추정합니다. 창에는 소요 시간이나 디스크 용량 안내가 없습니다. 테스트는 새 설치가 아니라 기존 설치에서 시작했습니다. 관찰
Unsloth를 완전히 오프라인으로 쓸 수 있나요?
공급자 문서는 100퍼센트 오프라인과 로컬에서 쓸 수 있다고 밝힙니다. 오프라인 사용은 테스트하지 않았으며, 웹 검색과 모델 다운로드에는 인터넷이 사용되었습니다. 개발사 주장
개발사 배경
직접 사용 테스트가 아닙니다. 아래 항목은 공급자의 GitHub 페이지, 문서, 릴리스 페이지와 PromptQuorum 디렉터리에서 가져온 것으로, 페이지를 요약하는 웹 가져오기 도구로 2026년 10월 16일에 읽었으며 독자적으로 검증하지 않았습니다.
개발사 주장GitHub 페이지는 Unsloth를 'first desktop app to run and train models', 'Local UI to run and train LLMs and diffusion models'라고 소개합니다. Unsloth Studio(웹 UI)와 Unsloth Core(코드)를 제공합니다. 확인한 페이지에는 회사나 개인의 이름이 나와 있지 않았습니다.
개발사 주장라이선스: 코어 패키지는 Apache 2.0, 'certain optional components, such as the Unsloth Studio UI'는 AGPL-3.0입니다.
개발사 주장플랫폼: Windows, Linux, WSL, macOS. 설치 방법: 데스크톱 앱(macOS는 .dmg), 셸 스크립트, Homebrew, Docker. 반환된 본문에는 하드웨어 요구 사항이 적혀 있지 않았습니다.
개발사 주장Studio 문서: GGUF, MLX, diffusion 이미지·영상 모델을 로컬에서 실행하고, macOS에서 'Training, MLX and GGUF inference all work inside of Unsloth'이며, 웹 검색은 'visits pages directly', 'can be used 100% offline'이라고 합니다.
제3자 출처PromptQuorum 디렉터리는 Unsloth를 무료, Apache-2.0, Mac·Windows·Linux 지원, 파인튜닝 및 LoRA 카테고리, GitHub 별 약 76,100개로 올려 두었습니다(데이터 확인 2026년 9월 13일). 릴리스 v0.1.905-beta의 macOS DMG(2026년 10월 9일 확인)와 2026년 10월 16일의 마지막 업스트림 업데이트도 기록되어 있습니다. PromptQuorum은 이 보고서 이전에는 직접 사용 테스트를 하지 않았습니다.
가정2026년 10월 16일에 읽은 릴리스 페이지는 v0.1.806-beta(9월 2일)를 최신으로 반환했는데, 디렉터리의 v0.1.905-beta와 다릅니다. 요약 도구가 오래된 페이지를 읽었을 수 있습니다. 설정 로그의 Python 패키지 버전(2026.10.3)은 데스크톱 앱 태그와 번호 체계가 다릅니다.