Teste prático do PromptQuorum · Unsloth · 9 de outubro de 2026
Unsloth em um Mac de 24 GB: app polido, sem memória antes da primeira imagem
Teste prático em um Mac de 24 GB, voltado à geração de imagens. O chat funcionou; os modelos de imagem foram recusados por falta de memória e nenhuma imagem foi gerada.
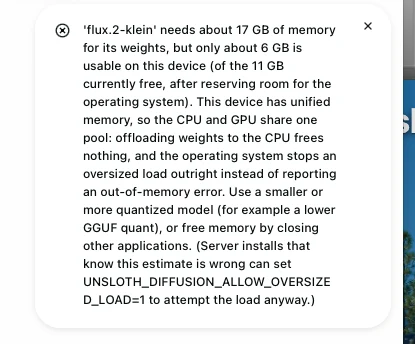
Figura 1Recusa ao carregar o modelo de imagem flux.2-klein. O app informa cerca de 17 GB necessários, cerca de 2 GB utilizáveis (7 GB atualmente livres, menos o espaço do sistema operacional). Ele cita uma variável para contornar, UNSLOTH_DIFFUSION_ALLOW_OVERSIZED_LOAD=1, que não foi testada.
Veredito
Avaliação geral
O app parece e funciona de forma polida: um instalador de 24 MB, uma janela de instalação que mostra o que faz, um hub de modelos com leitura do hardware, avisos de tamanho e cronômetro de download, e um chat que encontra modelos já presentes no disco vindos do LM Studio e do Ollama. Um cálculo rodou a 11,0 tokens por segundo em um modelo de 27B. O objetivo do teste, uma imagem, não foi alcançado. Os modelos de imagem foram recusados porque o app contou apenas 2 GB (antes de uma reinicialização) e 6 GB (depois) como utilizáveis, contra cerca de 17 GB necessários; a busca na web e uma busca de eventos terminaram em 'Ran out of memory'; e a inicialização de um modelo ficou minutos sem indicar progresso. O testador fez os primeiros testes com muitos outros apps abertos e não registrou os modelos e as configurações de algumas execuções.
Adequação ao uso do testador
Não para este testador, nesta máquina, por enquanto. Nas palavras dele: 'Everything works, except that the end result is I didn't get it to work.' O chat e o gerenciamento de modelos funcionam com 24 GB; a geração de imagens não funcionou neste teste. O treinamento não foi testado. O testador pretende olhar de novo em três a seis meses.
ObservadoO chat funciona: um modelo de 27B em 4 bits da pasta do LM Studio respondeu a um cálculo a 11,0 tokens por segundo. Modelos do Ollama e do LM Studio aparecem no app.
MedidoOs modelos de imagem foram recusados: o flux.2-klein precisa de cerca de 17 GB; o app contou cerca de 2 GB utilizáveis (7 GB livres) e, depois de uma reinicialização, cerca de 6 GB (11 GB livres). Nenhuma imagem foi produzida.
OpiniãoUma interface linda em que tudo funciona, mas o resultado final não foi alcançado em um Mac de 24 GB.
Pontuação Status: Parcial
Instalação4/5DMG de 24 MB; janela de instalação com log detalhado. Sem estimativa de tempo nem de disco; quatro a cinco minutos (estimativa do testador). O teste partiu de uma instalação existente.
Primeiros passos e escolha de modelo3/5Seletor, hub, leitura do hardware, avisos de tamanho e cronômetro de download são pontos fortes. O seletor mostra contagens de parâmetros, não gigabytes; as mensagens de '7 GB' e '17 GB' confundiram o testador.
Função principal2/5O chat respondeu a um cálculo. A leitura de uma página web e uma busca de eventos terminaram em erros de falta de memória; nenhuma imagem foi produzida.
Orientação e iteração3/5A mensagem de recusa explica a causa e indica uma forma de contorná-la. Sem progresso enquanto um modelo inicia; sem explicação de por que 7 GB estavam 'livres'.
Desempenho2/511,0 tok/s em um modelo de 27B em 4 bits; falta de memória com contexto de 34,4k em um Mac de 24 GB, com outros apps abertos.
Documentaçãon/dNão testado.
Confiança e privacidaden/dNão auditado. O fornecedor alega uso 100% offline; a busca na web e os downloads precisam de internet. A operação offline não foi testada.
Desinstalaçãon/dNão testado.
As pontuações são propostas derivadas das evidências abaixo (1 = ruim, 5 = muito bom). Cabe ao testador confirmá-las. A geração de imagens, objetivo do testador, recebe nota baixa porque nenhuma imagem foi feita nesta máquina.
Detalhes do teste
App
Unsloth, o app de desktop (Unsloth Studio). As anotações escrevem 'Unsloth', 'Unslothh' e 'Onslaught'; este relatório usa 'Unsloth'. Observado
Versão
Log de instalação: 'unsloth 2026.8.18 -> 2026.10.3 available, updating'. Presume-se que a versão em uso após a atualização seja a 2026.10.3. A janela traz o rótulo BETA. A versão do próprio app de desktop não foi registrada. Suposição
Testador
Hans Kuepper, fundador do PromptQuorum
Início
9 de outubro de 2026, 13h (segundo as anotações). Uma captura de tela mostra 17h13, então o teste durou pelo menos quatro horas. Observado
Fim
Não registrado
Hardware
Mac com 24 GB. As anotações dizem 'macOS M3 24 GB' e depois 'M3 24 GB Pro MacBook'. O Model hub do app mostra '24 GiB RAM', '0 GiB VRAM + 24 GiB shared' e '12/12 CPU'. O chip exato não foi registrado. Observado
Sistema
macOS; versão não registrada
Estado da instalação
Não era uma instalação limpa. O log de instalação diz 'Updating existing Unsloth install' e 'existing install detected'; o testador diz 'same as before'. O uso anterior pode explicar por que os modelos do LM Studio e do Ollama já eram conhecidos. Observado
Download
DMG de 24 MB (como lido pelo testador). Uma etapa de dependências rodou na primeira abertura (veja o capítulo 1). Observado
Por que foi testado
Para ver como o Unsloth funciona, 'especialmente as funções de imagem'. O testador não pretendia usar a otimização de modelos (treinamento).
Objetivo
Gerar imagens localmente no Mac de 24 GB. O chat e o hub de modelos foram experimentados pelo caminho. Observado
Ajuda de IA usada
Nas anotações há um prompt de várias centenas de palavras sobre o skyline de Nova York; as marcas de negrito em Markdown sugerem que foi escrito por uma IA. Não confirmado. As respostas do modelo de chat (por exemplo, sobre de onde ele tirou o modelo) não foram usadas como base aqui. Suposição
Cada afirmação traz um rótulo:ObservadoMedidoEstimativa do testadorAlegação do appDe terceirosSuposiçãoOpiniãoErro do testadorO que significam os rótulos
Transparência. O testador fundou o PromptQuorum (promptquorum.com), um site de conteúdo e diretório sobre aplicativos de IA local. O Unsloth consta nesse diretório e tem no site uma página de análise já existente, escrita separadamente. As anotações não registram contato com o fornecedor, pagamento nem patrocínio.
Tudo funciona, só que o resultado final é que eu não consegui fazer funcionar.
Anotações do testador, levemente editadas a partir de transcrição de voz.
Como o teste transcorreu
Download, instalação e primeira abertura
Observado
O instalador é um DMG de 24 MB, descrito pelo testador como 'the smallest file I've ever seen'.
Observado
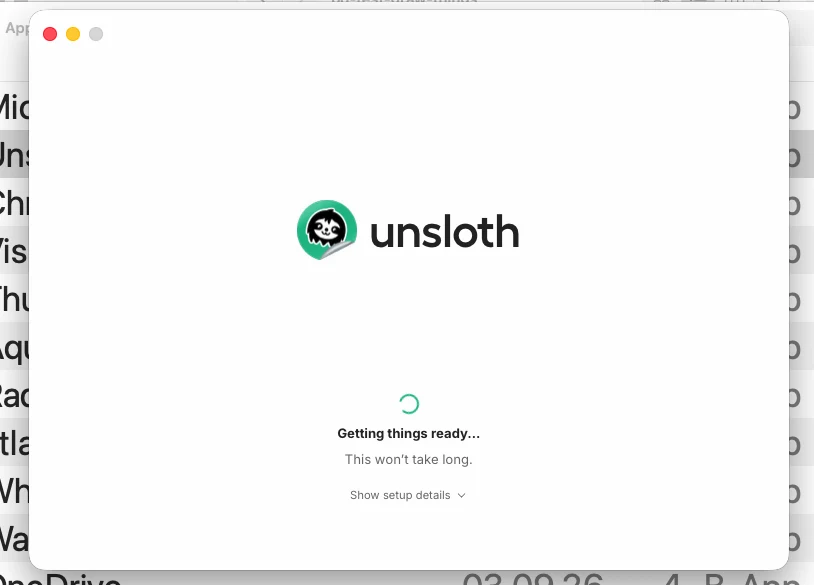
Primeira janela: 'Getting things ready... This won't take long.' com um link 'Show setup details'. O testador: 'Already feels much more polished than the other apps... a clear communication.'
Figura 2Primeira janela após abrir o app do DMG de 24 MB. O texto diz que não vai demorar; o testador não mediu nada e estima de quatro a cinco minutos (o log da atualização está no texto). Nenhuma estimativa de tempo ou de disco é exibida.
Observado
O log detalhado diz: 'Updating existing Unsloth install', 'frontend bundled (Tauri)', 'node v24.13.0 | npm 11.6.2 (system)', 'unsloth 2026.8.18 -> 2026.10.3 available, updating', e depois uma barra de dependências de 13 etapas (pip bootstrap, pilha MLX para Apple Silicon, pacotes base, extras do unsloth, codecs, overrides, dependências do studio, data designer, plugin local, pin do diffusers, finalização). Anotações: 'torch 2.10.0 detected -- installing torchao==0.16.0'; 'transformers 5.3.0, 5.5.0, 5.10.2 pre-installed'; 'gpu Apple Silicon (Metal, unified memory)'; 'installing prebuilt llama.cpp'.
Observado
O testador diz que rodou por cerca de quatro ou cinco minutos, e então o app abriu. O log não mostra estimativa de tempo nem de espaço em disco.
Estimativa do testador
Quatro a cinco minutos para a instalação. Não cronometrado.
Suposição
O DMG pequeno provavelmente baixa a maior parte do software nesta primeira etapa. Não verificado.
Opinião
'It gives me the details about what it does -- great -- but it doesn't tell me anything about estimated time, volumes, how much disk space it takes up.'
Observado
A janela principal abre com 'How can I help?' e uma barra lateral: New chat, Model hub, Library, Images, Train, More. O logotipo traz o rótulo BETA.
Figura 3Janela principal após a instalação. Barra lateral: New chat, Model hub, Library, Images, Train, More. O logotipo traz o rótulo BETA. Uma aba do navegador atrás da janela mostra uma página do GitHub do projeto.
Erro do testador
Partiu de uma instalação existente ('same as before'), então isto é uma atualização, não um teste de primeira execução. As conclusões sobre a integração inicial precisam de uma instalação limpa para serem confirmadas.
Seletor de modelos e o primeiro chat
Observado
O seletor de modelos lista Recommended models com números como 27.3B e 271.0M. São contagens de parâmetros, não gigabytes. Duas entradas estão acinzentadas (176.9B e 320.8B).
Figura 4Seletor de modelos, aba Recommended. Os números são contagens de parâmetros (B = bilhão, M = milhão), não gigabytes. Duas entradas estão acinzentadas (Qwen3.8-Flash-Next-GGUF 176.9B, GLM-5.3-Flash-GGUF 320.8B). O que o cinza e o ponto amarelo significam não é dito na visão do app capturada.
Suposição
As entradas acinzentadas provavelmente são grandes demais para esta máquina. A visão do app capturada não diz isso.
Opinião
'There were lots of models listed with the size. Very good.' Os números exibidos são contagens de parâmetros, então isso não diz ao leitor quanta memória um modelo precisa.
Observado
Em vez de escolher um modelo, o testador digitou um pedido de cálculo. O app começou a carregar modelos por conta própria. Um modelo Qwen3.8-27B MLX de 4 bits iniciou em menos de um minuto, segundo as anotações; um segundo aviso mostrou o Mistral-7B-Instruct-v0.3-4bit carregando (captura de tela omitida, do mesmo tipo da Figura 5).
Observado
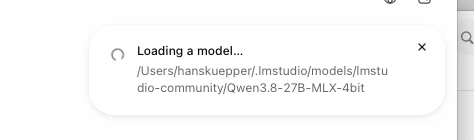
O aviso de carregamento mostra o caminho /Users/hanskuepper/.lmstudio/models/lmstudio-community/Qwen3.8-27B-MLX-4bit. O modelo foi lido da pasta do LM Studio no disco.
Figura 5Aviso exibido quando o primeiro chat começou. O caminho aponta para a pasta de modelos do LM Studio: /Users/hanskuepper/.lmstudio/models/lmstudio-community/Qwen3.8-27B-MLX-4bit. O modelo foi carregado do disco, não baixado.
Opinião
Ele suspeitou que viesse do disco rígido, porque 'that's a big model that doesn't go over the internet in one minute'. O caminho confirma isso. Por que o Unsloth escolheu esse modelo e o Mistral não foi registrado.
Observado
A pergunta 'what is 5 times 866' foi respondida com '5 x 866 = 4,330' (correto), após 'Worked for 10s', a 11.0 tok/s. O cabeçalho mostra 'Local' e um medidor de contexto '120 / 262.1k'.
Figura 6Primeiro chat. A resposta 4.330 está correta (5 x 866). A tela mostra 'Worked for 10s', 11.0 tok/s e um medidor de contexto '120 / 262.1k'.
Observado
Em seguida, o testador perguntou ao modelo de onde ele tirou o modelo. A parte capturada da resposta fala de pesos MLX e da memória unificada do Apple Silicon; a resposta completa não foi capturada. As anotações dizem que a resposta foi que o app não procura no disco.
Suposição
O relato do próprio modelo de chat sobre o app não é uma evidência confiável. Uma resposta chama o modelo de 'Qwen 3 27B MLX 4-bit', enquanto o app o nomeia Qwen3.8-27B-MLX-4bit.
Modelos já no disco: LM Studio e Ollama
Observado
A aba On Device lista os modelos por origem. Em CUSTOM FOLDERS aparecem dois caminhos (.lmstudio/models e .ollama/models) com os modelos do Ollama gemma4:latest, gemma3:1b e qwen3-coder:30b. Em LM STUDIO, o modelo Qwen3.8-27B está marcado como 'Loaded'.
Figura 7Aba On Device. Em CUSTOM FOLDERS há dois caminhos (.lmstudio/models e .ollama/models) com os modelos do Ollama gemma4:latest, gemma3:1b e qwen3-coder:30b; em LM STUDIO, o modelo Qwen3.8-27B está marcado como 'Loaded'. Uma resposta de chat parcialmente visível atrás da lista fala de pesos MLX. Não foi registrado se as pastas foram adicionadas pelo testador ou encontradas automaticamente.
Suposição
Ou o testador adicionou as duas pastas, ou o app as encontrou sozinho. Não registrado. O uso anterior do app pode tê-las configurado.
Observado
Ao trocar para o qwen3-coder:30b (30.5B, Q4_K_M, GGUF), aparece 'Starting model... Switching models. Loading cached model into memory.' com um botão Cancel. O medidor de contexto marca '1.3k / 8.2k', bem menor que os 262.1k do primeiro modelo.
Figura 8Troca para o modelo do Ollama qwen3-coder:30b (30.5B, Q4_K_M, GGUF). Medidor de contexto '1.3k / 8.2k'. O aviso diz 'Starting model... Switching models. Loading cached model into memory.' com um botão Cancel.
Opinião
'I like how easy to change models.' 'Some Ollama models do not work inside Unsloth, but great that it tried at least.'
Observado
Segundo as anotações, um modelo mais antigo funcionou e um mais novo travou. Quais modelos foram esses não foi registrado.
Opinião
Ele diz que é 'great that it tried' usar seus modelos do Ollama, e que ler modelos já presentes no disco evita mais um download grande.
Hub de modelos e downloads
Observado
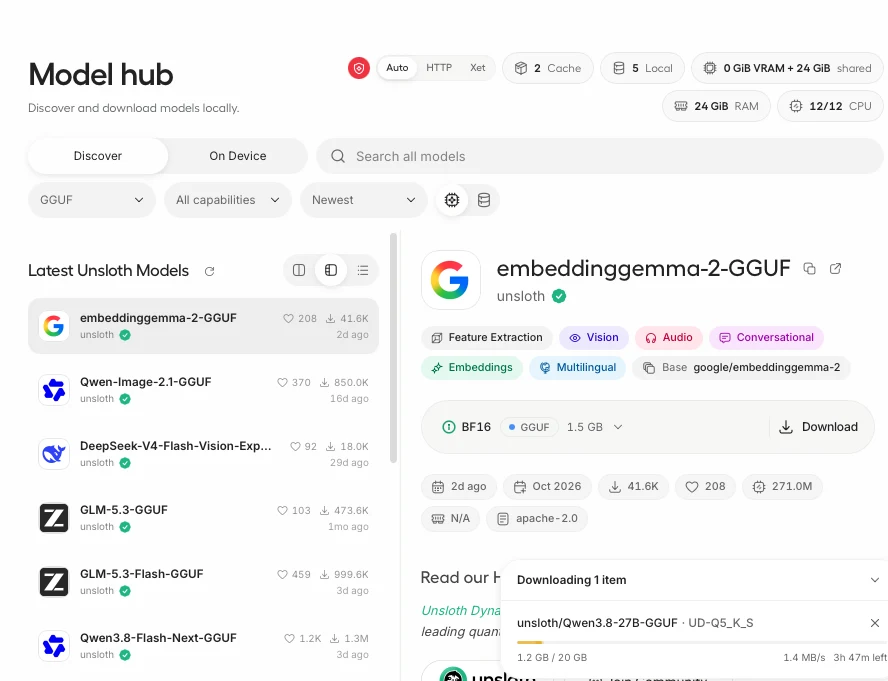
O hub mostra o dispositivo: '0 GiB VRAM + 24 GiB shared', '24 GiB RAM', '12/12 CPU', além de filtros (formato, capacidades, mais recentes). Os cartões mostram curtidas, downloads, idade e licença (embeddinggemma-2-GGUF: apache-2.0, 1.5 GB).
Figura 9Model hub. No alto à direita: '0 GiB VRAM + 24 GiB shared', '24 GiB RAM', '12/12 CPU'. Painel de download: unsloth/Qwen3.8-27B-GGUF UD-Q5_K_S, 1.2 GB de 20 GB, 1.4 MB/s, 3 h 47 m restantes. O cartão de modelo aberto, embeddinggemma-2-GGUF (1.5 GB, apache-2.0), não é o modelo em download.
Opinião
'Yes, great model hub.' O hub lista, entre outros, Qwen-Image-2.1-GGUF (850.0K downloads, 16 dias), GLM-5.3-GGUF e Qwen3.8-Flash-Next-GGUF.
Observado
Segundo as anotações, ao clicar em um arquivo grande demais para o Mac, apareceram vários avisos ('this file is 30 to 40 gigabytes total'); o download continua permitido. Sem captura de tela.
Medido
O painel de download do unsloth/Qwen3.8-27B-GGUF UD-Q5_K_S mostra 1.2 GB de 20 GB a 1.4 MB/s, 3 h 47 m restantes; mais tarde, 7.1 GB de 20 GB a 983 KB/s, 3 h 31 m restantes.
Figura 10O mesmo download mais tarde: 7.1 GB de 20 GB a 983 KB/s com 3 h 31 m restantes. O tempo entre esta e a captura anterior não foi registrado.
Opinião
'The professionalism of this app is visible. It has a timer attached. It tells you the download speed.'
Suposição
As velocidades sugerem uma conexão lenta no local do teste; o testador não diz isso. Não foi registrado se o download terminou.
Medido
A janela do Z-Image (BF16) lista arquivos do modelo de 12.3 GB mais codificador e decodificador necessários de 8.2 GB, total de 20.5 GB. Isso explica a 'difference between the gigabytes that the model has and then something else', que o testador menciona em outro ponto.
Figura 19Janela de download do Z-Image (BF16): arquivos do modelo 12.3 GB, 'Include required files' 8.2 GB (codificador e decodificador, compartilhados entre variantes compatíveis), total 20.5 GB. 'Downloading will not load this model or switch your current model.'
Opinião
As anotações dizem 'the picture LLM was downloaded'. Qual deles não foi registrado; as capturas mostram os modelos de imagem FLUX.2-klein-4B e sua variante GGUF no dispositivo (Figura 18).
Busca na web, voz e as falhas
Observado
O testador colou a URL de uma página do PromptQuorum e perguntou 'from a seo perspective will this help me?'. O chat mostra 'Using tool: Reading promptquorum.com' e 'Waiting for approval: web_search' com os botões Allow, Always allow e Deny. Horário 17h13; contexto '648 / 34.4k'.
Figura 11Chat com o Qwen3.8-27B-MLX-4bit, contexto '648 / 34.4k', horário 17h13. O prompt traz uma URL do PromptQuorum e pergunta sobre SEO. O app mostra 'Waiting for approval: web_search' e os botões Allow, Always allow, Deny. O modo é 'Approve for me'.
Observado
Segundo as anotações, a primeira tentativa disse que não conseguia ler a página; depois de clicar na função Search, funcionou na segunda vez. 'Maybe the first time should have had a warning.'
Suposição
A primeira falha pode ter vindo da falta de aprovação da busca na web ou do botão Search desligado. Não verificado.
Observado
A execução terminou com 'Ran out of memory. Try a smaller model or shorter input.' após 168.10 s, com um botão Retry.
Figura 12O mesmo chat termina com 'Ran out of memory. Try a smaller model or shorter input.' após 168.10 s.
Observado
A entrada por voz é integrada. Ao usá-la, o app pede para baixar o modelo de fala 'Qwen3-ASR 0.6B', cerca de 1.0 GB, que ele diz ser baixado uma vez para o cache do Hugging Face. Não foi registrado se o testador o baixou.
Figura 13Entrada por voz: 'Local dictation runs entirely offline, but it needs the Qwen3-ASR 0.6B speech model first. About 1.0 GB, fetched once into your Hugging Face cache.' Não foi registrado se o testador o baixou.
Observado
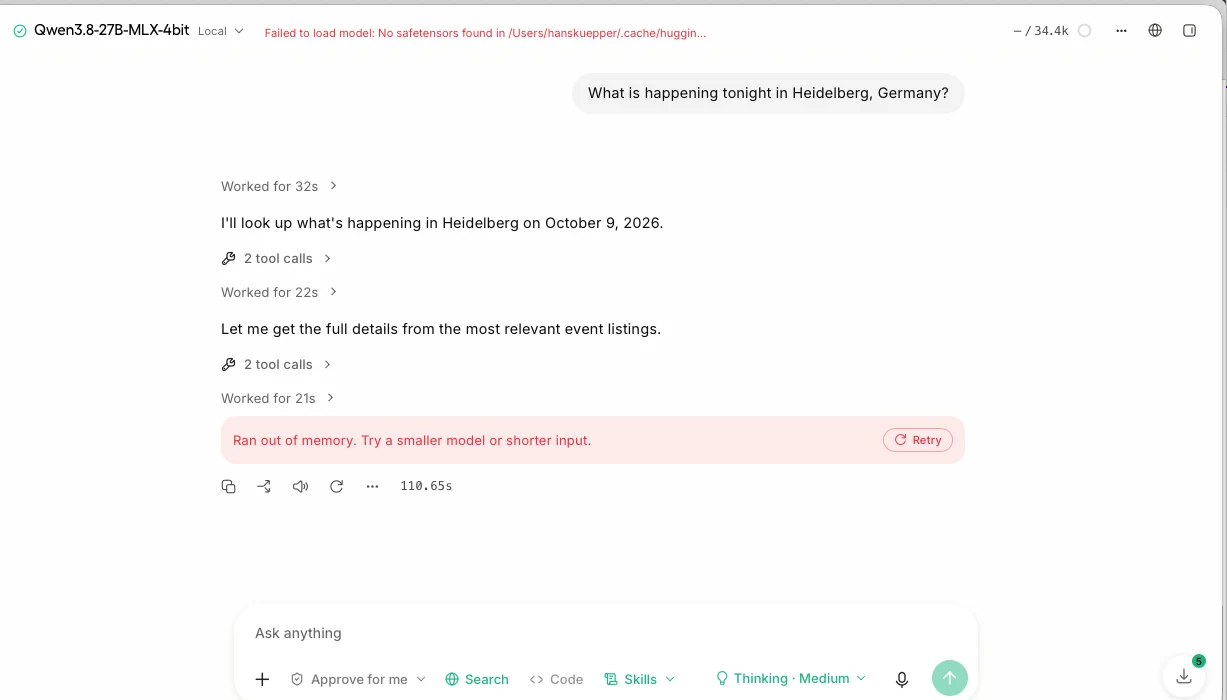
Uma busca local de eventos ('What is happening tonight in Heidelberg, Germany?') fez duas rodadas de chamadas de ferramentas e terminou com 'Ran out of memory' após 110.65 s. O cabeçalho mostra um aviso em vermelho: 'Failed to load model: No safetensors found in /Users/.../.cache/huggin...'.
Figura 14Busca local de eventos. Cabeçalho (vermelho): 'Failed to load model: No safetensors found in /Users/.../.cache/huggin...'. No chat, duas rodadas de 'tool calls' e então 'Ran out of memory. Try a smaller model or shorter input.' após 110.65 s. Contexto '- / 34.4k'. O indicador de downloads mostra 5.
Suposição
O erro de carregamento e a mensagem de falta de memória podem estar ligados (um modelo sendo trocado enquanto a memória acabava). A captura de tela não mostra essa ligação.
Opinião
'But yes, local AI, always some issues.'
Modelos de imagem: recusados por falta de memória
Observado
O objetivo do testador eram imagens. A barra lateral tem um item 'Images'. As anotações mostram um longo prompt do skyline de Nova York (vista do Brooklyn, Ponte do Brooklyn, golden hour, detalhe em 8K) com listas de composição e de itens a evitar. Nenhum resultado, erro ou configuração foi registrado para ele.
Medido
O carregamento do modelo de imagem flux.2-klein foi recusado: 'needs about 17 GB of memory for its weights, but only about 2 GB is usable on this device (of the 7 GB currently free, after reserving room for the operating system)'. A mensagem acrescenta que o Mac tem um único conjunto de memória, que descarregar para a CPU não libera nada, e sugere um modelo menor, uma quantização menor ou fechar outros apps. Ela cita UNSLOTH_DIFFUSION_ALLOW_OVERSIZED_LOAD=1 como forma de contornar.
Figura 1Recusa ao carregar o modelo de imagem flux.2-klein. O app informa cerca de 17 GB necessários, cerca de 2 GB utilizáveis (7 GB atualmente livres, menos o espaço do sistema operacional). Ele cita uma variável para contornar, UNSLOTH_DIFFUSION_ALLOW_OVERSIZED_LOAD=1, que não foi testada.
Medido
Depois de uma reinicialização limpa, a mensagem diz: cerca de 17 GB necessários, cerca de 6 GB utilizáveis, de 11 GB atualmente livres.
Figura 15Segunda recusa do flux.2-klein: cerca de 17 GB necessários, cerca de 6 GB utilizáveis (11 GB atualmente livres). Considerada aqui como feita após a reinicialização limpa, pela ordem das anotações.
Suposição
As duas mensagens diferem em 5 GB nos dois pares (7 - 2 e 11 - 6), então o app parece reservar cerca de 5 GB para o sistema operacional. Apenas dois pontos de dados.
Observado
A lista de dispositivos mostra FLUX.2-klein-4B-GGUF (7.8 GB), FLUX.2-klein-4B (16 GB) e mistral-7b-v0.3-bnb-4bit (4.1 GB). O testador: 'This should be small enough.' O testador diz que o menor modelo de imagem do hub trava sua máquina de 24 GB, e que todos os modelos em que clicou diziam ser grandes demais porque só 'seven gigabytes' estavam disponíveis.
Figura 18Modelos no dispositivo em UNSLOTH: FLUX.2-klein-4B-GGUF (BF16, ícone de imagem, 4B, 7.8 GB), FLUX.2-klein-4B (ícone de imagem, 4B, 16 GB), mistral-7b-v0.3-bnb-4bit (7B, 4.1 GB).
Erro do testador
O testador estranha que só sete gigabytes estejam disponíveis ('I have much more'). A janela informa que 7 GB estavam livres naquele momento e que os outros apps estavam abertos; depois da reinicialização, informa 11 GB. As anotações colocam o comentário dos '7 GB' junto à janela do Z-Image; o valor de 7 GB está na mensagem do flux.2-klein.
Opinião
'I'm lost... I have a 24-gigabyte machine and I cannot find an LLM that can serve me and can do the job.' Ele acha que 24 GB é mais do que mais de 80 por cento dos seus leitores têm (estimativa dele, não um valor medido).
Estimativa do testador
'More than 80% of my readers' têm 24 GB ou menos. Fonte não informada.
Memória no Mac
Observado
O testador conclui que os modelos locais e o trabalho do dia a dia disputam a mesma memória, e que o Chrome e outros apps ocupam de 5 a 8 GB. Ele escreveu 'VRAM' o tempo todo; o Apple Silicon tem um único conjunto de memória, como diz o hub ('0 GiB VRAM + 24 GiB shared').
Medido
Monitor de Atividade, uma captura: memória usada 12,92 GB, arquivos em cache 10,95 GB, memória de apps 9,81 GB, residente 1,83 GB, swap 0.
Figura 16Painel de memória com um histórico longo e plano. Memória usada 12,92 GB, arquivos em cache 10,95 GB, memória de apps 9,81 GB, residente 1,83 GB, swap usado 0 bytes. O momento da captura e os apps abertos não foram registrados.
Medido
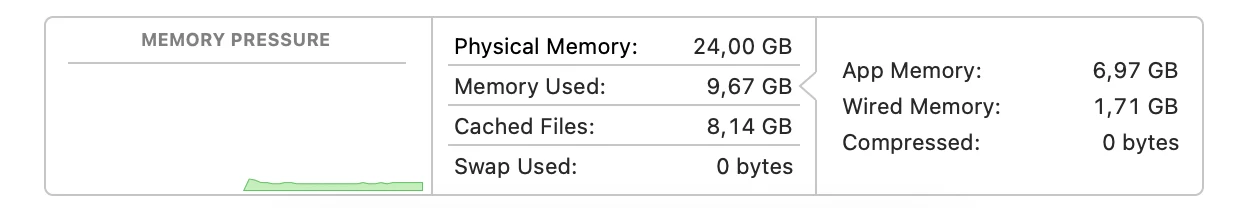
Monitor de Atividade, outra captura: memória usada 9,67 GB, arquivos em cache 8,14 GB, memória de apps 6,97 GB, residente 1,71 GB, swap 0. O gráfico de histórico curto combina com uma inicialização recente.
Figura 17Painel de memória com um histórico curto que começa tarde no gráfico. Memória usada 9,67 GB, arquivos em cache 8,14 GB, memória de apps 6,97 GB, residente 1,71 GB, swap 0. Combina com o comentário '10 GB at startup' nas anotações; qual momento ele mostra não foi registrado.
Suposição
Os 11 GB 'atualmente livres' na Figura 15 são coerentes com 24,00 - 12,92 = 11,08 GB da Figura 16. Não foi registrado se as duas foram feitas ao mesmo tempo.
Opinião
'Even after reboot, already nine gigabytes gone for general things.' 'Either I shut the computer down, reboot, stop all the processes... or I cannot run the LLM.'
Opinião
Duas respostas possíveis: os modelos precisam ficar menores e melhores, ou os computadores precisam de 48 ou 64 GB. 'All of this talk about this works on your computer is a little bit fake.'
Suposição
Que 48 ou 64 GB resolveriam isso 'com segurança' não foi testado.
Carregamento sem retorno e a visão final
Observado
Iniciar um modelo mostra um aviso 'Starting model... Loading cached model into memory.' com um indicador giratório e Cancel. Sem porcentagem, tamanho nem tempo.
Figura 20Início do modelo. O aviso mostra um indicador giratório e 'Loading cached model into memory.' Sem porcentagem, tamanho nem tempo. O testador diz que demorou mais de dois ou três minutos (estimativa).
Estimativa do testador
A espera foi maior que dois ou três minutos (não cronometrada).
Opinião
'The worst way you can treat a client is to do the work and not update the client.' O testador chama isso de problema de interface do usuário.
Observado
Os medidores do cabeçalho mostram os tokens usados em relação ao contexto (por exemplo '648 / 34.4k') e os tokens por segundo (11.0 tok/s).
Erro do testador
As anotações dizem 'no token counter'. As capturas mostram um medidor de contexto e um valor de tokens por segundo. Talvez ele se referisse a uma contagem de tokens por mensagem (suposição).
Erro do testador
As anotações chamam um modelo de chat local de 'the most stupid idea' porque ele 'does not research the internet'. As mesmas anotações e capturas mostram uma função Search, um pedido de aprovação de busca na web e chamadas de ferramentas lendo uma página.
Opinião
Ele não quer treinar modelos; a função de chat tem pouca utilidade para ele; ele quer uma ferramenta de imagem e vídeo e 'is not seeing it yet'. O treinamento e a aba 'Train' não foram testados.
Opinião
'Maybe it's on my side, but no, not for me. I'll check again in three or six months, but currently not on a M3 24 GB Pro MacBook.'
Alegações versus o que o testador viu
Alegação
Origem
Observado
Rótulo
'Run and train image and video diffusion or multimodal models', localmente (README do GitHub; página de documentação)
Fornecedor, lido em 16 de out. de 2026
Nenhuma imagem foi feita. O flux.2-klein foi recusado (cerca de 17 GB necessários; 2 GB e 6 GB utilizáveis). Não se mostrou que variantes menores de imagem carregam. Treinamento não testado.
Observado
'Training, MLX and GGUF inference all work inside of Unsloth' no macOS (documentação)
Fornecedor, lido em 16 de out. de 2026
Um modelo MLX (Qwen3.8-27B de 4 bits) e um modelo GGUF (qwen3-coder:30b) carregaram e responderam. Treinamento não testado.
Observado
'Can be used 100% offline and locally on your computer' (documentação)
Fornecedor, lido em 16 de out. de 2026
A busca na web e os downloads usaram a internet. O uso offline não foi testado.
Observado
A busca na web 'visits pages directly' (documentação)
Fornecedor, lido em 16 de out. de 2026
Tentou-se ler uma página; segundo as anotações, a primeira tentativa falhou e a segunda leu a página. Em seguida, a execução ficou sem memória.
Observado
App de desktop 'free and open source' (notas de versão)
Fornecedor, lido em 16 de out. de 2026
Nenhum pedido de pagamento aparece nas anotações nem nas capturas de tela.
Observado
Hardware mostrado no hub
App
O hub mostrou 24 GiB RAM, 0 GiB VRAM + 24 GiB shared e 12/12 CPU. O valor de RAM bate com os 24,00 GB do Mac.
Medido
'No hardware requirements stated' (páginas lidas)
Fornecedor, lido em 16 de out. de 2026
Nem a página do GitHub nem a de documentação indicaram um requisito de memória no texto retornado. O próprio app informa sua necessidade no momento do carregamento (17 GB para o flux.2-klein).
Observado
Cabe em 24 GB?
24 GB de memória
Pesos do flux.2-klein, segundo a mensagem de recusacerca de 17 GB necessários abaixo de 24 GBMedido
FLUX.2-klein-4B (lista de dispositivos)arquivo de 16 GB abaixo de 24 GBMedido
FLUX.2-klein-4B-GGUF (lista de dispositivos)arquivo de 7,8 GB abaixo de 24 GBMedido
Utilizável segundo o app, antes da reinicializaçãocerca de 2 GB dos 7 GB livres abaixo de 24 GBMedido
Utilizável segundo o app, depois da reinicializaçãocerca de 6 GB dos 11 GB livres abaixo de 24 GBMedido
Memória do Mac em uso, Monitor de Atividade (primeira captura)12,92 GB em uso abaixo de 24 GBMedido
Memória do Mac em uso, Monitor de Atividade (segunda captura)9,67 GB em uso abaixo de 24 GBMedido
Download total do Z-Image BF1612,3 GB do modelo + 8,2 GB de arquivos necessários (tamanho do download) abaixo de 24 GBMedido
As linhas 2, 3 e 8 são tamanhos de arquivo ou de download, não uso de memória em execução. O valor de 17 GB é a estimativa do próprio app para o flux.2-klein; a qual variante de arquivo ele se refere não foi registrado. 'Usable' é o valor do app depois de reservar espaço para o sistema operacional. O modelo Qwen3.8-27B MLX de 4 bits rodou no chat; seu uso de memória não foi lido.
Registro de uso
#
Tarefa
Modelo
Resultado
Tempo
Status
Figuras
1
Abrir o app de 24 MB, atualizar, primeira abertura
Unsloth 2026.8.18 -> 2026.10.3 (presumido)
Abriu após o log de instalação; instalação existente
Erro do testadorTestou uma atualização de uma instalação existente ('same as before'), não uma instalação de primeira execução.
Erro do testadorFez os primeiros testes de memória com Chrome, o app Claude, Word, WhatsApp e outros apps abertos em um Mac de 24 GB. A primeira recusa mostrou 7 GB livres.
Erro do testadorUsou 'VRAM' para memória o tempo todo, embora o app diga '0 GiB VRAM + 24 GiB shared'.
Erro do testadorEscreveu que não há 'no token counter'; as capturas mostram um medidor de contexto e tokens por segundo.
Erro do testadorEscreveu que um modelo de chat local 'does not research the internet'; as capturas mostram uma função Search e chamadas de ferramentas de busca na web.
Erro do testadorLeu os números do seletor de modelos como tamanhos; são contagens de parâmetros.
Erro do testadorAnotou que só havia sete gigabytes disponíveis sem dizer o que mais estava aberto; a janela diz que 7 GB estavam livres naquele momento.
Erro do testadorDeixou lacunas no registro: a versão do app de desktop, a versão do macOS, o chip, a hora de término, qual modelo foi usado no prompt de Nova York e o que aconteceu com ele, quais modelos do Ollama falharam, se o download de 20 GB terminou, as configurações das execuções de imagem e a desinstalação.
Erro do testadorEscreveu o nome do app como 'Onslaught' e 'Unslothh' nas anotações (transcrição de voz).
SuposiçãoAs anotações colocam a janela do Z-Image junto ao comentário sobre 'only seven gigabytes'; o valor de 7 GB está nas mensagens do flux.2-klein. As capturas de tela foram associadas ao texto pelo que mostram, não apenas pela ordem.
Registro de achados
ID
Achado
Categoria
Rótulo
Gravidade
Figuras
UN-01
O DMG tem 24 MB, bem menor que os outros apps que o testador já viu.
A primeira abertura executa uma instalação de dependências em 13 etapas, de cerca de quatro a cinco minutos, sem estimativa de tempo nem de disco. O log detalhado é visível.
O seletor de modelos mostra contagens de parâmetros (27.3B, 271.0M), não o tamanho de download ou de memória; algumas entradas estão acinzentadas sem explicação na captura.
O testador considera a interface bonita e fluida, mas não chegou a um resultado e não vê motivo para usar o app agora.
Visão geral
Opinião
Média
-
UN-26
O diretório indica a licença como Apache-2.0; a página do GitHub diz que a interface do Studio é AGPL-3.0 e o núcleo, Apache-2.0.
Manutenção
De terceiros
Média
-
A gravidade é o impacto sobre um usuário de primeira viagem. Proposta, não medida.
Para quem é
Provável bom encaixe
SuposiçãoUsuários com mais de 24 GB de memória, ou uma máquina limpa com poucos apps abertos, que querem chat, um hub de modelos e modelos locais do LM Studio e do Ollama em um só app.
Alegação do appPessoas que querem treinar ou ajustar modelos, que é o principal objetivo do projeto segundo o fornecedor (não testado aqui).
Provável mau encaixe
OpiniãoQuem quer geração local de imagens em um Mac de 24 GB com outros apps abertos. Não funcionou para o testador.
OpiniãoQuem quer um resultado rápido sem aprender sobre modelos, memória e treinamento.
Novo teste. O testador pretende conferir de novo em três a seis meses (cerca de janeiro a abril de 2027). Antes disso, registre a versão do app de desktop, a versão do macOS e o chip; comece de uma instalação limpa; feche os outros apps e anote a memória livre; teste um modelo de imagem que caiba (por exemplo, o GGUF de 7,8 GB) e registre cada configuração e resultado; teste o treinamento, o uso offline e a desinstalação.
A pior forma de tratar um cliente é fazer o trabalho e não manter o cliente informado.
Anotações do testador, levemente editadas a partir de transcrição de voz.
Perguntas frequentes
O Unsloth consegue gerar imagens em um Mac de 24 GB?
Não neste teste. O carregamento do modelo de imagem flux.2-klein foi recusado duas vezes: cerca de 17 GB necessários e, a princípio, cerca de 2 GB utilizáveis (7 GB livres), e cerca de 6 GB utilizáveis (11 GB livres) depois de uma reinicialização. Nenhuma imagem foi produzida. Medido
O Unsloth encontra modelos que já tenho no LM Studio ou no Ollama?
Sim, neste teste. O primeiro chat carregou um modelo Qwen3.8-27B de 4 bits da pasta de modelos do LM Studio sem download, e a lista On Device mostrou modelos do Ollama como gemma4:latest e qwen3-coder:30b. Alguns modelos do Ollama não funcionaram; quais não foi registrado. Observado
Qual é a velocidade do chat do Unsloth em um Mac de 24 GB?
Um modelo de 27B em 4 bits respondeu 'what is 5 times 866' (4.330, correto) em 10 segundos a 11,0 tokens por segundo. A leitura de uma página web e uma busca de eventos com o mesmo modelo terminaram em 'Ran out of memory', com outros apps abertos. Medido
Qual é o tamanho do instalador do Unsloth e quanto tempo leva a instalação?
O DMG tem 24 MB. A primeira abertura executou uma atualização de dependências em 13 etapas que o testador estima em quatro a cinco minutos; a janela não mostra estimativa de tempo nem de disco. O teste partiu de uma instalação existente, não de uma limpa. Observado
O Unsloth pode ser usado totalmente offline?
A documentação do fornecedor diz que ele pode ser usado 100 por cento offline e localmente. O uso offline não foi testado; a busca na web e os downloads de modelos usaram a internet. Alegação do app
Contexto sobre o desenvolvedor
Fora da sessão prática. Os itens abaixo vêm da página do fornecedor no GitHub, da documentação e da página de versões, e do diretório do PromptQuorum. Foram lidos em 16 de outubro de 2026 com uma ferramenta de busca na web que resume páginas e não foram verificados de forma independente.
Alegação do appA página do GitHub descreve o Unsloth como o 'first desktop app to run and train models' e 'Local UI to run and train LLMs and diffusion models'. Oferece o Unsloth Studio (interface web) e o Unsloth Core (código). As páginas lidas não nomearam uma empresa nem uma pessoa.
Alegação do appLicença: pacote principal Apache 2.0; 'certain optional components, such as the Unsloth Studio UI' são AGPL-3.0.
Alegação do appPlataformas: Windows, Linux, WSL e macOS. Opções de instalação: app de desktop (um .dmg para macOS), um script de shell, Homebrew e Docker. Os requisitos de hardware não foram indicados no texto retornado.
Alegação do appDocumentação do Studio: executa localmente modelos GGUF, MLX e de difusão de imagem e vídeo; 'Training, MLX and GGUF inference all work inside of Unsloth' no macOS; a busca na web 'visits pages directly'; 'can be used 100% offline'.
De terceirosO diretório do PromptQuorum lista o Unsloth como gratuito, Apache-2.0, para Mac, Windows e Linux, na categoria fine-tuning e LoRA, com cerca de 76.100 estrelas no GitHub (dados verificados em 13 de set. de 2026). Registra um DMG para macOS na versão v0.1.905-beta (conferida em 9 de out. de 2026) e uma última atualização upstream em 16 de out. de 2026. O PromptQuorum não havia testado o app na prática antes deste relatório.
SuposiçãoA página de versões lida em 16 de out. de 2026 retornou a v0.1.806-beta (2 de set.) como a mais recente, o que difere da v0.1.905-beta do diretório; a ferramenta de resumo pode ter lido uma página desatualizada. A versão do pacote Python no log de instalação (2026.10.3) segue outra numeração, diferente das tags do app de desktop.