Como o teste transcorreu
Download, primeira inicialização e o primeiro modelo
O instalador é um DMG de 270 MB do site. O testador: 'Really nice startup. Looks fake [wording unclear in the notes]. Nothing to be done more. Just click open.'
A tela inicial 'All AI Tools' mostra Text to image, Image to image, AI Canvas, Illusion Generator, Inpainting e Upscaler (lista rolada; pode haver mais abaixo).
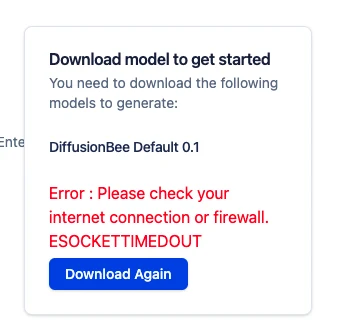
O primeiro uso pede um modelo: 'Download model to get started. You need to download the following models to generate: DiffusionBee Default 0.1'. A barra de progresso mostra apenas uma porcentagem: sem tamanho e sem estimativa de tempo. As anotações dizem 2 por cento após menos de um minuto; a captura de tela mostra 3 por cento.
A caixa de diálogo deveria dizer o tamanho do modelo e quanto tempo leva o download.
Enquanto um modelo é baixado, outras áreas do app podem ser abertas e usadas (anotações).
O primeiro download falhou com 'Please check your internet connection or firewall. ESOCKETTIMEDOUT' e a única opção 'Download Again'.
O testador acha que a conexão lenta do local do teste causou o timeout. Não verificado. Ele relata que o download estava em 65 por cento e teve de recomeçar; não se verificou se ele recomeçou do zero.
'Come on, this is so unprofessional.' Depois do download: 'Hurray, after download it works.'
A página Models
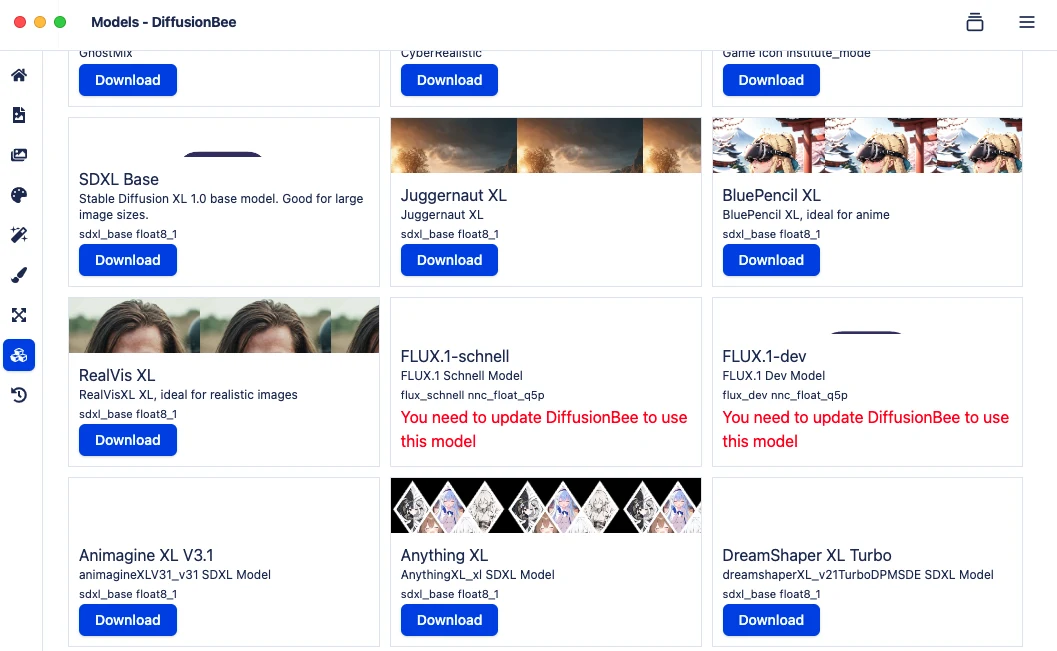
A página Models é uma grade de cartões, cada um com um nome, uma descrição de uma linha e uma tag como 'sdxl_base float8_1'. Ela lista SDXL Base, Juggernaut XL, BluePencil XL, RealVis XL, Animagine XL V3.1, Anything XL, DreamShaper XL Turbo e mais. Nenhum cartão mostra o tamanho do download.
FLUX.1-schnell e FLUX.1-dev mostram texto vermelho: 'You need to update DiffusionBee to use this model.' O testador tinha baixado o app cerca de dois minutos antes.
O diretório da PromptQuorum registra a última atualização do DiffusionBee pelo projeto original em 30 de outubro de 2024 (mais de um ano antes deste teste), e o rodapé da página do fabricante diz '© 2024'. O README do projeto lista SD 1.x, SD 2.x, SD XL, Inpainting, ControlNet e LoRA e não menciona o FLUX. Lido em 16 de outubro de 2026; a lista de versões no GitHub não pôde ser lida.
Há um botão 'Import From Computer' na página Models. O testador deduz que modelos que ele já tem podem ser importados (não testado).
Ele pergunta por que a página não mostra os tamanhos dos modelos para ver o que roda no computador dele, e por que não há uma explicação curta do que cada modelo faz. 'And as no instruction, it is just like the random downloads again.'
Um cartão do Samaritan 3d Cartoon mostrou uma barra de download em 1 por cento, sem tamanho (anotações e uma pequena captura de tela).
Primeiras imagens: um círculo e uma imagem de marca
Prompt 'circle with green dot in the middle': um disco branco com centro verde sobre fundo verde. Configurações: Default_SDB_0.1, 512 x 512, 1 imagem, seed -1, 25 passos. Cada imagem traz um botão 'Actions'.
Em seguida, 'a real challenge': um prompt longo e estruturado para uma imagem de marca e um logotipo da PromptQuorum. Configurações: Default_SDB_0.1, 1024 x 1024, 3 imagens, 25 passos. A tela mostra um indicador de carregamento, 'Add to Queue' e 'Stop all'.
Os três resultados são caixas e cartões em preto e branco com letras embaralhadas. Nenhum 'PromptQuorum.com' legível e nenhum logotipo utilizável.
O testador escreve 'I assume the prompt failed because that was not requested'. O sentido não está claro nas anotações.
Ele gosta de escolher o número de imagens e o tamanho. O que lhe faz falta é uma indicação de velocidade, um horário de término e 'some entertainment while it's working'.
Um lugar real: Heidelberg
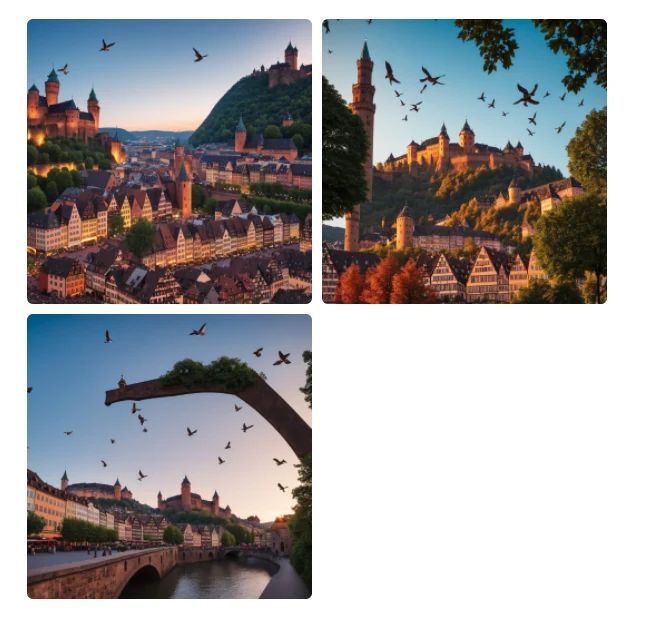
O prompt, escrito anos atrás para um modelo de ponta: uma imagem fotorrealista a partir do Heumarkt, em Heidelberg, olhando para o castelo, com pássaros e um nascer do sol atrás do castelo. Modelo e configurações não registrados.
Os três resultados mostram um castelo em uma colina arborizada acima de casas antigas de enxaimel, com pássaros. Nenhum mostra a vista do Heumarkt nem o castelo de Heidelberg propriamente dito.
O testador esperava que um modelo de imagem conhecesse um lugar real e o seu ângulo. Ele mesmo diz: 'too much expected from this tool'.
'I could have written, do a castle up the hill with a sunset and birds behind. That's the difference between frontier models with access to the internet and pure LLMs that are just generating pictures.'
A diferença é o acesso à internet ou ao conhecimento sobre lugares. Não testado neste relatório.
O testador também tentou imagens que 'outros sistemas poderiam recusar'. As anotações dizem que o app 'did not say stop on anything'. Os prompts não foram registrados e não há captura de tela.
Inpainting: logotipo e pedestre
Abrir o Inpainting pede mais um modelo: 'ControlNet Inpaint', mostrado em 3 por cento, sem tamanho.
Teste 1: a foto de uma caixa de massa. Prompt 'remove barillia logo' (marca escrita errada), com uma máscara sobre o logotipo. A primeira tentativa 'failed', segundo as anotações.
Após uma segunda tentativa, o texto do logotipo não é mais legível, mas restam manchas rosa e os fios de espaguete estão borrados.
'Technically, removing worked, just not putting the spaghettis back together.'
Teste 2: uma foto de rua com um pedestre. No resultado, a pessoa sumiu. O testador: 'Nearly there. If you don't expect something and I don't look for it, you don't see it.'
O nome da marca no prompt foi escrito errado ('barillia'). Quem fez o trabalho foi a máscara, não o prompt, então o efeito provavelmente é pequeno (suposição).
AI Canvas e image to image: céu e pop art
AI Canvas com a foto de rua e o prompt 'Make the sky dark blue, real summer day' com Input Strength 30. O resultado não foi capturado.
'Blue sky didn't work out, or I don't understand the mechanism.'
Image to image com 'make this into a pop art cartoon picture' no Samaritan_3d_Cartoon_v1_s2 com Input Strength 80.02. O resultado é uma cópia mais suave e opaca da foto, não pop art. Testador: 'Pop art also didn't work out. Not sure why.'
Esta captura de tela está no fim das anotações, depois do comentário sobre velocidade, e é lida aqui como a tentativa de pop art. Não confirmado.
Um Input Strength mais alto mantém mais da imagem original. Pontos de dados: 21.07 e 21.46 alteraram muito a imagem, 90.13 a devolveu quase inalterada, 80.02 deu uma cópia próxima. Apenas quatro configurações; a explicação do próprio app não foi registrada.
Palhaço, elefante, vulcão: modelos, orientação e um prompt negativo
O testador verificou o uso de memória com o Samaritan 3D Cartoon. Prompt 'draw a clown dancing on an elephant', 512 x 512, 1 imagem: um palhaço de desenho animado dançando, com uma forma bege de elefante fundida atrás dele.
Necessidade de memória neste modelo: cerca de 5 GB 'of my VRAM'. Método não registrado. O Apple Silicon tem um único conjunto de memória compartilhada.
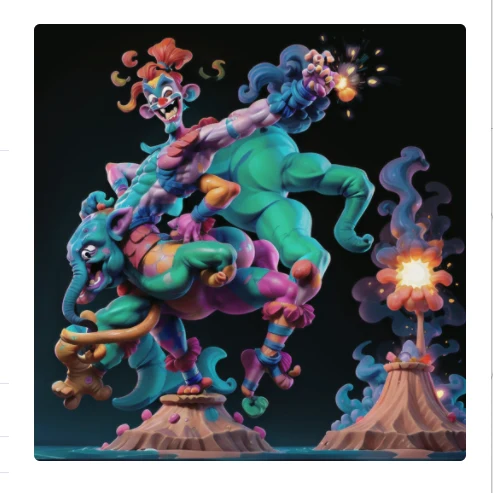
Prompt mais longo (palhaço em cima de um elefante, praia, oceano azul, vulcão explodindo) com o prompt negativo 'No blue sky!!' a 1024 x 1024: uma criatura azul musculosa com faíscas de fogo. Não se distingue palhaço, elefante, praia nem vulcão. Testador: 'a nice result, but not really what I outlined'.
Com a escala de orientação (guidance) no máximo (o que, segundo a instrução do app, 'means it should really do what I ask'): aparecem um palhaço, um animal parecido com um elefante e um vulcão em erupção. Não se distingue praia nem oceano azul; o chão é escuro.
'I would say close, close, close or maybe perfect.'
Mesmo prompt no JuggernautXL_v7_f8 (outro download): um palhaço com balões em um elefante, uma grande coluna de fumaça do vulcão, uma praia com guarda-sóis e água azul. O céu é azul, então o prompt negativo 'No blue sky!!' não foi seguido. Testador: 'Looks great, except the negative prompt was skipped.'
Ele gostaria que a janela dissesse o que é um modelo, em vez de ter de pesquisar em outro lugar. Uma resposta do Google colada nas anotações descreve o Juggernaut XL como um ajuste fino do SDXL voltado ao fotorrealismo (veja Contexto).
Um casal fotorrealista, e a velocidade
Prompt: 'photorealist a couple in love on the beach, watching the sunset over the ocean, birds in the sky, some boats on the water, some palm trees seen'. JuggernautXL_v7_f8, 1216 x 1216, 6 imagens solicitadas. Dois resultados foram capturados.
Ambos mostram pôr do sol, palmeiras e pássaros. O primeiro tem um veleiro e uma câmera na areia; o segundo tem vários barcos, mas três pessoas em dois bancos, onde o prompt pedia um casal.
O segundo resultado (Figura 19) é mostrado aqui.
'Looks a bit like AI, but well done, well done.' Ele gosta de poder escolher quantas imagens e que tamanho, e de o app 'just runs and runs' enquanto se faz outra coisa, e depois se escolhe a melhor.
Cerca de um minuto por imagem na resolução mais alta; um arquivo de cerca de dois megabytes por imagem. Nenhum dos dois foi cronometrado nem aparece em uma captura de tela. 'Not very fast, but it's okay.'
Mais testes e a visão final (anotações encontradas no documento do Msty)
O arquivo Word do teste do Msty também contém anotações e capturas de tela sobre o DiffusionBee. Elas são usadas aqui como segunda fonte. A data e a ordem em relação aos testes acima não estão registradas; uma captura de tela com informações de arquivo datada de 14 de outubro de 2026, 17:58, sugere o mesmo dia.
'Generate similar images' produziu quatro cenas parecidas de casal na praia a partir de uma imagem. Testador: uma função legal; ele a chama de 'really impressive'.
Um PNG salvo em Downloads em 14 de outubro de 2026 às 17:58 mede 38.733.330 bytes (38,7 MB). Qual imagem é, não está registrado.
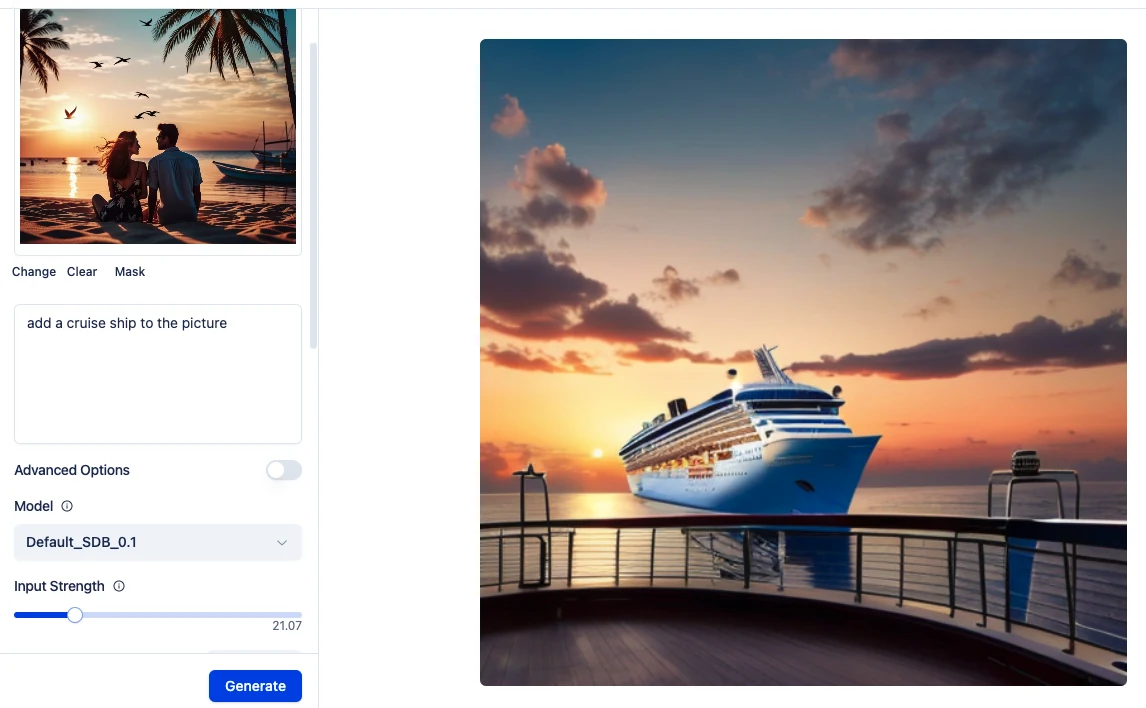
Image to image na imagem do casal na praia, prompt 'add a cruise ship to the picture', Input Strength 21.07: aparece um navio de cruzeiro ao pôr do sol visto da grade de um deque. O casal e as palmeiras sumiram.
Segunda tentativa (prompt longo, Input Strength 21.46): uma vista do mar ao pôr do sol a partir de um deque com uma palmeira e cadeiras; nenhum navio no horizonte.
Terceira tentativa (Input Strength 90.13): saída quase idêntica à entrada; nenhum navio.
Segundo as anotações, definir o Input Strength como 100 'crashes' o app. Sem captura de tela; versão não registrada.
Prompt da Torre Eiffel (JuggernautXL_v7_f8, 2 imagens, seed 770465): duas torres quase idênticas vistas de baixo. O testador diz que a torre está boa, mas a direção e as proporções estão erradas, e as árvores do jardim francês estão 'spot on' enquanto o resto ao redor da torre não foi acertado.
Linha do horizonte noturna de Nova York com 'add 3 helicopters flying' (epicrealismXL_v8, 75 passos): mais de três helicópteros estão visíveis. Testador: ele 'cannot count till three and created a second Manhattan Island'.
Uma foto de comida com o prompt 'make this german dinner into a cartoon style, many colors, really funny': segundo as anotações, o app 'gave me the same picture back several times'. O resultado não foi capturado.
O campo Seed tem um texto de ajuda que o testador cita como 'Starting point for iteration. Any number will do. [App?] will pick one if left blank.' Ele está 'not sure what the value is'. A palavra antes de 'will pick one' não está clara nas anotações.
Com o app Claude, Word, WhatsApp, Chrome e outros apps abertos, ele estima o uso de memória em cerca de 20 GB de 24 GB. A leitura dele: 'even on a 24 gigabyte Mac... it's at the limit again'. A verdadeira lição dos testes dele é a VRAM.
'Function-wise and interface-wise, this is so far the best local LLM app tool that I tried... Not sure I need to learn two or three of these functions, which I do not understand what they do.' 'The first picture app that really works.'
Falta: ajustar uma imagem passo a passo ('this a little bit, this a little bit'). 'Currently it's not working.' Ele pode estar usando de forma errada. 'In a year from now, this will be perfect.' Frase final: 'Smooth interface, works with smaller models, really mostly self-explanatory. Great functions that you can hand over one picture to another tool.'
A previsão do testador de que os modelos locais ficarão ao lado dos modelos de nuvem em um ou dois anos não é testada aqui.