Wie der Test verlief
Download, erster Start und das erste Modell
Der Installer ist ein 270-MB-DMG von der Website. Der Tester: „Really nice startup. Looks fake [Wortlaut in den Notizen unklar]. Nothing to be done more. Just click open.“
Der Startbildschirm „All AI Tools“ zeigt Text to image, Image to image, AI Canvas, Illusion Generator, Inpainting und Upscaler (Liste gescrollt; weitere können darunter liegen).
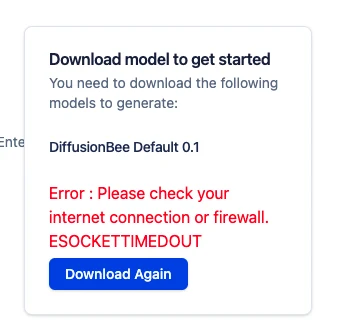
Die erste Nutzung verlangt ein Modell: 'Download model to get started. You need to download the following models to generate: DiffusionBee Default 0.1'. Der Fortschrittsbalken zeigt nur einen Prozentwert: keine Größe und keine Zeitschätzung. Die Notizen nennen 2 Prozent nach weniger als einer Minute; der Screenshot zeigt 3 Prozent.
Der Dialog sollte sagen, wie groß das Modell ist und wie lange der Download dauert.
Während ein Modell lädt, lassen sich andere Bereiche der App öffnen und nutzen (Notizen).
Der erste Download scheiterte mit 'Please check your internet connection or firewall. ESOCKETTIMEDOUT' und der einzigen Option 'Download Again'.
Der Tester vermutet, dass seine langsame Verbindung am Testort das Timeout verursacht hat. Nicht überprüft. Er berichtet, der Download sei bei 65 Prozent gewesen und habe neu beginnen müssen; ob er bei null wieder anfing, wurde nicht geprüft.
„Come on, this is so unprofessional.“ Nach dem Download: „Hurray, after download it works.“
Die Seite „Models“
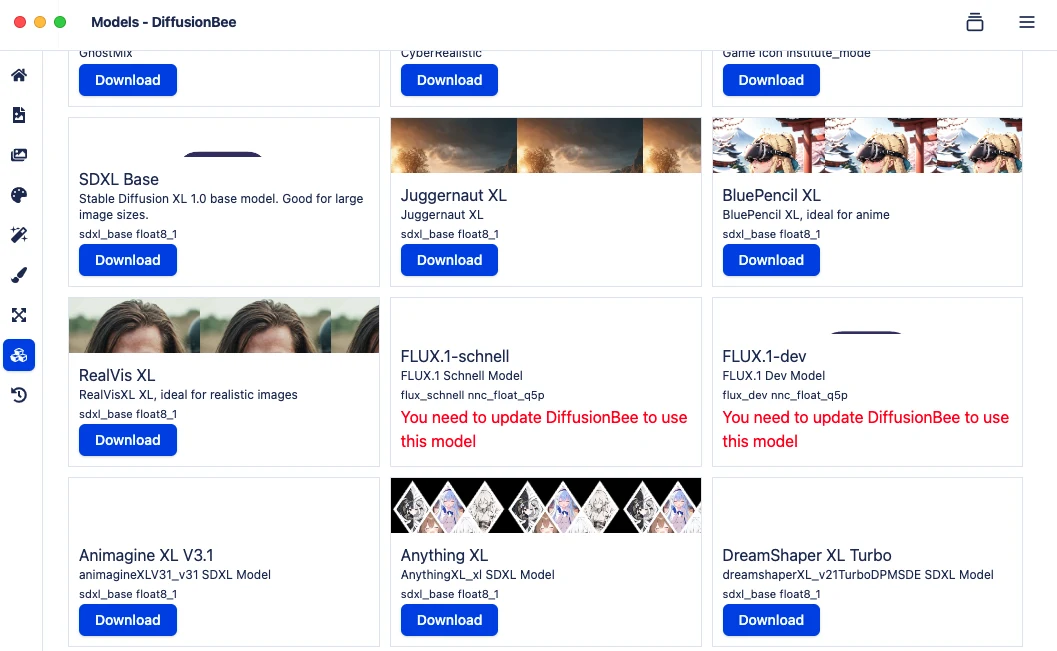
Die Seite „Models“ ist ein Raster aus Karten, jede mit Namen, einer einzeiligen Beschreibung und einem Tag wie 'sdxl_base float8_1'. Sie listet SDXL Base, Juggernaut XL, BluePencil XL, RealVis XL, Animagine XL V3.1, Anything XL, DreamShaper XL Turbo und weitere. Auf keiner Karte ist eine Download-Größe angegeben.
FLUX.1-schnell und FLUX.1-dev zeigen roten Text: 'You need to update DiffusionBee to use this model.' Der Tester hatte die App etwa zwei Minuten zuvor heruntergeladen.
Das PromptQuorum-Verzeichnis nennt als letztes Upstream-Update von DiffusionBee den 30. Oktober 2024 (mehr als ein Jahr vor diesem Test), und die Fußzeile der Hersteller-Seite lautet '© 2024'. Die README des Projekts listet SD 1.x, SD 2.x, SD XL, Inpainting, ControlNet und LoRA und erwähnt FLUX nicht. Gelesen am 16. Oktober 2026; die Release-Liste auf GitHub ließ sich nicht lesen.
Auf der Seite „Models“ gibt es eine Schaltfläche 'Import From Computer'. Der Tester schließt daraus, dass sich bereits vorhandene Modelle importieren lassen (nicht getestet).
Er fragt, warum die Seite keine Modellgrößen zeigt, damit er sehen kann, was auf seinem Rechner läuft, und warum es keine kurze Erklärung gibt, wofür jedes Modell gedacht ist. „And as no instruction, it is just like the random downloads again.“
Eine Karte für Samaritan 3d Cartoon zeigte einen Download-Balken bei 1 Prozent ohne Größe (Notizen und ein kleiner Screenshot).
Erste Bilder: ein Kreis und ein Markenmotiv
Prompt 'circle with green dot in the middle': eine weiße Scheibe mit grünem Zentrum auf grünem Hintergrund. Einstellungen: Default_SDB_0.1, 512 x 512, 1 Bild, Seed -1, 25 Schritte. Jedes Bild trägt eine Schaltfläche 'Actions'.
Als Nächstes „a real challenge“: ein langer, strukturierter Prompt für ein PromptQuorum-Markenmotiv und -Logo. Einstellungen: Default_SDB_0.1, 1024 x 1024, 3 Bilder, 25 Schritte. Der Bildschirm zeigt einen Spinner, 'Add to Queue' und 'Stop all'.
Die drei Ergebnisse sind schwarz-weiße Kästen und Karten mit verstümmelter Beschriftung. Kein lesbares 'PromptQuorum.com' und kein brauchbares Logo.
Der Tester schreibt „I assume the prompt failed because that was not requested“. Die Bedeutung ist in den Notizen unklar.
Er mag es, die Anzahl der Bilder und die Größe zu wählen. Es fehlen ihm eine Geschwindigkeitsanzeige, eine Endzeit und „some entertainment while it's working“.
Ein realer Ort: Heidelberg
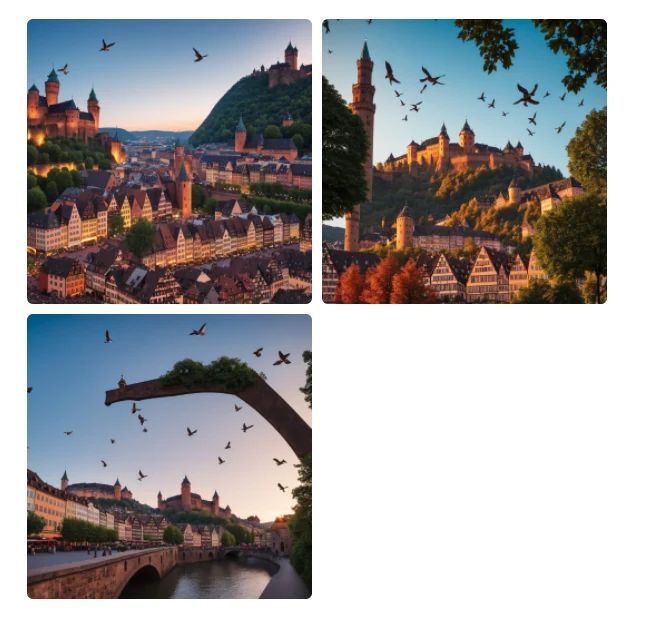
Der Prompt, vor Jahren für ein Frontier-Modell geschrieben: ein fotorealistisches Bild vom Heumarkt in Heidelberg hinauf zum Schloss, mit Vögeln und einem Sonnenaufgang hinter dem Schloss. Modell und Einstellungen nicht erfasst.
Die drei Ergebnisse zeigen ein Schloss auf einem bewaldeten Hügel über alten Fachwerkhäusern, mit Vögeln. Keines zeigt die Ansicht vom Heumarkt oder das Heidelberger Schloss als solches.
Der Tester erwartete von einem Bildmodell, einen realen Ort und dessen Blickwinkel zu kennen. Er sagt selbst: „too much expected from this tool“.
„I could have written, do a castle up the hill with a sunset and birds behind. That's the difference between frontier models with access to the internet and pure LLMs that are just generating pictures.“
Der Unterschied liegt im Internetzugang oder im Wissen über Orte. In diesem Bericht nicht getestet.
Der Tester probierte auch Bilder, die „other systems might refuse“. Die Notizen sagen, die App habe „did not say stop on anything“. Die Prompts wurden nicht erfasst, und es gibt keinen Screenshot.
Inpainting: Logo und Passant
Beim Öffnen von Inpainting wird noch ein weiteres Modell verlangt: 'ControlNet Inpaint', angezeigt bei 3 Prozent, ohne Größe.
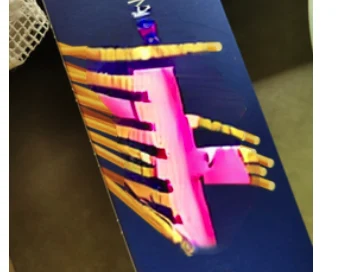
Test 1: ein Foto einer Nudelpackung. Prompt 'remove barillia logo' (Marke falsch geschrieben), mit einer Maske über dem Logo. Der erste Versuch „failed“ laut den Notizen.
Nach einem zweiten Versuch ist der Logotext nicht mehr lesbar, aber rosa Flecken bleiben, und die Spaghettistränge sind verschmiert.
„Technically, removing worked, just not putting the spaghettis back together.“
Test 2: ein Straßenfoto mit einem Passanten. Im Ergebnis ist die Person verschwunden. Der Tester: „Nearly there. If you don't expect something and I don't look for it, you don't see it.“
Der Markenname im Prompt war falsch geschrieben ('barillia'). Die Maske, nicht der Prompt, leistete die Arbeit, der Effekt ist also wahrscheinlich klein (Annahme).
AI Canvas und Bild zu Bild: Himmel und Pop-Art
AI Canvas mit dem Straßenfoto und dem Prompt 'Make the sky dark blue, real summer day' bei Input Strength 30. Das Ergebnis wurde nicht festgehalten.
„Blue sky didn't work out, or I don't understand the mechanism.“
Bild zu Bild mit 'make this into a pop art cartoon picture' auf Samaritan_3d_Cartoon_v1_s2 bei Input Strength 80.02. Das Ergebnis ist eine weichere, gedämpfte Kopie des Fotos, keine Pop-Art. Tester: „Pop art also didn't work out. Not sure why.“
Dieser Screenshot steht am Ende der Notizen, nach der Bemerkung zur Geschwindigkeit, und wird hier als Pop-Art-Versuch gelesen. Nicht bestätigt.
Ein höherer Input Strength behält mehr vom Originalbild. Datenpunkte: 21.07 und 21.46 veränderten das Bild stark, 90.13 gab es nahezu unverändert zurück, 80.02 ergab eine Beinahe-Kopie. Nur vier Einstellungen; die eigene Erklärung der App wurde nicht erfasst.
Clown, Elefant, Vulkan: Modelle, Guidance und ein Negativ-Prompt
Der Tester prüfte den Speicherbedarf mit Samaritan 3D Cartoon. Prompt 'draw a clown dancing on an elephant', 512 x 512, 1 Bild: ein tanzender Cartoon-Clown mit einer hellbraunen, elefantenähnlichen Form, die hinter ihm verschmolzen ist.
Speicherbedarf bei diesem Modell: etwa 5 GB „of my VRAM“. Methode nicht erfasst. Apple Silicon hat einen einzigen gemeinsamen Speicherpool.
Längerer Prompt (Clown auf einem Elefanten, Strand, blauer Ozean, explodierender Vulkan) mit dem Negativ-Prompt 'No blue sky!!' bei 1024 x 1024: eine blaue, muskulöse Gestalt mit feurigen Funken. Weder Clown noch Elefant, Strand oder Vulkan sind zu erkennen. Tester: „a nice result, but not really what I outlined“.
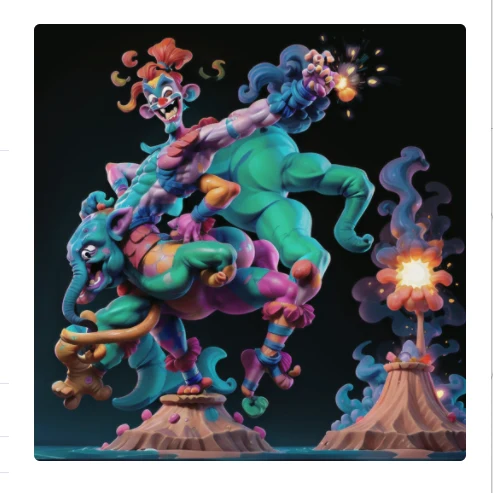
Mit der Guidance Scale auf Maximum (was laut Anweisung der App „means it should really do what I ask“ bedeutet): Ein Clown, ein elefantenähnliches Tier und ein ausbrechender Vulkan erscheinen. Strand oder blauer Ozean sind nicht zu erkennen; der Boden ist dunkel.
„I would say close, close, close or maybe perfect.“
Derselbe Prompt auf JuggernautXL_v7_f8 (ein weiterer Download): ein Clown mit Luftballons auf einem Elefanten, eine große Vulkanwolke, ein Strand mit Sonnenschirmen und blaues Wasser. Der Himmel ist blau, der Negativ-Prompt 'No blue sky!!' wurde also nicht befolgt. Tester: „Looks great, except the negative prompt was skipped.“
Er wünscht sich, dass das Fenster sagt, was ein Modell ist, statt es woanders nachschlagen zu müssen. Eine in die Notizen eingefügte Google-Antwort beschreibt Juggernaut XL als SDXL-Fine-Tune für Fotorealismus (siehe Hintergrund).
Ein fotorealistisches Paar und die Geschwindigkeit
Prompt: 'photorealist a couple in love on the beach, watching the sunset over the ocean, birds in the sky, some boats on the water, some palm trees seen'. JuggernautXL_v7_f8, 1216 x 1216, 6 Bilder angefordert. Zwei Ergebnisse wurden festgehalten.
Beide zeigen Sonnenuntergang, Palmen und Vögel. Das erste hat ein Segelboot und eine Kamera im Sand; das zweite hat mehrere Boote, aber drei Personen auf zwei Bänken, wo der Prompt ein Paar verlangte.
Das zweite Ergebnis (Abbildung 19) ist hier abgebildet.
„Looks a bit like AI, but well done, well done.“ Er mag, dass man wählt, wie viele Bilder und in welcher Größe, und dass die App „just runs and runs“, während man etwas anderes macht, und man dann das beste auswählt.
Etwa eine Minute pro Bild bei höchster Auflösung; eine Datei von etwa zwei Megabyte pro Bild. Beides wurde weder gestoppt noch auf einem Screenshot gezeigt. „Not very fast, but it's okay.“
Weitere Tests und der Schlussblick (Notizen aus dem Msty-Dokument)
Die Word-Datei zum Msty-Test enthält auch Notizen und Screenshots zu DiffusionBee. Sie werden hier als zweite Quelle genutzt. Ihr Datum und ihre Reihenfolge relativ zu den obigen Tests sind nicht erfasst; ein Dateiinfo-Screenshot vom 14. Oktober 2026, 17:58 Uhr legt denselben Tag nahe.
'Generate similar images' erzeugte aus einem Bild vier ähnliche Strandpaar-Szenen. Tester: eine schöne Funktion; er nennt sie „really impressive“.
Ein am 14. Oktober 2026 um 17:58 Uhr im Ordner Downloads gespeichertes PNG misst 38.733.330 Bytes (38,7 MB). Um welches Bild es sich handelt, ist nicht erfasst.
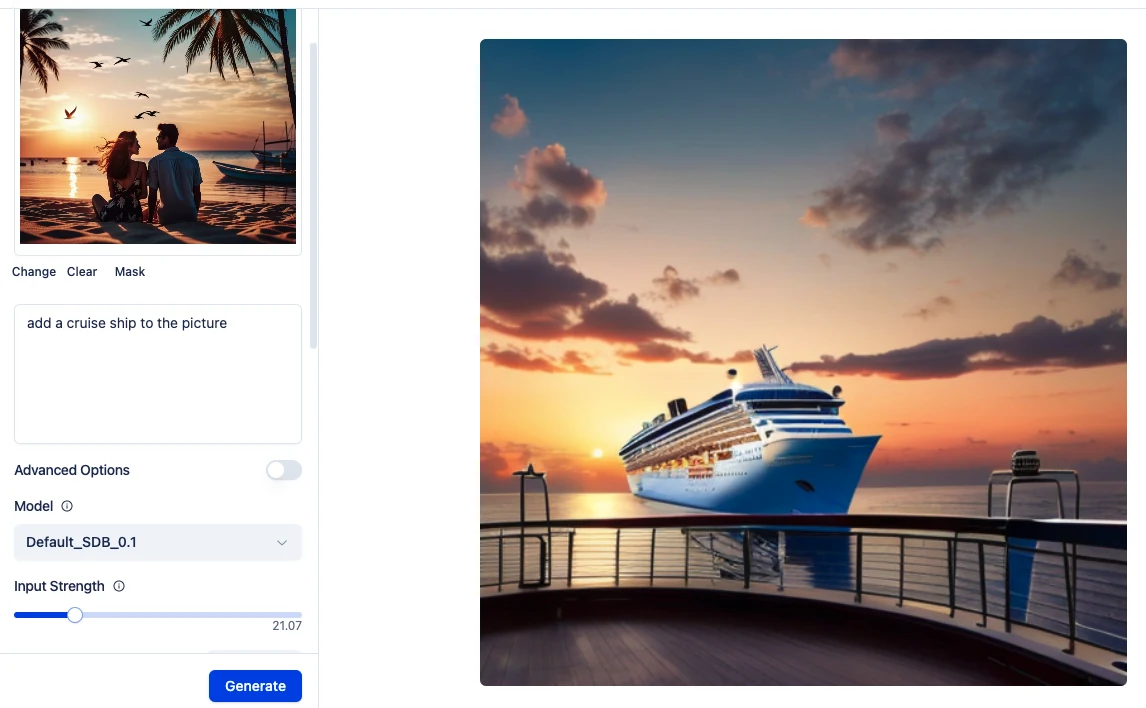
Bild zu Bild auf dem Strandpaar-Bild, Prompt 'add a cruise ship to the picture', Input Strength 21.07: Ein Kreuzfahrtschiff erscheint bei Sonnenuntergang, gesehen von einer Deckreling. Das Paar und die Palmen sind verschwunden.
Zweiter Versuch (langer Prompt, Input Strength 21.46): eine Meeresansicht bei Sonnenuntergang von einem Deck aus, mit Palme und Stühlen; kein Schiff am Horizont.
Dritter Versuch (Input Strength 90.13): Ausgabe nahezu identisch mit der Eingabe; kein Schiff.
Laut den Notizen „crashes“ die App, wenn der Input Strength auf 100 gesetzt wird. Kein Screenshot; Version nicht erfasst.
Eiffelturm-Prompt (JuggernautXL_v7_f8, 2 Bilder, Seed 770465): zwei nahezu identische Türme, von unten gesehen. Der Tester sagt, der Turm sei in Ordnung, aber Blickrichtung und Proportionen stimmten nicht, und die Bäume des französischen Gartens seien „spot on“, während der Rest um den Turm verfehlt werde.
New Yorker Skyline bei Nacht mit 'add 3 helicopters flying' (epicrealismXL_v8, 75 Schritte): Es sind mehr als drei Hubschrauber zu sehen. Tester: Sie „cannot count till three and created a second Manhattan Island“.
Ein Foto eines Essens mit dem Prompt 'make this german dinner into a cartoon style, many colors, really funny': Laut den Notizen „gave me the same picture back several times“. Das Ergebnis wurde nicht festgehalten.
Das Feld Seed hat einen Hilfetext, den der Tester als 'Starting point for iteration. Any number will do. [App?] will pick one if left blank.' zitiert. Er ist „not sure what the value is“. Das Wort vor „will pick one“ ist in den Notizen unklar.
Bei geöffneten Apps wie Claude, Word, WhatsApp und Chrome schätzt er die Speichernutzung auf etwa 20 GB von 24 GB. Seine Lesart: „even on a 24 gigabyte Mac... it's at the limit again“. Die eigentliche Lehre seines Testens sei VRAM.
„Function-wise and interface-wise, this is so far the best local LLM app tool that I tried... Not sure I need to learn two or three of these functions, which I do not understand what they do.“ „The first picture app that really works.“
Es fehlt: ein Bild Schritt für Schritt feinjustieren („this a little bit, this a little bit“). „Currently it's not working.“ Möglicherweise bedient er es falsch. „In a year from now, this will be perfect.“ Schlusszeile: „Smooth interface, works with smaller models, really mostly self-explanatory. Great functions that you can hand over one picture to another tool.“
Die Prognose des Testers, dass lokale Modelle innerhalb von ein bis zwei Jahren neben Cloud-Modellen stehen werden, wird hier nicht getestet.