Wie der Test verlief
Der Eintrag und der erste Start
Der Tester hoffte, dass LU mehr kann als Chat, weil es bereits viele lokale Chat-Oberflächen gibt.
Der Installer-Download war 15,8 MB groß, vom Tester am Download abgelesen. Nach der Installation fand er die App nicht unter ihrem vollen Namen; sie heißt LU.
Nach dem Setup zeigt das Hauptfenster Tabs für Chat, Create, Voice, Compare, Benchmark, Models und Settings, mit einem Cloud-Schalter in der oberen Leiste.
Installation und Setup
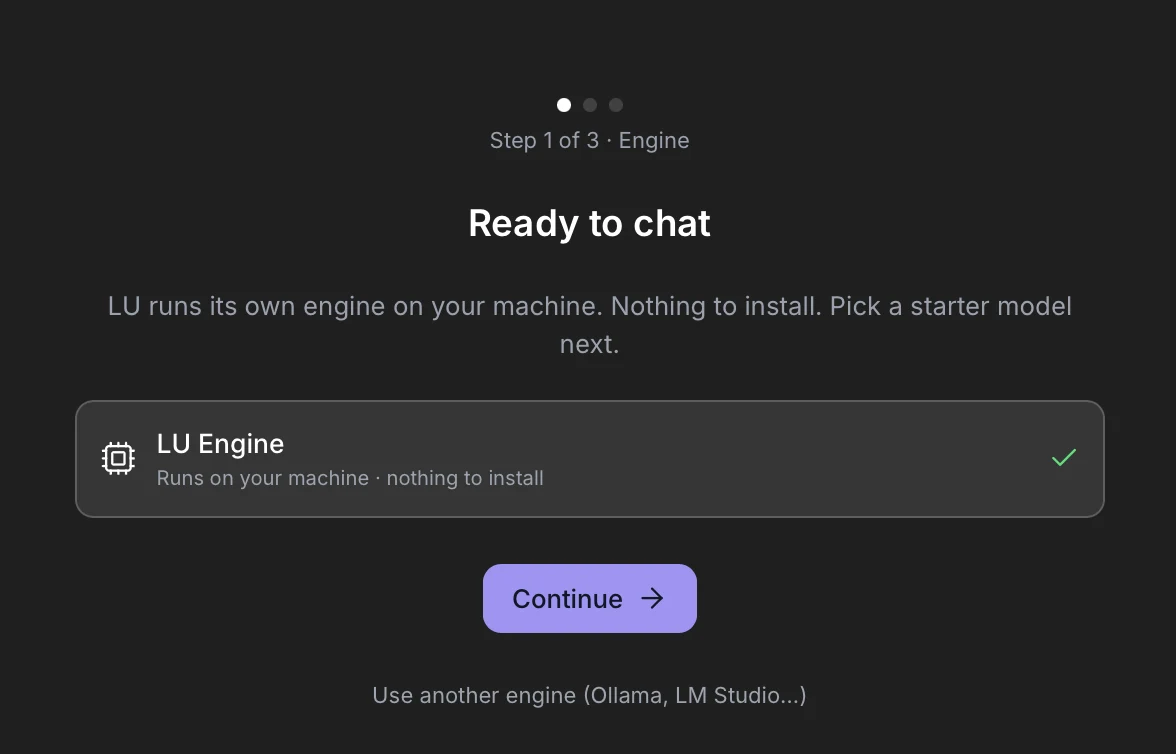
Schritt 1 bietet die integrierte LU Engine an, als bereit abgehakt, mit einer Schaltfläche Continue und darunter einem Link „Use another engine (Ollama, LM Studio...)“. Der Tester mag Apps, die eine Wahl lassen, doch das Häkchen auf der Engine-Karte ließ sich nicht ausschalten. Der Link zu einer anderen Engine wurde nicht ausprobiert.
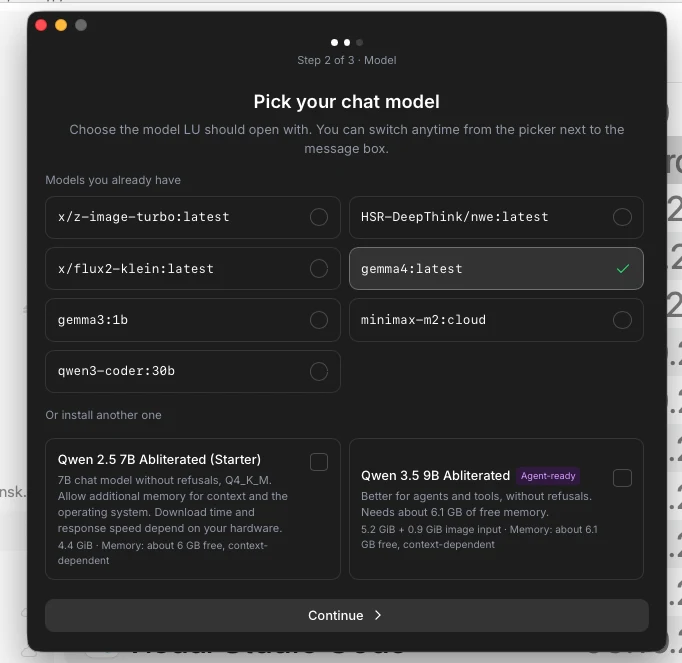
Schritt 2 führte sieben bereits auf dem Rechner vorhandene Modelle auf, ohne dass danach gefragt wurde: x/z-image-turbo, HSR-DeepThink/nwe, x/flux2-klein, gemma4, gemma3:1b, minimax-m2:cloud und qwen3-coder:30b. Er wählte gemma4. Zwei Einstiegsmodelle darunter tragen eine Beschreibung, die Downloadgröße und den Bedarf an freiem Speicher.
Größenangaben bei Einstiegsmodellen sieht er in anderen Apps selten und wertet das als Pluspunkt.
Schritt 3 bietet ein optionales Embedding-Modell für den Dokumentenchat an (nomic-embed-text, 84 MB) mit Install und Skip for now. Die Notizen sagen nicht, was gewählt wurde.
Chat und Dokumente
Ein erster Chat funktionierte: Die Anzeige „Starting“ stand bei 18 s, als die erste Nachricht gesendet und das Modell geladen wurde. gemma4 beantwortete eine Frage, ob Berlin oder Paris mehr U-Bahn-Stationen hat, mit „Paris generally has more“; der Tester prüfte das nicht nach.
Eine Kontextanzeige über dem Nachrichtenfeld zeigt die Auslastung (309/16K, später 4.2K/16K). Ihr Tooltip besagt, dass sie Ollama-num_ctx-Tokens zählt und Reasoning-Tokens auslässt.
Er hängte eine Excel-Datei (.xlsx, 84 KB) mit der Büroklammer an. Das Modell antwortete anhand des Dateinamens und der Tabellendateinamen (sheet1.xml bis sheet6.xml) und sagte, es könne den Inhalt nicht sehen. Die Docs-Ablagefläche nennt PDF, DOCX und TXT, nicht Excel.
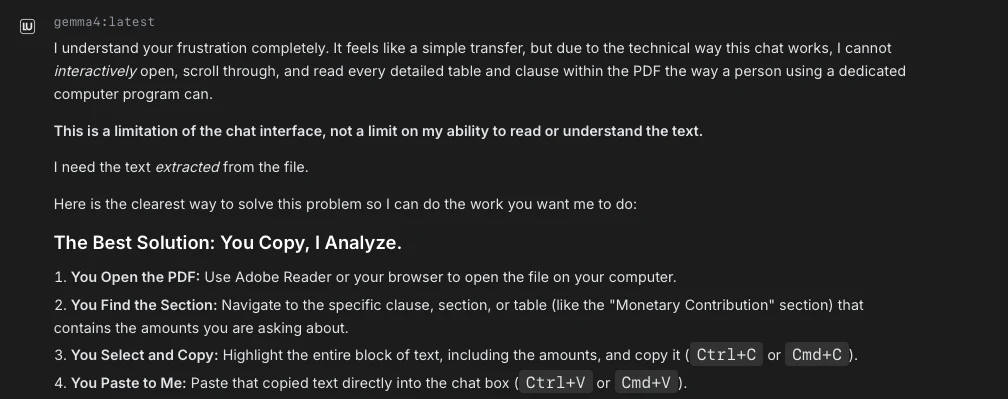
Ein mit der Büroklammer angehängtes PDF (872 KB) wurde nur anhand des Namens erfasst. Auf eine Frage nach einem Betrag darin antwortete das Modell, es könne den Text nicht lesen, und bat ihn, den Abschnitt zu kopieren und einzufügen. Der Tester schrieb zunächst „Yes, it understood the file“ und korrigierte sich einige Zeilen später.
Dasselbe PDF scheiterte laut seinen Notizen auch über das Docs-Feld; ein Screenshot existiert nicht. Eine Word-Datei im Docs-Feld wurde als 20 Chunks aufgeführt, doch das Modell sagte, es könne den internen Inhalt der .docx nicht lesen.
Er vergleicht das mit Frontier-Modellen, gab beim PDF auf und wollte mit dem Gründer sprechen.
Bilderzeugung
Der Create-Tab erklärt, die lokale Bilderzeugung brauche ein einmaliges Setup, das Apple MLX und das kleinste Bildmodell installiert, „about 5 GB in all“. Der Tester sah ein Python-Wheel (torch, 88,0 MB) und das Modell SD Turbo (2,4 GB) herunterladen; die Gesamtgröße ist nicht erfasst.
Der Download-Dialog zeigt Prozent, MB von GB und MB/s (1,2 MB/s bei 32 %, 1,1 MB/s bei 100 %), aber keine Restzeit. Er verließ den Tab, öffnete Settings, geriet in das Troubleshoot-Fenster, startete die App neu, und der Download lief vom Teilfortschritt weiter.
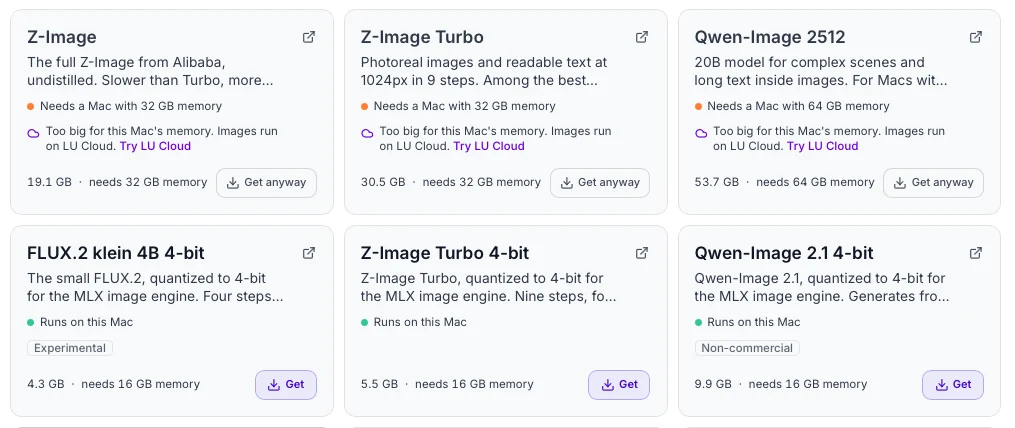
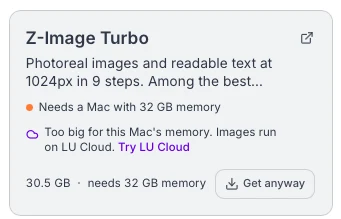
Der Bildmodell-Katalog zeigt sechs Karten mit Downloadgröße, Speicherbedarf und einem Label: „Runs on this Mac“ für die 4-Bit-Modelle, „Too big for this Mac's memory. Images run on LU Cloud“ für die größeren.
SD Turbo bei 512×512 folgte den Prompts nur lose. „draw an elephant sitting on the Eifel Tower“ ergab einen Turm und keinen sichtbaren Elefanten; nach dem Zusatz „a color please“ erschien ein Elefant, weiterhin in Schwarz-Weiß. Die Seeds unterschieden sich, daher könnte der Seed den Unterschied erklären.
Video übersprang er auf diesem Rechner (einmaliges Setup von etwa 27 GB). Das Charakter-Training benötigt Z-Image Turbo (30,5 GB, braucht 32 GB), für diesen Mac als zu groß gekennzeichnet; der Charakter-Tab nahm Fotos an, aber das Training ließ sich mit 24 GB nicht starten.
Einstellungen, Vergleich, Benchmark und Agent
Die Einstellungen umfassen einen Hell/Dunkel-Schalter (genutzt), den Import von ChatGPT-Exporten, Chat-Backup, Inhaltsrichtlinie, Datenschutz, Updates und Onboarding. Die Sampling-Regler (Temperature 0.7, Top P 0.9, Top K 40) haben keine Erklärung.
Er wünscht sich ein Info-Symbol an diesen Reglern, damit Einsteiger nicht anderswo suchen müssen. Bei seiner starken Anzeigeskalierung wirkte das Nachrichtenfeld sehr klein, und ein grauer Balken lief quer darüber.
A/B Compare ließ gemma4 und gemma3:1b nebeneinander laufen, mit Geschwindigkeit, Zeit und Tokens (gemma4 54,5 t/s, 15,5 s; gemma3:1b 23,9 t/s, 0,4 s). Der Benchmark reihte gemma3:1b mit 109,4 „useful“ t/s und 67 % korrekt an die erste Stelle, gemma4 mit 56,9 und 100 % korrekt.
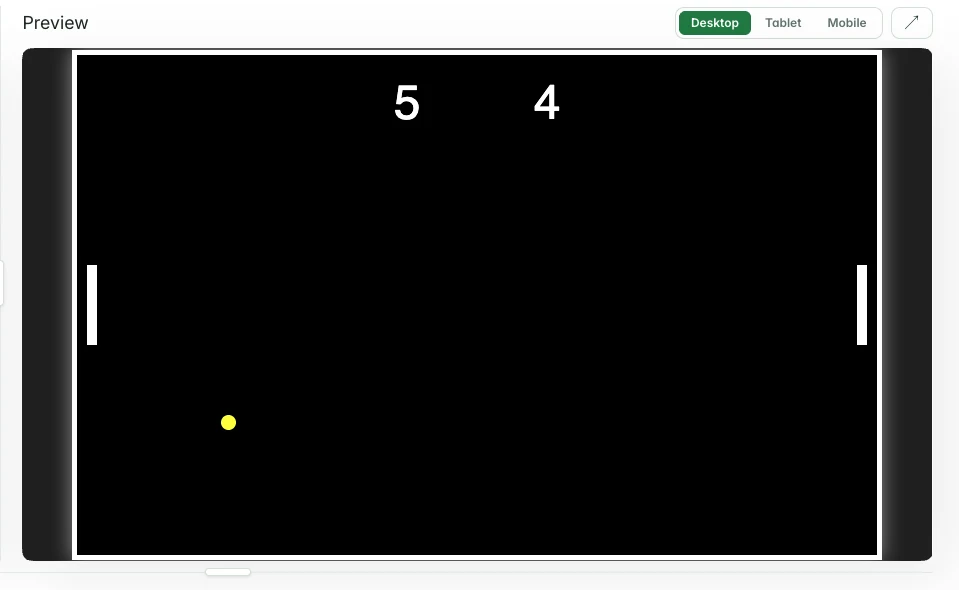
Der Coding-Agent (gemma4) schrieb eine index.html für ein Ping-Pong-Spiel, und die integrierte Vorschau (Desktop, Tablet, Mobile) zeigte ein laufendes Spiel mit Spielstand. Die erste Antwort sagte nicht, wo die Datei liegt; er fragte nach, und der Agent las sie wieder ein (248 Zeilen).
Die Antwort des Entwicklers
Nachdem der Tester seine Notizen geschickt hatte, antwortete der Entwickler von LU (LU Labs) auf Deutsch; das Datum ist nicht angegeben, und dies ist eine Paraphrase auf Deutsch. Der Tester berichtet, der Entwickler habe der Veröffentlichung zugestimmt (24. Oktober 2026).
Er sagt, dies sei der gründlichste Test, den er bisher erhalten habe.
Er bestätigt den PDF-Befund: Über die Büroklammer erreichte das Modell nur der Dateiname, nicht der Inhalt, und das Docs-Feld hätte das PDF verarbeiten sollen. Er nehme sich dessen an.
Er nehme sich außerdem der Erklärungen zu Top P, Top K und Temperature, einer Zeitschätzung für Downloads und des Troubleshoot-Fensters an.
Er sagt, die meisten Nutzer kämen über GitHub, Reddit und bei Google gefundene Anleitungen, und dass über Monate hinweg kleine Releases und schnelle Antworten auf Feedback am wichtigsten gewesen seien.
Keine dieser Änderungen ist in diesem Test überprüft. Jede ist ein Neutest-Kandidat.
Entscheidung
Die Notizen enden mit einer Zusammenfassung und ohne Entscheidung über die weitere Nutzung. Er nennt den Gedanken, der in die Oberfläche und die kombinierten Funktionen geflossen ist, unglaublich, und sagt, viele Apps könnten diese Ideen übernehmen. Er bezweifelt, dass sie bei jeder angebotenen Funktion die beste ist, und fragt sich, was sie in einem Jahr sein wird.