Cómo fue la prueba
La ficha y el primer arranque
El evaluador esperaba que LU hiciera más que chatear, porque ya existen muchas interfaces de chat locales.
La descarga del instalador fue de 15.8 MB, leídos por el evaluador en la propia descarga. Tras instalar no encontró la app por su nombre completo; se llama LU.
Tras la configuración, la ventana principal muestra las pestañas Chat, Create, Voice, Compare, Benchmark, Models y Settings, con un interruptor Cloud en la barra superior.
Instalación y configuración
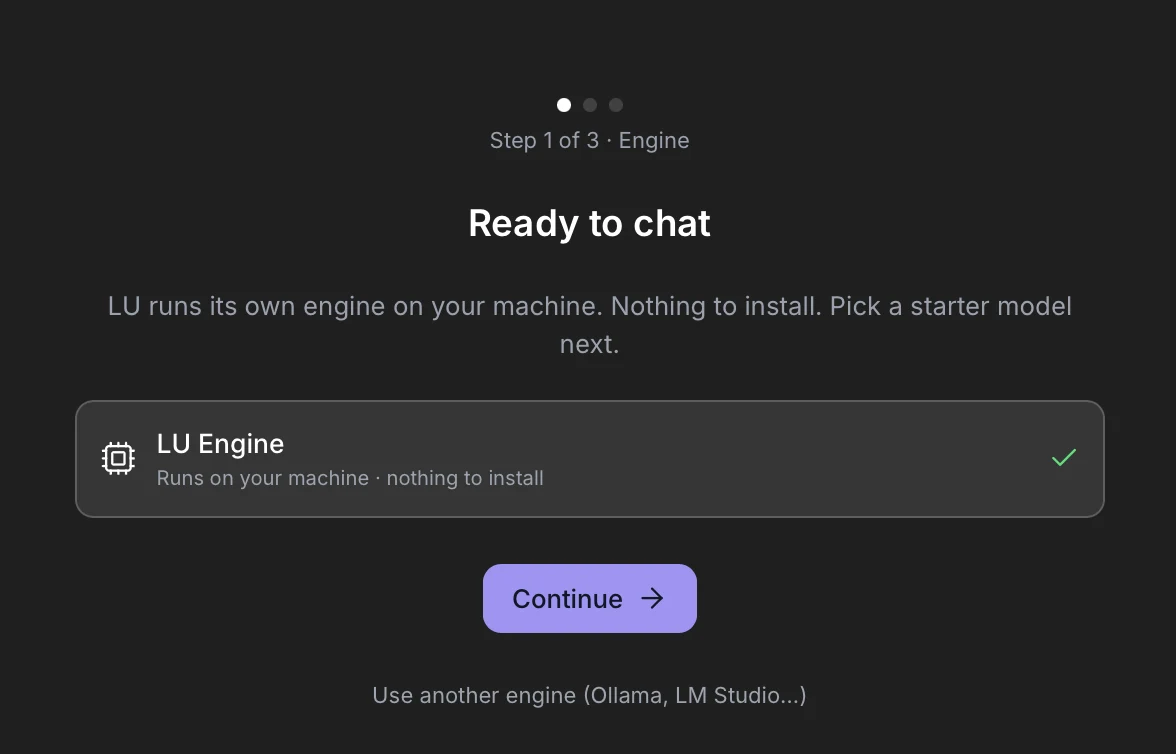
El paso 1 ofrece el LU Engine integrado, marcado como listo, con un botón Continue y debajo un enlace "Use another engine (Ollama, LM Studio...)". Al evaluador le gustan las apps que dejan elegir, pero la marca de la tarjeta del motor no se desactivaba. No se probó el enlace de otro motor.
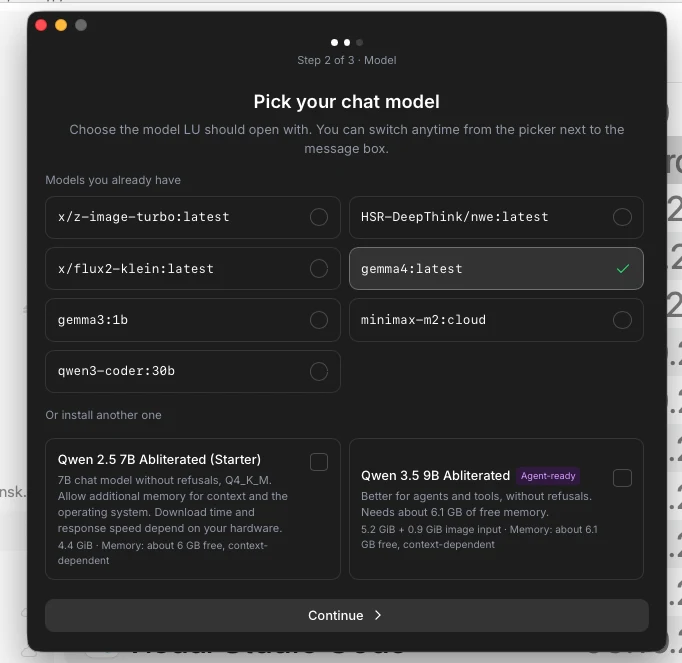
El paso 2 listó siete modelos que ya estaban en el equipo sin que se pidiera: x/z-image-turbo, HSR-DeepThink/nwe, x/flux2-klein, gemma4, gemma3:1b, minimax-m2:cloud y qwen3-coder:30b. Eligió gemma4. Debajo, dos modelos iniciales incluyen una descripción, el tamaño de descarga y la memoria libre necesaria.
Rara vez ve tamaños en los modelos iniciales de otras apps y lo cuenta como un punto a favor.
El paso 3 ofrece un modelo de embeddings opcional para Document Chat (nomic-embed-text, 84 MB) con Install y Skip for now. Las notas no dicen cuál se eligió.
Chat y documentos
Un primer chat funcionó: el indicador "Starting" marcaba 18 s cuando se envió el primer mensaje y se cargó el modelo. gemma4 respondió a la pregunta de si Berlín o París tiene más estaciones de metro con "Paris generally has more" (París suele tener más); el evaluador no lo verificó.
Un medidor de contexto sobre el cuadro de mensajes muestra el uso (309/16K, luego 4.2K/16K). Su tooltip dice que cuenta tokens num_ctx de Ollama y no incluye los tokens de razonamiento.
Adjuntó un archivo de Excel (.xlsx, 84 KB) con el clip. El modelo respondió a partir del nombre del archivo y de los nombres de las hojas (sheet1.xml a sheet6.xml) y dijo que no podía ver el contenido. La zona de arrastre de Docs lista PDF, DOCX y TXT, no Excel.
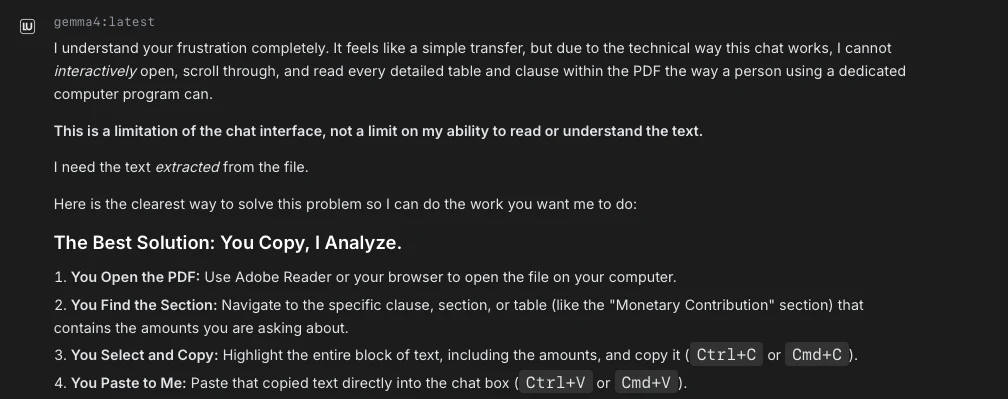
Un PDF (872 KB) adjuntado con el clip solo se leyó por el nombre. Ante una pregunta sobre un importe del documento, la respuesta fue que el modelo no podía leer el texto y le pidió copiar y pegar la sección. El evaluador escribió primero "Yes, it understood the file" (sí, entendió el archivo) y se corrigió unas líneas después.
El mismo PDF a través del campo Docs también falló, según sus notas; no hay captura. Un archivo de Word en el campo Docs apareció como 20 fragmentos, pero el modelo dijo que no podía leer el contenido interno del .docx.
Lo compara con los modelos de frontera, renunció al PDF y planeó hablar con el fundador.
Generación de imágenes
La pestaña Create dice que la generación local de imágenes necesita una configuración única que instala Apple MLX y el modelo de imagen más pequeño, "about 5 GB in all" (unos 5 GB en total). El evaluador vio descargarse una rueda de Python (torch, 88.0 MB) y el modelo SD Turbo (2.4 GB); el total no está registrado.
El cuadro de descarga muestra el porcentaje, los MB de GB y los MB/s (1.2 MB/s al 32 %, 1.1 MB/s al 100 %), pero no el tiempo restante. Salió de la pestaña, abrió Settings, se topó con la ventana Troubleshoot, reinició la app y la descarga continuó desde el progreso parcial.
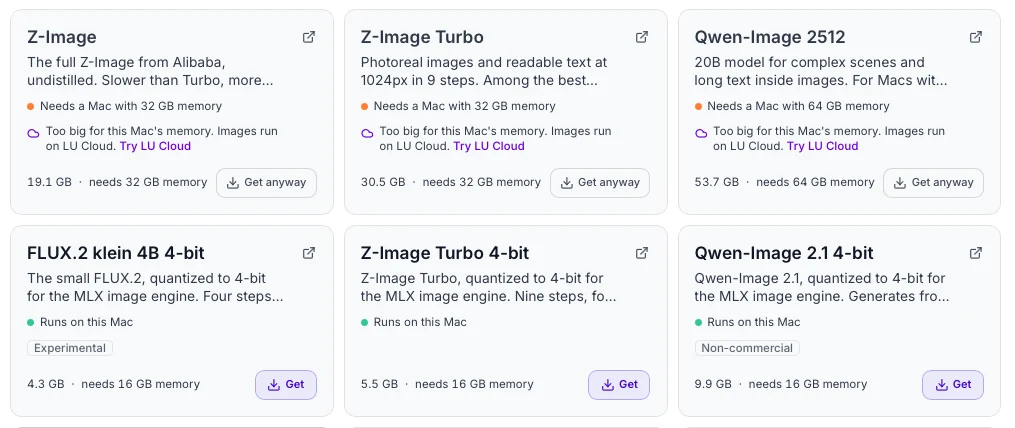
El catálogo de modelos de imagen muestra seis tarjetas con tamaño de descarga, memoria necesaria y una etiqueta: "Runs on this Mac" para los modelos de 4 bits y "Too big for this Mac's memory. Images run on LU Cloud" para los más grandes.
SD Turbo a 512×512 siguió los prompts de forma imprecisa. "draw an elephant sitting on the Eifel Tower" dio una torre y ningún elefante visible; al añadir "a color please" apareció un elefante, aún en blanco y negro. Las semillas eran distintas, así que la semilla puede explicar la diferencia.
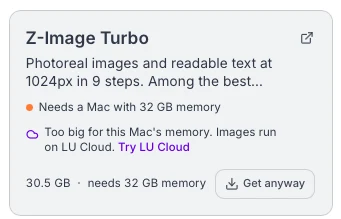
Omitió el vídeo en este equipo (configuración única de unos 27 GB). El entrenamiento de personajes requiere Z-Image Turbo (30.5 GB, necesita 32 GB), marcado como demasiado grande para este Mac; la pestaña Character aceptó fotos, pero el entrenamiento no pudo empezar con 24 GB.
Settings, comparación, benchmark y agente
Settings incluye un interruptor de tema claro/oscuro (usado), importación de exportaciones de ChatGPT, copia de seguridad de chats, política de contenido, privacidad, actualizaciones y onboarding. Los controles deslizantes de muestreo (Temperature 0.7, Top P 0.9, Top K 40) no tienen explicación.
Quiere un icono de información en esos controles para que los principiantes no tengan que buscar en otro sitio. Con su escalado de pantalla grande, el cuadro de mensajes le pareció muy pequeño y una barra gris lo cruzaba.
A/B Compare ejecutó gemma4 y gemma3:1b en paralelo con velocidad, tiempo y tokens (gemma4 54.5 t/s, 15.5 s; gemma3:1b 23.9 t/s, 0.4 s). Benchmark puso primero a gemma3:1b con 109.4 t/s "useful" y 67 % de aciertos, y a gemma4 con 56.9 y 100 % de aciertos.
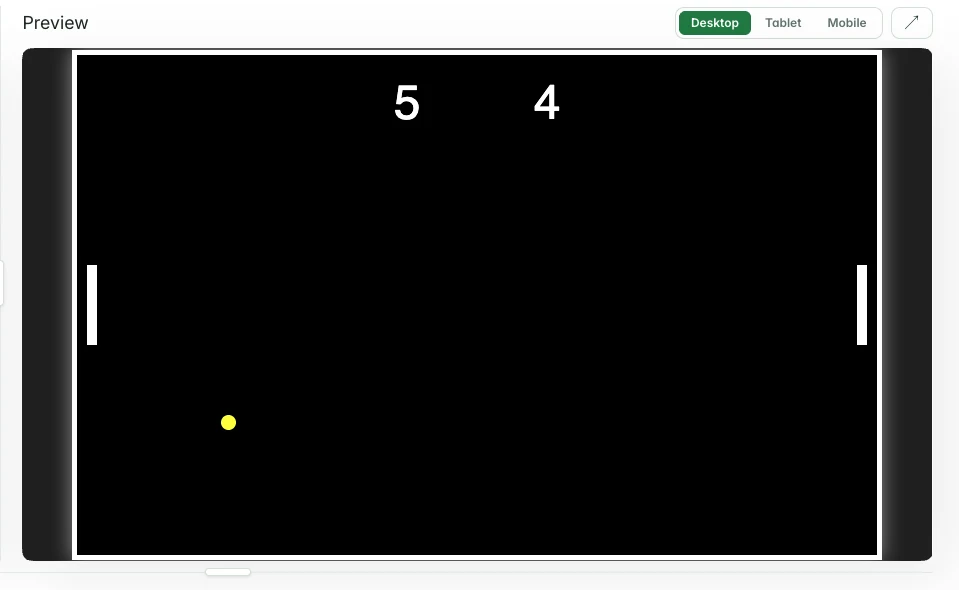
El Coding Agent (gemma4) escribió un index.html para un juego de ping-pong y la vista previa integrada (Desktop, Tablet, Mobile) mostró un juego en marcha con marcador. La primera respuesta no decía dónde estaba el archivo; lo preguntó y el agente lo leyó de vuelta (248 líneas).
La respuesta del desarrollador
Tras recibir las notas del evaluador, el desarrollador de LU (LU Labs) respondió en alemán; la fecha no se indica y esto es una paráfrasis en español. El evaluador informa de que el desarrollador aceptó su publicación (2026-10-24).
Dice que es la prueba más minuciosa que ha recibido hasta ahora.
Confirma el hallazgo del PDF: con el clip solo llegó al modelo el nombre del archivo, no el contenido, y el campo Docs debería haber gestionado el PDF. Se encargará de ello.
También se ocupará de las explicaciones de Top P, Top K y Temperature, de una estimación del tiempo de las descargas y de la ventana Troubleshoot.
Dice que la mayoría de los usuarios llegan a través de GitHub, Reddit y guías encontradas en Google, y que lo que más pesó fueron las versiones pequeñas y las respuestas rápidas a los comentarios, mantenidas durante meses.
Ninguno de estos cambios está verificado en esta prueba. Cada uno es un elemento de nueva prueba.
Decisión
Las notas terminan con un resumen y sin decisión sobre seguir usándola. Califica de increíble el cuidado puesto en la interfaz y la combinación de funciones, y dice que muchas apps podrían copiar estas ideas. Duda de que sea la mejor en cada función que ofrece y se pregunta cómo será dentro de un año.