Déroulement du test
L'annonce et le premier lancement
Le testeur espérait que LU fasse plus que du chat, puisqu'il existe déjà beaucoup d'interfaces de chat locales.
Le téléchargement de l'installateur pesait 15.8 MB, lu par le testeur dans le téléchargement. Après l'installation, il n'a pas retrouvé l'appli par son nom complet ; elle s'appelle LU.
Après la configuration, la fenêtre principale affiche des onglets Chat, Create, Voice, Compare, Benchmark, Models et Settings, avec un interrupteur Cloud dans la barre supérieure.
Installation et configuration
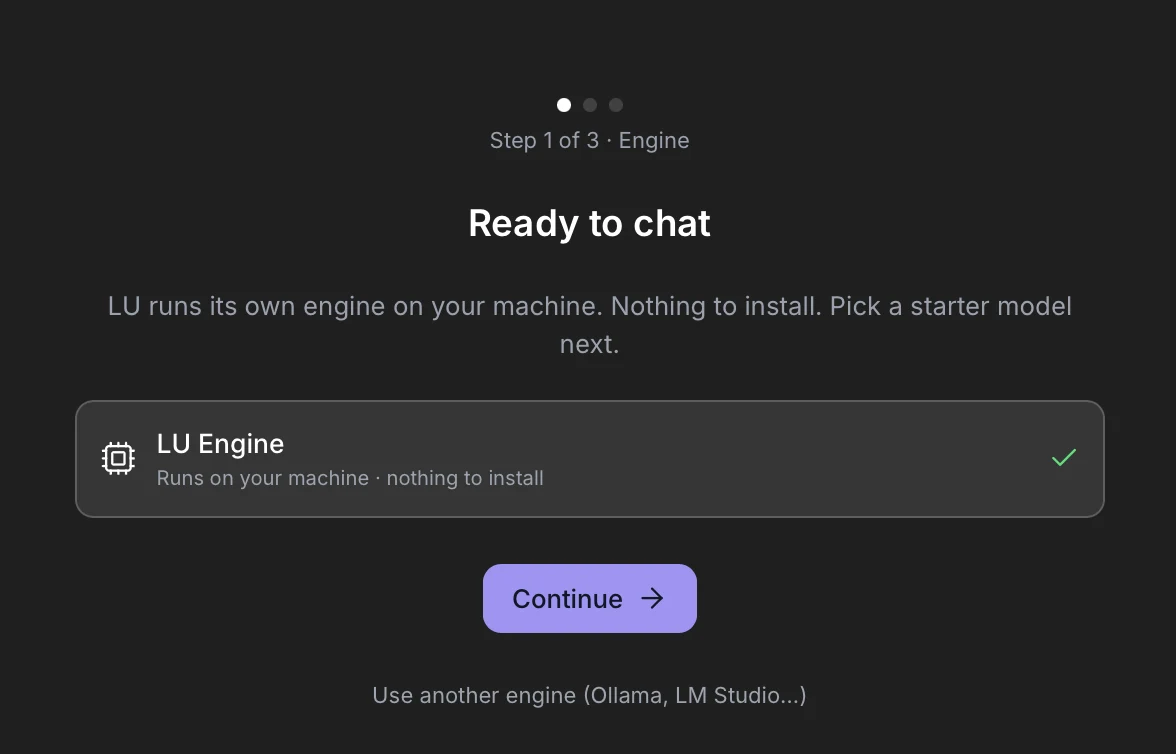
L'étape 1 propose le moteur intégré LU Engine, coché comme prêt, avec un bouton Continue et, en dessous, un lien "Use another engine (Ollama, LM Studio...)". Le testeur apprécie les applis qui laissent le choix, mais la coche sur la carte du moteur ne se désactivait pas. Le lien vers un autre moteur n'a pas été essayé.
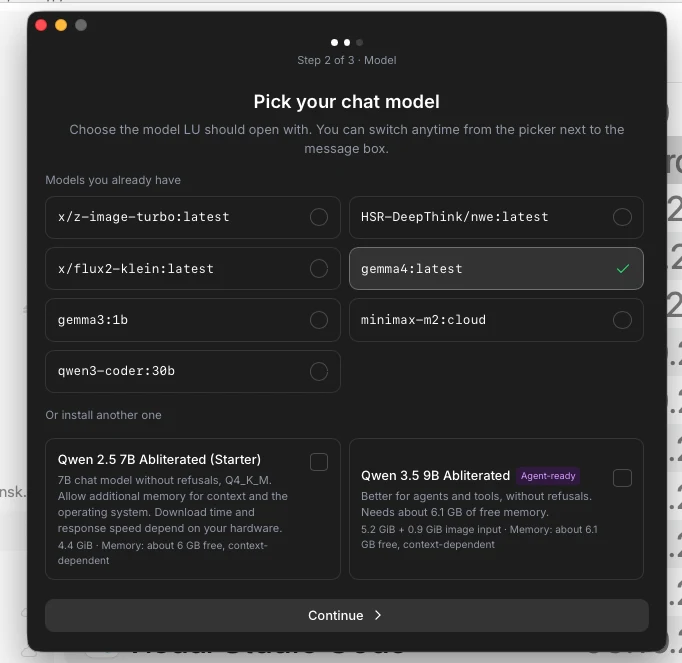
L'étape 2 a listé sept modèles déjà présents sur la machine, sans qu'on le demande : x/z-image-turbo, HSR-DeepThink/nwe, x/flux2-klein, gemma4, gemma3:1b, minimax-m2:cloud et qwen3-coder:30b. Il a choisi gemma4. Deux modèles de départ, plus bas, affichent une description, la taille de téléchargement et la mémoire libre requise.
Il voit rarement la taille des modèles de départ dans d'autres applis et y voit un point positif.
L'étape 3 propose un modèle d'embedding facultatif pour Document Chat (nomic-embed-text, 84 MB), avec Install et Skip for now. Les notes ne disent pas lequel a été choisi.
Chat et documents
Un premier chat a fonctionné : l'indicateur "Starting" affichait 18 s à l'envoi du premier message, le temps de charger le modèle. À la question « Berlin ou Paris : où y a-t-il le plus de stations de métro ? », gemma4 a répondu "Paris generally has more" ; le testeur n'a pas vérifié.
Un compteur de contexte au-dessus de la zone de saisie indique l'usage (309/16K, puis 4.2K/16K). Son infobulle précise qu'il compte les tokens num_ctx d'Ollama et exclut les tokens de raisonnement.
Il a joint un fichier Excel (.xlsx, 84 KB) avec le trombone. Le modèle a répondu à partir du nom du fichier et des noms de fichiers des feuilles (sheet1.xml à sheet6.xml) et a dit ne pas voir le contenu. La zone de dépôt Docs liste PDF, DOCX et TXT, pas Excel.
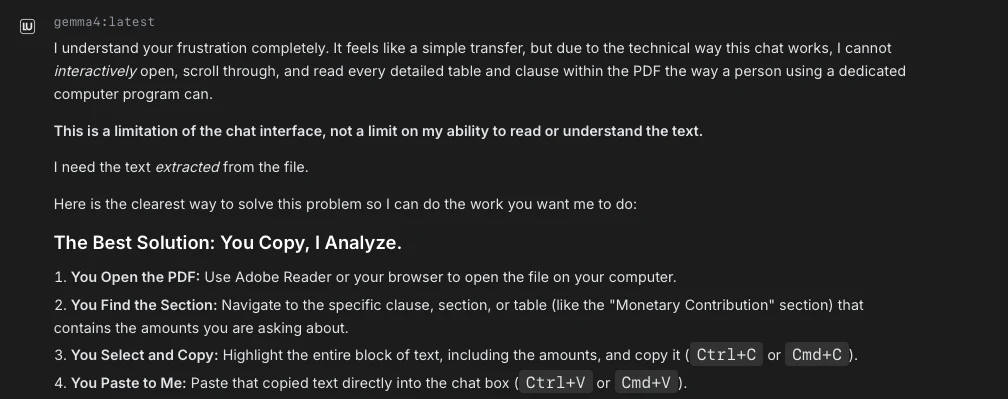
Un PDF (872 KB) joint avec le trombone n'a été lu que par son nom. À une question sur un montant du document, le modèle a répondu qu'il ne pouvait pas lire le texte et lui a demandé de copier-coller la section. Le testeur a d'abord écrit « Yes, it understood the file » puis s'est corrigé quelques lignes plus loin.
Le même PDF via le champ Docs a aussi échoué, d'après ses notes ; il n'existe pas de capture d'écran. Un fichier Word dans le champ Docs a été listé en 20 fragments (chunks), mais le modèle a dit ne pas pouvoir lire le contenu interne du .docx.
Il compare avec les modèles de pointe, a renoncé au PDF et comptait en parler au fondateur.
Génération d'images
L'onglet Create indique que la génération d'images locale exige une configuration unique qui installe Apple MLX et le plus petit modèle d'image, "about 5 GB in all". Le testeur a vu télécharger une wheel Python (torch, 88.0 MB) et le modèle SD Turbo (2.4 GB) ; le total n'est pas consigné.
La boîte de dialogue de téléchargement affiche le pourcentage, les MB sur GB et les MB/s (1.2 MB/s à 32 %, 1.1 MB/s à 100 %), mais pas le temps restant. Il a quitté l'onglet, ouvert Settings, rencontré la fenêtre Troubleshoot, redémarré l'appli, et le téléchargement a repris à partir de la progression partielle.
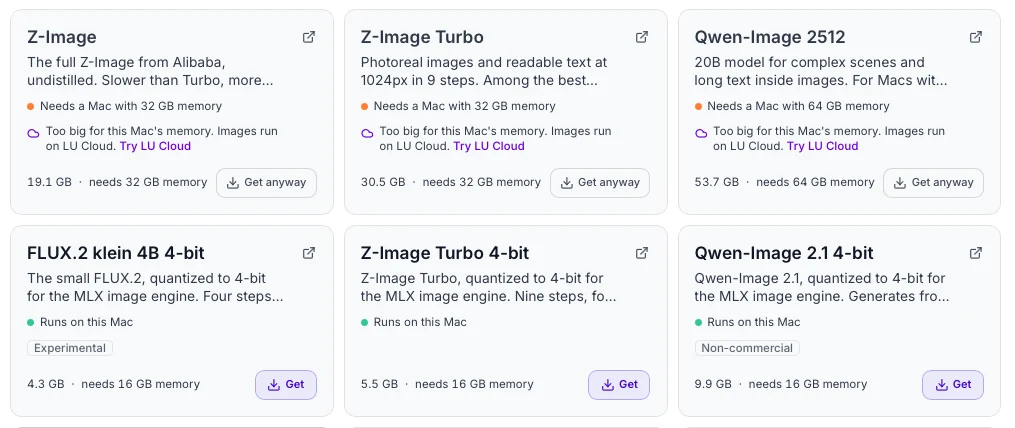
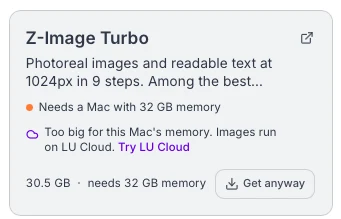
Le catalogue des modèles d'image présente six cartes avec la taille de téléchargement, la mémoire requise et une étiquette : "Runs on this Mac" pour les modèles 4 bits, "Too big for this Mac's memory. Images run on LU Cloud" pour les plus gros.
SD Turbo en 512×512 a suivi les prompts de façon approximative. "draw an elephant sitting on the Eifel Tower" a donné une tour sans éléphant visible ; en ajoutant "a color please", un éléphant est apparu, toujours en noir et blanc. Les seeds différaient, donc le seed peut expliquer la différence.
Il a laissé de côté la vidéo sur cette machine (configuration unique d'environ 27 GB). L'entraînement de personnage exige Z-Image Turbo (30.5 GB, 32 GB requis), signalé comme trop gros pour ce Mac ; l'onglet Character a accepté des photos, mais l'entraînement n'a pas pu démarrer avec 24 GB.
Réglages, comparaison, benchmark et agent
Les réglages comprennent un interrupteur clair/sombre (utilisé), l'import d'exports ChatGPT, la sauvegarde des conversations, la politique de contenu, la confidentialité, les mises à jour et l'onboarding. Les curseurs d'échantillonnage (Temperature 0.7, Top P 0.9, Top K 40) ne sont pas expliqués.
Il voudrait une icône d'information sur ces curseurs pour que les débutants n'aient pas à chercher ailleurs. Avec son échelle d'affichage élevée, la zone de saisie lui a paru très petite et une barre grise la traversait.
A/B Compare a fait tourner gemma4 et gemma3:1b côte à côte, avec vitesse, durée et tokens (gemma4 54.5 t/s, 15.5 s ; gemma3:1b 23.9 t/s, 0.4 s). Benchmark a classé gemma3:1b premier avec 109.4 t/s "useful" et 67 % de réponses correctes, gemma4 avec 56.9 et 100 % de réponses correctes.
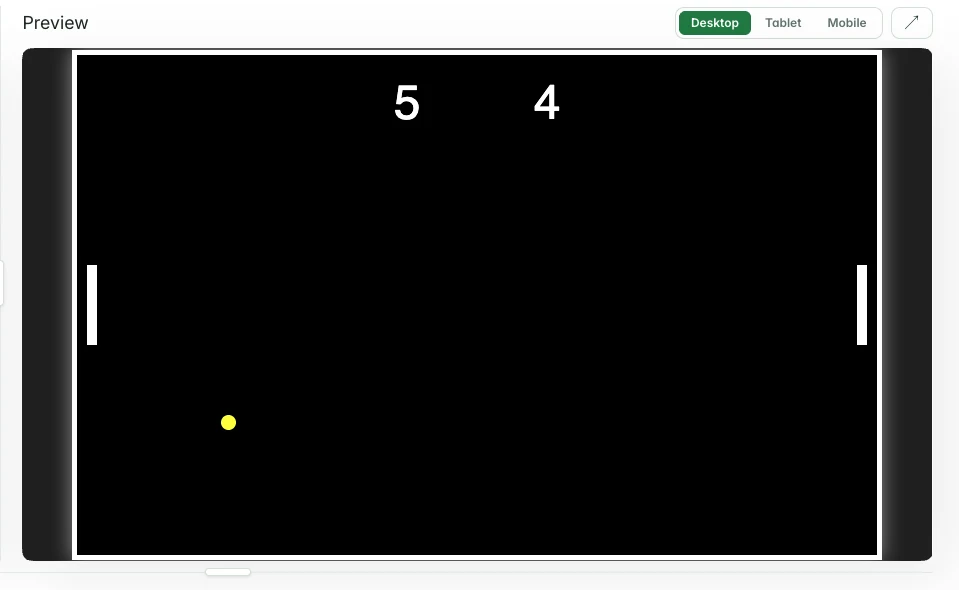
Le Coding Agent (gemma4) a écrit un index.html pour un jeu de ping-pong, et l'aperçu intégré (Desktop, Tablet, Mobile) a montré un jeu en marche avec un score. La première réponse n'indiquait pas où se trouvait le fichier ; il a demandé et l'agent l'a relu (248 lignes).
La réponse du développeur
Après l'envoi des notes par le testeur, le développeur de LU (LU Labs) a répondu en allemand ; la date n'est pas indiquée et ce qui suit est une paraphrase en français. Le testeur indique que le développeur a accepté la publication (2026-10-24).
Il dit que c'est le test le plus approfondi qu'il ait reçu jusqu'ici.
Il confirme le constat sur le PDF : via le trombone, seul le nom du fichier est parvenu au modèle, pas le contenu, et le champ Docs aurait dû traiter le PDF. Il s'en occupe.
Il s'occupe aussi des explications sur Top P, Top K et Temperature, d'une estimation de durée pour les téléchargements et de la fenêtre Troubleshoot.
Il dit que la plupart des utilisateurs arrivent par GitHub, Reddit et des guides trouvés sur Google, et que de petites versions et des réponses rapides aux retours, tenues pendant des mois, ont compté le plus.
Aucun de ces changements n'est vérifié dans ce test. Chacun est à retester.
Décision
Les notes se terminent par un résumé, sans décision sur la poursuite de l'usage. Il juge incroyable le soin porté à l'interface et la combinaison des fonctions, et dit que beaucoup d'applis pourraient reprendre ces idées. Il doute qu'elle soit la meilleure pour chaque fonction proposée et se demande ce qu'elle sera dans un an.