Figure 1Premier lancement. Un modèle local (Gemma 4 E2B, 3,6 GB, curseur de puissance sur 'Capable') ou un fournisseur connecté. Un avis jaune indique 'Add at least one model before continuing with a connected provider.' et le bouton Continue est grisé.
Verdict
Appréciation générale
Testé en partie. Ce que le testeur a essayé a surtout fonctionné : Msty a repris ses modèles Ollama existants, un chat texte et un envoi d'image ont fonctionné, et le Model Hub indique si un modèle tient sur le Mac. Ce qui n'a pas abouti : le site et les premiers écrans ne disent pas à quoi sert l'application, un envoi de fichier a tourné en boucle entre une base de connaissances et le chat, et aucun modèle d'image n'a pu être utilisé dans Media Studio. Les notes s'arrêtent au Model Matchmaker sans conclusion sur Msty.
Adéquation à l’usage du testeur
Non consigné. La propre question du testeur, 'why should a home user use it', reste sans réponse dans les notes. Le jugement final du fichier Word décrit une autre application et n'est pas repris ici.
ObservéLes modèles Ollama existants sont apparus dans le sélecteur de modèles de Msty. Les notes ne consignent aucun second téléchargement de modèle.
ObservéDeux choses n'ont pas fonctionné comme le testeur l'attendait : l'envoi de fichier a tourné en boucle entre la base de connaissances et le chat, et aucun modèle d'image local n'a pu être utilisé dans Media Studio.
Avis du testeurLe testeur n'a pas pu déduire du site à quoi sert Msty pour un particulier. Les notes ne contiennent aucun verdict final sur Msty.
Grille de scores Statut : Partiel
Installationn/dTaille du téléchargement consignée (246 MB). Les étapes d'installation et les invites macOS n'ont pas été consignées.
Prise en main et choix du modèle3/5Les modèles Ollama apparaissent à côté des fournisseurs hébergés et les cartes de modèles portent une indication d'adéquation matérielle. Les premiers écrans ne disent pas à quoi sert l'application, et la connexion à Ollama n'était pas évidente pour le testeur.
Fonction principale4/5Le chat avec un modèle Ollama et l'entrée d'image ont fonctionné. Une seule réponse texte, un seul test de vision et un seul test de fichier ; la qualité des réponses n'a pas été évaluée.
Guidage et itération2/5L'envoi de fichier a tourné en boucle entre une base de connaissances et le chat. Les modèles uniquement image et ceux marqués cloud figurent dans le même sélecteur que les modèles de chat.
Performancesn/dUne seule mesure : 52,81 tok/s sur une réponse (nom du modèle en partie coupé). Insuffisant pour noter.
Documentationn/dNon testée.
Confiance et confidentialitén/dNon audité. Le fournisseur revendique un 'privacy-first workspace' ; le sélecteur contient aussi un modèle ':cloud' et des fournisseurs hébergés. Le fonctionnement hors ligne n'a pas été testé.
Désinstallationn/dNon testée.
Les scores sont des propositions tirées des éléments de preuve ci-dessous (1 = médiocre, 5 = très bon). Il revient au testeur de les confirmer.
Détails du test
Application
Msty Studio (bureau) de CloudStack, LLC. Les notes l'écrivent 'Mysty' et 'Misty' (transcription vocale) ; ce rapport utilise l'orthographe du fournisseur. Annonce éditeur
Version
Non consignée. Pour le contexte : le journal des modifications du fournisseur cite Msty Studio 3.0.0 Beta 15 (7 octobre 2026) et 2.9.11 (15 septembre 2026) parmi les versions récentes.
Testeur
Hans Kuepper, fondateur de PromptQuorum
Début
13 octobre 2026 (heure non consignée). Les notes disent que le test durerait 'over the next two days'. Observé
Fin
Non consignée
Matériel
Mac de la famille Apple M3, 24 GB. Les notes disent 'M3, 24 GB'. La machine de test standard est un MacBook Pro avec M3 Pro et 24 GB de mémoire unifiée ; même machine supposée. L'application a elle-même indiqué 16,8 GB disponibles à un moment. Hypothèse
Système
macOS ; version non consignée
Source
Bouton 'Download Studio' sur la page produit Studio du fournisseur Observé
Téléchargement
246 MB (programme d'installation, tel que lu par le testeur) Observé
Offre utilisée
Non consignée. Grille tarifaire du fournisseur au 16 octobre 2026 : Free 0 $ ; Aurum 149 $ par utilisateur et par an ; Aurum Lifetime 349 $ en une fois ; Enterprise sur demande. Annonce éditeur
Pourquoi ce test
Le testeur voulait savoir à quoi sert Msty. Il le décrit comme l'un des premiers outils, un outil professionnel, et ne voyait pas pourquoi un particulier devrait l'utiliser. Avis du testeur
Objectif
Selon les notes : comprendre de quoi il s'agit avec Msty et voir comment il se connecte aux modèles locaux, en espérant Ollama pour ne pas avoir à télécharger un autre modèle. Observé
Assistance IA utilisée
Non consignée
Chaque affirmation porte une étiquette :ObservéMesuréEstim. testeurAnnonce éditeurSource tierceHypothèseAvis du testeurErreur testeurSignification des étiquettes
Déclaration d’intérêts. Le testeur a fondé PromptQuorum (promptquorum.com), un site de contenus et un annuaire consacrés aux applications d'IA locale. Msty figure dans cet annuaire et dispose sur le site d'une page de test distincte, rédigée auparavant. Les notes ne consignent aucun contact avec le fournisseur, aucun paiement et aucun parrainage.
Télécharger 10 GB, 20 GB et des modèles différents pour chaque application, ce n'est tout simplement pas la voie à suivre.
Notes du testeur, légèrement retouchées à partir d’une transcription vocale.
Déroulement du test
Le site : à quoi ça sert ?
Observé
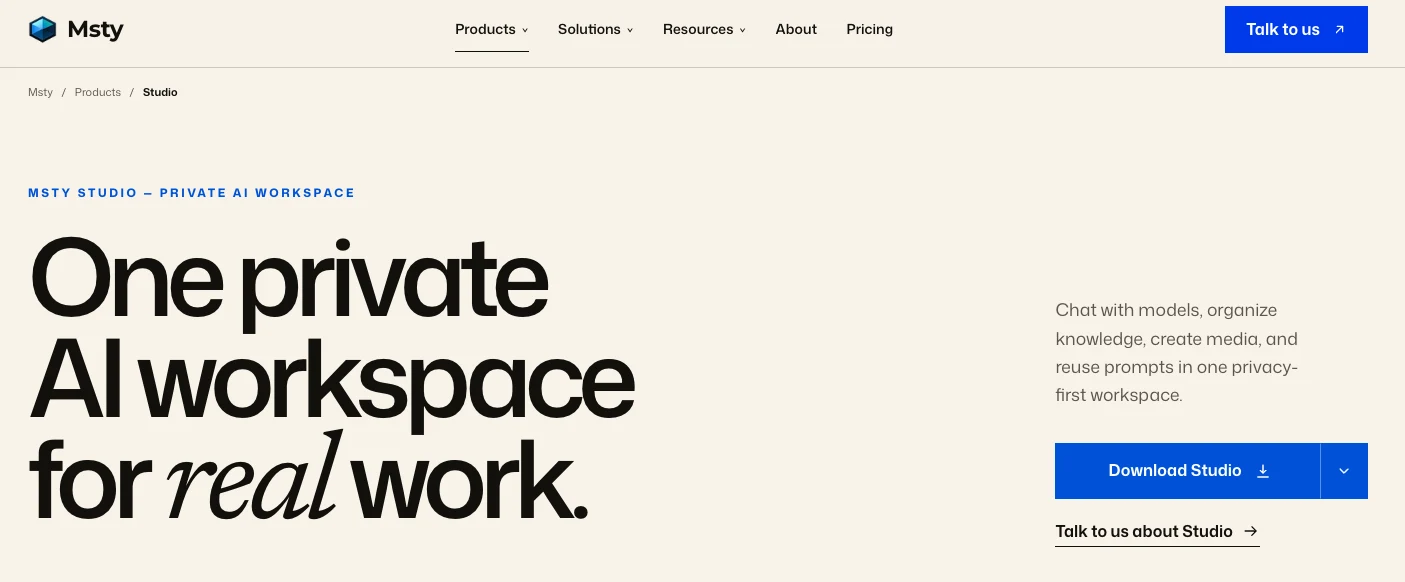
Le testeur est parti de la page produit Studio. Titre : 'One private AI workspace for real work.' Sous-titre : 'Chat with models, organize knowledge, create media, and reuse prompts in one privacy-first workspace.' Bouton : 'Download Studio'.
Figure 2La page produit Studio d'où le testeur est parti. Le titre et la ligne 'Chat with models, organize knowledge, create media, and reuse prompts in one privacy-first workspace.' sont la formulation du fournisseur.
Avis du testeur
Il voulait comprendre de quoi parle Msty : c'est 'one of the early ones, one of the professional ones', et pour un particulier il ne voyait pas bien l'intérêt. 'The screen makes it clear that it's not clear what it's actually for.'
Observé
Le testeur a vu plusieurs solutions et produits et a choisi 'Download Studio' parce que cela semblait être celui qui tourne en local.
Annonce éditeur
La page produit du fournisseur cite Studio, Go ('bounded AI agents'), Nexus ('AI control center') et Stack ('governed knowledge layer'). Vérifié le 16 octobre 2026 ; le testeur ne les a pas ouverts.
Observé
Le fichier téléchargé fait 246 MB. Le testeur : 'so it's okay'.
Avis du testeur
Il espérait une connexion à Ollama ou LM Studio pour éviter tout autre téléchargement de modèle. À son avis, chaque application devrait proposer ce choix à côté des modèles intégrés, car 10 à 20 GB par application, c'est 'just not the way forward'.
Premier lancement : un modèle local ou un fournisseur
Observé
Le premier écran (figure 1, en haut de cette page) propose une carte étiquetée 'LOCAL AI · RUNS ON YOUR MACHINE' : Gemma 4 E2B, 3,6 GB, décrit comme le modèle multimodal compact de Google avec vision. Un curseur de puissance va de Light à Powerful et se trouve sur 'Capable'. Le bouton indique 'Download & Get Started'.
Observé
En dessous, 'Or connect an AI provider' affiche OpenAI, Claude, xAI, Gemini, OpenRouter et 'More'. Un avis jaune indique 'Add at least one model before continuing with a connected provider.' et 'Continue with connected provider' est grisé.
Annonce éditeur
'Runs on your machine' est le libellé de l'application elle-même. Le testeur n'a pas téléchargé ce modèle (il a utilisé des modèles déjà présents dans Ollama) et n'a pas vérifié le trafic réseau.
Hypothèse
L'avis apparaît parce qu'aucun modèle n'avait été ajouté à ce moment-là. L'action qui active 'Continue' n'a pas été testée.
Connecter Ollama
Observé
La liste 'New Model Provider' regroupe Msty Remote et Ollama sous 'Msty Compatible', MLX Remote sous 'MLX Compatible' et LLaMA.cpp sous 'OpenAI Compatible'. La liste de la capture est défilée, donc les entrées au-dessus de xAI ne sont pas visibles.
Figure 3Liste 'New Model Provider', défilée. Ollama figure sous 'Msty Compatible', MLX Remote sous 'MLX Compatible', LLaMA.cpp sous 'OpenAI Compatible'. Les entrées au-dessus de xAI ne sont pas visibles.
Observé
Notes : 'It allowed me to connect to Ollama, select Ollama, but then it didn't select it.' Il est retourné à l'écran de téléchargement local pour comprendre ce qui se passait.
Erreur testeur
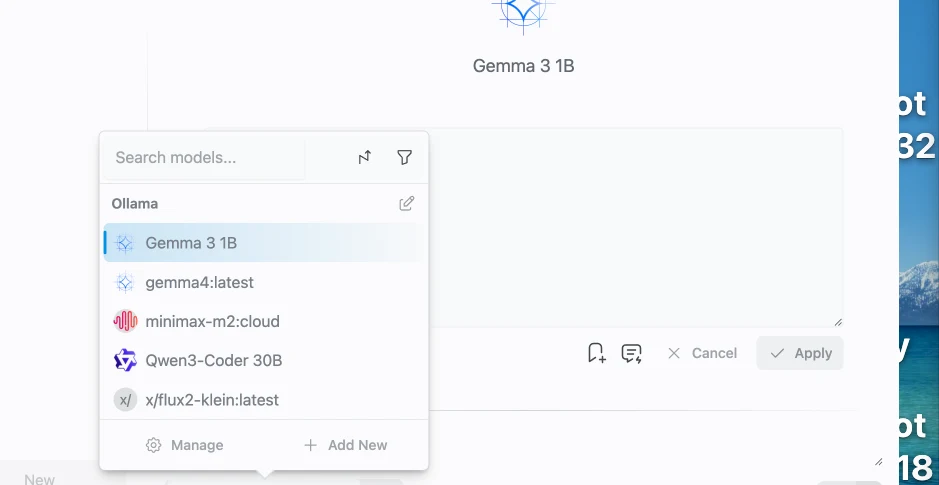
La connexion avait fonctionné. Le testeur ne s'en est pas rendu compte parce que, selon ses mots, l'application affiche le nom du modèle et non le mot Ollama. Le sélecteur listait ensuite cinq modèles sous un en-tête Ollama.
Figure 4Sélecteur de modèles après la connexion d'Ollama : cinq modèles sous un en-tête 'Ollama', dont un modèle d'image (x/flux2-klein:latest) et une entrée ':cloud' dans la même liste que les modèles de chat.
Observé
Correction des notes : la capture du sélecteur montre bien un en-tête 'Ollama' au-dessus de la liste. Les notes renvoient probablement à un écran antérieur qui n'a pas été capturé (hypothèse).
Observé
L'espoir déclaré du testeur s'est réalisé : ses modèles Ollama existants étaient utilisables et les notes ne consignent aucun autre téléchargement de modèle.
Hypothèse
Le suffixe ':cloud' de minimax-m2:cloud laisse penser à un modèle qui tourne dans le cloud et non sur le Mac. Non vérifié. Si c'est le cas, la liste Ollama mélange modèles locaux et cloud sans marqueur visible.
Avis du testeur
'So good, so good. Thanks.'
Tests de chat
Observé
Le testeur a demandé un QR code (texte du prompt non consigné ; la réponse mentionne www.promptquorum.com). La réponse indiquait qu'il s'agit d'une IA textuelle qui ne peut pas générer d'images, et donnait cinq étapes pour utiliser un générateur de QR code en ligne gratuit.
Figure 5Réponse à la demande de QR code. Le nom du modèle est coupé en haut ('gemma4:latest' en partie visible). Un repli 'Thoughts (1)' se trouve au-dessus de la réponse. Le compteur sous la réponse indique 52,81 tok/s.
Mesuré
52,81 tok/s s'affiche sous la réponse. Le nom du modèle est en partie coupé ('gemma4:latest' visible en haut ; la correspondance est probable, pas certaine).
Erreur testeur
Un modèle texte s'est vu demander une image. La réponse était correcte pour un modèle texte. Le testeur l'a présenté comme 'the difference to a functional model'.
Observé
Le testeur a ensuite sélectionné comme modèle de chat un modèle d'image d'un travail précédent (x/flux2-klein dans Ollama). Selon les notes, il 'does not support chat'. Le message lui-même n'a pas été capturé.
Hypothèse
Le testeur doutait que deux ou trois modèles puissent être chargés en même temps ('I don't think so'). Non testé. La page du fournisseur indique 'Split Chats: run models side by side'.
Observé
De retour sur gemma4:latest, il a envoyé une image et le modèle a pu la lire (notes uniquement ; l'image et la réponse n'ont pas été consignées).
Envoi d'un fichier Search Console
Observé
Le testeur a envoyé un export de Google Search Console. Selon les notes, l'application a 'just ran' une analyse sans qu'on le lui demande. Premier point du conseil, tel que cité dans les notes : 'Investigate High-CTR Regions: A rapid audit of Gambia, Saint Barthélemy, Bangladesh, and Gabon is essential.' Les chiffres n'ont pas été comparés au fichier. Modèle et taille du fichier non consignés.
Observé
La boucle, telle que décrite : l'envoi place le fichier dans 'some background tool, knowledge base'. De retour dans le chat, l'application analyse automatiquement et ne laisse pas dire ce qu'il faut analyser. Taper 'I want this analyzed' dans le chat fait redemander les données par l'application.
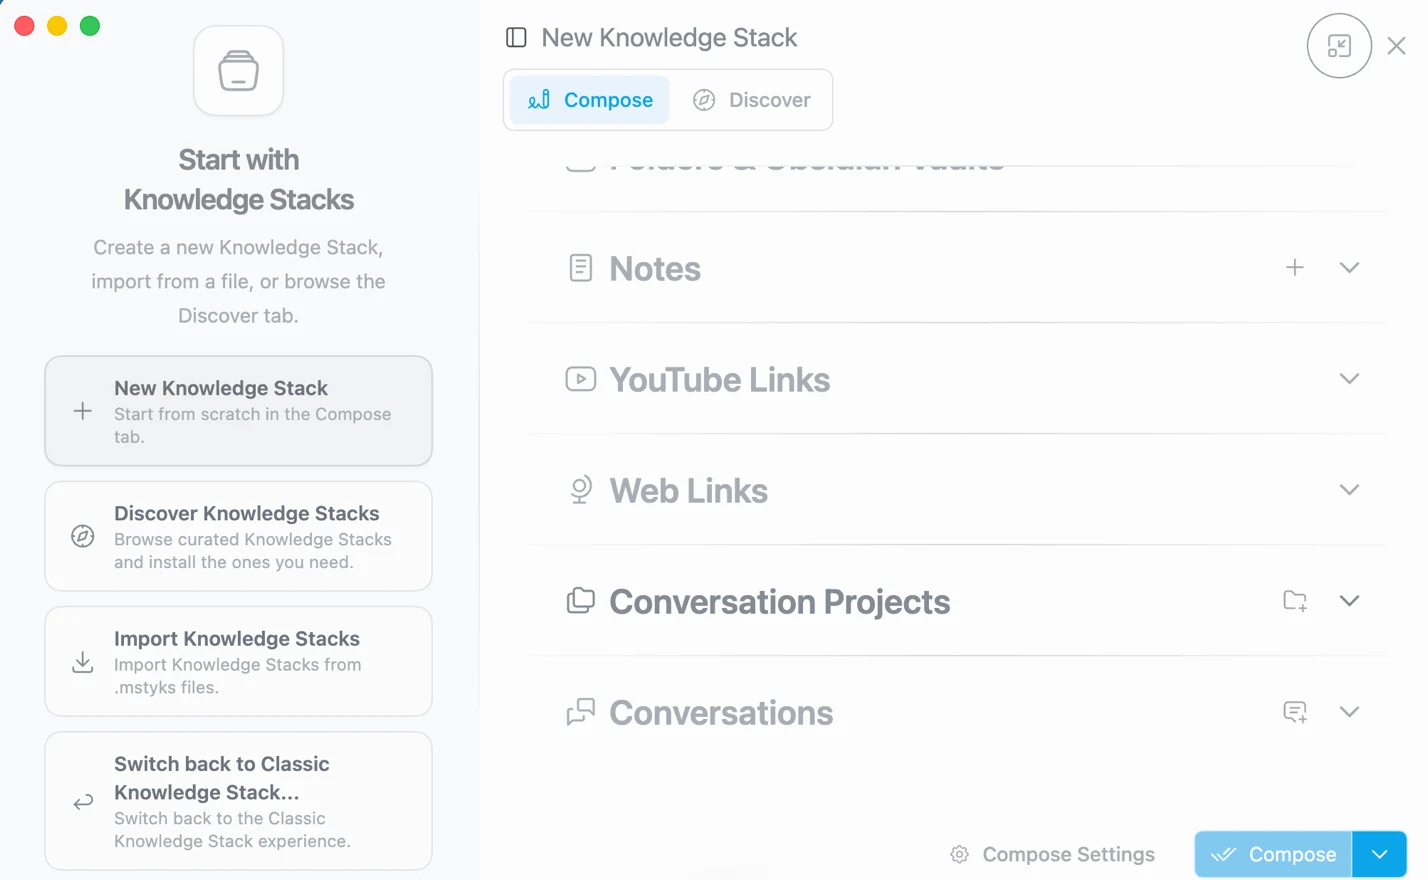
Figure 6Écran de démarrage de Knowledge Stacks : nouveau, découvrir, importer (fichiers .mstyks) et 'Switch back to Classic Knowledge Stack'. Sources à droite : Notes, YouTube Links, Web Links, Conversation Projects, Conversations. Que le fichier Search Console soit passé par cet écran n'est pas confirmé.
Hypothèse
La capture de Knowledge Stacks suit ces notes. Que le fichier soit passé par Knowledge Stacks est la lecture du testeur ('knowledge base'), non confirmée.
Observé
L'écran Knowledge Stacks propose : nouveau stack, découvrir des stacks sélectionnés, importer des fichiers .mstyks et 'Switch back to Classic Knowledge Stack'. Sources affichées : Notes, YouTube Links, Web Links, Conversation Projects, Conversations ; une ligne en partie coupée en haut semble indiquer 'Folders & Obsidian Vaults'.
Avis du testeur
'Okay, this goes in circles.' Puis : 'So this looks like an interesting tool, but let's see.'
Media Studio
Observé
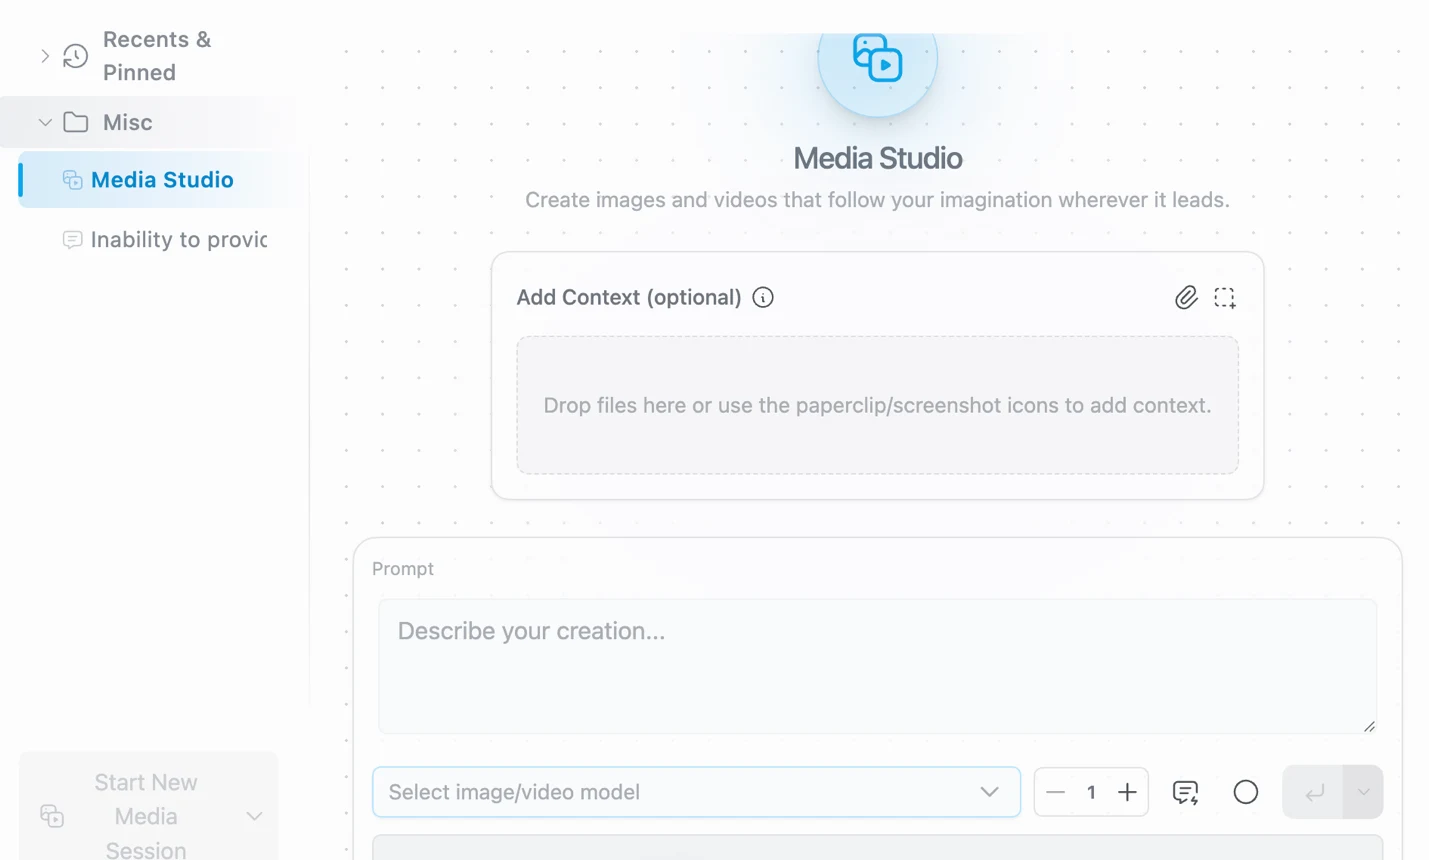
La barre latérale comporte une entrée 'Media Studio'. L'écran indique 'Create images and videos that follow your imagination wherever it leads.' Il comporte une zone de dépôt de contexte facultative, une zone de prompt ('Describe your creation...'), un compteur réglé sur 1 et un menu intitulé 'Select image/video model'.
Figure 7Media Studio. Le menu des modèles indique toujours 'Select image/video model'. Le contenu du menu n'a pas été capturé ; aucune image n'a été générée.
Avis du testeur
'Great, can do pictures too.' Mais en se connectant à sa configuration LLM locale, l'application a indiqué que son Ollama n'avait pas de modèle d'image, et il pensait que Flux était le bon.
Observé
Aucune image n'a été générée dans Msty. Les notes ne consignent aucun sélecteur de modèle d'image qui ait fonctionné pour lui.
Hypothèse
Media Studio ne liste pas le modèle d'image Ollama x/flux2-klein. Le contenu du menu des modèles n'a pas été capturé. Le journal des modifications du fournisseur date Media Studio de la version 2.7.0 (29 avril 2026) et mentionne des modèles d'image et de vidéo de xAI et d'OpenRouter, ce qui suggère des fournisseurs hébergés. Non vérifié.
Model Hub et Model Matchmaker
Observé
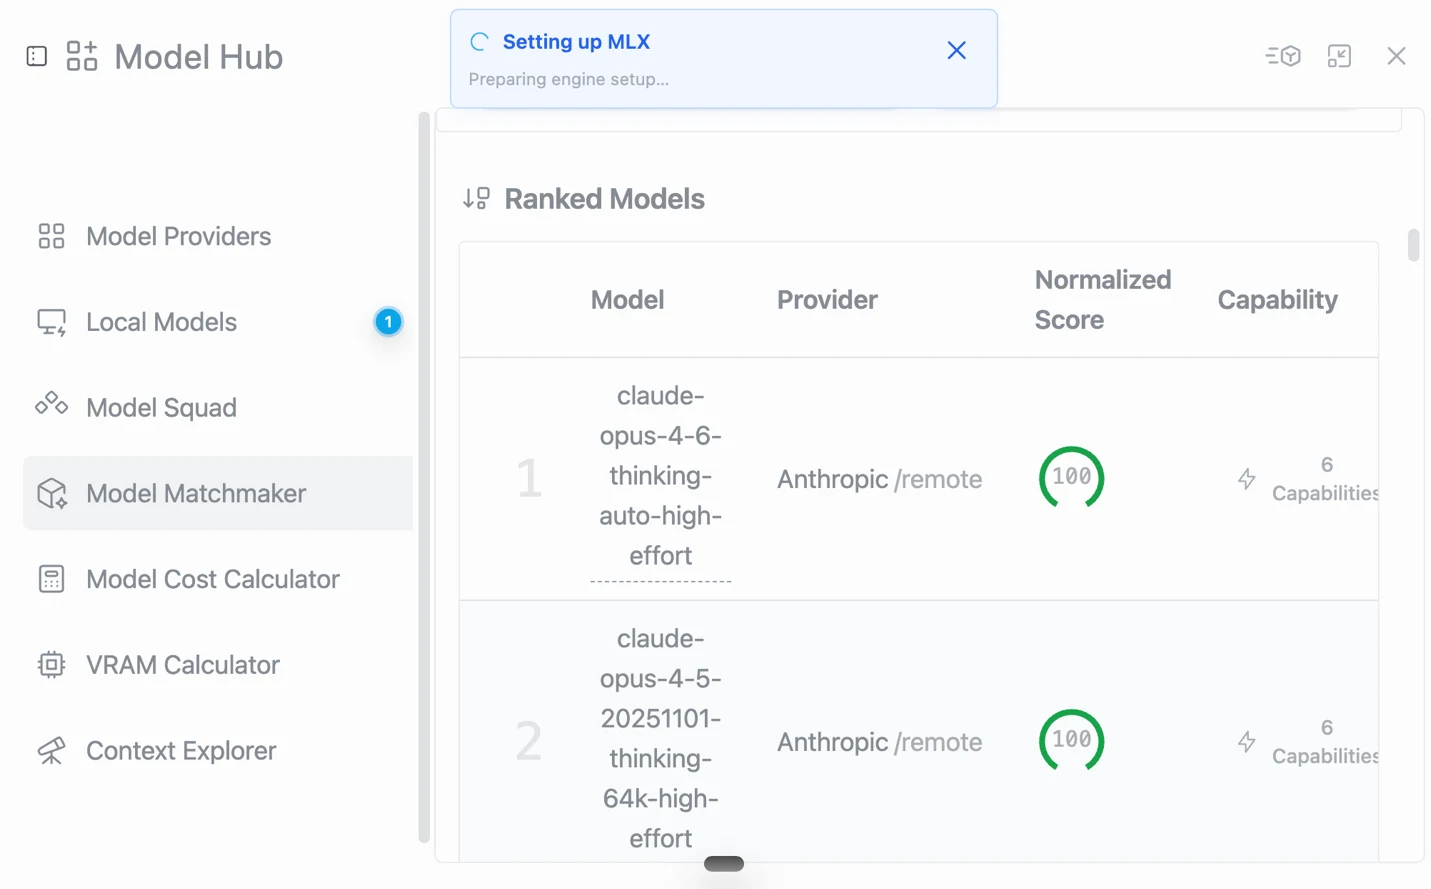
La barre latérale du Model Hub liste Model Providers, Local Models, Model Squad, Model Matchmaker, Model Cost Calculator, VRAM Calculator et Context Explorer. Local Models comporte les onglets Featured, Installed, Search et Import. Selon les notes, seul le Matchmaker a été ouvert.
Figure 8Model Hub, modèles locaux Featured (liste défilée, partiellement visible) : Mistral 7B Instruct v0.3 6,9 GB, Llama 3.2 3B 1,7 GB, Llama 3.2 1B 645 MB, Meta Llama 3.1 8B 4,5 GB, tous étiquetés 4-bit. La barre latérale liste sept outils.
Observé
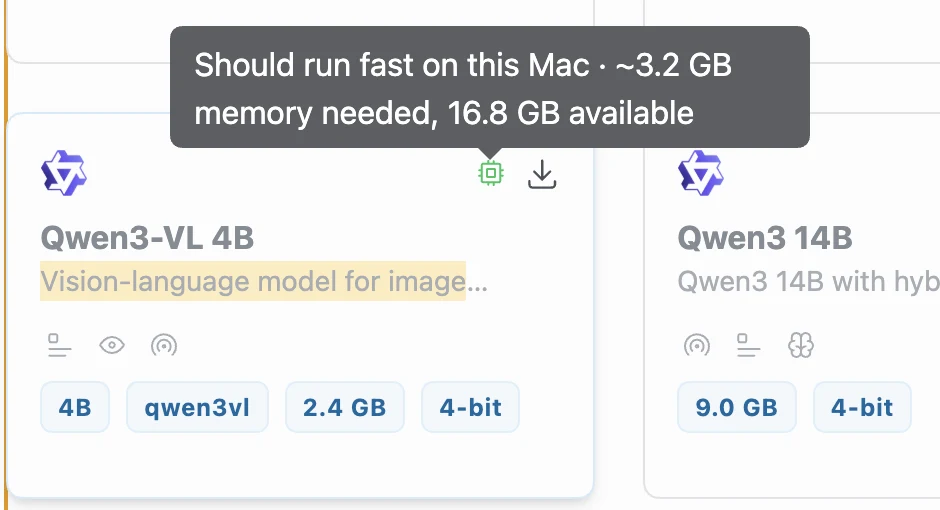
Les cartes de modèles indiquent la taille et la quantification. Une infobulle sur Qwen3-VL 4B (2,4 GB, 4-bit) indique 'Should run fast on this Mac · ~3.2 GB memory needed, 16.8 GB available'.
Figure 9Indication matérielle sur une carte de modèle : 'Should run fast on this Mac · ~3.2 GB memory needed, 16.8 GB available'. La carte montre Qwen3-VL 4B, 2,4 GB, 4-bit. L'estimation vient de l'application ; le modèle n'a pas été exécuté.
Annonce éditeur
Cette estimation d'adéquation vient de l'application elle-même. Le modèle n'a pas été exécuté.
Avis du testeur
'Model Matchmaker. Great idea. I like it.' Mais il n'a trouvé aucun sélecteur pour la génération d'images.
Observé
La capture suivante montre le classement du Matchmaker : n° 1 claude-opus-4-6-thinking-auto-high-effort et n° 2 claude-opus-4-5-20251101-thinking-64k-high-effort, tous deux 'Anthropic /remote', score 100. Un avis 'Setting up MLX: Preparing engine setup...' est visible ; la raison de son apparition n'a pas été consignée.
Figure 10Model Matchmaker, 'Ranked Models'. N° 1 claude-opus-4-6-thinking-auto-high-effort, n° 2 claude-opus-4-5-20251101-thinking-64k-high-effort, tous deux fournisseur 'Anthropic /remote', score normalisé 100. Un avis 'Setting up MLX: Preparing engine setup...' s'affiche. La date des données du classement n'est pas visible.
Avis du testeur
'In October 2026 and I see this, I'm not impressed. That is an AI process to update this. I have tools on my website to update the website. Why is it so difficult?'
Hypothèse
'This' est lu ici comme le classement de la capture qui serait périmé. Les notes ne disent pas de quel écran il parlait.
Source tierce
La page des modèles d'Anthropic (consultée le 16 octobre 2026) donne Claude Opus 5.5 (claude-opus-5-5) comme Opus le plus récent et ne présente pas les deux modèles 4.x comme actuels. La date des données du classement n'apparaît pas sur la capture, donc le caractère périmé n'est pas confirmé.
Observé
Les modèles Featured visibles sont Mistral 7B Instruct v0.3, Llama 3.2 3B et 1B, Meta Llama 3.1 8B. Mistral 7B, à 6,9 GB, est plus gros que Llama 3.1 8B, à 4,5 GB, tous deux étiquetés 4-bit ; la différence n'est pas expliquée sur les cartes.
Où les notes s'arrêtent
Observé
La partie Msty des notes s'arrête au Model Matchmaker. Le reste du fichier Word (à partir du passage 'Generate similar images') décrit une autre application, un générateur d'images, avec ses propres captures. Il a été écarté de ce rapport.
Observé
Non consigné pour Msty : version de l'application et de macOS, heure de fin, offre utilisée, un verdict, une vérification de la désinstallation.
Affirmations et observations du testeur
Affirmation
Source
Observé
Étiquette
'Chat with models, organize knowledge, create media, and reuse prompts in one privacy-first workspace.'
Page Studio du fournisseur (aussi sur la capture du testeur)
Le chat avec des modèles Ollama a fonctionné. Knowledge Stacks s'est ouvert. Media Studio s'est ouvert mais n'a produit aucune image. La réutilisation de prompts n'a pas été essayée. La confidentialité n'a pas été auditée.
Observé
'Bring local inference engines like MLX, llama.cpp, and Ollama together with hosted providers in one organized hub.'
Page Studio du fournisseur, consultée le 16/10/2026
Ollama s'est connecté et ses modèles ont été listés. LLaMA.cpp et MLX Remote figurent dans la liste des fournisseurs. Seul Ollama a été utilisé. Un avis de configuration de MLX est apparu une fois.
Observé
Split Chats : 'run models side by side'
Page Studio du fournisseur, consultée le 16/10/2026
Non testé. Le testeur supposait que deux ou trois modèles ne peuvent pas être chargés en même temps.
Hypothèse
Media Studio : génération d'images et mise en forme de concepts vidéo
Page Studio du fournisseur, consultée le 16/10/2026
L'écran existe. Aucune image n'a été générée ; aucun modèle d'image local utilisable n'a été trouvé.
Observé
'LOCAL AI · RUNS ON YOUR MACHINE' (Gemma 4 E2B, 3,6 GB)
Écran du premier lancement
Non téléchargé. Le testeur a utilisé des modèles déjà présents dans Ollama. Pas de vérification réseau.
Observé
'Should run fast on this Mac · ~3.2 GB memory needed, 16.8 GB available'
Infobulle du Model Hub
Le modèle n'a pas été exécuté, l'estimation n'a donc pas été vérifiée.
Annonce éditeur
Offre Free : 0 $, inclut des modèles locaux et en ligne ainsi que Media Studio (certaines fonctions limitées)
Page tarifs du fournisseur, consultée le 16/10/2026
L'offre utilisée par le testeur n'est pas consignée.
Annonce éditeur
Tient-il dans 24 GB ?
24 GB de mémoire
Llama 3.2 1B (4-bit)645 MB en dessous de 24 GBObservé
Llama 3.2 3B (4-bit)1,7 GB en dessous de 24 GBObservé
Qwen3-VL 4B (4-bit)2,4 GB de fichier ; l'application indique environ 3,2 GB de mémoire nécessaires en dessous de 24 GBAnnonce éditeur
Gemma 4 E2B (téléchargement au premier lancement)3,6 GB en dessous de 24 GBObservé
Meta Llama 3.1 8B (4-bit)4,5 GB en dessous de 24 GBObservé
Mistral 7B Instruct v0.3 (4-bit)6,9 GB en dessous de 24 GBObservé
Qwen3 14B (4-bit)9,0 GB en dessous de 24 GBObservé
Ce sont les tailles de téléchargement affichées sur les cartes de modèles, pas la mémoire d'exécution. La longueur de contexte et le moteur modifient ce dont un modèle a besoin. L'application indiquait 16,8 GB disponibles au moment de l'infobulle de Qwen3-VL. Les modèles Ollama que le testeur a réellement utilisés (Gemma 3 1B, gemma4:latest, Qwen3-Coder 30B) n'affichent aucune taille dans le sélecteur. La carte de Qwen3 14B n'est que partiellement visible sur la capture (son nom, sa taille et sa quantification sont lisibles).
Journal d’usage
#
Tâche
Modèle
Résultat
Durée
Statut
Figures
1
Connecter Ollama comme fournisseur
-
Connecté ; cinq modèles listés sous Ollama. Le testeur a d'abord cru que cela avait échoué.
Erreur testeurA cru que la connexion à Ollama avait échoué. Elle avait fonctionné ; les modèles étaient listés.
Erreur testeurA demandé une image (QR code) à un modèle texte, puis l'a jugé à l'aune d'un 'functional model'.
Erreur testeurA écrit que l'application ne dit pas 'Ollama'. Sa propre capture montre un en-tête 'Ollama' au-dessus de la liste des modèles.
Erreur testeurA laissé des lacunes dans le relevé : version de l'application, version de macOS, heure de fin, offre utilisée, prompts, modèle ayant répondu au test de fichier, et verdict sur Msty.
Erreur testeurA mêlé deux applications dans un même document. La seconde moitié du fichier Msty décrit un générateur d'images, ce qui a nui à la clarté sur l'endroit où s'arrête le test de Msty.
HypothèseLe testeur doutait que plusieurs modèles puissent tourner en même temps. Non testé, et le fournisseur annonce Split Chats.
Registre des constats
ID
Constat
Catégorie
Étiquette
Gravité
Figures
MS-01
La page Studio et les premiers écrans ne disent pas à un particulier à quoi sert l'application.
Le premier écran propose un modèle local (Gemma 4 E2B, 3,6 GB) ou un fournisseur hébergé ; Ollama n'y figure pas et apparaît à la place dans la liste des fournisseurs.
Le classement du Matchmaker est mené par deux modèles Claude Opus 4.x alors qu'Anthropic donne Opus 5.5 comme le plus récent ; caractère périmé non confirmé (aucune date de données affichée).
La gravité mesure l’impact sur un utilisateur novice. Proposée, non mesurée.
À qui il s’adresse
Adéquation probable
HypothèsePersonnes qui utilisent déjà Ollama et veulent un frontal de bureau unique pour des modèles locaux et hébergés (la réutilisation d'Ollama a fonctionné dans ce test).
Annonce éditeurÉquipes ayant besoin de SSO, de journaux d'audit et de contrôles partagés (indiqués sur la page Studio du fournisseur ; non testés).
Mauvaise adéquation probable
Avis du testeurUn particulier qui veut comprendre dès les premiers écrans à quoi sert l'application.
HypothèseUtilisateurs qui s'attendent à générer des images dans Media Studio avec un modèle d'image Ollama local (n'a pas fonctionné dans ce test).
Nouveau test. Retester les parties non testées (Split Chats, prompts, Media Studio avec un modèle d'image hébergé, le flux de fichiers, la désinstallation) et consigner d'abord la version et macOS. Le journal des modifications montre que la 3.0.0 était encore en bêta le 7 octobre 2026 ; l'interface peut donc changer à la sortie (hypothèse).
Bon, ça tourne en rond.
Notes du testeur, légèrement retouchées à partir d’une transcription vocale.
Questions fréquentes
Msty Studio fonctionne-t-il avec Ollama ?
Oui, dans ce test. Une fois Ollama ajouté comme fournisseur, cinq modèles Ollama sont apparus dans le sélecteur de modèles, et les notes ne consignent aucun second téléchargement. Le testeur a d'abord cru que la connexion avait échoué. Observé
Msty Studio peut-il générer des images avec un modèle Ollama local ?
Pas dans ce test. Media Studio s'est ouvert, mais le testeur n'a trouvé aucun moyen d'y utiliser son modèle d'image local (x/flux2-klein), et aucune image n'a été générée. Le contenu du menu 'Select image/video model' n'a pas été capturé, et les fournisseurs hébergés n'ont pas été essayés. Observé
Msty Studio indique-t-il si un modèle tient sur mon Mac ?
Les cartes de modèles du Model Hub portent une indication matérielle, par exemple 'Should run fast on this Mac · ~3.2 GB memory needed, 16.8 GB available' sur Qwen3-VL 4B. L'estimation vient de l'application elle-même ; le modèle n'a pas été exécuté. Annonce éditeur
Combien coûte Msty Studio ?
La grille tarifaire du fournisseur, lue le 16 octobre 2026, indique Free à 0 $, Aurum à 149 $ par utilisateur et par an, et Aurum Lifetime à 349 $ en une fois. L'offre utilisée par le testeur n'est pas consignée. Annonce éditeur
Contexte sur le créateur
Hors de la session pratique. Les éléments ci-dessous viennent du site du fournisseur, de son journal des modifications et de l'annuaire PromptQuorum, lus le 16 octobre 2026 avec un outil de récupération web qui résume les pages. Rien n'a été vérifié de façon indépendante pour ce test.
Annonce éditeurLe pied de page du fournisseur indique 'Msty is a product of CloudStack, LLC.' (2026).
Annonce éditeurGrille tarifaire : Free 0 $ ; Aurum 149 $ par utilisateur et par an ; Aurum Lifetime 349 $ en une fois ; Enterprise et Teams sur demande, minimum 5 postes. La page tarifs n'indique pas de licence logicielle.
Source tierceL'annuaire PromptQuorum présente Msty comme propriétaire, freemium, pour macOS, Windows et Linux, dernière mise à jour amont le 7 octobre 2026. La fiche n'a pas été vérifiée (actualité : non vérifiée).
Annonce éditeurJournal des modifications : Media Studio introduit dans la version 2.7.0 (29 avril 2026) ; la prise en charge de MLX pour Apple Silicon apparaît d'abord dans la 2.0.0-alpha.10 (7 août 2025), marquée expérimentale ; Knowledge Stacks 2.0 dans la 2.0.0-alpha.9 (31 juillet 2025). Dernière version listée le 7 octobre 2026 : 3.0.0 Beta 15.