Déroulement du test
Téléchargement, premier démarrage et premier modèle
L'installateur est un DMG de 270 Mo téléchargé sur le site. Le testeur : 'Really nice startup. Looks fake [wording unclear in the notes]. Nothing to be done more. Just click open.'
L'écran d'accueil 'All AI Tools' montre Text to image, Image to image, AI Canvas, Illusion Generator, Inpainting et Upscaler (liste défilée ; d'autres peuvent se trouver plus bas).
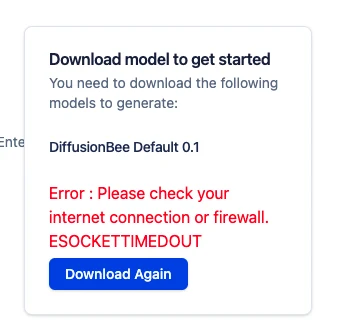
La première utilisation demande un modèle : 'Download model to get started. You need to download the following models to generate: DiffusionBee Default 0.1'. La barre de progression n'affiche qu'un pourcentage : ni taille ni estimation de durée. Les notes indiquent 2 pour cent après moins d'une minute ; la capture montre 3 pour cent.
La boîte de dialogue devrait indiquer la taille du modèle et la durée du téléchargement.
Pendant le téléchargement d'un modèle, on peut ouvrir et utiliser d'autres zones de l'appli (notes).
Le premier téléchargement a échoué avec 'Please check your internet connection or firewall. ESOCKETTIMEDOUT' et pour seule option 'Download Again'.
Le testeur pense que sa connexion lente sur le lieu du test a causé le délai dépassé. Non vérifié. Il indique que le téléchargement en était à 65 pour cent et qu'il a fallu recommencer ; on n'a pas vérifié s'il est reparti de zéro.
'Come on, this is so unprofessional.' Après le téléchargement : 'Hurray, after download it works.'
La page Models
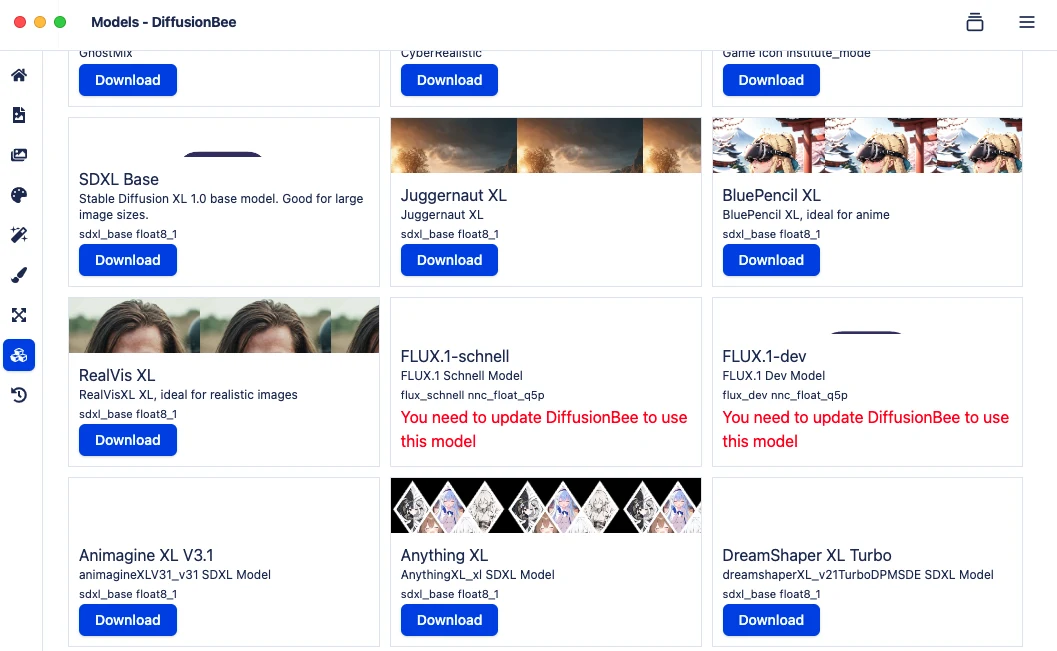
La page Models est une grille de cartes, chacune avec un nom, une description d'une ligne et une étiquette comme 'sdxl_base float8_1'. Elle liste SDXL Base, Juggernaut XL, BluePencil XL, RealVis XL, Animagine XL V3.1, Anything XL, DreamShaper XL Turbo et d'autres. Aucune carte n'affiche de taille de téléchargement.
FLUX.1-schnell et FLUX.1-dev affichent un texte rouge : 'You need to update DiffusionBee to use this model.' Le testeur avait téléchargé l'appli environ deux minutes plus tôt.
L'annuaire PromptQuorum indique la dernière mise à jour en amont de DiffusionBee au 30 octobre 2024 (plus d'un an avant ce test), et le pied de page de l'éditeur indique '© 2024'. Le README du projet liste SD 1.x, SD 2.x, SD XL, Inpainting, ControlNet et LoRA, et ne mentionne pas FLUX. Lu le 16 octobre 2026 ; la liste des versions sur GitHub n'a pas pu être lue.
Un bouton 'Import From Computer' figure sur la page Models. Le testeur en déduit qu'on peut importer des modèles déjà présents (non testé).
Il demande pourquoi la page n'affiche pas la taille des modèles pour voir ce qui tourne sur son ordinateur, et pourquoi il n'y a pas de courte explication de l'usage de chaque modèle. 'And as no instruction, it is just like the random downloads again.'
Une carte Samaritan 3d Cartoon affichait une barre de téléchargement à 1 pour cent sans taille (notes et petite capture).
Premières images : un cercle et un visuel de marque
Prompt 'circle with green dot in the middle' : un disque blanc au centre vert sur fond vert. Réglages : Default_SDB_0.1, 512 x 512, 1 image, seed -1, 25 étapes. Chaque image porte un bouton 'Actions'.
Ensuite, 'a real challenge' : un long prompt structuré pour un visuel de marque et un logo PromptQuorum. Réglages : Default_SDB_0.1, 1024 x 1024, 3 images, 25 étapes. L'écran affiche un spinner, 'Add to Queue' et 'Stop all'.
Les trois résultats sont des boîtes et des cartes noir et blanc avec des lettres illisibles. Aucun 'PromptQuorum.com' lisible et aucun logo utilisable.
Le testeur écrit 'I assume the prompt failed because that was not requested'. Le sens n'est pas clair dans les notes.
Il apprécie de choisir le nombre d'images et la taille. Ce qui lui manque : une indication de vitesse, une heure de fin et 'some entertainment while it's working'.
Un lieu réel : Heidelberg
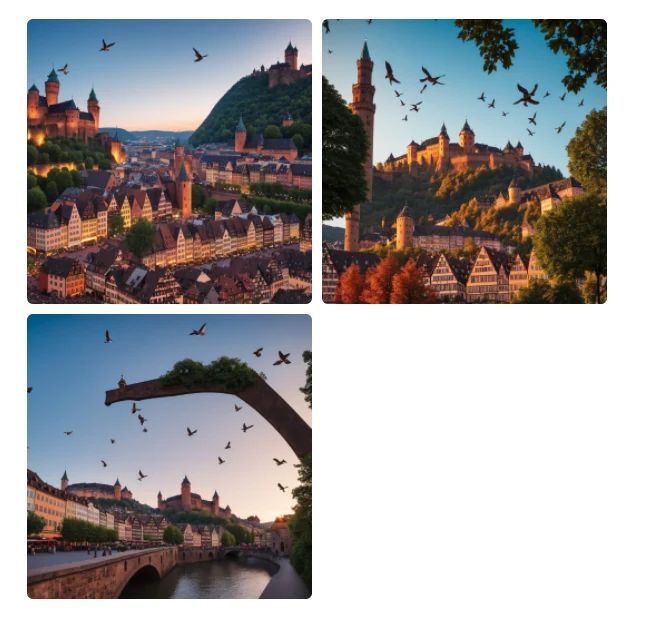
Le prompt, écrit il y a des années pour un modèle de pointe : une image photoréaliste prise depuis le Heumarkt de Heidelberg en regardant vers le château, avec des oiseaux et un lever de soleil derrière le château. Modèle et réglages non consignés.
Les trois résultats montrent un château sur une colline boisée au-dessus de vieilles maisons à colombages, avec des oiseaux. Aucun ne montre la vue depuis le Heumarkt ni le château de Heidelberg en tant que tel.
Le testeur s'attendait à ce qu'un modèle d'images connaisse un lieu réel et son angle de vue. Il le dit lui-même : 'too much expected from this tool'.
'I could have written, do a castle up the hill with a sunset and birds behind. That's the difference between frontier models with access to the internet and pure LLMs that are just generating pictures.'
La différence tient à l'accès à Internet ou à la connaissance des lieux. Non testé dans ce rapport.
Le testeur a aussi essayé des images que 'other systems might refuse'. Les notes disent que l'appli 'did not say stop on anything'. Les prompts n'ont pas été consignés et aucune capture n'existe.
Inpainting : logo et passant
L'ouverture d'Inpainting demande encore un autre modèle : 'ControlNet Inpaint', affiché à 3 pour cent, sans taille.
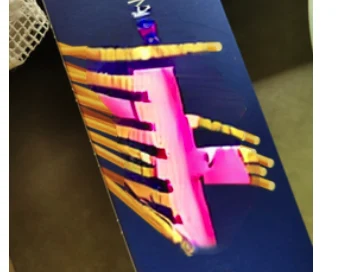
Test 1 : une photo d'un paquet de pâtes. Prompt 'remove barillia logo' (marque mal orthographiée), avec un masque sur le logo. Le premier essai a 'failed' selon les notes.
Après un deuxième essai, le texte du logo n'est plus lisible, mais des taches roses restent et les brins de spaghetti sont étalés.
'Technically, removing worked, just not putting the spaghettis back together.'
Test 2 : une photo de rue avec un passant. Dans le résultat, la personne a disparu. Le testeur : 'Nearly there. If you don't expect something and I don't look for it, you don't see it.'
Le nom de la marque dans le prompt était mal orthographié ('barillia'). C'est le masque, et non le prompt, qui a fait le travail ; l'effet est donc probablement faible (hypothèse).
AI Canvas et image vers image : ciel et pop art
AI Canvas avec la photo de rue et le prompt 'Make the sky dark blue, real summer day' à Input Strength 30. Le résultat n'a pas été capturé.
'Blue sky didn't work out, or I don't understand the mechanism.'
Image vers image avec 'make this into a pop art cartoon picture' sur Samaritan_3d_Cartoon_v1_s2 à Input Strength 80.02. Le résultat est une copie plus douce et terne de la photo, pas du pop art. Le testeur : 'Pop art also didn't work out. Not sure why.'
Cette capture se trouve à la fin des notes, après la remarque sur la vitesse, et est lue ici comme l'essai pop art. Non confirmé.
Une Input Strength plus élevée conserve davantage de l'image d'origine. Points de données : 21.07 et 21.46 ont beaucoup modifié l'image, 90.13 l'a renvoyée presque inchangée, 80.02 a donné une quasi-copie. Quatre réglages seulement ; l'explication propre de l'appli n'a pas été consignée.
Clown, éléphant, volcan : modèles, guidage et prompt négatif
Le testeur a vérifié l'usage mémoire avec Samaritan 3D Cartoon. Prompt 'draw a clown dancing on an elephant', 512 x 512, 1 image : un clown de dessin animé qui danse, avec derrière lui une forme brun clair évoquant un éléphant, fusionnée avec lui.
Besoin mémoire de ce modèle : environ 5 Go 'of my VRAM'. Méthode non consignée. Apple Silicon n'a qu'un seul pool de mémoire partagée.
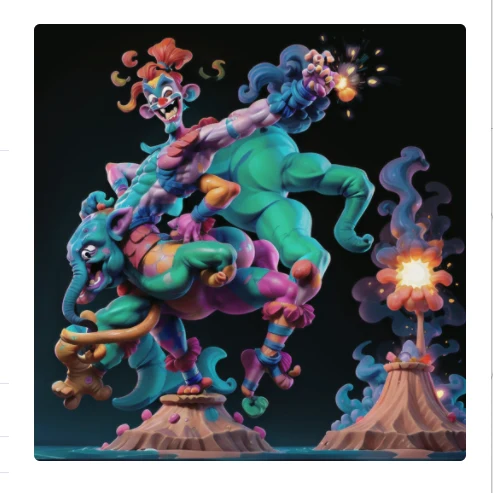
Prompt plus long (clown au sommet d'un éléphant, plage, océan bleu, volcan en éruption) avec le prompt négatif 'No blue sky!!' en 1024 x 1024 : une créature bleue musclée avec des étincelles de feu. On ne distingue ni clown, ni éléphant, ni plage, ni volcan. Le testeur : 'a nice result, but not really what I outlined'.
Avec l'échelle de guidage au maximum (ce qui, selon la consigne de l'appli, 'means it should really do what I ask') : un clown, un animal évoquant un éléphant et un volcan en éruption apparaissent. On ne distingue ni plage ni océan bleu ; le sol est sombre.
'I would say close, close, close or maybe perfect.'
Même prompt sur JuggernautXL_v7_f8 (un téléchargement de plus) : un clown avec des ballons sur un éléphant, un grand panache de volcan, une plage avec des parasols et de l'eau bleue. Le ciel est bleu, donc le prompt négatif 'No blue sky!!' n'a pas été respecté. Le testeur : 'Looks great, except the negative prompt was skipped.'
Il souhaiterait que la fenêtre dise ce qu'est un modèle, au lieu de devoir le chercher ailleurs. Une réponse Google collée dans les notes décrit Juggernaut XL comme un fine-tune de SDXL pour le photoréalisme (voir Contexte).
Un couple photoréaliste, et la vitesse
Prompt : 'photorealist a couple in love on the beach, watching the sunset over the ocean, birds in the sky, some boats on the water, some palm trees seen'. JuggernautXL_v7_f8, 1216 x 1216, 6 images demandées. Deux résultats ont été capturés.
Les deux montrent un coucher de soleil, des palmiers et des oiseaux. Le premier a un voilier et un appareil photo sur le sable ; le second a plusieurs bateaux mais trois personnes sur deux bancs, alors que le prompt demandait un couple.
Le second résultat (Figure 19) est présenté ici.
'Looks a bit like AI, but well done, well done.' Il apprécie de choisir le nombre d'images et leur taille, et que l'appli 'just runs and runs' pendant qu'on fait autre chose, puis qu'on choisisse la meilleure.
Environ une minute par image à la résolution la plus élevée ; un fichier d'environ deux mégaoctets par image. Ni l'un ni l'autre n'a été chronométré ni montré sur une capture. 'Not very fast, but it's okay.'
Autres tests et avis final (notes trouvées dans le document Msty)
Le fichier Word du test Msty contient aussi des notes et des captures sur DiffusionBee. Elles sont utilisées ici comme seconde source. Leur date et leur ordre par rapport aux tests ci-dessus ne sont pas consignés ; une capture d'infos de fichier datée du 14 octobre 2026, 17:58, laisse penser que c'était le même jour.
'Generate similar images' a produit quatre scènes similaires de couple sur la plage à partir d'une image. Le testeur : une belle fonction ; il la trouve 'really impressive'.
Un PNG enregistré dans Téléchargements le 14 octobre 2026 à 17:58 mesure 38 733 330 octets (38.7 Mo). L'image concernée n'est pas consignée.
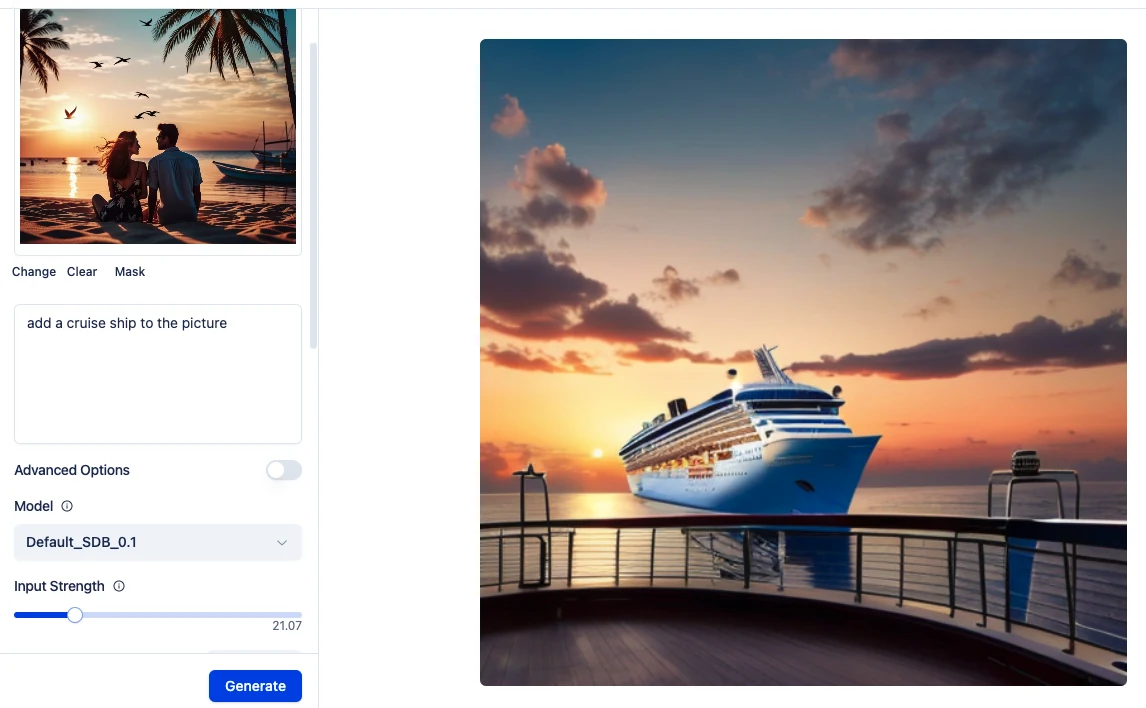
Image vers image sur l'image du couple sur la plage, prompt 'add a cruise ship to the picture', Input Strength 21.07 : un paquebot apparaît au coucher du soleil, vu depuis la rambarde d'un pont. Le couple et les palmiers ont disparu.
Deuxième essai (long prompt, Input Strength 21.46) : une vue de la mer au coucher du soleil depuis un pont, avec un palmier et des chaises ; aucun navire à l'horizon.
Troisième essai (Input Strength 90.13) : sortie presque identique à l'entrée ; aucun navire.
Selon les notes, régler Input Strength sur 100 fait 'crashes' l'appli. Pas de capture ; version non consignée.
Prompt Tour Eiffel (JuggernautXL_v7_f8, 2 images, seed 770465) : deux tours presque identiques vues d'en bas. Le testeur dit que la tour est correcte mais que la direction et les proportions sont fausses, et que les arbres du jardin à la française sont 'spot on' tandis que le reste autour de la tour est raté.
Horizon nocturne de New York avec 'add 3 helicopters flying' (epicrealismXL_v8, 75 étapes) : plus de trois hélicoptères sont visibles. Le testeur : il 'cannot count till three and created a second Manhattan Island'.
Une photo de plat avec le prompt 'make this german dinner into a cartoon style, many colors, really funny' : selon les notes, l'appli 'gave me the same picture back several times'. Le résultat n'a pas été capturé.
Le champ Seed a un texte d'aide que le testeur cite ainsi : 'Starting point for iteration. Any number will do. [App?] will pick one if left blank.' Il n'est 'not sure what the value is'. Le mot avant 'will pick one' n'est pas clair dans les notes.
Avec l'appli Claude, Word, WhatsApp, Chrome et d'autres applis ouvertes, il situe l'usage mémoire à environ 20 Go sur 24 Go. Sa lecture : 'even on a 24 gigabyte Mac... it's at the limit again'. La vraie leçon de ses tests, c'est la VRAM.
'Function-wise and interface-wise, this is so far the best local LLM app tool that I tried... Not sure I need to learn two or three of these functions, which I do not understand what they do.' 'The first picture app that really works.'
Ce qui manque : affiner une image pas à pas ('this a little bit, this a little bit'). 'Currently it's not working.' Il s'y prend peut-être mal. 'In a year from now, this will be perfect.' Dernière ligne : 'Smooth interface, works with smaller models, really mostly self-explanatory. Great functions that you can hand over one picture to another tool.'
La prévision du testeur, selon laquelle les modèles locaux rejoindront les modèles cloud d'ici un à deux ans, n'est pas testée ici.