Cómo fue la prueba
Descarga, primer arranque y primer modelo
El instalador es un DMG de 270 MB del sitio web. El evaluador: 'Really nice startup. Looks fake [wording unclear in the notes]. Nothing to be done more. Just click open.'
La pantalla de inicio 'All AI Tools' muestra Text to image, Image to image, AI Canvas, Illusion Generator, Inpainting y Upscaler (lista desplazada; puede haber más debajo).
El primer uso pide un modelo: 'Download model to get started. You need to download the following models to generate: DiffusionBee Default 0.1'. La barra de progreso muestra solo un porcentaje: ni tamaño ni estimación de tiempo. Las notas dicen 2 por ciento tras menos de un minuto; la captura muestra 3 por ciento.
El cuadro debería indicar qué tamaño tiene el modelo y cuánto tarda la descarga.
Mientras se descarga un modelo, se pueden abrir y usar otras áreas de la app (notas).
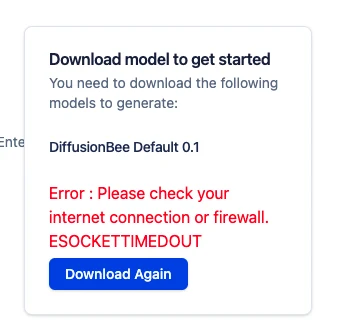
La primera descarga falló con 'Please check your internet connection or firewall. ESOCKETTIMEDOUT' y la única opción 'Download Again'.
El evaluador cree que la causa de la caducidad fue su conexión lenta en el lugar de la prueba. No verificado. Cuenta que la descarga iba al 65 por ciento y hubo que empezar de nuevo; no se comprobó si se reanudó desde cero.
'Come on, this is so unprofessional.' Tras la descarga: 'Hurray, after download it works.'
La página Models
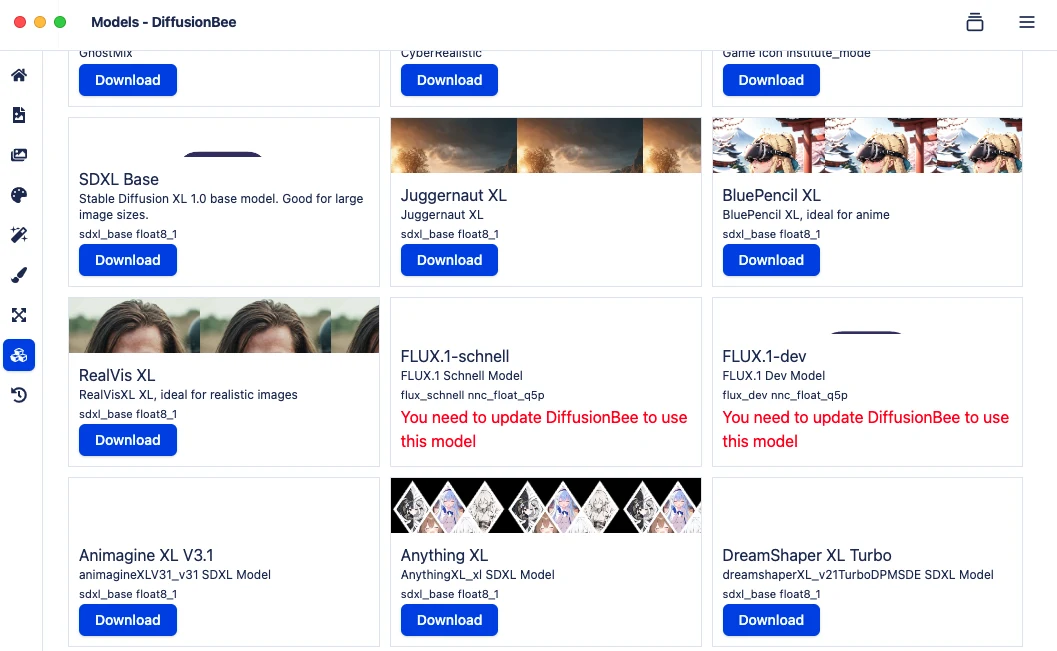
La página Models es una cuadrícula de tarjetas, cada una con un nombre, una descripción de una línea y una etiqueta como 'sdxl_base float8_1'. Incluye SDXL Base, Juggernaut XL, BluePencil XL, RealVis XL, Animagine XL V3.1, Anything XL, DreamShaper XL Turbo y más. Ninguna tarjeta muestra el tamaño de descarga.
FLUX.1-schnell y FLUX.1-dev muestran texto rojo: 'You need to update DiffusionBee to use this model.' El evaluador había descargado la app unos dos minutos antes.
El directorio de PromptQuorum indica como última actualización upstream de DiffusionBee el 30 de octubre de 2024 (más de un año antes de esta prueba), y el pie de la página del fabricante dice '© 2024'. El README del proyecto menciona SD 1.x, SD 2.x, SD XL, Inpainting, ControlNet y LoRA, y no menciona FLUX. Leído el 16 de octubre de 2026; no se pudo leer la lista de versiones en GitHub.
En la página Models hay un botón 'Import From Computer'. El evaluador infiere que se pueden importar modelos que ya tenga (no probado).
Pregunta por qué la página no muestra los tamaños de los modelos para ver qué funciona en su ordenador, y por qué no hay una breve explicación de para qué sirve cada modelo. 'And as no instruction, it is just like the random downloads again.'
Una tarjeta de Samaritan 3d Cartoon mostraba una barra de descarga al 1 por ciento sin tamaño (notas y una captura pequeña).
Primeras imágenes: un círculo y una imagen de marca
Prompt 'circle with green dot in the middle': un disco blanco con el centro verde sobre fondo verde. Ajustes: Default_SDB_0.1, 512 x 512, 1 imagen, seed -1, 25 pasos. Cada imagen lleva un botón 'Actions'.
A continuación, 'a real challenge': un prompt largo y estructurado para una imagen de marca y un logo de PromptQuorum. Ajustes: Default_SDB_0.1, 1024 x 1024, 3 imágenes, 25 pasos. La pantalla muestra un indicador de carga, 'Add to Queue' y 'Stop all'.
Los tres resultados son cajas y tarjetas en blanco y negro con letras distorsionadas. No hay un 'PromptQuorum.com' legible ni un logo utilizable.
El evaluador escribe 'I assume the prompt failed because that was not requested'. El sentido no está claro en las notas.
Le gusta poder elegir el número de imágenes y el tamaño. Echa de menos un indicador de velocidad, una hora de finalización y 'some entertainment while it's working'.
Un lugar real: Heidelberg
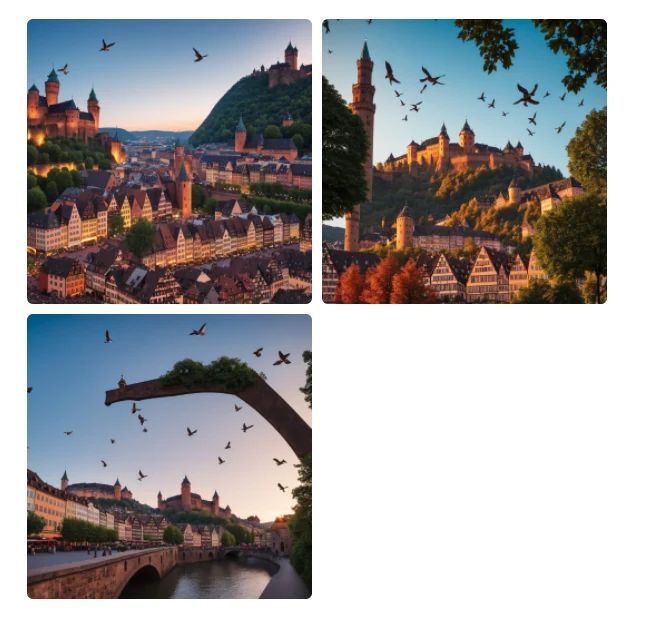
El prompt, escrito hace años para un modelo de frontera: una imagen fotorrealista desde el Heumarkt de Heidelberg mirando hacia el castillo, con pájaros y un amanecer detrás del castillo. Modelo y ajustes no registrados.
Los tres resultados muestran un castillo en una colina boscosa sobre casas antiguas de entramado de madera, con pájaros. Ninguno muestra la vista del Heumarkt ni el castillo de Heidelberg como tal.
El evaluador esperaba que un modelo de imágenes conociera un lugar real y su ángulo. Él mismo dice: 'too much expected from this tool'.
'I could have written, do a castle up the hill with a sunset and birds behind. That's the difference between frontier models with access to the internet and pure LLMs that are just generating pictures.'
La diferencia es el acceso a internet o al conocimiento de lugares. No se probó en este informe.
El evaluador probó también imágenes que 'otros sistemas podrían rechazar'. Las notas dicen que la app 'did not say stop on anything'. Los prompts no se registraron y no hay captura.
Inpainting: logo y transeúnte
Al abrir Inpainting se pide otro modelo más: 'ControlNet Inpaint', al 3 por ciento, sin tamaño.
Prueba 1: una foto de una caja de pasta. Prompt 'remove barillia logo' (marca mal escrita), con una máscara sobre el logo. El primer intento 'failed' según las notas.
Tras un segundo intento, el texto del logo ya no se lee, pero quedan manchas rosas y las hebras de espagueti están emborronadas.
'Technically, removing worked, just not putting the spaghettis back together.'
Prueba 2: una foto de una calle con un transeúnte. En el resultado la persona ya no está. El evaluador: 'Nearly there. If you don't expect something and I don't look for it, you don't see it.'
La marca estaba mal escrita en el prompt ('barillia'). La máscara, no el prompt, hizo el trabajo, así que el efecto probablemente es pequeño (suposición).
AI Canvas e imagen a imagen: cielo y pop art
AI Canvas con la foto de la calle y el prompt 'Make the sky dark blue, real summer day' con Input Strength 30. El resultado no se capturó.
'Blue sky didn't work out, or I don't understand the mechanism.'
Imagen a imagen con 'make this into a pop art cartoon picture' en Samaritan_3d_Cartoon_v1_s2 con Input Strength 80.02. El resultado es una copia más suave y apagada de la foto, no pop art. Evaluador: 'Pop art also didn't work out. Not sure why.'
Esta captura está al final de las notas, después del comentario sobre la velocidad, y aquí se interpreta como el intento de pop art. No confirmado.
Un Input Strength más alto conserva más de la imagen original. Datos: 21.07 y 21.46 cambiaron mucho la imagen, 90.13 la devolvió casi sin cambios, 80.02 dio una copia casi idéntica. Solo cuatro ajustes; no se registró la explicación de la propia app.
Payaso, elefante, volcán: modelos, guía y un prompt negativo
El evaluador comprobó el uso de memoria con Samaritan 3D Cartoon. Prompt 'draw a clown dancing on an elephant', 512 x 512, 1 imagen: un payaso de dibujos animados bailando con una forma de elefante beige fundida detrás de él.
Memoria necesaria con este modelo: unos 5 GB 'of my VRAM'. Método no registrado. Apple Silicon tiene un único conjunto de memoria compartida.
Prompt más largo (payaso sobre un elefante, playa, océano azul, volcán en erupción) con el prompt negativo 'No blue sky!!' a 1024 x 1024: una criatura azul y musculosa con chispas de fuego. No se distingue ningún payaso, elefante, playa ni volcán. Evaluador: 'a nice result, but not really what I outlined'.
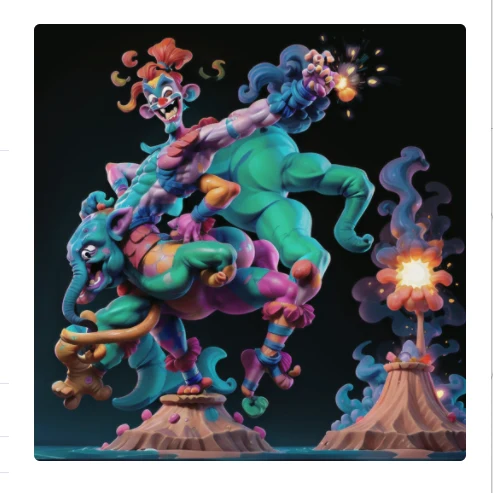
Con la escala de guía (guidance scale) al máximo (que, según la instrucción de la app, 'means it should really do what I ask'): aparecen un payaso, un animal parecido a un elefante y un volcán en erupción. No se distingue ninguna playa ni océano azul; el suelo es oscuro.
'I would say close, close, close or maybe perfect.'
El mismo prompt en JuggernautXL_v7_f8 (otra descarga más): un payaso con globos sobre un elefante, una gran columna del volcán, una playa con sombrillas y agua azul. El cielo es azul, así que no se siguió el prompt negativo 'No blue sky!!'. Evaluador: 'Looks great, except the negative prompt was skipped.'
Desea que la ventana diga qué es un modelo, en lugar de tener que buscarlo en otro sitio. Una respuesta de Google pegada en las notas describe Juggernaut XL como un ajuste fino de SDXL para fotorrealismo (véase Contexto).
Una pareja fotorrealista, y la velocidad
Prompt: 'photorealist a couple in love on the beach, watching the sunset over the ocean, birds in the sky, some boats on the water, some palm trees seen'. JuggernautXL_v7_f8, 1216 x 1216, 6 imágenes solicitadas. Se capturaron dos resultados.
Ambos muestran puesta de sol, palmeras y pájaros. El primero tiene un velero y una cámara sobre la arena; el segundo tiene varios barcos, pero tres personas en dos bancos donde el prompt pedía una pareja.
Aquí se muestra el segundo resultado (Figura 19).
'Looks a bit like AI, but well done, well done.' Le gusta poder elegir cuántas imágenes y de qué tamaño, y que la app 'just runs and runs' mientras uno hace otra cosa, y luego se elige la mejor.
Cerca de un minuto por imagen a la máxima resolución; un archivo de unos dos megabytes por imagen. Ninguna de las dos cifras se cronometró ni aparece en una captura. 'Not very fast, but it's okay.'
Más pruebas y la valoración final (notas encontradas en el documento de Msty)
El archivo de Word de la prueba de Msty contiene también notas y capturas sobre DiffusionBee. Se usan aquí como segunda fuente. No se registra su fecha ni su orden respecto a las pruebas anteriores; una captura de información de archivo con fecha 14 de octubre de 2026, 17:58, sugiere que fue el mismo día.
'Generate similar images' produjo cuatro escenas parecidas de una pareja en la playa a partir de una imagen. Evaluador: una función muy buena; la llama 'really impressive'.
Un PNG guardado en Descargas el 14 de octubre de 2026 a las 17:58 pesa 38 733 330 bytes (38.7 MB). No se registra de qué imagen se trata.
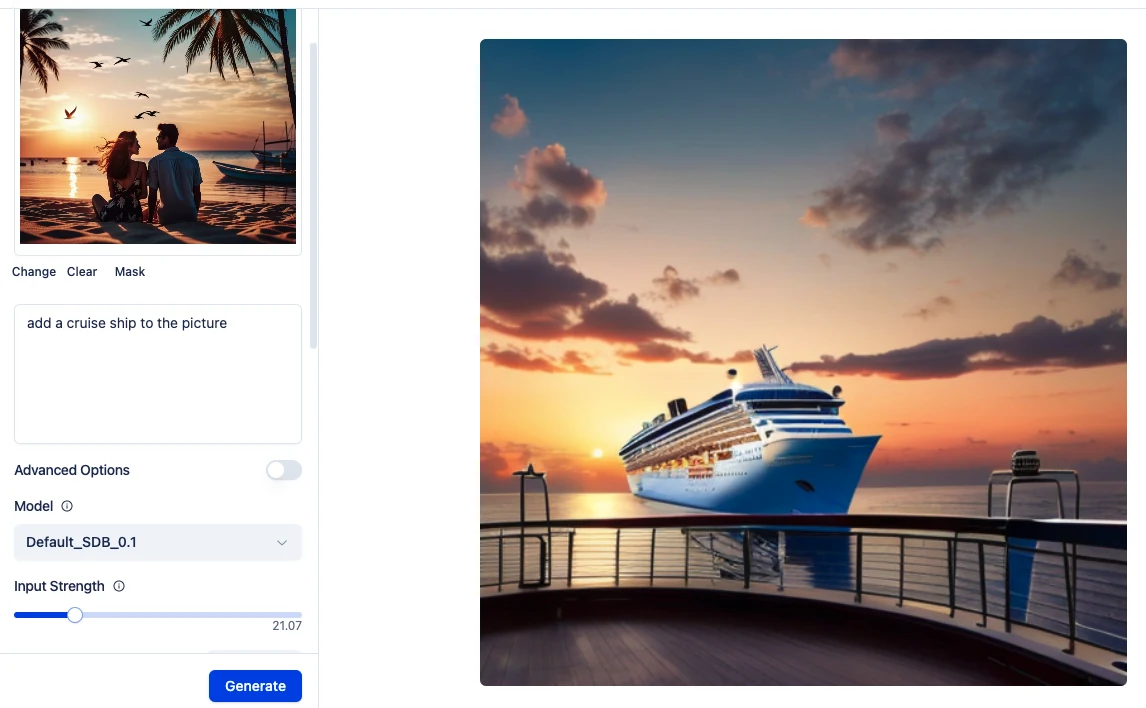
Imagen a imagen sobre la imagen de la pareja en la playa, prompt 'add a cruise ship to the picture', Input Strength 21.07: aparece un crucero al atardecer visto desde la barandilla de una cubierta. La pareja y las palmeras han desaparecido.
Segundo intento (prompt largo, Input Strength 21.46): una vista del mar al atardecer desde una cubierta con una palmera y sillas; sin barco en el horizonte.
Tercer intento (Input Strength 90.13): resultado casi idéntico a la imagen de entrada; sin barco.
Según las notas, poner Input Strength en 100 'crashes' la app. Sin captura; versión no registrada.
Prompt de la Torre Eiffel (JuggernautXL_v7_f8, 2 imágenes, seed 770465): dos torres casi idénticas vistas desde abajo. El evaluador dice que la torre está bien pero la dirección y las proporciones no, y que los árboles del jardín francés están 'spot on' mientras que el resto alrededor de la torre falla.
Horizonte nocturno de Nueva York con 'add 3 helicopters flying' (epicrealismXL_v8, 75 pasos): se ven más de tres helicópteros. Evaluador: 'cannot count till three and created a second Manhattan Island'.
Una foto de comida con el prompt 'make this german dinner into a cartoon style, many colors, really funny': según las notas, la app 'gave me the same picture back several times'. El resultado no se capturó.
El campo Seed tiene un texto de ayuda que el evaluador cita como 'Starting point for iteration. Any number will do. [App?] will pick one if left blank.' Dice que 'not sure what the value is'. La palabra anterior a 'will pick one' no se entiende en las notas.
Con la app de Claude, Word, WhatsApp, Chrome y otras apps abiertas, calcula el uso de memoria en unos 20 GB de 24 GB. Su lectura: 'even on a 24 gigabyte Mac... it's at the limit again'. La verdadera lección de sus pruebas es la VRAM.
'Function-wise and interface-wise, this is so far the best local LLM app tool that I tried... Not sure I need to learn two or three of these functions, which I do not understand what they do.' 'The first picture app that really works.'
Falta: afinar una imagen paso a paso ('this a little bit, this a little bit'). 'Currently it's not working.' Puede que la esté manejando mal. 'In a year from now, this will be perfect.' Última línea: 'Smooth interface, works with smaller models, really mostly self-explanatory. Great functions that you can hand over one picture to another tool.'
La previsión del evaluador de que los modelos locales estarán al nivel de los modelos en la nube en uno o dos años no se prueba aquí.