Figura 1Primer inicio. Un modelo local (Gemma 4 E2B, 3,6 GB, control de potencia en 'Capable') o un proveedor conectado. Un aviso amarillo dice 'Add at least one model before continuing with a connected provider.' y el botón Continue está en gris.
Veredicto
Valoración general
Probado en parte. Lo que el evaluador probó funcionó en su mayoría: Msty recogió sus modelos de Ollama existentes, un chat de texto y una subida de imagen funcionaron, y el Model Hub dice si un modelo cabe en el Mac. Lo que no salió bien: la web y las primeras pantallas no dicen para qué sirve la aplicación, una subida de archivo daba vueltas entre una base de conocimiento y el chat, y no se pudo usar ningún modelo de imagen en Media Studio. Las notas terminan en el Model Matchmaker sin una conclusión sobre Msty.
Encaje con el uso del evaluador
No registrado. La propia pregunta del evaluador, 'why should a home user use it', no se responde en las notas. El juicio final del archivo Word describe otra aplicación y no se usa aquí.
ObservadoLos modelos de Ollama existentes aparecieron en el selector de modelos de Msty. Las notas no registran una segunda descarga de modelo.
ObservadoDos cosas no funcionaron como el evaluador esperaba: la subida de archivo dio vueltas entre la base de conocimiento y el chat, y no se pudo usar ningún modelo de imagen local en Media Studio.
OpiniónEl evaluador no pudo deducir de la web para qué sirve Msty a un usuario doméstico. Las notas no contienen un veredicto final sobre Msty.
Puntuaciones Estado: Parcial
Instalaciónn/dTamaño de descarga registrado (246 MB). Los pasos de instalación y los avisos de macOS no se registraron.
Primeros pasos y elección de modelo3/5Los modelos de Ollama aparecen junto a los proveedores alojados y las tarjetas de modelos llevan una indicación de adecuación al hardware. Las primeras pantallas no dicen para qué sirve la aplicación, y la conexión con Ollama no fue evidente para el evaluador.
Función principal4/5El chat con un modelo de Ollama y la entrada de imagen funcionaron. Solo una respuesta de texto, una prueba de visión y una prueba de archivo; no se evaluó la calidad de las respuestas.
Guía e iteración2/5La subida de archivo dio vueltas entre una base de conocimiento y el chat. Los modelos solo de imagen y los marcados como nube están en el mismo selector que los de chat.
Rendimienton/dUn solo dato: 52,81 tok/s en una respuesta (nombre del modelo cortado en parte). Insuficiente para puntuar.
Documentaciónn/dNo probado.
Confianza y privacidadn/dNo auditado. El proveedor afirma ser un 'privacy-first workspace'; el selector también incluye un modelo ':cloud' y proveedores alojados. No se probó el funcionamiento sin conexión.
Desinstalaciónn/dNo probado.
Las puntuaciones son propuestas derivadas de la evidencia que se presenta más abajo (1 = deficiente, 5 = muy bueno). Corresponde al evaluador confirmarlas.
Detalles de la prueba
App
Msty Studio (escritorio) de CloudStack, LLC. Las notas lo escriben 'Mysty' y 'Misty' (transcripción de voz); este informe usa la grafía del proveedor. Del proveedor
Versión
No registrada. Como contexto: el registro de cambios del proveedor lista Msty Studio 3.0.0 Beta 15 (7 de octubre de 2026) y 2.9.11 (15 de septiembre de 2026) como versiones recientes.
Evaluador
Hans Kuepper, fundador de PromptQuorum
Inicio
13 de octubre de 2026 (hora no registrada). Las notas dicen que la prueba duraría 'over the next two days'. Observado
Fin
No registrada
Hardware
Mac de la familia Apple M3, 24 GB. Las notas dicen 'M3, 24 GB'. El equipo de pruebas estándar es un MacBook Pro con M3 Pro y 24 GB de memoria unificada; se supone el mismo equipo. La propia aplicación indicó en un momento 16,8 GB disponibles. Suposición
Sistema
macOS; versión no registrada
Fuente
Botón 'Download Studio' en la página de producto Studio del proveedor Observado
Descarga
246 MB (instalador, según lo leyó el evaluador) Observado
Plan usado
No registrado. Lista de precios del proveedor el 16 de octubre de 2026: Free 0 $; Aurum 149 $ por usuario al año; Aurum Lifetime 349 $ de pago único; Enterprise bajo petición. Del proveedor
Por qué se probó
El evaluador quería saber para qué sirve Msty. Lo describe como una de las herramientas tempranas y profesionales y no veía por qué un usuario doméstico debería usarla. Opinión
Objetivo
Según las notas: entender de qué trata Msty y ver cómo se conecta con modelos locales, con la esperanza de usar Ollama para no tener que descargar otro modelo. Observado
Ayuda de IA utilizada
No registrada
Cada afirmación lleva una etiqueta:ObservadoMedidoEstimación del evaluadorDel proveedorDe tercerosSuposiciónOpiniónError propioQué significan las etiquetas
Transparencia. El evaluador fundó PromptQuorum (promptquorum.com), un sitio de contenidos y un directorio sobre aplicaciones de IA local. Msty figura en ese directorio y tiene en el sitio una página de reseña previa, escrita por separado. Las notas no registran contacto con el proveedor, pago ni patrocinio.
Descargar 10 GB, 20 GB y modelos distintos para cada aplicación simplemente no es el camino.
Notas del evaluador, editadas ligeramente a partir de la transcripción de voz.
Cómo fue la prueba
La web: ¿para qué sirve?
Observado
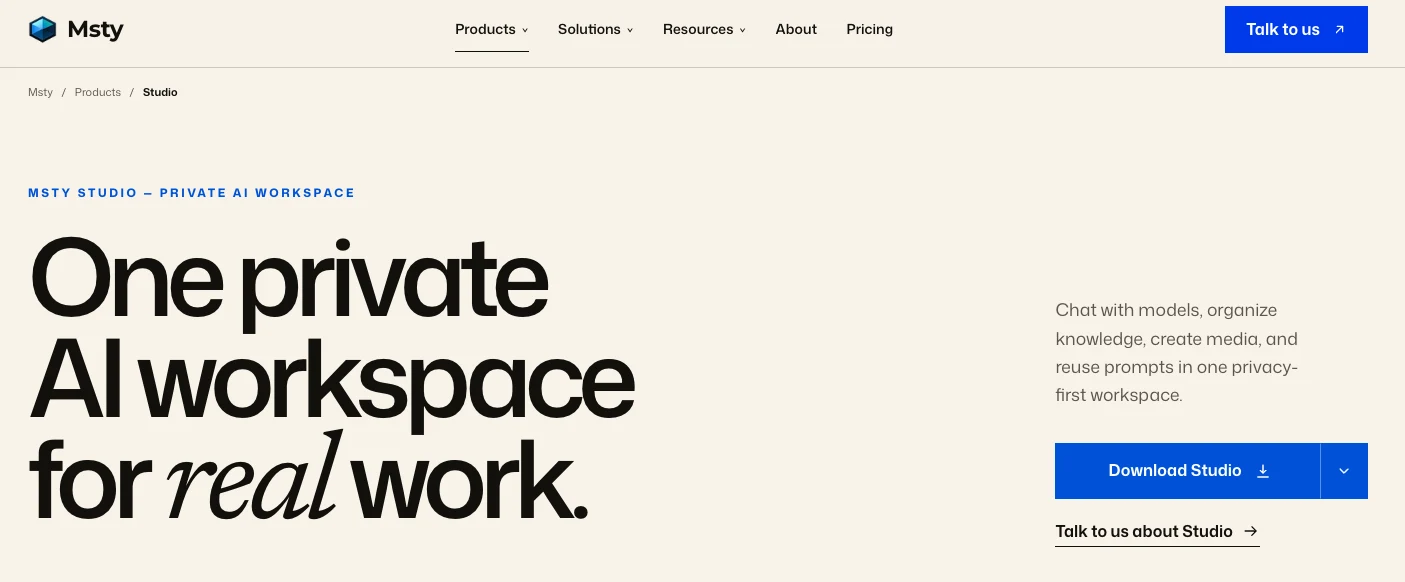
El evaluador empezó en la página de producto Studio. Titular: 'One private AI workspace for real work.' Subtítulo: 'Chat with models, organize knowledge, create media, and reuse prompts in one privacy-first workspace.' Botón: 'Download Studio'.
Figura 2La página de producto Studio de la que partió el evaluador. El titular y la línea 'Chat with models, organize knowledge, create media, and reuse prompts in one privacy-first workspace.' son la redacción del proveedor.
Opinión
Quería entender de qué va Msty: es 'one of the early ones, one of the professional ones', y para un usuario doméstico no tenía claro el sentido. 'The screen makes it clear that it's not clear what it's actually for.'
Observado
El evaluador vio varias soluciones y productos y eligió 'Download Studio' porque parecía el que se ejecuta en local.
Del proveedor
La página de producto del proveedor nombra Studio, Go ('bounded AI agents'), Nexus ('AI control center') y Stack ('governed knowledge layer'). Comprobado el 16 de octubre de 2026; el evaluador no los abrió.
Observado
El archivo de descarga pesa 246 MB. El evaluador: 'so it's okay'.
Opinión
Esperaba una conexión con Ollama o LM Studio para no tener que descargar otro modelo. En su opinión, toda aplicación debería ofrecer esa opción junto a los modelos integrados, porque descargar 10 a 20 GB por aplicación es 'just not the way forward'.
Primer inicio: un modelo local o un proveedor
Observado
La primera pantalla (figura 1, arriba en esta página) ofrece una tarjeta con la etiqueta 'LOCAL AI · RUNS ON YOUR MACHINE': Gemma 4 E2B, 3,6 GB, descrito como el modelo multimodal compacto de Google con visión. Un control de potencia va de Light a Powerful y está en 'Capable'. El botón dice 'Download & Get Started'.
Observado
Debajo, 'Or connect an AI provider' muestra OpenAI, Claude, xAI, Gemini, OpenRouter y 'More'. Un aviso amarillo dice 'Add at least one model before continuing with a connected provider.' y 'Continue with connected provider' está en gris.
Del proveedor
'Runs on your machine' es la etiqueta de la propia aplicación. El evaluador no descargó este modelo (usó modelos que ya estaban en Ollama) y no comprobó el tráfico de red.
Suposición
El aviso aparece porque en ese momento no se había añadido ningún modelo. No se probó qué acción habilita 'Continue'.
Conectar Ollama
Observado
La lista 'New Model Provider' agrupa Msty Remote y Ollama bajo 'Msty Compatible', MLX Remote bajo 'MLX Compatible' y LLaMA.cpp bajo 'OpenAI Compatible'. La lista de la captura está desplazada, así que las entradas por encima de xAI no se ven.
Figura 3Lista 'New Model Provider', desplazada. Ollama está bajo 'Msty Compatible', MLX Remote bajo 'MLX Compatible', LLaMA.cpp bajo 'OpenAI Compatible'. Las entradas por encima de xAI no se ven.
Observado
Notas: 'It allowed me to connect to Ollama, select Ollama, but then it didn't select it.' Volvió a la pantalla de descarga local para ver qué pasaba.
Error propio
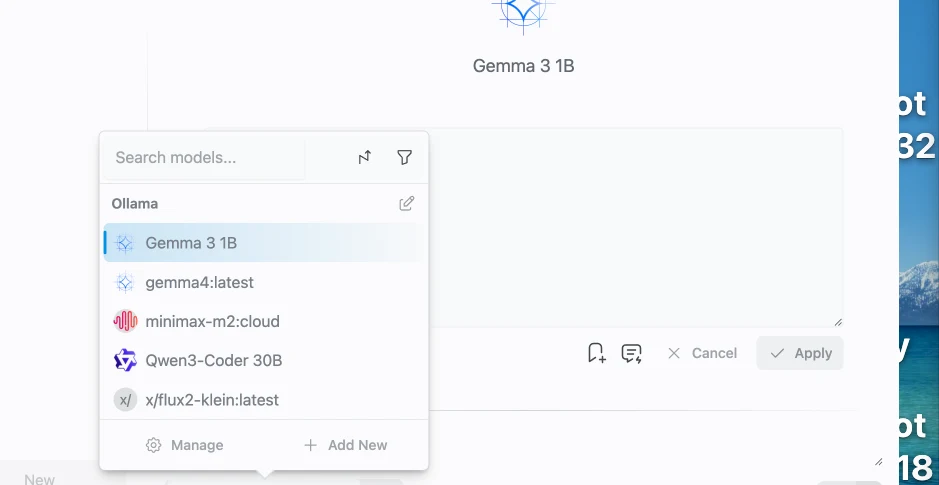
La conexión había funcionado. El evaluador no se dio cuenta porque, según sus palabras, la aplicación muestra el nombre del modelo y no la palabra Ollama. El selector listaba luego cinco modelos bajo un encabezado Ollama.
Figura 4Selector de modelos tras conectar Ollama: cinco modelos bajo un encabezado 'Ollama', incluidos un modelo de imagen (x/flux2-klein:latest) y una entrada ':cloud' en la misma lista que los modelos de chat.
Observado
Corrección a las notas: la captura del selector sí muestra un encabezado 'Ollama' sobre la lista. Las notas probablemente se refieren a una pantalla anterior que no se capturó (hipótesis).
Observado
Se cumplió la esperanza declarada del evaluador: sus modelos de Ollama existentes eran utilizables y las notas no registran otra descarga de modelo.
Suposición
El sufijo ':cloud' de minimax-m2:cloud sugiere un modelo que se ejecuta en la nube y no en el Mac. No verificado. Si es así, la lista de Ollama mezcla modelos locales y en la nube sin un marcador visible.
Opinión
'So good, so good. Thanks.'
Pruebas de chat
Observado
El evaluador pidió un código QR (texto del prompt no registrado; la respuesta menciona www.promptquorum.com). La respuesta decía que es una IA basada en texto que no puede generar imágenes, y daba cinco pasos para usar un generador de QR en línea gratuito.
Figura 5Respuesta a la petición del código QR. El nombre del modelo está cortado arriba ('gemma4:latest' visible en parte). Un pliegue 'Thoughts (1)' está sobre la respuesta. El contador bajo la respuesta marca 52,81 tok/s.
Medido
Bajo la respuesta se muestran 52,81 tok/s. El nombre del modelo está cortado en parte ('gemma4:latest' visible arriba; la coincidencia es probable, no segura).
Error propio
A un modelo de texto se le pidió una imagen. La respuesta fue correcta para un modelo de texto. El evaluador lo planteó como 'the difference to a functional model'.
Observado
El evaluador seleccionó entonces como modelo de chat un modelo de imagen de un trabajo anterior (x/flux2-klein en Ollama). Según las notas, 'does not support chat'. El mensaje en sí no se capturó.
Suposición
El evaluador dudaba de que se puedan cargar dos o tres modelos a la vez ('I don't think so'). No probado. La página del proveedor menciona 'Split Chats: run models side by side'.
Observado
De vuelta en gemma4:latest subió una imagen y el modelo pudo leerla (solo notas; la imagen y la respuesta no se registraron).
Subir un archivo de Search Console
Observado
El evaluador subió una exportación de Google Search Console. Según las notas, la aplicación 'just ran' un análisis sin que se lo pidieran. El primer punto del consejo, citado en las notas: 'Investigate High-CTR Regions: A rapid audit of Gambia, Saint Barthélemy, Bangladesh, and Gabon is essential.' Las cifras no se contrastaron con el archivo. Modelo y tamaño del archivo no registrados.
Observado
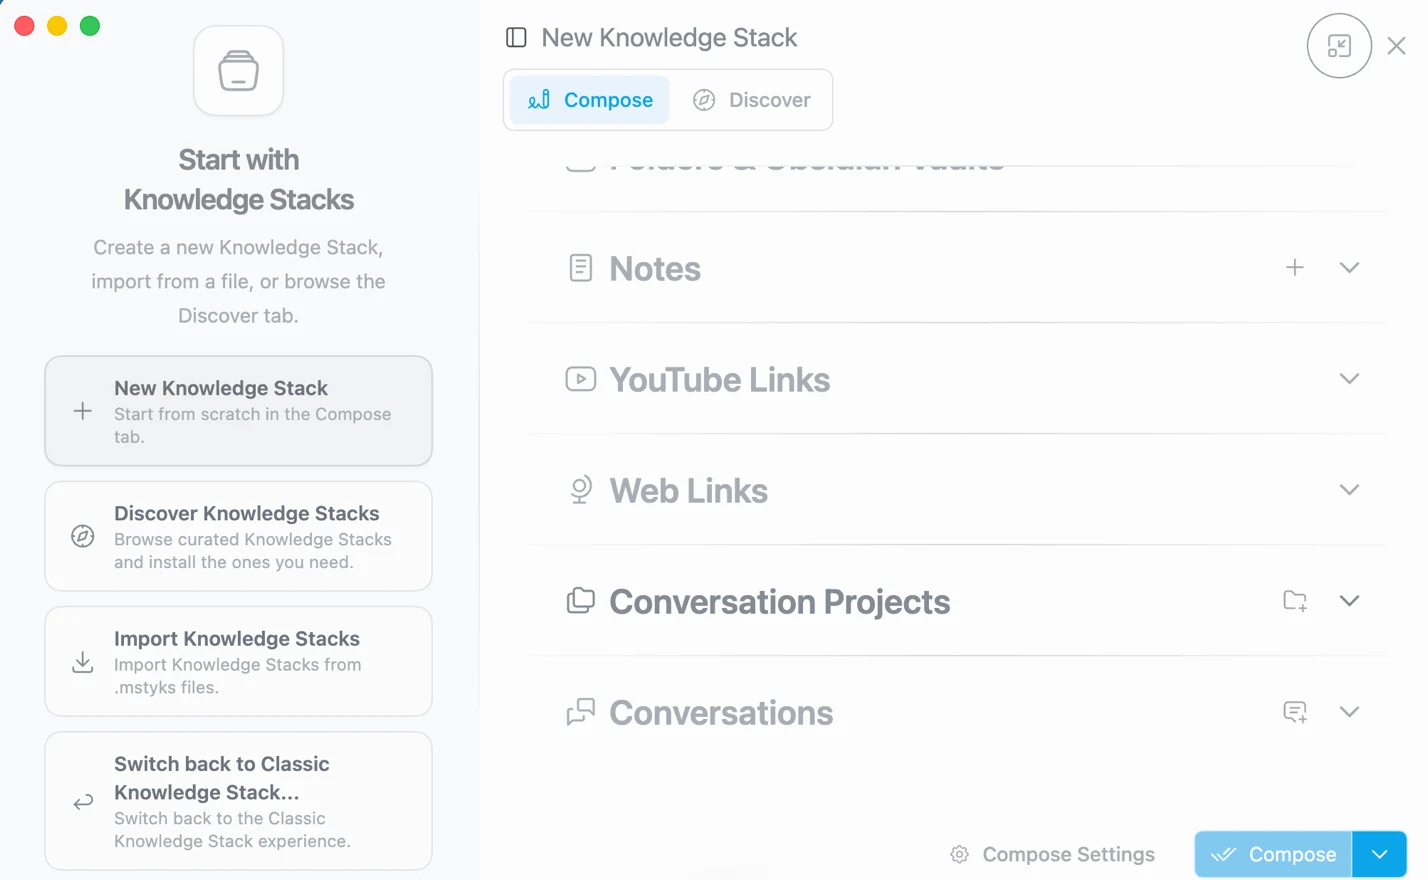
El bucle, tal como se describe: subir el archivo lo coloca en 'some background tool, knowledge base'. De vuelta en el chat, la aplicación analiza automáticamente y no da ocasión de decir qué analizar. Escribir 'I want this analyzed' en el chat hace que la aplicación pida los datos.
Figura 6Pantalla de inicio de Knowledge Stacks: nuevo, descubrir, importar (archivos .mstyks) y 'Switch back to Classic Knowledge Stack'. Fuentes a la derecha: Notes, YouTube Links, Web Links, Conversation Projects, Conversations. No está confirmado que el archivo de Search Console pasara por esta pantalla.
Suposición
La captura de Knowledge Stacks sigue a estas notas. Que el archivo pasara por Knowledge Stacks es la lectura del evaluador ('knowledge base'), no confirmada.
Observado
La pantalla Knowledge Stacks ofrece: nuevo stack, descubrir stacks seleccionados, importar archivos .mstyks y 'Switch back to Classic Knowledge Stack'. Fuentes mostradas: Notes, YouTube Links, Web Links, Conversation Projects, Conversations; una fila cortada arriba parece decir 'Folders & Obsidian Vaults'.
Opinión
'Okay, this goes in circles.' Luego: 'So this looks like an interesting tool, but let's see.'
Media Studio
Observado
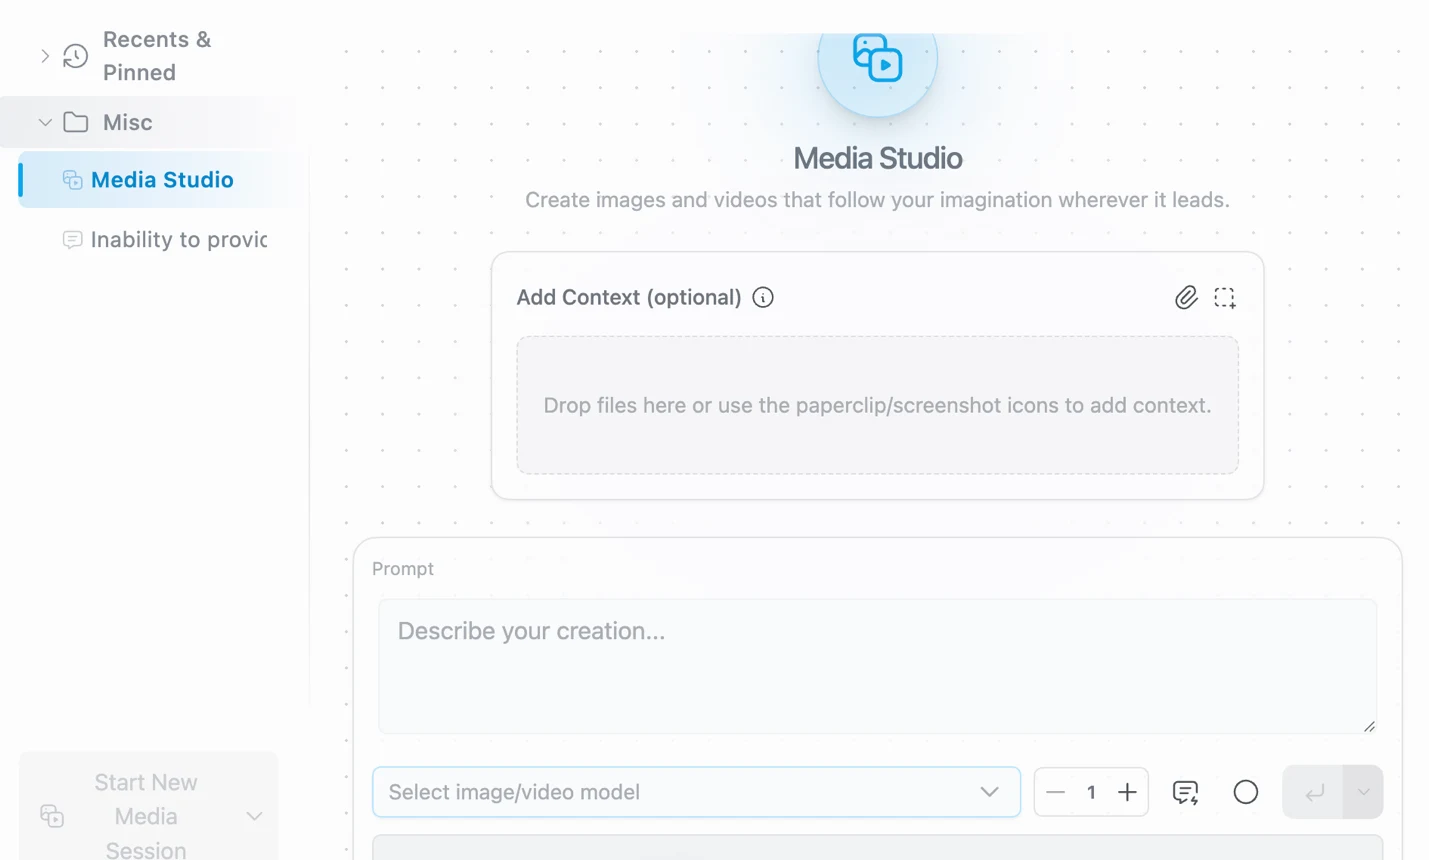
La barra lateral tiene una entrada 'Media Studio'. La pantalla dice 'Create images and videos that follow your imagination wherever it leads.' Tiene una zona opcional para soltar contexto, un cuadro de prompt ('Describe your creation...'), un contador en 1 y un menú que dice 'Select image/video model'.
Figura 7Media Studio. El menú de modelos sigue diciendo 'Select image/video model'. No se capturó el contenido del menú; no se generó ninguna imagen.
Opinión
'Great, can do pictures too.' Pero al conectar con su configuración local de LLM, la aplicación dijo que su Ollama no tiene modelo de imágenes, y él pensaba que Flux era el adecuado.
Observado
No se generó ninguna imagen en Msty. Las notas no registran ningún selector de modelo de imagen que le funcionara.
Suposición
Media Studio no lista el modelo de imagen de Ollama x/flux2-klein. No se capturó el contenido del menú de modelos. El registro de cambios del proveedor sitúa Media Studio en la versión 2.7.0 (29 de abril de 2026) y menciona modelos de imagen y vídeo de xAI y OpenRouter, lo que sugiere proveedores alojados. No verificado.
Model Hub y Model Matchmaker
Observado
La barra lateral del Model Hub lista Model Providers, Local Models, Model Squad, Model Matchmaker, Model Cost Calculator, VRAM Calculator y Context Explorer. Local Models tiene las pestañas Featured, Installed, Search e Import. Según las notas, solo se abrió el Matchmaker.
Figura 8Model Hub, modelos locales Featured (lista desplazada, solo en parte visible): Mistral 7B Instruct v0.3 6,9 GB, Llama 3.2 3B 1,7 GB, Llama 3.2 1B 645 MB, Meta Llama 3.1 8B 4,5 GB, todos etiquetados como 4-bit. La barra lateral lista siete herramientas.
Observado
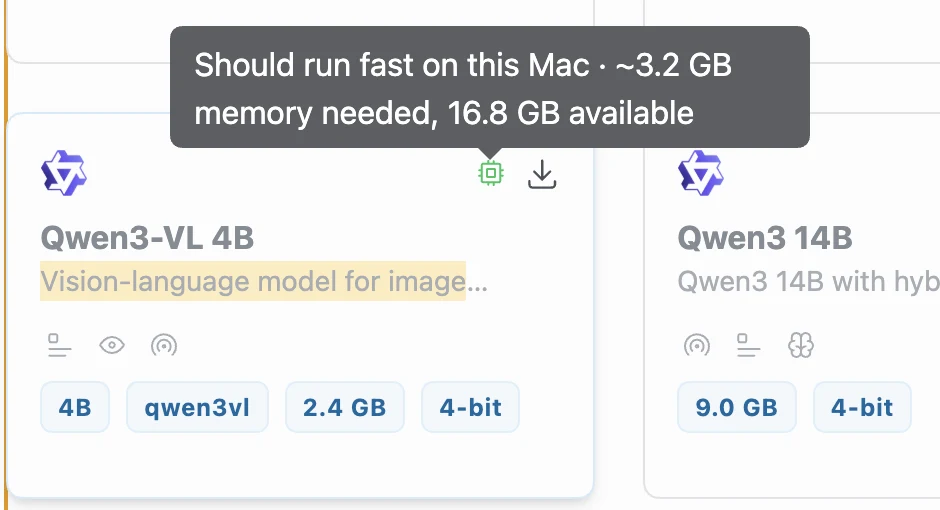
Las tarjetas de modelos muestran tamaño y cuantización. Un tooltip en Qwen3-VL 4B (2,4 GB, 4-bit) dice 'Should run fast on this Mac · ~3.2 GB memory needed, 16.8 GB available'.
Figura 9Indicación de hardware en una tarjeta de modelo: 'Should run fast on this Mac · ~3.2 GB memory needed, 16.8 GB available'. La tarjeta muestra Qwen3-VL 4B, 2,4 GB, 4-bit. La estimación es de la aplicación; el modelo no se ejecutó.
Del proveedor
Esa estimación de adecuación es de la propia aplicación. El modelo no se ejecutó.
Opinión
'Model Matchmaker. Great idea. I like it.' Pero no encontró selectores para la generación de imágenes.
Observado
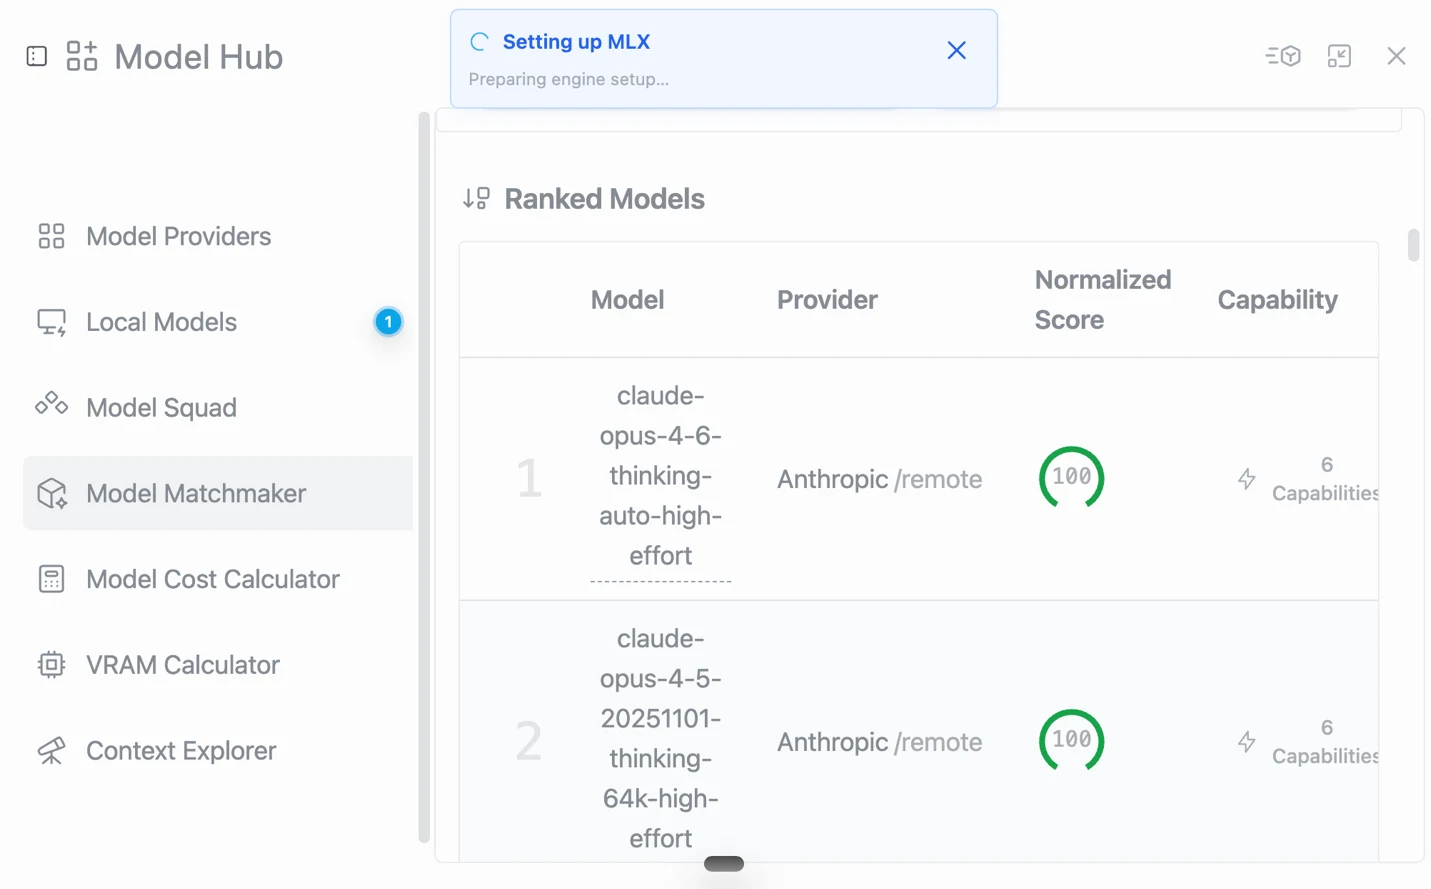
La siguiente captura muestra la lista clasificada del Matchmaker: n.º 1 claude-opus-4-6-thinking-auto-high-effort y n.º 2 claude-opus-4-5-20251101-thinking-64k-high-effort, ambos 'Anthropic /remote', puntuación 100. Es visible un aviso 'Setting up MLX: Preparing engine setup...'; no se registró por qué apareció.
Figura 10Model Matchmaker, 'Ranked Models'. N.º 1 claude-opus-4-6-thinking-auto-high-effort, n.º 2 claude-opus-4-5-20251101-thinking-64k-high-effort, ambos proveedor 'Anthropic /remote', puntuación normalizada 100. Se muestra un aviso 'Setting up MLX: Preparing engine setup...'. La fecha de los datos del ranking no es visible.
Opinión
'In October 2026 and I see this, I'm not impressed. That is an AI process to update this. I have tools on my website to update the website. Why is it so difficult?'
Suposición
'This' se lee aquí como que el ranking de la captura está desactualizado. Las notas no dicen a qué pantalla se refería.
De terceros
La página de modelos de Anthropic (consultada el 16 de octubre de 2026) indica Claude Opus 5.5 (claude-opus-5-5) como el Opus más reciente y no presenta los dos modelos 4.x como actuales. La fecha de los datos del ranking no se ve en la captura, así que no está confirmado que esté desactualizado.
Observado
Los modelos Featured visibles son Mistral 7B Instruct v0.3, Llama 3.2 3B y 1B, y Meta Llama 3.1 8B. Mistral 7B, con 6,9 GB, es más grande que Llama 3.1 8B, con 4,5 GB, ambos etiquetados como 4-bit; la diferencia no se explica en las tarjetas.
Dónde terminan las notas
Observado
La parte de Msty de las notas termina en el Model Matchmaker. El resto del archivo Word (desde el pasaje 'Generate similar images') describe otra aplicación, un generador de imágenes, con sus propias capturas. Se dejó fuera de este informe.
Observado
No registrado para Msty: versión de la aplicación y de macOS, hora de fin, plan usado, un veredicto, una comprobación de desinstalación.
Afirmaciones frente a lo que vio el evaluador
Afirmación
Fuente
Observado
Etiqueta
'Chat with models, organize knowledge, create media, and reuse prompts in one privacy-first workspace.'
Página Studio del proveedor (también en la captura del evaluador)
El chat con modelos de Ollama funcionó. Knowledge Stacks se abrió. Media Studio se abrió pero no produjo ninguna imagen. No se probó reutilizar prompts. No se auditó la privacidad.
Observado
'Bring local inference engines like MLX, llama.cpp, and Ollama together with hosted providers in one organized hub.'
Página Studio del proveedor, consultada el 16/10/2026
Ollama se conectó y sus modelos se listaron. LLaMA.cpp y MLX Remote aparecen en la lista de proveedores. Solo se usó Ollama. Un aviso de configuración de MLX apareció una vez.
Observado
Split Chats: 'run models side by side'
Página Studio del proveedor, consultada el 16/10/2026
No probado. El evaluador suponía que no se pueden cargar dos o tres modelos a la vez.
Suposición
Media Studio: generación de imágenes y elaboración de conceptos de vídeo
Página Studio del proveedor, consultada el 16/10/2026
La pantalla existe. No se generó ninguna imagen; no se encontró ningún modelo de imagen local utilizable.
Observado
'LOCAL AI · RUNS ON YOUR MACHINE' (Gemma 4 E2B, 3,6 GB)
Pantalla del primer inicio
No descargado. El evaluador usó modelos que ya estaban en Ollama. Sin comprobación de red.
Observado
'Should run fast on this Mac · ~3.2 GB memory needed, 16.8 GB available'
Tooltip del Model Hub
El modelo no se ejecutó, así que la estimación no se comprobó.
Del proveedor
Plan Free: 0 $, incluye modelos locales y en línea y Media Studio (algunas funciones limitadas)
Página de precios del proveedor, consultada el 16/10/2026
El plan que usó el evaluador no está registrado.
Del proveedor
¿Cabe en 24 GB?
24 GB de memoria
Llama 3.2 1B (4-bit)645 MB por debajo de 24 GBObservado
Llama 3.2 3B (4-bit)1,7 GB por debajo de 24 GBObservado
Qwen3-VL 4B (4-bit)Archivo de 2,4 GB; la aplicación indica unos 3,2 GB de memoria necesaria por debajo de 24 GBDel proveedor
Gemma 4 E2B (descarga del primer inicio)3,6 GB por debajo de 24 GBObservado
Meta Llama 3.1 8B (4-bit)4,5 GB por debajo de 24 GBObservado
Mistral 7B Instruct v0.3 (4-bit)6,9 GB por debajo de 24 GBObservado
Qwen3 14B (4-bit)9,0 GB por debajo de 24 GBObservado
Son tamaños de descarga que muestran las tarjetas de modelos, no memoria en ejecución. La longitud de contexto y el motor cambian lo que necesita un modelo. La aplicación indicaba 16,8 GB disponibles en el momento del tooltip de Qwen3-VL. Los modelos de Ollama que el evaluador usó realmente (Gemma 3 1B, gemma4:latest, Qwen3-Coder 30B) no muestran tamaño en el selector. La tarjeta de Qwen3 14B solo se ve en parte en la captura (su nombre, tamaño y cuantización se leen).
Registro de uso
#
Tarea
Modelo
Resultado
Tiempo
Estado
Figuras
1
Conectar Ollama como proveedor
-
Conectado; cinco modelos listados bajo Ollama. El evaluador creyó al principio que había fallado.
Error propioCreyó que la conexión con Ollama había fallado. Había funcionado; los modelos estaban listados.
Error propioPidió una imagen (código QR) a un modelo de texto y luego lo juzgó frente a un 'functional model'.
Error propioEscribió que la aplicación no dice 'Ollama'. Su propia captura muestra un encabezado 'Ollama' sobre la lista de modelos.
Error propioDejó lagunas en el registro: versión de la aplicación, versión de macOS, hora de fin, plan usado, prompts, qué modelo respondió la prueba de archivo y un veredicto sobre Msty.
Error propioMezcló dos aplicaciones en un documento. La segunda mitad del archivo de Msty describe un generador de imágenes, lo que restó claridad sobre dónde termina la prueba de Msty.
SuposiciónEl evaluador dudaba de que varios modelos puedan ejecutarse a la vez. No probado, y el proveedor menciona Split Chats.
Registro de hallazgos
ID
Hallazgo
Categoría
Etiqueta
Gravedad
Figuras
MS-01
La página Studio y las primeras pantallas no dicen a un usuario doméstico para qué sirve la aplicación.
La primera pantalla ofrece un modelo local (Gemma 4 E2B, 3,6 GB) o un proveedor alojado; Ollama no aparece allí y figura en cambio en la lista de proveedores.
El ranking del Matchmaker lo encabezan dos modelos Claude Opus 4.x mientras Anthropic indica Opus 5.5 como el más reciente; desactualización no confirmada (sin fecha de datos visible).
La gravedad es el impacto en un usuario nuevo. Es una propuesta, no una medición.
Para quién es
Encaje probable
SuposiciónPersonas que ya usan Ollama y quieren un único frontal de escritorio para modelos locales y alojados (la reutilización de Ollama funcionó en esta prueba).
Del proveedorEquipos que necesitan SSO, registros de auditoría y controles compartidos (indicados en la página Studio del proveedor; no probados).
Encaje poco probable
OpiniónUn usuario doméstico que quiere entender desde las primeras pantallas para qué sirve la aplicación.
SuposiciónUsuarios que esperan generar imágenes en Media Studio con un modelo de imagen local de Ollama (no funcionó en esta prueba).
Nueva prueba. Repetir las partes no probadas (Split Chats, prompts, Media Studio con un modelo de imagen alojado, el flujo de archivos, la desinstalación) y registrar antes la versión y macOS. El registro de cambios muestra que la 3.0.0 seguía en beta el 7 de octubre de 2026, así que la interfaz puede cambiar con el lanzamiento (hipótesis).
Vale, esto da vueltas en círculos.
Notas del evaluador, editadas ligeramente a partir de la transcripción de voz.
Preguntas frecuentes
¿Funciona Msty Studio con Ollama?
Sí, en esta prueba. Tras añadir Ollama como proveedor, cinco modelos de Ollama aparecieron en el selector de modelos, y las notas no registran una segunda descarga de modelo. El evaluador creyó al principio que la conexión había fallado. Observado
¿Puede Msty Studio generar imágenes con un modelo local de Ollama?
No en esta prueba. Media Studio se abrió, pero el evaluador no encontró forma de usar allí su modelo de imagen local (x/flux2-klein) y no se generó ninguna imagen. El contenido del menú 'Select image/video model' no se capturó y no se probaron proveedores alojados. Observado
¿Dice Msty Studio si un modelo cabe en mi Mac?
Las tarjetas de modelos del Model Hub llevan una indicación de hardware, por ejemplo 'Should run fast on this Mac · ~3.2 GB memory needed, 16.8 GB available' en Qwen3-VL 4B. La estimación es de la propia aplicación; el modelo no se ejecutó. Del proveedor
¿Cuánto cuesta Msty Studio?
La lista de precios del proveedor, leída el 16 de octubre de 2026, muestra Free a 0 $, Aurum a 149 $ por usuario al año y Aurum Lifetime a 349 $ de pago único. El plan que usó el evaluador no está registrado. Del proveedor
Contexto sobre el desarrollador
Fuera de la sesión práctica. Lo siguiente procede del sitio del proveedor, su registro de cambios y el directorio de PromptQuorum, leídos el 16 de octubre de 2026 con una herramienta de obtención web que resume páginas. Nada se verificó de forma independiente para esta prueba.
Del proveedorEl pie de página del proveedor dice 'Msty is a product of CloudStack, LLC.' (2026).
Del proveedorLista de precios: Free 0 $; Aurum 149 $ por usuario al año; Aurum Lifetime 349 $ de pago único; Enterprise y Teams bajo petición, mínimo 5 puestos. La página de precios no indica una licencia de software.
De tercerosEl directorio de PromptQuorum lista Msty como de código cerrado, freemium, para macOS, Windows y Linux, última actualización upstream el 7 de octubre de 2026. La ficha no se ha verificado (actualidad: sin verificar).
Del proveedorRegistro de cambios: Media Studio introducido en la versión 2.7.0 (29 de abril de 2026); el soporte de MLX para Apple Silicon aparece por primera vez en 2.0.0-alpha.10 (7 de agosto de 2025), marcado como experimental; Knowledge Stacks 2.0 en 2.0.0-alpha.9 (31 de julio de 2025). Última versión listada el 7 de octubre de 2026: 3.0.0 Beta 15.