Prueba práctica de PromptQuorum · Unsloth · 9 de octubre de 2026
Unsloth en un Mac de 24 GB: una app pulida, sin memoria antes de la primera imagen
Prueba práctica en un Mac de 24 GB, centrada en la generación de imágenes. El chat funcionó; los modelos de imagen fueron rechazados por falta de memoria y no se generó ninguna imagen.
Figura 1Rechazo de la carga del modelo de imagen flux.2-klein. La app indica unos 17 GB necesarios y unos 2 GB utilizables (7 GB libres en ese momento, menos el espacio para el sistema operativo). Nombra una variable para forzar la carga, UNSLOTH_DIFFUSION_ALLOW_OVERSIZED_LOAD=1, que no se probó.
Veredicto
Valoración general
La app se ve y se siente pulida: un instalador de 24 MB, una ventana de instalación que muestra lo que hace, un hub de modelos con lectura del hardware, avisos de tamaño y un temporizador de descarga, y un chat que encuentra modelos ya presentes en el disco de LM Studio y Ollama. Un cálculo se ejecutó a 11,0 tokens por segundo con un modelo de 27B. El objetivo de la prueba, una imagen, no se alcanzó. Los modelos de imagen fueron rechazados porque la app contaba solo 2 GB (antes de reiniciar) y 6 GB (después) como utilizables frente a unos 17 GB necesarios; una búsqueda web y una búsqueda de eventos terminaron en 'Ran out of memory'; y el arranque de un modelo no mostró progreso durante minutos. El evaluador hizo las primeras pruebas con muchas otras apps abiertas y no registró los modelos ni los ajustes de algunas ejecuciones.
Encaje con el uso del evaluador
No para este evaluador en este equipo, por ahora. En sus palabras: 'Everything works, except that the end result is I didn't get it to work.' El chat y la gestión de modelos funcionan con 24 GB; la generación de imágenes no funcionó en esta prueba. No se probó el entrenamiento. El evaluador piensa volver a mirarlo en tres a seis meses.
ObservadoEl chat funciona: un modelo de 27B en 4 bits de la carpeta de LM Studio respondió a un cálculo a 11,0 tokens por segundo. Los modelos de Ollama y LM Studio aparecen en la app.
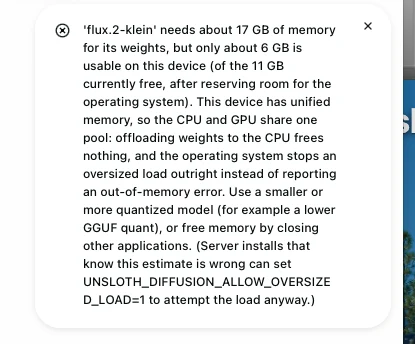
MedidoLos modelos de imagen fueron rechazados: flux.2-klein necesita unos 17 GB; la app contó unos 2 GB utilizables (7 GB libres) y, tras reiniciar, unos 6 GB (11 GB libres). No se generó ninguna imagen.
OpiniónUna interfaz preciosa en la que todo funciona, pero el resultado final no se alcanzó en un Mac de 24 GB.
Puntuaciones Estado: Parcial
Instalación4/5DMG de 24 MB; ventana de instalación con registro detallado. Sin estimación de tiempo ni de disco; de cuatro a cinco minutos (estimación del evaluador). La prueba partió de una instalación existente.
Primeros pasos y elección de modelo3/5El selector, el hub, la lectura del hardware, los avisos de tamaño y el temporizador de descarga son puntos fuertes. El selector muestra el número de parámetros, no gigabytes; los mensajes de '7 GB' y '17 GB' confundieron al evaluador.
Función principal2/5El chat respondió a un cálculo. La lectura de una página web y una búsqueda de eventos terminaron en errores de memoria; no se generó ninguna imagen.
Guía e iteración3/5El mensaje de rechazo explica la causa y nombra una forma de forzar la carga. Sin progreso mientras arranca un modelo; sin explicación de por qué había 7 GB 'libres'.
Rendimiento2/511,0 tok/s con un modelo de 27B en 4 bits; sin memoria con 34,4k de contexto en un Mac de 24 GB, con otras apps abiertas.
Documentaciónn/dNo probado.
Confianza y privacidadn/dNo auditado. El proveedor afirma un uso 100 % sin conexión; la búsqueda web y las descargas necesitan internet. No se probó el funcionamiento sin conexión.
Desinstalaciónn/dNo probado.
Las puntuaciones son propuestas derivadas de la evidencia que se presenta más abajo (1 = deficiente, 5 = muy bueno). Corresponde al evaluador confirmarlas. La generación de imágenes, el objetivo del evaluador, puntúa bajo porque no se generó ninguna imagen en este equipo.
Detalles de la prueba
App
Unsloth, la app de escritorio (Unsloth Studio). Las notas lo escriben 'Unsloth', 'Unslothh' y 'Onslaught'; este informe usa 'Unsloth'. Observado
Versión
Registro de instalación: 'unsloth 2026.8.18 -> 2026.10.3 available, updating'. Se supone que la versión en uso tras la actualización es la 2026.10.3. La ventana lleva la etiqueta BETA. No se registró la versión de la propia app de escritorio. Suposición
Evaluador
Hans Kuepper, fundador de PromptQuorum
Inicio
9 de octubre de 2026, 13:00 (según las notas). Una captura muestra las 17:13, así que la prueba duró al menos cuatro horas. Observado
Fin
No registrado
Hardware
Mac con 24 GB. Las notas dicen 'macOS M3 24 GB' y después 'M3 24 GB Pro MacBook'. El Model hub de la app muestra '24 GiB RAM', '0 GiB VRAM + 24 GiB shared' y '12/12 CPU'. No se registró el chip exacto. Observado
Sistema
macOS; versión no registrada
Estado de la instalación
No era una instalación limpia. El registro de instalación dice 'Updating existing Unsloth install' y 'existing install detected'; el evaluador dice 'same as before'. Un uso anterior puede explicar que ya se conocieran los modelos de LM Studio y Ollama. Observado
Descarga
DMG de 24 MB (según lo leyó el evaluador). En el primer inicio se ejecutó un paso de dependencias (véase el capítulo 1). Observado
Por qué se probó
Para ver cómo funciona Unsloth, 'especially the picture functions'. El evaluador no pensaba usar la optimización de modelos (entrenamiento).
Objetivo
Generar imágenes en local en el Mac de 24 GB. Por el camino se probaron el chat y el hub de modelos. Observado
Ayuda de IA utilizada
En las notas hay un prompt de varios cientos de palabras sobre el skyline de Nueva York; sus negritas en Markdown sugieren que lo escribió una IA. No confirmado. Las respuestas del modelo de chat (por ejemplo, sobre de dónde sacó el modelo) no se tomaron como base aquí. Suposición
Cada afirmación lleva una etiqueta:ObservadoMedidoEstimación del evaluadorDel proveedorDe tercerosSuposiciónOpiniónError propioQué significan las etiquetas
Transparencia. El evaluador fundó PromptQuorum (promptquorum.com), un sitio de contenidos y un directorio sobre aplicaciones de IA local. Unsloth figura en ese directorio y tiene en el sitio una página de reseña previa, escrita por separado. Las notas no registran contacto con el proveedor, pago ni patrocinio.
Todo funciona, salvo que el resultado final es que no conseguí que funcionara.
Notas del evaluador, editadas ligeramente a partir de la transcripción de voz.
Cómo fue la prueba
Descarga, instalación y primer inicio
Observado
El instalador es un DMG de 24 MB, que el evaluador describe como 'the smallest file I've ever seen'.
Observado
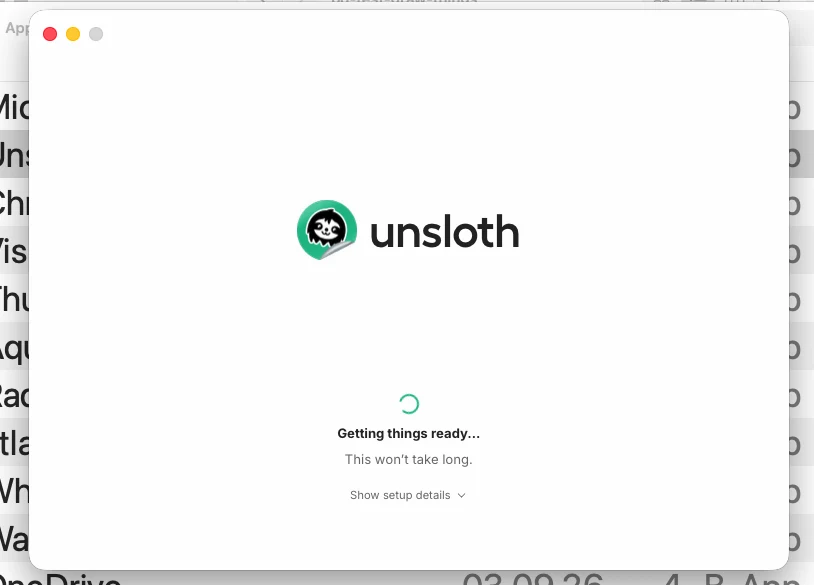
Primera ventana: 'Getting things ready... This won't take long.' con un enlace 'Show setup details'. El evaluador: 'Already feels much more polished than the other apps... a clear communication.'
Figura 2Primera ventana tras abrir la app de DMG de 24 MB. El texto dice que no tardará; el evaluador no midió nada y estima de cuatro a cinco minutos (el registro de actualización está en el texto). No se muestra estimación de tiempo ni de disco.
Observado
El registro detallado dice: 'Updating existing Unsloth install', 'frontend bundled (Tauri)', 'node v24.13.0 | npm 11.6.2 (system)', 'unsloth 2026.8.18 -> 2026.10.3 available, updating', y luego una barra de dependencias de 13 pasos (arranque de pip, pila MLX para Apple Silicon, paquetes base, extras de unsloth, códecs, overrides, dependencias de studio, data designer, plugin local, versión fijada de diffusers, finalización). Notas: 'torch 2.10.0 detected -- installing torchao==0.16.0'; 'transformers 5.3.0, 5.5.0, 5.10.2 pre-installed'; 'gpu Apple Silicon (Metal, unified memory)'; 'installing prebuilt llama.cpp'.
Observado
El evaluador dice que se ejecutó unos cuatro o cinco minutos y luego se abrió la app. El registro no muestra estimación de tiempo ni de espacio en disco.
Estimación del evaluador
Cuatro a cinco minutos para la instalación. Sin cronometrar.
Suposición
El DMG, pequeño, probablemente descarga la mayor parte del software durante este primer paso. No comprobado.
Opinión
'It gives me the details about what it does -- great -- but it doesn't tell me anything about estimated time, volumes, how much disk space it takes up.'
Observado
La ventana principal se abre con 'How can I help?' y una barra lateral: New chat, Model hub, Library, Images, Train, More. El logotipo lleva la etiqueta BETA.
Figura 3Ventana principal tras la instalación. Barra lateral: New chat, Model hub, Library, Images, Train, More. El logotipo lleva la etiqueta BETA. Una pestaña del navegador tras la ventana muestra una página de GitHub del proyecto.
Error propio
Partió de una instalación existente ('same as before'), así que es una actualización, no una prueba de primer uso. Las conclusiones sobre los primeros pasos necesitan una instalación limpia para confirmarse.
Selector de modelos y primer chat
Observado
El selector de modelos lista modelos Recommended con cifras como 27.3B y 271.0M. Son números de parámetros, no gigabytes. Dos entradas aparecen en gris (176.9B y 320.8B).
Figura 4Selector de modelos, pestaña Recommended. Las cifras son números de parámetros (B = miles de millones, M = millones), no gigabytes. Dos entradas están en gris (Qwen3.8-Flash-Next-GGUF 176.9B, GLM-5.3-Flash-GGUF 320.8B). Qué significan el gris y el punto amarillo no se indica en la vista capturada de la app.
Suposición
Las entradas en gris probablemente son demasiado grandes para este equipo. La vista capturada de la app no lo dice.
Opinión
'There were lots of models listed with the size. Very good.' Las cifras mostradas son números de parámetros, así que no indican al lector cuánta memoria necesita un modelo.
Observado
En lugar de elegir un modelo, el evaluador escribió una petición de cálculo. La app empezó a cargar modelos por su cuenta. Un modelo Qwen3.8-27B MLX de 4 bits arrancó en menos de un minuto, según las notas; un segundo aviso mostró la carga de Mistral-7B-Instruct-v0.3-4bit (captura no incluida, del mismo tipo que la Figura 5).
Observado
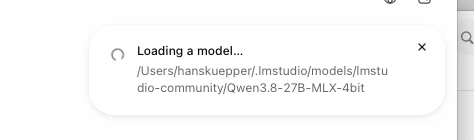
El aviso de carga muestra la ruta /Users/hanskuepper/.lmstudio/models/lmstudio-community/Qwen3.8-27B-MLX-4bit. El modelo se leyó de la carpeta de LM Studio en el disco.
Figura 5Aviso mostrado al iniciarse el primer chat. La ruta apunta a la carpeta de modelos de LM Studio: /Users/hanskuepper/.lmstudio/models/lmstudio-community/Qwen3.8-27B-MLX-4bit. El modelo se cargó desde el disco, no se descargó.
Opinión
Sospechó que venía del disco duro, porque 'that's a big model that doesn't go over the internet in one minute'. La ruta lo respalda. No se registró por qué Unsloth eligió este modelo y el de Mistral.
Observado
A la pregunta 'what is 5 times 866' se respondió '5 x 866 = 4,330' (correcto), tras 'Worked for 10s', a 11,0 tok/s. El encabezado muestra 'Local' y un medidor de contexto '120 / 262.1k'.
Figura 6Primer chat. La respuesta 4.330 es correcta (5 x 866). La pantalla muestra 'Worked for 10s', 11,0 tok/s y un medidor de contexto '120 / 262.1k'.
Observado
Después el evaluador preguntó al modelo de dónde había sacado el modelo. La parte capturada de la respuesta habla de pesos MLX y memoria unificada de Apple Silicon; la respuesta completa no se capturó. Las notas dicen que la respuesta fue que la app no busca en el disco.
Suposición
El relato que hace el propio modelo de chat sobre la app no es una evidencia fiable. Una respuesta llama al modelo 'Qwen 3 27B MLX 4-bit', mientras que la app lo llama Qwen3.8-27B-MLX-4bit.
Modelos ya presentes en el disco: LM Studio y Ollama
Observado
La pestaña On Device lista los modelos por origen. En CUSTOM FOLDERS aparecen dos rutas (.lmstudio/models y .ollama/models) con los modelos de Ollama gemma4:latest, gemma3:1b y qwen3-coder:30b. En LM STUDIO el modelo Qwen3.8-27B figura como 'Loaded'.
Figura 7Pestaña On Device. En CUSTOM FOLDERS se listan dos rutas (.lmstudio/models y .ollama/models) con los modelos de Ollama gemma4:latest, gemma3:1b y qwen3-coder:30b; en LM STUDIO el modelo Qwen3.8-27B figura como 'Loaded'. Tras la lista se ve en parte una respuesta del chat que habla de pesos MLX. No se registró si el evaluador añadió las carpetas o se encontraron automáticamente.
Suposición
O el evaluador añadió las dos carpetas o la app las encontró sola. No registrado. Un uso anterior de la app pudo haberlas configurado.
Observado
Al cambiar a qwen3-coder:30b (30.5B, Q4_K_M, GGUF) aparece 'Starting model... Switching models. Loading cached model into memory.' con un botón Cancel. El medidor de contexto marca '1.3k / 8.2k', mucho menos que los 262.1k del primer modelo.
Figura 8Cambio al modelo de Ollama qwen3-coder:30b (30.5B, Q4_K_M, GGUF). Medidor de contexto '1.3k / 8.2k'. El aviso dice 'Starting model... Switching models. Loading cached model into memory.' con un botón Cancel.
Opinión
'I like how easy to change models.' 'Some Ollama models do not work inside Unsloth, but great that it tried at least.'
Observado
Según las notas, un modelo más antiguo funcionó y uno más nuevo se colgó. No se registró a qué modelos se refiere.
Opinión
Dice que está bien ('great that it tried') que intentara usar sus modelos de Ollama, y que leer los modelos que ya están en el disco evita otra descarga grande.
Hub de modelos y descargas
Observado
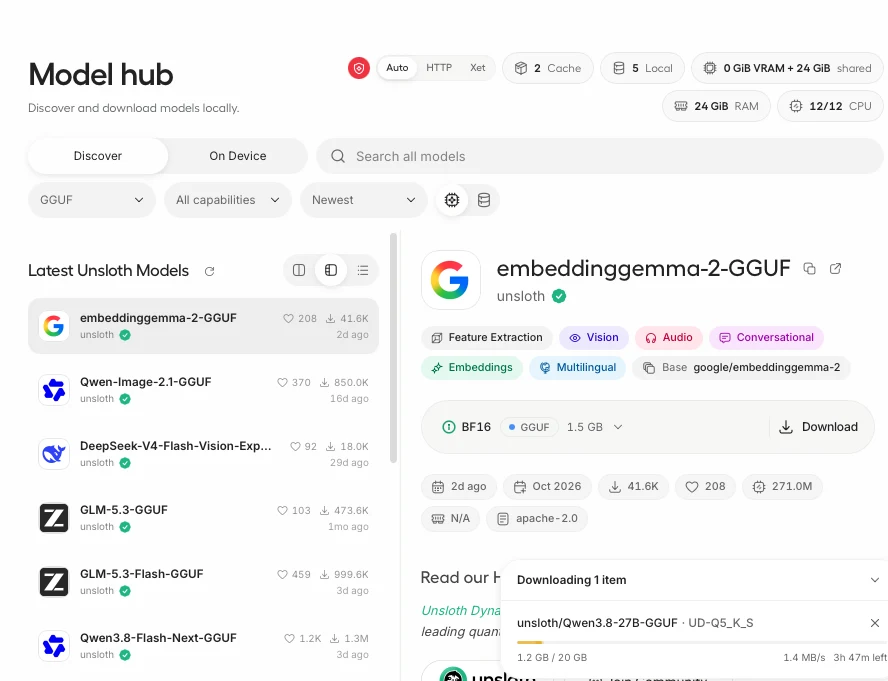
El hub muestra el dispositivo: '0 GiB VRAM + 24 GiB shared', '24 GiB RAM', '12/12 CPU', además de filtros (formato, capacidades, más recientes). Las tarjetas muestran me gusta, descargas, antigüedad y licencia (embeddinggemma-2-GGUF: apache-2.0, 1,5 GB).
Figura 9Model hub. Arriba a la derecha: '0 GiB VRAM + 24 GiB shared', '24 GiB RAM', '12/12 CPU'. Panel de descarga: unsloth/Qwen3.8-27B-GGUF UD-Q5_K_S, 1,2 GB de 20 GB, 1,4 MB/s, 3 h 47 m restantes. La tarjeta de modelo abierta, embeddinggemma-2-GGUF (1,5 GB, apache-2.0), no es el modelo que se descarga.
Opinión
'Yes, great model hub.' El hub lista, entre otros, Qwen-Image-2.1-GGUF (850.0K descargas, 16 días), GLM-5.3-GGUF y Qwen3.8-Flash-Next-GGUF.
Observado
Según las notas, al hacer clic en un archivo demasiado grande para el Mac aparecieron varios avisos ('this file is 30 to 40 gigabytes total'); la descarga sigue permitida. Sin captura.
Medido
El panel de descarga de unsloth/Qwen3.8-27B-GGUF UD-Q5_K_S indica 1,2 GB de 20 GB a 1,4 MB/s, quedan 3 h 47 m; más tarde 7,1 GB de 20 GB a 983 KB/s, quedan 3 h 31 m.
Figura 10La misma descarga más tarde: 7,1 GB de 20 GB a 983 KB/s con 3 h 31 m restantes. No se registró el tiempo transcurrido entre esta captura y la anterior.
Opinión
'The professionalism of this app is visible. It has a timer attached. It tells you the download speed.'
Suposición
Las velocidades sugieren una conexión lenta en el lugar de la prueba; el evaluador no lo dice. No se registró si la descarga terminó.
Medido
El cuadro de Z-Image (BF16) lista archivos del modelo de 12,3 GB más codificador y decodificador necesarios de 8,2 GB, total 20,5 GB. Esto explica la 'difference between the gigabytes that the model has and then something else' que el evaluador menciona en otro punto.
Figura 19Cuadro de descarga de Z-Image (BF16): archivos del modelo 12,3 GB, 'Include required files' 8,2 GB (codificador y decodificador, compartidos entre variantes compatibles), total 20,5 GB. 'Downloading will not load this model or switch your current model.'
Opinión
Las notas dicen 'the picture LLM was downloaded'. No se registró cuál; las capturas muestran en el dispositivo los modelos de imagen FLUX.2-klein-4B y su variante GGUF (Figura 18).
Búsqueda web, voz y los cierres inesperados
Observado
El evaluador pegó la URL de una página de PromptQuorum y preguntó 'from a seo perspective will this help me?'. El chat muestra 'Using tool: Reading promptquorum.com' y 'Waiting for approval: web_search' con los botones Allow, Always allow y Deny. Marca de hora 17:13; contexto '648 / 34.4k'.
Figura 11Chat con Qwen3.8-27B-MLX-4bit, contexto '648 / 34.4k', marca de hora 17:13. El prompt da una URL de PromptQuorum y pregunta por SEO. La app muestra 'Waiting for approval: web_search' y los botones Allow, Always allow, Deny. El modo es 'Approve for me'.
Observado
Según las notas, el primer intento dijo que no podía leer la página; tras pulsar la función Search funcionó al segundo intento. 'Maybe the first time should have had a warning.'
Suposición
El primer fallo pudo deberse a la falta de aprobación de la búsqueda web o a que el interruptor Search estaba apagado. No verificado.
Observado
La ejecución terminó con 'Ran out of memory. Try a smaller model or shorter input.' tras 168,10 s, con un botón Retry.
Figura 12El mismo chat termina con 'Ran out of memory. Try a smaller model or shorter input.' tras 168,10 s.
Observado
La entrada de voz está integrada. Al usarla pide descargar el modelo de voz 'Qwen3-ASR 0.6B', de unos 1,0 GB, que según dice se descarga una sola vez en la caché de Hugging Face. No se registró si el evaluador lo descargó.
Figura 13Entrada de voz: 'Local dictation runs entirely offline, but it needs the Qwen3-ASR 0.6B speech model first. About 1.0 GB, fetched once into your Hugging Face cache.' No se registró si el evaluador lo descargó.
Observado
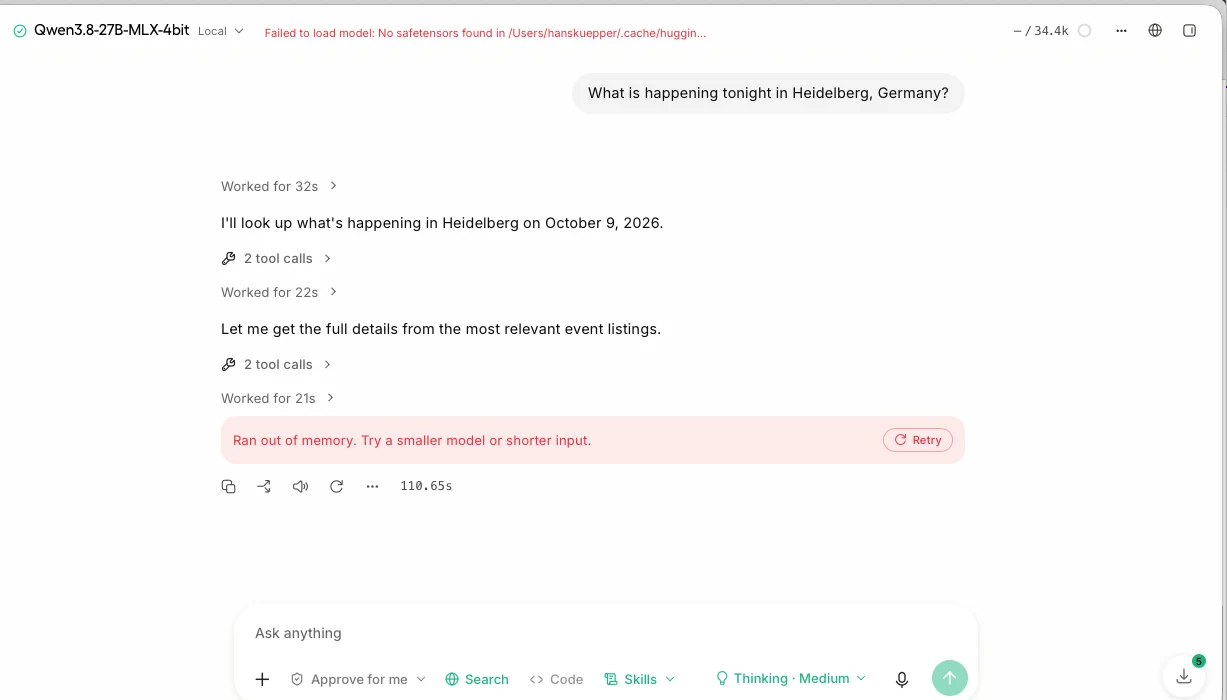
Una búsqueda local de eventos ('What is happening tonight in Heidelberg, Germany?') hizo dos rondas de llamadas a herramientas y terminó con 'Ran out of memory' tras 110,65 s. El encabezado muestra una nota roja: 'Failed to load model: No safetensors found in /Users/.../.cache/huggin...'.
Figura 14Búsqueda local de eventos. Encabezado (rojo): 'Failed to load model: No safetensors found in /Users/.../.cache/huggin...'. En el chat, dos rondas de 'tool calls' y luego 'Ran out of memory. Try a smaller model or shorter input.' tras 110,65 s. Contexto '- / 34.4k'. La insignia de descargas muestra 5.
Suposición
El error de carga y el mensaje de falta de memoria pueden estar relacionados (un modelo que se intercambiaba mientras la memoria escaseaba). La captura no muestra ningún vínculo.
Opinión
'But yes, local AI, always some issues.'
Modelos de imagen: rechazados por memoria
Observado
El objetivo del evaluador eran las imágenes. La barra lateral tiene un elemento 'Images'. Las notas muestran un largo prompt del skyline de Nueva York (vista de Brooklyn, puente de Brooklyn, hora dorada, detalle 8K) con listas de composición y de cosas que evitar. No se registran resultado, error ni ajustes.
Medido
La carga del modelo de imagen flux.2-klein fue rechazada: 'needs about 17 GB of memory for its weights, but only about 2 GB is usable on this device (of the 7 GB currently free, after reserving room for the operating system)'. Añade que el Mac tiene un único conjunto de memoria, que descargar a la CPU no libera nada, y sugiere un modelo más pequeño, una cuantización menor o cerrar otras apps. Nombra UNSLOTH_DIFFUSION_ALLOW_OVERSIZED_LOAD=1 como forma de forzar la carga.
Figura 1Rechazo de la carga del modelo de imagen flux.2-klein. La app indica unos 17 GB necesarios y unos 2 GB utilizables (7 GB libres en ese momento, menos el espacio para el sistema operativo). Nombra una variable para forzar la carga, UNSLOTH_DIFFUSION_ALLOW_OVERSIZED_LOAD=1, que no se probó.
Medido
Tras un reinicio limpio el mensaje dice: unos 17 GB necesarios, unos 6 GB utilizables, de 11 GB libres en ese momento.
Figura 15Segundo rechazo de flux.2-klein: unos 17 GB necesarios, unos 6 GB utilizables (11 GB libres en ese momento). Se interpreta aquí como tomado tras el reinicio limpio, según el orden de las notas.
Suposición
Los dos mensajes difieren en 5 GB en ambos pares (7 - 2 y 11 - 6), así que la app parece reservar unos 5 GB para el sistema operativo. Solo dos datos.
Observado
La lista del dispositivo muestra FLUX.2-klein-4B-GGUF (7,8 GB), FLUX.2-klein-4B (16 GB) y mistral-7b-v0.3-bnb-4bit (4,1 GB). El evaluador: 'This should be small enough.' Dice que el modelo de imagen más pequeño del hub cuelga su equipo de 24 GB, y que todos los modelos en los que hizo clic decían ser demasiado grandes porque solo había 'seven gigabytes' disponibles.
Figura 18Modelos en el dispositivo bajo UNSLOTH: FLUX.2-klein-4B-GGUF (BF16, icono de imagen, 4B, 7,8 GB), FLUX.2-klein-4B (icono de imagen, 4B, 16 GB), mistral-7b-v0.3-bnb-4bit (7B, 4,1 GB).
Error propio
El evaluador se pregunta por qué solo hay siete gigabytes disponibles ('I have much more'). El cuadro indica que en ese momento había 7 GB libres y que las demás apps estaban abiertas; tras el reinicio indica 11 GB. Las notas sitúan el comentario de los '7 GB' junto al cuadro de Z-Image; la cifra de 7 GB está en el mensaje de flux.2-klein.
Opinión
'I'm lost... I have a 24-gigabyte machine and I cannot find an LLM that can serve me and can do the job.' Opina que 24 GB es más de lo que tiene el 80 % de sus lectores (estimación suya, no una cifra medida).
Estimación del evaluador
'More than 80% of my readers' tienen 24 GB o menos. Fuente no indicada.
La memoria en el Mac
Observado
El evaluador concluye que los modelos locales y el trabajo diario compiten por la misma memoria, y que Chrome y otras apps ocupan de 5 a 8 GB. Escribió 'VRAM' en todo momento; Apple Silicon tiene un único conjunto de memoria, como dice el hub ('0 GiB VRAM + 24 GiB shared').
Medido
Monitor de Actividad, una captura: memoria usada 12,92 GB, archivos en caché 10,95 GB, memoria de apps 9,81 GB, residente 1,83 GB, swap 0.
Figura 16Panel de memoria con un historial largo y plano. Memoria usada 12,92 GB, archivos en caché 10,95 GB, memoria de apps 9,81 GB, residente 1,83 GB, swap usado 0 bytes. No se registraron el momento de la captura ni las apps abiertas.
Medido
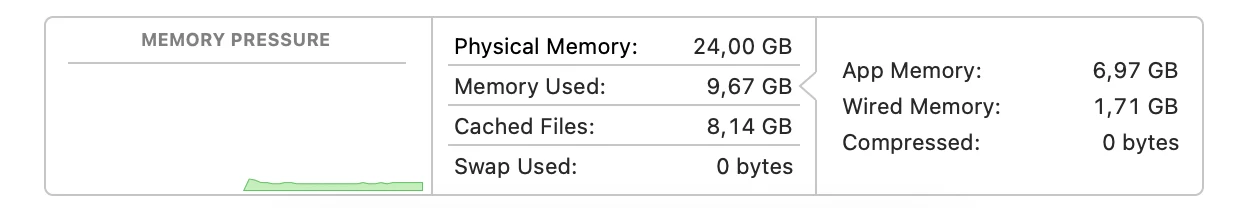
Monitor de Actividad, otra captura: memoria usada 9,67 GB, archivos en caché 8,14 GB, memoria de apps 6,97 GB, residente 1,71 GB, swap 0. El breve gráfico de historial encaja con un arranque reciente.
Figura 17Panel de memoria con un historial corto que empieza tarde en el gráfico. Memoria usada 9,67 GB, archivos en caché 8,14 GB, memoria de apps 6,97 GB, residente 1,71 GB, swap 0. Coincide con el comentario de '10 GB at startup' de las notas; no se registró qué momento muestra.
Suposición
Los 11 GB 'currently free' de la Figura 15 son coherentes con 24,00 - 12,92 = 11,08 GB de la Figura 16. No se registró si ambas se tomaron al mismo tiempo.
Opinión
'Even after reboot, already nine gigabytes gone for general things.' 'Either I shut the computer down, reboot, stop all the processes... or I cannot run the LLM.'
Opinión
Dos respuestas posibles: los modelos deben hacerse más pequeños y mejores, o los ordenadores necesitan 48 o 64 GB. 'All of this talk about this works on your computer is a little bit fake.'
Suposición
Que 48 o 64 GB lo arreglarían 'con seguridad' no está probado.
Carga sin información y la valoración final
Observado
Al arrancar un modelo aparece un aviso 'Starting model... Loading cached model into memory.' con un indicador de carga y Cancel. Sin porcentaje, tamaño ni tiempo.
Figura 20Arranque de un modelo. El aviso muestra un indicador de carga y 'Loading cached model into memory.' Sin porcentaje, tamaño ni tiempo. El evaluador dice que duró más de dos o tres minutos (estimación).
Estimación del evaluador
La espera duró más de dos o tres minutos (sin cronometrar).
Opinión
'The worst way you can treat a client is to do the work and not update the client.' El evaluador lo considera un problema de interfaz de usuario.
Observado
Los medidores del encabezado muestran los tokens usados frente al contexto (por ejemplo '648 / 34.4k') y los tokens por segundo (11,0 tok/s).
Error propio
Las notas dicen 'no token counter'. Las capturas muestran un medidor de contexto y una cifra de tokens por segundo. Quizá se refería a un recuento de tokens por mensaje (suposición).
Error propio
Las notas llaman a un modelo de chat local 'the most stupid idea' porque 'does not research the internet'. Las mismas notas y capturas muestran una función Search, una solicitud de aprobación de búsqueda web y llamadas a herramientas que leen una página.
Opinión
No quiere entrenar modelos; la función de chat le sirve de poco; quiere una herramienta de imagen y vídeo y 'is not seeing it yet'. No se probaron el entrenamiento ni la pestaña 'Train'.
Opinión
'Maybe it's on my side, but no, not for me. I'll check again in three or six months, but currently not on a M3 24 GB Pro MacBook.'
Afirmaciones frente a lo que vio el evaluador
Afirmación
Fuente
Observado
Etiqueta
'Run and train image and video diffusion or multimodal models', en local (README de GitHub; página de documentación)
Proveedor, consultado el 16 de octubre de 2026
No se generó ninguna imagen. flux.2-klein fue rechazado (unos 17 GB necesarios; 2 GB y 6 GB utilizables). No se comprobó que cargaran variantes de imagen más pequeñas. Entrenamiento no probado.
Observado
'Training, MLX and GGUF inference all work inside of Unsloth' en macOS (documentación)
Proveedor, consultado el 16 de octubre de 2026
Un modelo MLX (Qwen3.8-27B de 4 bits) y un modelo GGUF (qwen3-coder:30b) se cargaron y respondieron. Entrenamiento no probado.
Observado
'Can be used 100% offline and locally on your computer' (documentación)
Proveedor, consultado el 16 de octubre de 2026
La búsqueda web y las descargas usaron internet. No se probó el uso sin conexión.
Observado
La búsqueda web 'visits pages directly' (documentación)
Proveedor, consultado el 16 de octubre de 2026
Se intentó leer una página; según las notas el primer intento falló y el segundo leyó la página. Después la ejecución se quedó sin memoria.
Observado
App de escritorio 'free and open source' (notas de la versión)
Proveedor, consultado el 16 de octubre de 2026
Ni en las notas ni en las capturas aparece ninguna solicitud de pago.
Observado
Hardware mostrado en el hub
App
El hub mostró 24 GiB RAM, 0 GiB VRAM + 24 GiB shared y 12/12 CPU. La cifra de RAM coincide con los 24,00 GB del Mac.
Ni la página de GitHub ni la de documentación indicaban un requisito de memoria en el texto obtenido. La app indica su propia necesidad al cargar (17 GB para flux.2-klein).
Observado
¿Cabe en 24 GB?
24 GB de memoria
Pesos de flux.2-klein, según el mensaje de rechazounos 17 GB necesarios por debajo de 24 GBMedido
FLUX.2-klein-4B (lista del dispositivo)archivo de 16 GB por debajo de 24 GBMedido
FLUX.2-klein-4B-GGUF (lista del dispositivo)archivo de 7,8 GB por debajo de 24 GBMedido
Utilizable según la app, antes del reiniciounos 2 GB de 7 GB libres por debajo de 24 GBMedido
Utilizable según la app, tras el reiniciounos 6 GB de 11 GB libres por debajo de 24 GBMedido
Memoria usada del Mac, Monitor de Actividad (primera captura)12,92 GB usados por debajo de 24 GBMedido
Memoria usada del Mac, Monitor de Actividad (segunda captura)9,67 GB usados por debajo de 24 GBMedido
Descarga total de Z-Image BF1612,3 GB de modelo + 8,2 GB de archivos necesarios (tamaño de descarga) por debajo de 24 GBMedido
Las filas 2, 3 y 8 son tamaños de archivo o de descarga, no uso de memoria en ejecución. La cifra de 17 GB es la estimación de la propia app para flux.2-klein; no se registró a qué variante de archivo se refiere. 'Utilizable' es la cifra de la app tras reservar espacio para el sistema operativo. El modelo Qwen3.8-27B MLX de 4 bits se ejecutó en el chat; no se leyó su uso de memoria.
Registro de uso
#
Tarea
Modelo
Resultado
Tiempo
Estado
Figuras
1
Abrir la app de 24 MB, actualizar, primer inicio
Unsloth 2026.8.18 -> 2026.10.3 (supuesto)
Se abrió tras el registro de instalación; instalación existente
Error propioProbó una actualización de una instalación existente ('same as before'), no una instalación de primer uso.
Error propioHizo las primeras pruebas de memoria con Chrome, la app de Claude, Word, WhatsApp y otras apps abiertas en un Mac de 24 GB. El primer rechazo mostraba 7 GB libres.
Error propioUsó 'VRAM' para referirse a la memoria en todo momento, aunque la app dice '0 GiB VRAM + 24 GiB shared'.
Error propioEscribió que hay 'no token counter'; las capturas muestran un medidor de contexto y los tokens por segundo.
Error propioEscribió que un modelo de chat local 'does not research the internet'; las capturas muestran una función Search y llamadas a herramientas de búsqueda web.
Error propioLeyó las cifras del selector de modelos como tamaños; son números de parámetros.
Error propioAnotó que solo había siete gigabytes disponibles sin decir qué más estaba abierto; el cuadro dice que en ese momento había 7 GB libres.
Error propioDejó lagunas en el registro: la versión de la app de escritorio, la versión de macOS, el chip, la hora de fin, qué modelo se usó para el prompt de Nueva York y qué pasó con él, qué modelos de Ollama fallaron, si terminó la descarga de 20 GB, los ajustes de las ejecuciones de imagen y la desinstalación.
Error propioEscribió la app como 'Onslaught' y 'Unslothh' en las notas (transcripción de voz).
SuposiciónLas notas sitúan el cuadro de Z-Image junto al comentario de 'only seven gigabytes'; la cifra de 7 GB está en los mensajes de flux.2-klein. Las capturas se asociaron al texto por lo que muestran, no solo por su orden.
Registro de hallazgos
ID
Hallazgo
Categoría
Etiqueta
Gravedad
Figuras
UN-01
El DMG pesa 24 MB, mucho menos que las otras apps que ha visto el evaluador.
El primer inicio ejecuta una instalación de dependencias de 13 pasos de unos cuatro a cinco minutos, sin estimación de tiempo ni de disco. El registro detallado es visible.
El selector de modelos muestra números de parámetros (27.3B, 271.0M), no el tamaño de descarga ni de memoria; algunas entradas están en gris sin explicación en la captura.
No se generó ninguna imagen en el Mac de 24 GB; las notas también calificaron de 'too big' los modelos de imagen más pequeños de la lista (7,8 GB, 16 GB).
El evaluador juzga la interfaz preciosa y fluida, pero no llegó a un resultado y no ve motivo para usar la app ahora.
Valoración general
Opinión
Media
-
UN-26
El directorio indica la licencia como Apache-2.0; la página de GitHub dice que la interfaz de Studio es AGPL-3.0 y el núcleo Apache-2.0.
Mantenimiento
De terceros
Media
-
La gravedad es el impacto en un usuario nuevo. Es una propuesta, no una medición.
Para quién es
Encaje probable
SuposiciónUsuarios con más de 24 GB de memoria, o con un equipo limpio y pocas apps abiertas, que quieran chat, un hub de modelos y modelos locales de LM Studio y Ollama en una sola app.
Del proveedorPersonas que quieran entrenar o ajustar (fine-tuning) modelos, que es el propósito principal del proyecto según el proveedor (no probado aquí).
Encaje poco probable
OpiniónQuien quiera generar imágenes en local en un Mac de 24 GB con otras apps abiertas. No funcionó para el evaluador.
OpiniónQuien quiera un resultado rápido sin aprender sobre modelos, memoria y entrenamiento.
Nueva prueba. El evaluador piensa volver a mirarlo en tres a seis meses (aproximadamente de enero a abril de 2027). Antes, registrar la versión de la app de escritorio, la versión de macOS y el chip; partir de una instalación limpia; cerrar las demás apps y anotar la memoria libre; probar un modelo de imagen que quepa (por ejemplo, el GGUF de 7,8 GB) y registrar cada ajuste y resultado; probar el entrenamiento, el uso sin conexión y la desinstalación.
La peor forma de tratar a un cliente es hacer el trabajo y no mantenerlo informado.
Notas del evaluador, editadas ligeramente a partir de la transcripción de voz.
Preguntas frecuentes
¿Puede Unsloth generar imágenes en un Mac de 24 GB?
No en esta prueba. La carga del modelo de imagen flux.2-klein fue rechazada dos veces: al principio unos 17 GB necesarios y unos 2 GB utilizables (7 GB libres), y tras reiniciar unos 6 GB utilizables (11 GB libres). No se generó ninguna imagen. Medido
¿Unsloth encuentra los modelos que ya tengo en LM Studio u Ollama?
Sí, en esta prueba. El primer chat cargó un modelo Qwen3.8-27B de 4 bits desde la carpeta de modelos de LM Studio sin descarga, y la lista On Device mostró modelos de Ollama como gemma4:latest y qwen3-coder:30b. Algunos modelos de Ollama no funcionaron; no se registró cuáles. Observado
¿Qué tan rápido es el chat de Unsloth en un Mac de 24 GB?
Un modelo de 27B en 4 bits respondió a 'what is 5 times 866' (4.330, correcto) en 10 segundos a 11,0 tokens por segundo. La lectura de una página web y una búsqueda de eventos con el mismo modelo terminaron en 'Ran out of memory', con otras apps abiertas. Medido
¿Cuánto pesa el instalador de Unsloth y cuánto tarda la instalación?
El DMG pesa 24 MB. El primer inicio ejecutó una actualización de dependencias de 13 pasos que el evaluador estima en cuatro o cinco minutos; la ventana no muestra estimación de tiempo ni de disco. La prueba partió de una instalación existente, no de una limpia. Observado
¿Se puede usar Unsloth totalmente sin conexión?
La documentación del proveedor dice que puede usarse al 100 % sin conexión y en local. No se probó el uso sin conexión; la búsqueda web y las descargas de modelos usaron internet. Del proveedor
Contexto sobre el desarrollador
Fuera de la sesión práctica. Lo siguiente procede de la página de GitHub del proveedor, su documentación, su página de versiones y el directorio de PromptQuorum. Se consultó el 16 de octubre de 2026 con una herramienta de obtención web que resume páginas y no se verificó de forma independiente.
Del proveedorLa página de GitHub describe Unsloth como la 'first desktop app to run and train models' y 'Local UI to run and train LLMs and diffusion models'. Ofrece Unsloth Studio (interfaz web) y Unsloth Core (código). Las páginas consultadas no nombraban a ninguna empresa ni persona.
Del proveedorLicencia: el paquete principal es Apache 2.0; 'certain optional components, such as the Unsloth Studio UI' son AGPL-3.0.
Del proveedorPlataformas: Windows, Linux, WSL y macOS. Opciones de instalación: app de escritorio (un .dmg para macOS), un script de shell, Homebrew y Docker. No se indicaron requisitos de hardware en el texto obtenido.
Del proveedorDocumentación de Studio: ejecuta en local modelos GGUF, MLX y de difusión de imagen y vídeo; 'Training, MLX and GGUF inference all work inside of Unsloth' en macOS; la búsqueda web 'visits pages directly'; 'can be used 100% offline'.
De tercerosEl directorio de PromptQuorum lista Unsloth como gratuito, Apache-2.0, para Mac, Windows y Linux, en la categoría de fine-tuning y LoRA, con unas 76.100 estrellas en GitHub (datos verificados el 13 de septiembre de 2026). Registra un DMG para macOS en la versión v0.1.905-beta (comprobado el 9 de octubre de 2026) y una última actualización upstream el 16 de octubre de 2026. PromptQuorum no lo había probado en la práctica antes de este informe.
SuposiciónLa página de versiones consultada el 16 de octubre de 2026 devolvió v0.1.806-beta (2 de septiembre) como la más reciente, lo que difiere de la v0.1.905-beta del directorio; la herramienta de resumen pudo haber leído una página desactualizada. La versión del paquete de Python en el registro de instalación (2026.10.3) sigue otra numeración distinta de las etiquetas de la app de escritorio.