PromptQuorum Praxistest · Unsloth · 9. Oktober 2026
Unsloth auf einem 24-GB-Mac: Eine ausgereifte App, aber Speicher voll, bevor das erste Bild entstand
Praxistest auf einem 24-GB-Mac, gedacht für die Bilderzeugung. Der Chat funktionierte; Bildmodelle wurden wegen fehlenden Speichers abgelehnt, und es entstand kein Bild.
Abbildung 1Ablehnung beim Laden des Bildmodells flux.2-klein. Die App meldet etwa 17 GB Bedarf, etwa 2 GB nutzbar (7 GB derzeit frei, abzüglich Platz für das Betriebssystem). Sie nennt eine Umgehungsvariable, UNSLOTH_DIFFUSION_ALLOW_OVERSIZED_LOAD=1, die nicht ausprobiert wurde.
Fazit
Gesamteinschätzung
Die App wirkt ausgereift: ein 24-MB-Installer, ein Setup-Fenster, das zeigt, was es tut, ein Model Hub mit Hardware-Anzeige, Größenwarnungen und Download-Timer sowie ein Chat, der Modelle von LM Studio und Ollama auf der Festplatte selbst findet. Eine Rechenaufgabe lief mit einem 27B-Modell mit 11,0 Tokens pro Sekunde. Das Ziel des Tests, ein Bild, wurde nicht erreicht. Bildmodelle wurden abgelehnt, weil die App nur 2 GB (vor einem Neustart) und 6 GB (danach) als nutzbar zählte, bei etwa 17 GB Bedarf; eine Websuche und eine Veranstaltungssuche endeten mit 'Ran out of memory', und ein Modellstart zeigte minutenlang keinen Fortschritt. Der Tester führte die ersten Tests mit vielen anderen geöffneten Apps durch und erfasste Modelle und Einstellungen einiger Durchläufe nicht.
Eignung für den Einsatz des Testers
Vorerst nicht für diesen Tester auf diesem Rechner. In seinen Worten: 'Everything works, except that the end result is I didn't get it to work.' Chat und Modellverwaltung funktionieren mit 24 GB; die Bilderzeugung funktionierte in diesem Test nicht. Training wurde nicht ausprobiert. Der Tester will in drei bis sechs Monaten noch einmal nachsehen.
BeobachtetDer Chat funktioniert: Ein 27B-Modell mit 4 Bit aus dem LM-Studio-Ordner beantwortete eine Rechenaufgabe mit 11,0 Tokens pro Sekunde. Modelle von Ollama und LM Studio erscheinen in der App.
GemessenBildmodelle wurden abgelehnt: flux.2-klein braucht etwa 17 GB; die App zählte etwa 2 GB als nutzbar (7 GB frei) und nach einem Neustart etwa 6 GB (11 GB frei). Es entstand kein Bild.
Tester-MeinungEine schöne Oberfläche, auf der alles funktioniert, doch das Endergebnis wurde auf einem 24-GB-Mac nicht erreicht.
Bewertungsübersicht Status: Teilweise
Installation4/524-MB-DMG; Setup-Fenster mit Detailprotokoll. Keine Zeit- oder Speicherplatzangabe; vier bis fünf Minuten (Tester-Schätzung). Der Test begann von einer bestehenden Installation aus.
Onboarding und Modellauswahl3/5Auswahl, Hub, Hardware-Anzeige, Größenwarnungen und Download-Timer sind stark. Die Auswahl zeigt Parameterzahlen statt Gigabyte; die Meldungen '7 GB' und '17 GB' verwirrten den Tester.
Kernfunktion2/5Der Chat beantwortete eine Rechenaufgabe. Das Lesen einer Webseite und eine Veranstaltungssuche endeten mit Speicherfehlern; es entstand kein Bild.
Anleitung und Iteration3/5Die Ablehnungsmeldung erklärt die Ursache und nennt eine Umgehung. Kein Fortschritt, während ein Modell startet; keine Erklärung, warum 7 GB 'frei' waren.
Leistung2/511,0 tok/s bei einem 27B-Modell mit 4 Bit; Speicher voll bei 34,4k Kontext auf einem 24-GB-Mac mit anderen geöffneten Apps.
Dokumentationk. A.Nicht getestet.
Vertrauen und Datenschutzk. A.Nicht geprüft. Der Anbieter wirbt mit 100 Prozent Offline-Nutzung; Websuche und Downloads brauchen das Internet. Der Offline-Betrieb wurde nicht getestet.
Deinstallationk. A.Nicht getestet.
Die Bewertungen sind Vorschläge, abgeleitet aus den untenstehenden Belegen (1 = schlecht, 5 = sehr gut). Die Bestätigung liegt beim Tester. Die Bilderzeugung, das Ziel des Testers, wird niedrig bewertet, weil auf diesem Rechner kein Bild entstand.
Testdetails
App
Unsloth, die Desktop-App (Unsloth Studio). Die Notizen schreiben es 'Unsloth', 'Unslothh' und 'Onslaught'; dieser Bericht verwendet 'Unsloth'. Beobachtet
Version
Setup-Protokoll: 'unsloth 2026.8.18 -> 2026.10.3 available, updating'. Die nach dem Update verwendete Version ist vermutlich 2026.10.3. Das Fenster trägt die Kennzeichnung BETA. Die Version der Desktop-App selbst wurde nicht erfasst. Annahme
Tester
Hans Kuepper, Gründer von PromptQuorum
Beginn
9. Oktober 2026, 13 Uhr (laut Notizen). Ein Screenshot zeigt 17:13 Uhr, der Test dauerte also mindestens vier Stunden. Beobachtet
Ende
Nicht erfasst
Hardware
Mac mit 24 GB. Die Notizen sagen 'macOS M3 24 GB' und später 'M3 24 GB Pro MacBook'. Der Model Hub der App zeigt '24 GiB RAM', '0 GiB VRAM + 24 GiB shared' und '12/12 CPU'. Der genaue Chip wurde nicht erfasst. Beobachtet
System
macOS; Version nicht erfasst
Installationsstand
Keine saubere Installation. Das Setup-Protokoll meldet 'Updating existing Unsloth install' und 'existing install detected'; der Tester sagt 'same as before'. Frühere Nutzung könnte erklären, warum Modelle aus LM Studio und Ollama schon bekannt waren. Beobachtet
Download
DMG mit 24 MB (vom Tester abgelesen). Beim ersten Start lief ein Schritt für Abhängigkeiten (siehe Kapitel 1). Beobachtet
Testgrund
Um zu sehen, wie Unsloth funktioniert, 'especially the picture functions'. Modelloptimierung (Training) wollte der Tester nicht nutzen.
Ziel
Bilder lokal auf dem 24-GB-Mac erzeugen. Chat und Model Hub wurden nebenbei ausprobiert. Beobachtet
KI-Hilfe genutzt
In den Notizen steht ein New-York-Skyline-Prompt mit mehreren hundert Wörtern; seine Markdown-Fettdruckmarken deuten darauf hin, dass er KI-geschrieben wurde. Nicht bestätigt. Auf die Antworten des Chat-Modells (etwa dazu, woher es das Modell hat) stützt sich dieser Bericht nicht. Annahme
Jede Aussage trägt eine Kennzeichnung:BeobachtetGemessenTester-SchätzungHerstellerangabeDrittquelleAnnahmeTester-MeinungTester-FehlerWas die Kennzeichnungen bedeuten
Offenlegung. Der Tester hat PromptQuorum (promptquorum.com) gegründet, eine Inhaltsseite und ein Verzeichnis über lokale KI-Apps. Unsloth ist in diesem Verzeichnis gelistet und hat auf der Seite eine bestehende, separat verfasste Rezensionsseite. Die Notizen halten keinen Kontakt zum Anbieter, keine Zahlung und kein Sponsoring fest.
Alles funktioniert, nur dass am Ende herauskommt: Ich habe es nicht zum Laufen gebracht.
Notizen des Testers, leicht redigiert aus einer Sprachtranskription.
Wie der Test verlief
Download, Einrichtung und erster Start
Beobachtet
Der Installer ist ein DMG mit 24 MB, vom Tester gelesen als 'the smallest file I've ever seen'.
Beobachtet
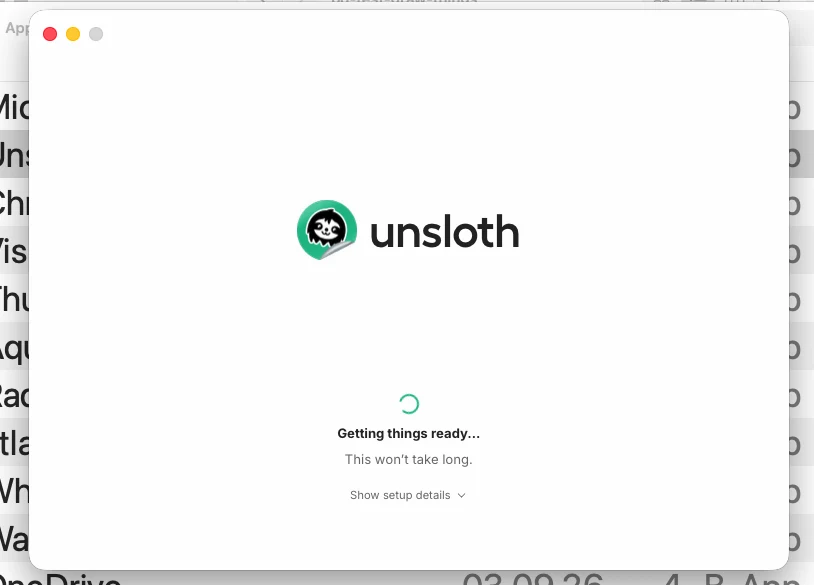
Erstes Fenster: 'Getting things ready... This won't take long.' mit einem Link 'Show setup details'. Der Tester: 'Already feels much more polished than the other apps... a clear communication.'
Abbildung 2Erstes Fenster nach dem Öffnen der App aus dem 24-MB-DMG. Der Text verspricht, es dauere nicht lange; der Tester maß nichts und schätzt vier bis fünf Minuten (das Update-Protokoll steht im Text). Es wird keine Zeit- oder Speicherplatzangabe gezeigt.
Beobachtet
Das Detailprotokoll lautet: 'Updating existing Unsloth install', 'frontend bundled (Tauri)', 'node v24.13.0 | npm 11.6.2 (system)', 'unsloth 2026.8.18 -> 2026.10.3 available, updating', danach eine Abhängigkeitsleiste mit 13 Schritten (pip bootstrap, MLX-Stack für Apple Silicon, Basispakete, Unsloth-Extras, Codecs, Overrides, Studio-Abhängigkeiten, Data Designer, lokales Plugin, Diffusers-Pin, Abschluss). Hinweise: 'torch 2.10.0 detected -- installing torchao==0.16.0'; 'transformers 5.3.0, 5.5.0, 5.10.2 pre-installed'; 'gpu Apple Silicon (Metal, unified memory)'; 'installing prebuilt llama.cpp'.
Beobachtet
Der Tester sagt, es sei etwa vier oder fünf Minuten gelaufen, dann habe sich die App geöffnet. Das Protokoll zeigt keine Zeitschätzung und keine Angabe zum Speicherplatz.
Tester-Schätzung
Vier bis fünf Minuten für die Einrichtung. Nicht gestoppt.
Annahme
Das kleine DMG lädt vermutlich den Großteil der Software in diesem ersten Schritt nach. Nicht geprüft.
Tester-Meinung
'It gives me the details about what it does -- great -- but it doesn't tell me anything about estimated time, volumes, how much disk space it takes up.'
Beobachtet
Das Hauptfenster öffnet sich mit 'How can I help?' und einer Seitenleiste: New chat, Model hub, Library, Images, Train, More. Das Logo trägt die Kennzeichnung BETA.
Abbildung 3Hauptfenster nach dem Setup. Seitenleiste: New chat, Model hub, Library, Images, Train, More. Das Logo trägt die Kennzeichnung BETA. Ein Browser-Tab hinter dem Fenster zeigt eine GitHub-Seite des Projekts.
Tester-Fehler
Der Test begann von einer bestehenden Installation aus ('same as before'), ist also ein Update und kein Erststart-Test. Schlüsse zum Onboarding brauchen eine saubere Installation zur Bestätigung.
Modellauswahl und der erste Chat
Beobachtet
Die Modellauswahl listet Recommended models mit Zahlen wie 27.3B und 271.0M. Das sind Parameterzahlen, keine Gigabyte. Zwei Einträge sind ausgegraut (176.9B und 320.8B).
Abbildung 4Modellauswahl, Tab Recommended. Die Zahlen sind Parameterzahlen (B = Milliarden, M = Millionen), keine Gigabyte. Zwei Einträge sind ausgegraut (Qwen3.8-Flash-Next-GGUF 176.9B, GLM-5.3-Flash-GGUF 320.8B). Was das Grau und der gelbe Punkt bedeuten, sagt die erfasste App-Ansicht nicht.
Annahme
Ausgegraute Einträge sind vermutlich zu groß für diesen Rechner. Die erfasste App-Ansicht sagt das nicht.
Tester-Meinung
'There were lots of models listed with the size. Very good.' Die gezeigten Zahlen sind Parameterzahlen; sie sagen dem Leser also nicht, wie viel Speicher ein Modell braucht.
Beobachtet
Statt ein Modell zu wählen, tippte der Tester eine Rechenaufgabe ein. Die App begann von selbst, Modelle zu laden. Laut Notizen startete ein Qwen3.8-27B-MLX-Modell mit 4 Bit in unter einer Minute; ein zweiter Hinweis zeigte das Laden von Mistral-7B-Instruct-v0.3-4bit (Screenshot nicht verwendet, gleiche Art wie Abbildung 5).
Beobachtet
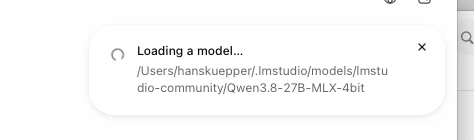
Der Lade-Hinweis zeigt den Pfad /Users/hanskuepper/.lmstudio/models/lmstudio-community/Qwen3.8-27B-MLX-4bit. Das Modell wurde aus dem Ordner von LM Studio auf der Festplatte gelesen.
Abbildung 5Hinweis beim Start des ersten Chats. Der Pfad zeigt in den Modellordner von LM Studio: /Users/hanskuepper/.lmstudio/models/lmstudio-community/Qwen3.8-27B-MLX-4bit. Das Modell wurde von der Festplatte geladen, nicht heruntergeladen.
Tester-Meinung
Er vermutete, es komme von der Festplatte, weil 'that's a big model that doesn't go over the internet in one minute'. Der Pfad stützt das. Warum Unsloth dieses Modell und das Mistral-Modell gewählt hat, wurde nicht erfasst.
Beobachtet
Die Frage 'what is 5 times 866' wurde nach 'Worked for 10s' mit '5 x 866 = 4,330' beantwortet (richtig), bei 11,0 tok/s. Die Kopfzeile zeigt 'Local' und eine Kontextanzeige '120 / 262.1k'.
Abbildung 6Erster Chat. Die Antwort 4,330 ist richtig (5 x 866). Der Bildschirm zeigt 'Worked for 10s', 11.0 tok/s und eine Kontextanzeige '120 / 262.1k'.
Beobachtet
Danach fragte der Tester das Modell, woher es das Modell habe. Der erfasste Teil der Antwort handelt von MLX-Gewichten und dem Unified Memory von Apple Silicon; die vollständige Antwort wurde nicht erfasst. Laut Notizen lautete die Antwort, die App durchsuche die Festplatte nicht.
Annahme
Die Selbstauskunft des Chat-Modells über die App ist kein verlässlicher Beleg. Eine Antwort nennt das Modell 'Qwen 3 27B MLX 4-bit', während die App es Qwen3.8-27B-MLX-4bit nennt.
Modelle, die schon auf der Festplatte liegen: LM Studio und Ollama
Beobachtet
Der Tab On Device listet Modelle nach Quelle. Unter CUSTOM FOLDERS erscheinen zwei Pfade (.lmstudio/models und .ollama/models) mit den Ollama-Modellen gemma4:latest, gemma3:1b und qwen3-coder:30b. Unter LM STUDIO ist das Modell Qwen3.8-27B als 'Loaded' markiert.
Abbildung 7Tab On Device. Unter CUSTOM FOLDERS stehen zwei Pfade (.lmstudio/models und .ollama/models) mit den Ollama-Modellen gemma4:latest, gemma3:1b und qwen3-coder:30b; unter LM STUDIO ist das Modell Qwen3.8-27B als 'Loaded' markiert. Eine teilweise sichtbare Chat-Antwort hinter der Liste handelt von MLX-Gewichten. Ob der Tester die Ordner hinzugefügt hat oder sie automatisch gefunden wurden, wurde nicht erfasst.
Annahme
Entweder hat der Tester die beiden Ordner hinzugefügt oder die App hat sie selbst gefunden. Nicht erfasst. Frühere Nutzung der App könnte sie eingerichtet haben.
Beobachtet
Der Wechsel zu qwen3-coder:30b (30.5B, Q4_K_M, GGUF) zeigt 'Starting model... Switching models. Loading cached model into memory.' mit einem Cancel-Button. Die Kontextanzeige steht auf '1.3k / 8.2k', viel kleiner als die 262.1k des ersten Modells.
Abbildung 8Wechsel zum Ollama-Modell qwen3-coder:30b (30.5B, Q4_K_M, GGUF). Kontextanzeige '1.3k / 8.2k'. Der Hinweis lautet 'Starting model... Switching models. Loading cached model into memory.' mit einem Cancel-Button.
Tester-Meinung
'I like how easy to change models.' 'Some Ollama models do not work inside Unsloth, but great that it tried at least.'
Beobachtet
Laut Notizen funktionierte ein älteres Modell, und ein neueres stürzte ab. Welche Modelle gemeint waren, wurde nicht erfasst.
Tester-Meinung
Er findet es 'great that it tried', seine Ollama-Modelle zu nutzen, und dass das Lesen bereits vorhandener Modelle einen weiteren großen Download erspart.
Model Hub und Downloads
Beobachtet
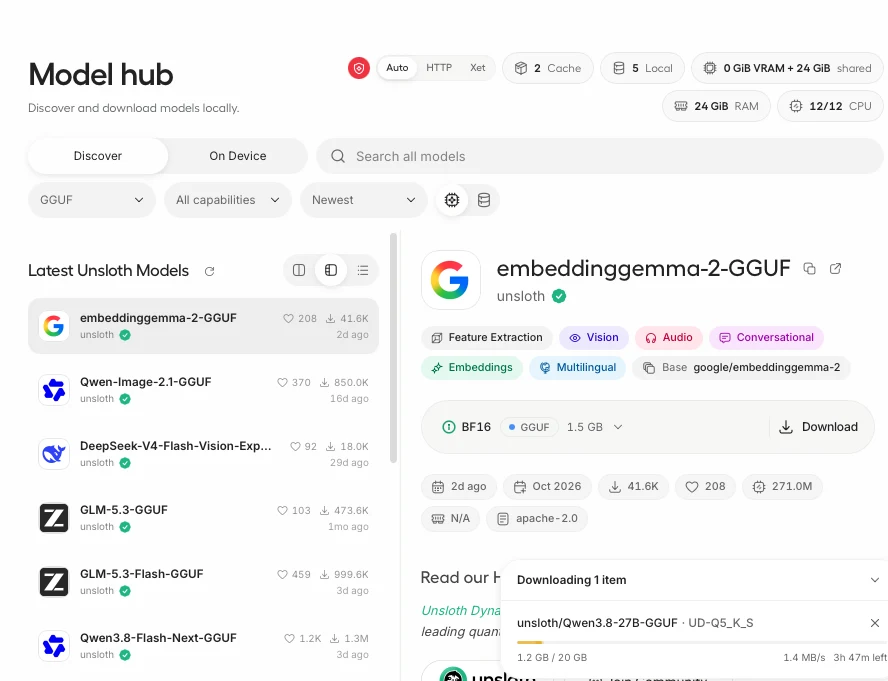
Der Hub zeigt das Gerät: '0 GiB VRAM + 24 GiB shared', '24 GiB RAM', '12/12 CPU', dazu Filter (Format, Fähigkeiten, Neueste). Karten zeigen Likes, Downloads, Alter und Lizenz (embeddinggemma-2-GGUF: apache-2.0, 1,5 GB).
Abbildung 9Model Hub. Oben rechts: '0 GiB VRAM + 24 GiB shared', '24 GiB RAM', '12/12 CPU'. Download-Fenster: unsloth/Qwen3.8-27B-GGUF UD-Q5_K_S, 1,2 GB von 20 GB, 1,4 MB/s, noch 3 h 47 min. Die geöffnete Modellkarte, embeddinggemma-2-GGUF (1,5 GB, apache-2.0), ist nicht das Modell, das gerade heruntergeladen wird.
Tester-Meinung
'Yes, great model hub.' Der Hub listet unter anderem Qwen-Image-2.1-GGUF (850.0K Downloads, 16 Tage alt), GLM-5.3-GGUF und Qwen3.8-Flash-Next-GGUF.
Beobachtet
Laut Notizen gab das Anklicken einer für den Mac zu großen Datei mehrere Warnungen ('this file is 30 to 40 gigabytes total'); der Download bleibt erlaubt. Kein Screenshot.
Gemessen
Das Download-Fenster für unsloth/Qwen3.8-27B-GGUF UD-Q5_K_S zeigt 1,2 GB von 20 GB bei 1,4 MB/s, noch 3 h 47 min; später 7,1 GB von 20 GB bei 983 KB/s, noch 3 h 31 min.
Abbildung 10Derselbe Download später: 7,1 GB von 20 GB bei 983 KB/s, noch 3 h 31 min. Die Zeit zwischen diesem und dem vorigen Screenshot wurde nicht erfasst.
Tester-Meinung
'The professionalism of this app is visible. It has a timer attached. It tells you the download speed.'
Annahme
Die Geschwindigkeiten deuten auf eine langsame Verbindung am Testort hin; der Tester sagt das nicht. Ob der Download abgeschlossen wurde, wurde nicht erfasst.
Gemessen
Der Dialog für Z-Image (BF16) listet Modelldateien mit 12,3 GB plus nötigem Encoder und Decoder mit 8,2 GB, zusammen 20,5 GB. Das erklärt die 'difference between the gigabytes that the model has and then something else', die der Tester an anderer Stelle erwähnt.
Abbildung 19Download-Dialog für Z-Image (BF16): Modelldateien 12,3 GB, 'Include required files' 8,2 GB (Encoder und Decoder, von kompatiblen Varianten gemeinsam genutzt), gesamt 20,5 GB. 'Downloading will not load this model or switch your current model.'
Tester-Meinung
Die Notizen sagen 'the picture LLM was downloaded'. Welches, wurde nicht erfasst; die Screenshots zeigen die Bildmodelle FLUX.2-klein-4B und seine GGUF-Variante auf dem Gerät (Abbildung 18).
Websuche, Sprache und die Abstürze
Beobachtet
Der Tester fügte die URL einer PromptQuorum-Seite ein und fragte 'from a seo perspective will this help me?'. Der Chat zeigt 'Using tool: Reading promptquorum.com' und 'Waiting for approval: web_search' mit den Buttons Allow, Always allow und Deny. Zeitstempel 17:13 Uhr; Kontext '648 / 34.4k'.
Abbildung 11Chat mit Qwen3.8-27B-MLX-4bit, Kontext '648 / 34.4k', Zeitstempel 17:13 Uhr. Der Prompt nennt eine PromptQuorum-URL und fragt nach SEO. Die App zeigt 'Waiting for approval: web_search' und die Buttons Allow, Always allow, Deny. Der Modus ist 'Approve for me'.
Beobachtet
Laut Notizen sagte der erste Versuch, die Seite sei nicht lesbar; nach einem Klick auf die Search-Funktion klappte es beim zweiten Mal. 'Maybe the first time should have had a warning.'
Annahme
Der erste Fehlschlag könnte an der fehlenden Freigabe der Websuche oder an ausgeschaltetem Search-Schalter gelegen haben. Nicht überprüft.
Beobachtet
Der Lauf endete nach 168,10 s mit 'Ran out of memory. Try a smaller model or shorter input.' und einem Retry-Button.
Abbildung 12Derselbe Chat endet nach 168,10 s mit 'Ran out of memory. Try a smaller model or shorter input.'
Beobachtet
Spracheingabe ist eingebaut. Ihre Nutzung verlangt den Download des Sprachmodells 'Qwen3-ASR 0.6B' mit etwa 1,0 GB, das laut App einmalig in den Hugging-Face-Cache geladen wird. Ob der Tester es herunterlud, wurde nicht erfasst.
Abbildung 13Spracheingabe: 'Local dictation runs entirely offline, but it needs the Qwen3-ASR 0.6B speech model first. About 1.0 GB, fetched once into your Hugging Face cache.' Ob der Tester es herunterlud, wurde nicht erfasst.
Beobachtet
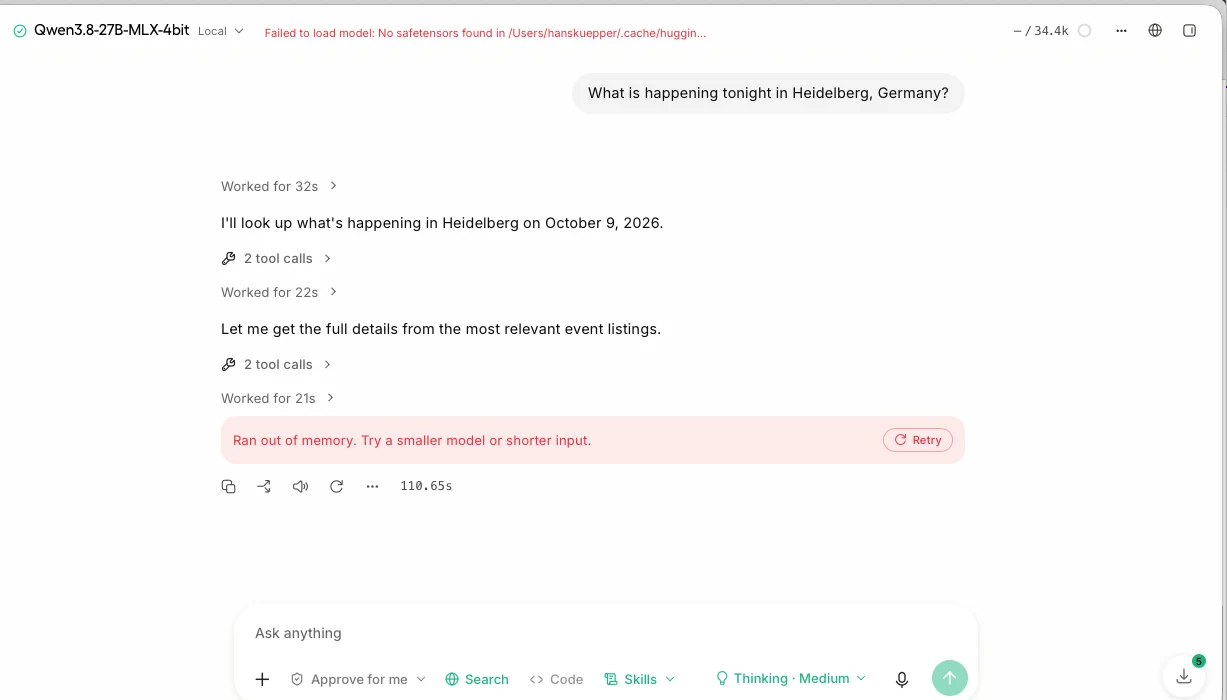
Eine lokale Veranstaltungssuche ('What is happening tonight in Heidelberg, Germany?') lief durch zwei Runden mit Tool-Aufrufen und endete nach 110,65 s mit 'Ran out of memory'. Die Kopfzeile zeigt einen roten Hinweis: 'Failed to load model: No safetensors found in /Users/.../.cache/huggin...'.
Abbildung 14Lokale Veranstaltungssuche. Kopfzeile (rot): 'Failed to load model: No safetensors found in /Users/.../.cache/huggin...'. Im Chat zwei Runden 'tool calls', dann 'Ran out of memory. Try a smaller model or shorter input.' nach 110,65 s. Kontext '- / 34.4k'. Das Download-Symbol zeigt 5.
Annahme
Der Ladefehler und die Speichermeldung könnten zusammenhängen (ein Modell wurde getauscht, während der Speicher knapp wurde). Der Screenshot zeigt keinen Zusammenhang.
Tester-Meinung
'But yes, local AI, always some issues.'
Bildmodelle: wegen Speicher abgelehnt
Beobachtet
Das Ziel des Testers waren Bilder. Die Seitenleiste hat den Eintrag 'Images'. Die Notizen zeigen einen langen New-York-Skyline-Prompt (Blick auf Brooklyn, Brooklyn Bridge, goldene Stunde, 8K-Detail) mit Listen zu Komposition und zu Vermeidendem. Zu ihm sind weder Ergebnis noch Fehler oder Einstellungen erfasst.
Gemessen
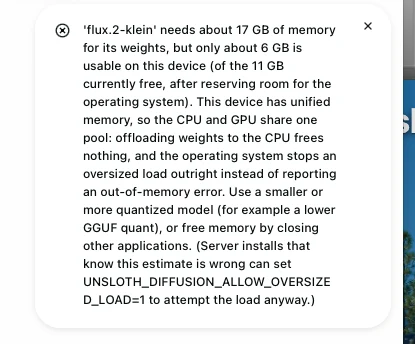
Das Laden des Bildmodells flux.2-klein wurde abgelehnt: 'needs about 17 GB of memory for its weights, but only about 2 GB is usable on this device (of the 7 GB currently free, after reserving room for the operating system)'. Die Meldung ergänzt, der Mac habe nur einen Speicherpool, Auslagern auf die CPU gebe nichts frei, und schlägt ein kleineres Modell, eine niedrigere Quantisierung oder das Schließen anderer Apps vor. Als Umgehung nennt sie UNSLOTH_DIFFUSION_ALLOW_OVERSIZED_LOAD=1.
Abbildung 1Ablehnung beim Laden des Bildmodells flux.2-klein. Die App meldet etwa 17 GB Bedarf, etwa 2 GB nutzbar (7 GB derzeit frei, abzüglich Platz für das Betriebssystem). Sie nennt eine Umgehungsvariable, UNSLOTH_DIFFUSION_ALLOW_OVERSIZED_LOAD=1, die nicht ausprobiert wurde.
Gemessen
Nach einem sauberen Neustart lautet die Meldung: etwa 17 GB nötig, etwa 6 GB nutzbar, von derzeit 11 GB frei.
Abbildung 15Zweite Ablehnung von flux.2-klein: etwa 17 GB nötig, etwa 6 GB nutzbar (11 GB derzeit frei). Hier gelesen als nach dem sauberen Neustart aufgenommen, gemäß der Reihenfolge in den Notizen.
Annahme
Die beiden Meldungen unterscheiden sich in beiden Paaren um 5 GB (7 - 2 und 11 - 6); die App scheint also etwa 5 GB für das Betriebssystem zurückzuhalten. Nur zwei Datenpunkte.
Beobachtet
Die Geräteliste zeigt FLUX.2-klein-4B-GGUF (7,8 GB), FLUX.2-klein-4B (16 GB) und mistral-7b-v0.3-bnb-4bit (4,1 GB). Der Tester: 'This should be small enough.' Er sagt, das kleinste Bildmodell im Hub bringe seinen 24-GB-Rechner zum Absturz, und die angeklickten Modelle hätten alle gemeldet, sie seien zu groß, weil nur 'seven gigabytes' verfügbar seien.
Abbildung 18Modelle auf dem Gerät unter UNSLOTH: FLUX.2-klein-4B-GGUF (BF16, Bildsymbol, 4B, 7,8 GB), FLUX.2-klein-4B (Bildsymbol, 4B, 16 GB), mistral-7b-v0.3-bnb-4bit (7B, 4,1 GB).
Tester-Fehler
Der Tester fragt sich, warum nur sieben Gigabyte verfügbar sind ('I have much more'). Der Dialog nennt 7 GB als in diesem Moment frei und dass die anderen Apps liefen; nach dem Neustart nennt er 11 GB. Die Notizen stellen die Bemerkung '7 GB' neben den Z-Image-Dialog; die Zahl 7 GB steht in der Meldung zu flux.2-klein.
Tester-Meinung
'I'm lost... I have a 24-gigabyte machine and I cannot find an LLM that can serve me and can do the job.' Er meint, 24 GB seien mehr, als über 80 Prozent seiner Leser haben (seine Schätzung, kein gemessener Wert).
Tester-Schätzung
'More than 80% of my readers' haben 24 GB oder weniger. Quelle nicht genannt.
Speicher auf dem Mac
Beobachtet
Der Tester folgert, dass lokale Modelle und die tägliche Arbeit um denselben Speicher konkurrieren und dass Chrome und andere Apps 5 bis 8 GB belegen. Er schrieb durchgehend 'VRAM'; Apple Silicon hat einen einzigen Speicherpool, wie der Hub sagt ('0 GiB VRAM + 24 GiB shared').
Abbildung 16Speicherbereich mit langem, flachem Verlauf. Speicher belegt 12,92 GB, zwischengespeicherte Dateien 10,95 GB, App-Speicher 9,81 GB, reserviert 1,83 GB, Swap genutzt 0 Byte. Der Zeitpunkt der Aufnahme und die geöffneten Apps wurden nicht erfasst.
Gemessen
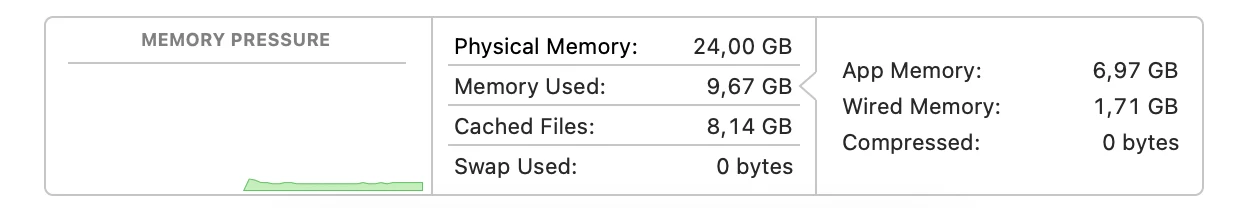
Aktivitätsanzeige, eine andere Aufnahme: Speicher belegt 9,67 GB, zwischengespeicherte Dateien 8,14 GB, App-Speicher 6,97 GB, reserviert 1,71 GB, Swap 0. Der kurze Verlaufsgraph passt zu einem frischen Start.
Abbildung 17Speicherbereich mit kurzem Verlauf, der spät im Graphen beginnt. Speicher belegt 9,67 GB, zwischengespeicherte Dateien 8,14 GB, App-Speicher 6,97 GB, reserviert 1,71 GB, Swap 0. Passt zur Bemerkung '10 GB at startup' in den Notizen; welchen Moment er zeigt, wurde nicht erfasst.
Annahme
Die 11 GB 'currently free' in Abbildung 15 passen zu 24,00 - 12,92 = 11,08 GB aus Abbildung 16. Ob beide zur selben Zeit aufgenommen wurden, wurde nicht erfasst.
Tester-Meinung
'Even after reboot, already nine gigabytes gone for general things.' 'Either I shut the computer down, reboot, stop all the processes... or I cannot run the LLM.'
Tester-Meinung
Zwei mögliche Antworten: Modelle müssen kleiner und besser werden, oder Computer brauchen 48 oder 64 GB. 'All of this talk about this works on your computer is a little bit fake.'
Annahme
Dass 48 oder 64 GB das 'confidently' lösen würden, ist ungetestet.
Laden ohne Rückmeldung und der Schlussblick
Beobachtet
Beim Start eines Modells erscheint ein Hinweis 'Starting model... Loading cached model into memory.' mit Spinner und Cancel. Keine Prozentzahl, Größe oder Zeit.
Abbildung 20Modellstart. Der Hinweis zeigt einen Spinner und 'Loading cached model into memory.' Keine Prozentzahl, keine Größe, keine Zeit. Der Tester sagt, es habe länger als zwei oder drei Minuten gedauert (Schätzung).
Tester-Schätzung
Die Wartezeit lag über zwei oder drei Minuten (nicht gestoppt).
Tester-Meinung
'The worst way you can treat a client is to do the work and not update the client.' Der Tester nennt dies ein Problem der Benutzeroberfläche.
Beobachtet
Anzeigen in der Kopfzeile zeigen die verbrauchten Tokens im Verhältnis zum Kontext (zum Beispiel '648 / 34.4k') und die Tokens pro Sekunde (11.0 tok/s).
Tester-Fehler
Die Notizen sagen 'no token counter'. Die Screenshots zeigen eine Kontextanzeige und einen Wert für Tokens pro Sekunde. Gemeint war vielleicht eine Token-Zahl pro Nachricht (Annahme).
Tester-Fehler
Die Notizen nennen ein lokales Chat-Modell 'the most stupid idea', weil es 'does not research the internet'. Dieselben Notizen und Screenshots zeigen eine Search-Funktion, eine Freigabeabfrage für die Websuche und Tool-Aufrufe, die eine Seite lesen.
Tester-Meinung
Er will keine Modelle trainieren; die Chat-Funktion nützt ihm wenig; er will ein Bild- und Videowerkzeug und 'is not seeing it yet'. Training und der Tab 'Train' wurden nicht ausprobiert.
Tester-Meinung
'Maybe it's on my side, but no, not for me. I'll check again in three or six months, but currently not on a M3 24 GB Pro MacBook.'
Angaben im Vergleich zu dem, was der Tester sah
Angabe
Bezugsquelle
Beobachtet
Kennzeichnung
'Run and train image and video diffusion or multimodal models', locally (GitHub README; docs page)
Anbieter, gelesen am 16. Okt. 2026
Es entstand kein Bild. flux.2-klein wurde abgelehnt (etwa 17 GB nötig; 2 GB und 6 GB nutzbar). Kleinere Bildvarianten wurden nicht als ladbar gezeigt. Training nicht ausprobiert.
Beobachtet
'Training, MLX and GGUF inference all work inside of Unsloth' on macOS (docs)
Anbieter, gelesen am 16. Okt. 2026
Ein MLX-Modell (Qwen3.8-27B, 4 Bit) und ein GGUF-Modell (qwen3-coder:30b) luden und antworteten. Training nicht ausprobiert.
Beobachtet
'Can be used 100% offline and locally on your computer' (docs)
Anbieter, gelesen am 16. Okt. 2026
Websuche und Downloads nutzten das Internet. Die Offline-Nutzung wurde nicht getestet.
Beobachtet
Web search 'visits pages directly' (docs)
Anbieter, gelesen am 16. Okt. 2026
Das Lesen einer Seite wurde versucht; laut Notizen scheiterte der erste Versuch, und der zweite las die Seite. Danach ging der Speicher aus.
Beobachtet
Desktop app 'free and open source' (release notes)
Anbieter, gelesen am 16. Okt. 2026
In den Notizen und Screenshots erscheint keine Zahlungsaufforderung.
Beobachtet
Im Hub angezeigte Hardware
App
Der Hub zeigte 24 GiB RAM, 0 GiB VRAM + 24 GiB shared und 12/12 CPU. Der RAM-Wert passt zu den 24,00 GB des Macs.
Gemessen
'No hardware requirements stated' (pages read)
Anbieter, gelesen am 16. Okt. 2026
Weder die GitHub-Seite noch die Docs-Seite nannte im zurückgegebenen Text eine Speicheranforderung. Die App nennt ihren Bedarf selbst beim Laden (17 GB für flux.2-klein).
Beobachtet
Passt es in 24 GB?
24 GB Speicher
Gewichte von flux.2-klein laut Ablehnungsmeldungetwa 17 GB nötig unter 24 GBGemessen
FLUX.2-klein-4B (Geräteliste)16 GB Dateigröße unter 24 GBGemessen
FLUX.2-klein-4B-GGUF (Geräteliste)7,8 GB Dateigröße unter 24 GBGemessen
Laut App nutzbar, vor dem Neustartetwa 2 GB von 7 GB frei unter 24 GBGemessen
Laut App nutzbar, nach dem Neustartetwa 6 GB von 11 GB frei unter 24 GBGemessen
Mac-Speicher belegt, Aktivitätsanzeige (erste Aufnahme)12,92 GB belegt unter 24 GBGemessen
Mac-Speicher belegt, Aktivitätsanzeige (zweite Aufnahme)9,67 GB belegt unter 24 GBGemessen
Z-Image BF16, Download gesamt12,3 GB Modell + 8,2 GB nötige Dateien (Download-Größe) unter 24 GBGemessen
Die Zeilen 2, 3 und 8 sind Datei- oder Download-Größen, keine Speichernutzung zur Laufzeit. Die 17 GB sind die eigene Schätzung der App für flux.2-klein; auf welche Dateivariante sie sich bezieht, wurde nicht erfasst. 'Nutzbar' ist der Wert der App nach Abzug des Platzes für das Betriebssystem. Das Modell Qwen3.8-27B MLX 4-bit lief im Chat; seine Speichernutzung wurde nicht abgelesen.
Nutzungsprotokoll
#
Aufgabe
Modell
Ergebnis
Zeit
Status
Abbildungen
1
Die 24-MB-App öffnen, aktualisieren, erster Start
Unsloth 2026.8.18 -> 2026.10.3 (angenommen)
Nach dem Setup-Protokoll geöffnet; bestehende Installation
Tester-FehlerGetestet wurde ein Update einer bestehenden Installation ('same as before'), keine Erstinstallation.
Tester-FehlerFührte die ersten Speichertests mit geöffneten Apps wie Chrome, der Claude-App, Word, WhatsApp und weiteren auf einem 24-GB-Mac durch. Die erste Ablehnung zeigte 7 GB frei.
Tester-FehlerVerwendete durchgehend 'VRAM' für Speicher, obwohl die App '0 GiB VRAM + 24 GiB shared' sagt.
Tester-FehlerSchrieb, es gebe 'no token counter'; die Screenshots zeigen eine Kontextanzeige und Tokens pro Sekunde.
Tester-FehlerSchrieb, ein lokales Chat-Modell 'does not research the internet'; die Screenshots zeigen eine Search-Funktion und Tool-Aufrufe zur Websuche.
Tester-FehlerLas die Zahlen der Modellauswahl als Größen; es sind Parameterzahlen.
Tester-FehlerNotierte, nur sieben Gigabyte seien verfügbar, ohne zu sagen, was sonst offen war; der Dialog sagt, 7 GB seien in diesem Moment frei gewesen.
Tester-FehlerLieß Lücken in der Dokumentation: die Version der Desktop-App, die macOS-Version, den Chip, die Endzeit, welches Modell für den New-York-Prompt genutzt wurde und was daraus wurde, welche Ollama-Modelle scheiterten, ob der 20-GB-Download abgeschlossen wurde, die Einstellungen der Bildläufe und die Deinstallation.
Tester-FehlerSchrieb die App in den Notizen 'Onslaught' und 'Unslothh' (Sprachtranskription).
AnnahmeDie Notizen stellen den Z-Image-Dialog neben die Bemerkung 'only seven gigabytes'; die Zahl 7 GB steht in den Meldungen zu flux.2-klein. Screenshots wurden dem Text danach zugeordnet, was sie zeigen, nicht nur nach ihrer Reihenfolge.
Befundregister
ID
Befund
Kategorie
Kennzeichnung
Schweregrad
Abbildungen
UN-01
Das DMG ist 24 MB groß, viel kleiner als die anderen Apps, die der Tester kennt.
Der erste Start führt eine Installation von Abhängigkeiten in 13 Schritten durch, etwa vier bis fünf Minuten, ohne Zeit- oder Speicherplatzangabe. Das Detailprotokoll ist sichtbar.
Die Modellauswahl zeigt Parameterzahlen (27.3B, 271.0M) statt Download- oder Speichergröße; einige Einträge sind ohne Erklärung in der Aufnahme ausgegraut.
Der Tester hält die Oberfläche für schön und flüssig, erreichte aber kein Ergebnis und sieht derzeit keinen Grund, die App zu nutzen.
Gesamteindruck
Tester-Meinung
Mittel
-
UN-26
Das Verzeichnis führt die Lizenz als Apache-2.0; die GitHub-Seite sagt, die Studio-Oberfläche stehe unter AGPL-3.0 und der Kern unter Apache-2.0.
Pflege
Drittquelle
Mittel
-
Der Schweregrad bezeichnet die Auswirkung auf Erstnutzer. Vorgeschlagen, nicht gemessen.
Für wen es gedacht ist
Voraussichtlich geeignet
AnnahmeNutzer mit mehr als 24 GB Speicher oder einem sauberen Rechner mit wenigen geöffneten Apps, die Chat, einen Model Hub und lokale Modelle aus LM Studio und Ollama in einer App wollen.
HerstellerangabeMenschen, die Modelle trainieren oder feinabstimmen wollen, was laut Anbieter der Hauptzweck des Projekts ist (hier nicht getestet).
Voraussichtlich weniger geeignet
Tester-MeinungWer lokal Bilder auf einem 24-GB-Mac erzeugen will, während andere Apps offen sind. Beim Tester funktionierte das nicht.
Tester-MeinungWer schnell ein Ergebnis will, ohne sich mit Modellen, Speicher und Training zu beschäftigen.
Neutest. Der Tester will in drei bis sechs Monaten noch einmal nachsehen (etwa Januar bis April 2027). Vorher: Version der Desktop-App, macOS-Version und Chip erfassen; mit einer sauberen Installation beginnen; andere Apps schließen und den freien Speicher notieren; ein Bildmodell ausprobieren, das passt (zum Beispiel das GGUF mit 7,8 GB), und jede Einstellung und jedes Ergebnis festhalten; Training, Offline-Nutzung und Deinstallation testen.
Das Schlimmste, was man einem Kunden antun kann, ist, die Arbeit zu machen und ihn nicht auf dem Laufenden zu halten.
Notizen des Testers, leicht redigiert aus einer Sprachtranskription.
Häufige Fragen
Kann Unsloth auf einem 24-GB-Mac Bilder erzeugen?
In diesem Test nicht. Das Laden des Bildmodells flux.2-klein wurde zweimal abgelehnt: zuerst etwa 17 GB nötig bei etwa 2 GB nutzbar (7 GB frei), nach einem Neustart bei etwa 6 GB nutzbar (11 GB frei). Es entstand kein Bild. Gemessen
Findet Unsloth Modelle, die ich schon in LM Studio oder Ollama habe?
Ja, in diesem Test. Der erste Chat lud ein Qwen3.8-27B-Modell mit 4 Bit aus dem Modellordner von LM Studio ohne Download, und die Liste On Device zeigte Ollama-Modelle wie gemma4:latest und qwen3-coder:30b. Einige Ollama-Modelle funktionierten nicht; welche, wurde nicht erfasst. Beobachtet
Wie schnell ist der Unsloth-Chat auf einem 24-GB-Mac?
Ein 27B-Modell mit 4 Bit beantwortete 'what is 5 times 866' (4,330, richtig) in 10 Sekunden mit 11,0 Tokens pro Sekunde. Das Lesen einer Webseite und eine Veranstaltungssuche mit demselben Modell endeten bei geöffneten anderen Apps mit 'Ran out of memory'. Gemessen
Wie groß ist der Unsloth-Installer, und wie lange dauert die Einrichtung?
Das DMG ist 24 MB groß. Der erste Start führte ein Update der Abhängigkeiten in 13 Schritten durch, das der Tester auf vier bis fünf Minuten schätzt; das Fenster zeigt keine Zeit- oder Speicherplatzangabe. Der Test begann von einer bestehenden Installation aus, nicht von einer sauberen. Beobachtet
Lässt sich Unsloth vollständig offline nutzen?
Die Dokumentation des Anbieters sagt, es lasse sich zu 100 Prozent offline und lokal nutzen. Die Offline-Nutzung wurde nicht getestet; Websuche und Modell-Downloads nutzten das Internet. Herstellerangabe
Hintergrund zum Hersteller
Nicht Teil der Praxissitzung. Die folgenden Punkte stammen von der GitHub-Seite des Anbieters, seiner Dokumentation und Release-Seite sowie aus dem PromptQuorum-Verzeichnis. Sie wurden am 16. Oktober 2026 mit einem Web-Fetch-Werkzeug gelesen, das Seiten zusammenfasst, und nicht unabhängig überprüft.
HerstellerangabeDie GitHub-Seite beschreibt Unsloth als 'first desktop app to run and train models' und 'Local UI to run and train LLMs and diffusion models'. Sie bietet Unsloth Studio (Web-Oberfläche) und Unsloth Core (Code). Die gelesenen Seiten nannten weder ein Unternehmen noch eine Person.
HerstellerangabeLizenz: Kernpaket Apache 2.0; 'certain optional components, such as the Unsloth Studio UI' stehen unter AGPL-3.0.
HerstellerangabePlattformen: Windows, Linux, WSL und macOS. Installationsoptionen: Desktop-App (unter macOS eine .dmg), ein Shell-Skript, Homebrew und Docker. Hardwareanforderungen wurden im zurückgegebenen Text nicht genannt.
HerstellerangabeStudio-Dokumentation: führt GGUF-, MLX- sowie Diffusions-Modelle für Bild und Video lokal aus; unter macOS 'Training, MLX and GGUF inference all work inside of Unsloth'; Websuche 'visits pages directly'; 'can be used 100% offline'.
DrittquelleDas PromptQuorum-Verzeichnis führt Unsloth als kostenlos, Apache-2.0, für Mac, Windows und Linux, in der Kategorie Feinabstimmung und LoRA, mit etwa 76.100 GitHub-Sternen (Daten geprüft am 13. Sep. 2026). Es verzeichnet ein macOS-DMG im Release v0.1.905-beta (geprüft am 9. Okt. 2026) und ein letztes Upstream-Update am 16. Okt. 2026. PromptQuorum hatte Unsloth vor diesem Bericht nicht praktisch getestet.
AnnahmeDie am 16. Okt. 2026 gelesene Release-Seite lieferte v0.1.806-beta (2. Sep.) als neueste, was vom v0.1.905-beta des Verzeichnisses abweicht; das zusammenfassende Werkzeug hat möglicherweise eine veraltete Seite gelesen. Die Version des Python-Pakets im Setup-Protokoll (2026.10.3) folgt einer anderen Nummerierung als die Tags der Desktop-App.