Fatos rápidos
- Apps comparados: PocketPal AI, Private LLM, Locally AI (da LM Studio), Google AI Edge Gallery, MLC Chat, Apple Intelligence (sistema) — além do LLM Farm, atualmente fora da App Store (README: "temporariamente indisponível").
- Últimas atualizações upstream (verificadas em 2026-10-23): PocketPal AI v1.20.1 (19 out 2026) · Locally AI v1.66.0 (15 out 2026) · Google AI Edge Gallery v1.0.13 (8 out 2026) · Private LLM v1.9.16 (14 set 2026) · app MLC Chat para iPhone v1.6 (27 set 2024 — desatualizado) · LLM Farm versão 1.4.3 (27 jan 2025), último envio de código em 30 jan 2026 — desatualizado.
- Aparelhos de referência para as velocidades: iPhone 16 Pro (A18 Pro, 8 GB RAM) e iPhone 17 Pro (A19 Pro, 12 GB RAM). As velocidades são faixas aproximadas de orientação, não medições do PromptQuorum. O iPhone 18 Pro, o 18 Pro Max e o iPhone Duo (A20 Pro) não têm números de velocidade aqui.
- Motores de inferência: llama.cpp (PocketPal AI, LLM Farm), Apple MLX (Locally AI), MLC LLM com Metal (MLC Chat), Google LiteRT-LM (Google AI Edge Gallery), runtime proprietário no aparelho (Private LLM, Apple Intelligence).
- iPhone mínimo para modelos 3B+: iPhone 14 Pro (A16, 6 GB RAM) para 1.7B; qualquer iPhone de 8 GB+ (15 Pro, série 16, 16e, série 17, 18 Pro) para 3B–4B.
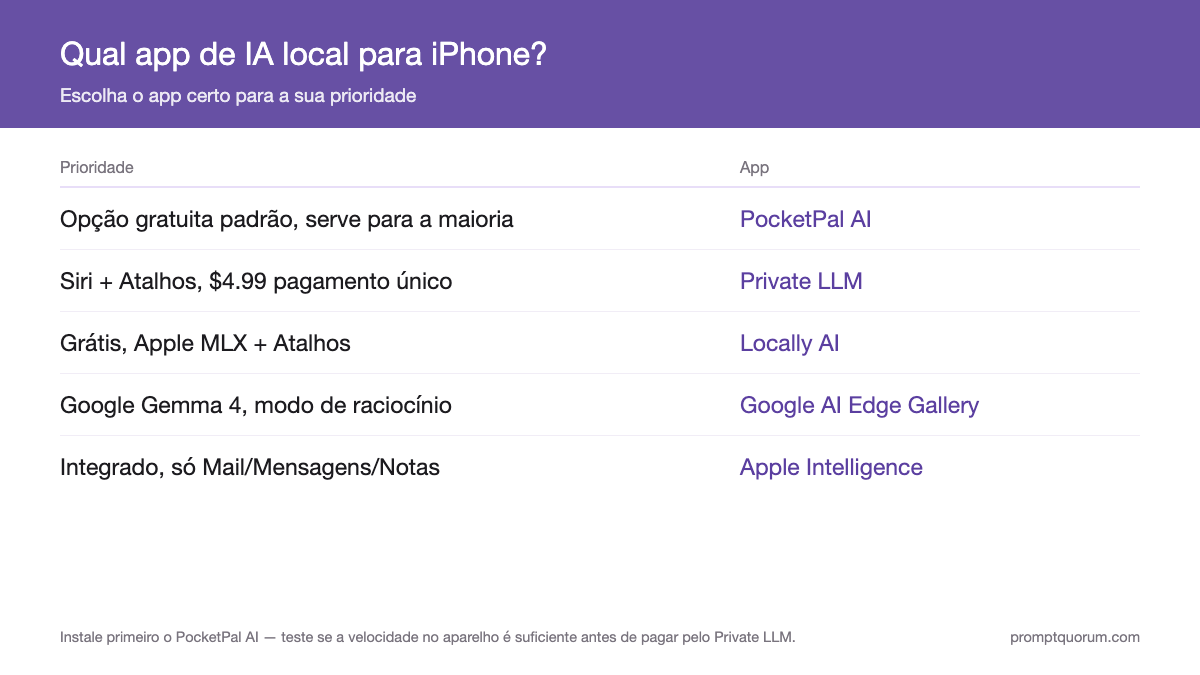
- App gratuito recomendado: PocketPal AI — App Store, código aberto, flexibilidade de modelos.
- Opção paga: Private LLM — $4.99 pagamento único (iPhone + iPad + Mac), suporte a Shortcuts + Siri.
- Offline: Depois que o modelo é baixado, o chat no aparelho dos seis funciona sem WiFi; recursos que buscam dados ao vivo (por exemplo, as skills de Wikipédia e mapas do Google AI Edge Gallery ou o LM Link opcional do Locally AI) precisam de conexão. Segundo o README ou a ficha do PocketPal AI, Private LLM, Locally AI e Google AI Edge Gallery, o chat no aparelho não faz chamadas à nuvem (não verificado para MLC Chat e LLM Farm); o Apple Intelligence pode usar o Private Cloud Compute.
Qual app instalar primeiro no iPhone?
Para a maioria dos usuários: PocketPal AI pela App Store e depois baixe o Phi-4 Mini (3.8B Q4_K_M) — ou um modelo pequeno mais novo, como o Gemma 4 E2B/E4B ou o Qwen3.5 4B. Essa combinação funciona no iPhone 15 Pro e modelos mais recentes (8 GB+ de RAM); em um iPhone de 6 GB, como o iPhone 14 Pro, baixe um modelo de 1.7B, como o Qwen3 1.7B (veja Modelos por nível de iPhone). Não custa nada para conversar e dá resultados úteis para o chat do dia a dia, resumos e rascunhos rápidos. Escolha outro app só quando tiver uma necessidade específica que ele não cobre.
📍 Em uma frase
Para a maioria dos usuários de iPhone em 2026, instale o PocketPal AI (grátis, App Store) e baixe o Phi-4 Mini ou um modelo pequeno mais novo, como o Gemma 4 E2B — ele cobre chat do dia a dia, resumos e rascunhos — com um modelo de 3B–4B em iPhones de 8 GB+ e um modelo de 1.7B em iPhones de 6 GB.
💬 Em termos simples
Seis opções executam IA no seu iPhone em 2026; os apps de chat mantêm o chat no aparelho depois que o modelo é baixado, e o Apple Intelligence também pode usar o Private Cloud Compute da Apple para solicitações maiores. O PocketPal AI é o ponto de partida gratuito recomendado — instale, baixe uma única vez um arquivo de modelo de 2.7 GB e pronto: você tem um assistente de chat privado que funciona no trem sem WiFi. O Private LLM é a opção paga se você quer que a Siri converse com o modelo local. O Locally AI, da equipe da LM Studio, é a alternativa gratuita e moderna com suporte a Shortcuts, e o Google AI Edge Gallery é o app gratuito do Google para os modelos Gemma 4. A versão do MLC Chat para iPhone não é mais atualizada. O Apple Intelligence é integrado ao iOS, mas não é um app de chat. O PocketPal AI atende à maioria dos casos de uso.
Decisão: qual app de IA local para iPhone?
Use um LLM local se:
- •Você quer uma IA de chat gratuita que funcione offline → PocketPal AI
- •Você quer que a Siri converse com o seu modelo local → Private LLM
- •Você quer um app MLX gratuito com Shortcuts e acesso aos Apple Foundation Models → Locally AI
- •Você quer o Gemma 4 do próprio Google, com modo de raciocínio e agent skills → Google AI Edge Gallery
- •Você quer experimentar a cadeia de ferramentas do MLC LLM e aceita uma versão para iPhone sem atualização desde setembro de 2024 → MLC Chat
- •Você só precisa de ajuda de escrita no Mail / Mensagens / Notas → Apple Intelligence (integrado)
- •Você quer chat offline com perguntas sobre documentos, memória editável ou Modo Criança com PIN → MemoryAI
Use um modelo em nuvem se:
- •Você precisa de qualidade de modelo 70B+ (Llama 3.3 70B, nível GPT-5.5) → use a nuvem ou conecte-se remotamente a uma máquina em casa
- •Você precisa especificamente de GPT-5.5, Claude Opus ou Gemini → apps na nuvem (não estão disponíveis localmente)
- •Você precisa de visão em tempo real ou saída multimodal além de texto → nuvem (o multimodal no aparelho é limitado em 2026)
Decisão rápida:
- →Grátis + serve para a maioria: PocketPal AI
- →Pago + integração nativa com o iOS: Private LLM
- →Grátis + ecossistema LM Studio: Locally AI
- →Grátis + Gemma 4 do Google: Google AI Edge Gallery
- →Gratuito + documentos, memória, Modo Criança: MemoryAI
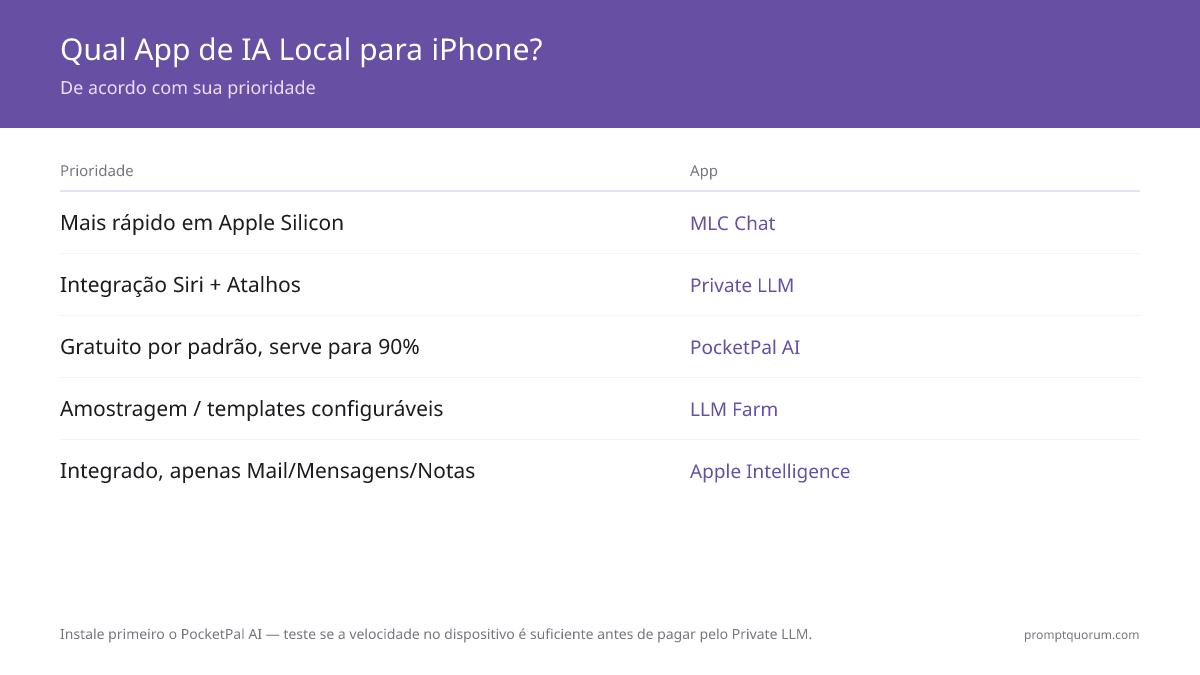
💡Dica: Instale o PocketPal AI primeiro, mesmo que você pretenda pagar pelo Private LLM mais tarde. Use o PocketPal AI para testar se a inferência no aparelho, no seu modelo de iPhone, é rápida o bastante para o seu uso. Se for, decida se a integração com Shortcuts e Siri do Private LLM vale $4.99. Se não for, você descobriu isso sem gastar $4.99. O PocketPal AI também tem um benchmark integrado que mostra tokens/seg e memória no seu próprio iPhone — use-o em vez de confiar em qualquer tabela, inclusive a abaixo.
Tabela comparativa de apps para iPhone
As seis opções se diferenciam em três eixos que importam à maioria dos usuários: custo, flexibilidade de modelos e integração com o iOS. As diferenças de velocidade existem, mas são menores que a distância entre qualquer um desses apps e um LLM na nuvem. Preços e versões foram lidos nas fichas da App Store dos EUA e nas páginas dos projetos em 2026-10-23.
📍 Em uma frase
O PocketPal AI é a opção gratuita padrão recomendada, o Private LLM é a opção paga, o Locally AI é a opção MLX gratuita da equipe da LM Studio, o Google AI Edge Gallery é o app gratuito do Google para o Gemma 4, o MLC Chat está parado no iPhone e o Apple Intelligence é integrado ao sistema.
💬 Em termos simples
A escolha geralmente se resume a três perguntas: você quer pagar pela integração com a Siri (Private LLM), quer o ecossistema da LM Studio com Shortcuts de graça (Locally AI) ou quer o próprio Gemma 4 do Google, com modo de raciocínio (Google AI Edge Gallery)? Para todo o resto, o PocketPal AI é a opção padrão. Os números de velocidade da tabela são faixas indicativas para a quantização Q4_K_M — o padrão para inferência móvel em 2026 —, não medições do PromptQuorum.
App | Preço | Tokens/seg (Phi-4 Mini, 16 Pro) | Privacidade | Ideal para |
|---|---|---|---|---|
| PocketPal AI | Grátis (MIT) + compras opcionais no app | ~10–15 | Chat no aparelho, sem conta (README) | Opção gratuita padrão para a maioria |
| Private LLM | $4.99 pagamento único | Sem número | No aparelho; sem contas nem rastreamento (desenvolvedor) | Shortcuts + integração com a Siri |
| Locally AI | Grátis (equipe LM Studio) | N/D — catálogo MLX (sem Phi-4) | No aparelho; sem coleta de dados (ficha) | MLX + Shortcuts, vínculo com LM Studio |
| Google AI Edge Gallery | Grátis (Google) | N/D — LiteRT-LM, Gemma 4 | No aparelho após baixar o modelo (ficha) | Gemma 4, modo de raciocínio, agent skills |
| MLC Chat | Grátis (código aberto) | N/D — biblioteca anterior ao Phi-4 | Inferência local (doc. do projeto; não verificado) | Quem usa o MLC LLM (app iOS parado) |
| LLM Farm | Grátis (compilar o código-fonte) | Sem número | Inferência local (doc. do projeto; não verificado) | Desenvolvedores (fora da App Store, desatualizado) |
| Apple Intelligence | Grátis (integrado ao iOS) | N/A (função do sistema) | Local + Private Cloud Compute (Apple) | Ajuda no Mail, Mensagens, Notas |
| MemoryAI | Gratuito; sem anúncios nem compras no app | Sem valor | No dispositivo após o download; envia eventos de uso e falhas | Documentos, memória editável, Modo Criança |
| fullmoon | Gratuito (MIT) | Sem valor | No dispositivo segundo o fabricante; política contraditória | Chat offline simples; sem versões desde jan. 2025 |
| Cloak: Local AI | Pagamento único (R$ 12,90, loja brasileira); sem assinatura | Sem valor | No aparelho após o download do modelo; pesquisa opcional e contagens de uso se você ativar | Chat sem configuração, Notas de Voz, Recap |
Nota sobre Apple Neural Engine (ANE), Metal e MLX: o PocketPal AI e o LLM Farm usam llama.cpp com Metal Performance Shaders para a inferência, que roda na GPU. O MLC Chat usa o MLC LLM com uma otimização Metal mais profunda, que o projeto MLC LLM descreve como mais rápida que os apps baseados em llama.cpp no mesmo hardware (afirmação do projeto; o PromptQuorum não mediu isso). O Locally AI usa o Apple MLX, o framework open source de arrays da própria Apple, que alcança eficiência de GPU semelhante no Apple Silicon. O Google AI Edge Gallery executa o Gemma 4 pelo runtime LiteRT-LM do Google. O Apple Intelligence usa o ANE especificamente para o modelo de sistema de ~3B, que é mais eficiente em energia, mas menos flexível que a inferência baseada em Metal. Desde o iOS 26, apps de terceiros podem chamar esse modelo de sistema pelo framework Foundation Models — o Locally AI faz exatamente isso —, mas modelos GGUF/MLX personalizados ainda não conseguem usar o ANE diretamente. A Apple afirma que o A20 Pro do iPhone 18 Pro tem um Neural Engine de 16 núcleos duplo, com o dobro do poder de computação de antes; essa é uma afirmação da Apple, e o PromptQuorum não mediu o que isso significa para esses apps.
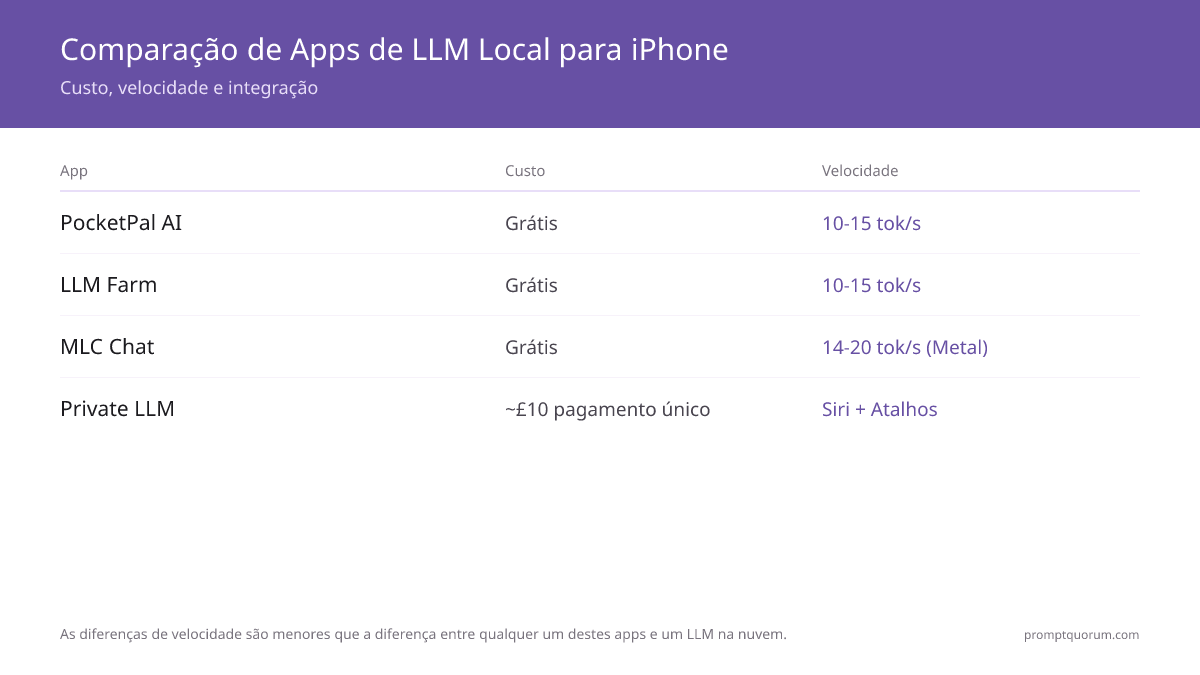
💡Dica: Os números de tokens/seg são faixas aproximadas de orientação para modelos Q4_K_M em iPhones recentes, não medições do PromptQuorum nem vinculados a uma versão do app ou a uma data de teste. Eles assumem a quantização Q4_K_M (o padrão para inferência móvel em 2026) e um iPhone ocioso, sem outros apps pesados abertos. Apps em segundo plano podem reduzir bastante o desempenho, e o iPhone 17 Pro normalmente é mais rápido que o iPhone 16 Pro. Meça o seu próprio aparelho com o benchmark integrado do PocketPal AI.
PocketPal AI: opção gratuita e de código aberto
O PocketPal AI é o ponto de partida recomendado para a maioria dos usuários de iPhone em 2026. É gratuito, de código aberto (MIT; GitHub: a-ghorbani/pocketpal-ai), está na App Store e é compatível com qualquer modelo GGUF do Hugging Face. O app usa llama.cpp por baixo, com otimizações para Apple Silicon. Análise completa: Análise do PocketPal AI.
- O que é: um app para iOS/iPadOS e Android que executa modelos GGUF localmente com llama.cpp, publicado pela Gooya UG. O README informa que prompts, respostas e documentos não são enviados a servidores externos; o chat não exige conta.
- Versão e última atualização: v1.20.1, lançada em 19 de outubro de 2026 (release no GitHub); a ficha da App Store mostra a mesma versão. Versões recentes: v1.19.0 (4 out), v1.20.0 (14 out), v1.20.1 (19 out 2026) — sem aviso de inatividade.
- Instalação: App Store → "PocketPal AI". Download gratuito com compras opcionais dentro do app (Pals premium e "PocketPal Plus"). Exige iOS/iPadOS 15.1 ou superior; é a RAM, e não a versão do iOS, que define o tamanho de modelo utilizável. Desde a v1.20.0 o app também oferece Entrar com a Apple (opcional) e exclusão de conta.
- Adicionar um modelo: no app, toque em Modelos → "Adicionar do Hugging Face" → pesquise (p. ex. "phi-4-mini-instruct-Q4_K_M") → toque para baixar. O modelo fica no armazenamento local do app (~2.7 GB para o Phi-4 Mini Q4).
- Velocidade de geração (iPhone 16 Pro, indicativa): Phi-4 Mini ~10–15 tok/seg, Llama 3.2 3B ~12–18 tok/seg, Gemma 3 4B ~7–10 tok/seg, Qwen3 1.7B ~18–24 tok/seg. São faixas aproximadas de orientação, não medições do PromptQuorum — use o benchmark integrado, que mostra tokens/seg e memória no seu próprio iPhone.
- Outros recursos: Pals (assistentes personalizados), texto para fala no aparelho, Talents (calculadora e ferramentas de data/hora para modelos capazes) e um navegador de modelos do Hugging Face que aceita modelos restritos com token de acesso.
- Ideal para: quem quer um app de chat gratuito, instalável pela App Store, sem conta e compatível com qualquer modelo GGUF publicado pela comunidade.
💡Dica: O seletor de modelos do PocketPal AI tem um filtro "Recomendados" que, segundo a documentação do app, mostra os modelos que cabem na RAM do seu aparelho. Confira-o no seu próprio iPhone — um modelo grande demais pode fazer o iOS encerrar o app no meio da resposta.
Private LLM: opção paga com integração ao iOS
O Private LLM é a opção paga deste guia para iPhone ($4.99 pagamento único, sem assinatura). Está disponível só na App Store e vem com uma biblioteca curada de modelos otimizados. Seu diferencial é a integração com o iOS: o desenvolvedor afirma que ele se conecta diretamente à Siri e ao app Shortcuts. Análise completa: Análise do Private LLM.
- O que é: um app iOS pago com biblioteca de modelos curada e integração profunda com o iOS. Usa um runtime proprietário no aparelho, otimizado para Apple Silicon.
- Instalação: App Store → "Private LLM - Local AI Chat" (Numen Technologies Limited). Compra única de $4.99 (sem assinatura; a ficha não mostra compras dentro do app). Exige iOS/iPadOS 17.0 ou superior em um chip A12 Bionic ou mais novo.
- Versão e última atualização: v1.9.16, lançada em 14 de setembro de 2026 (histórico de versões da App Store); a versão anterior foi a 1.9.15, de 9 de julho de 2026. As versões saem a cada dois ou três meses — dentro do limite de três meses, então sem aviso de inatividade.
- Biblioteca de modelos curada: o privatellm.app anuncia mais de 140 modelos locais para iPhone, iPad e Mac, citando famílias como Llama, Qwen3, Gemma 3 e Phi 4; o subconjunto que cabe em um iPhone é menor. Menos flexibilidade que o PocketPal AI, mas os modelos já vêm otimizados para o runtime do app.
- Shortcuts: segundo o desenvolvedor, o Private LLM se conecta ao app Shortcuts e pode repassar respostas a outros apps que suportam a especificação x-callback-url. Útil para acionar a IA local por um botão na tela de início ou por etiquetas NFC.
- Integração com a Siri: o desenvolvedor lista a integração com a Siri; um prompt encaminhado ao modelo no aparelho funciona sem conexão à internet (a internet só é necessária para o primeiro download do modelo).
💡Dica: Segundo o privatellm.app, uma única compra de $4.99 cobre iPhone, iPad e Mac, e a ficha da App Store diz que até seis familiares podem usar com o Compartilhamento em Família. Não há assinatura nem compras dentro do app listadas — o preço exibido é o custo total. O desenvolvedor afirma que não há contas, rastreamento nem logs. O preço está em dólares, conforme a App Store dos EUA; o valor em reais na sua loja pode ser diferente.
Locally AI: app MLX gratuito da LM Studio
O Locally AI é um app de chat gratuito (a ficha diz que não coleta dados), desenvolvido pela equipe da LM Studio (listado em nome da Element Labs Inc) e construído sobre o framework MLX da própria Apple, em vez de llama.cpp. É o único app aqui que expõe o modelo de base no dispositivo da Apple como interface de chat. Análise completa: Análise do Locally AI.
- O que é: um app iOS/iPadOS/macOS que usa o Apple MLX para a inferência, desenvolvido pela equipe por trás do app de desktop LM Studio.
- Instalação: App Store → "Locally AI". Grátis, sem compras dentro do app listadas, sem conta (segundo a ficha), funciona offline.
- Versão e última atualização: v1.66.0, lançada em 15 de outubro de 2026 (histórico de versões da App Store); cerca de uma versão por mês em 2026 — sem aviso de inatividade.
- Biblioteca de modelos: Llama 3.2, Gemma 2/3/4, Qwen 3 e 3.5, DeepSeek, LFM 2.5, Bonsai, Ministral 3 e Apple Foundation Models — um catálogo mais amplo e atual que o do MLC Chat.
- iOS Shortcuts: expõe uma ação de Shortcuts, igualando de graça o suporte de automação do Private LLM.
- LM Link: um recurso opcional que se conecta ao LM Studio rodando em um Mac pelo que a LM Studio descreve como um link criptografado de ponta a ponta, permitindo que o app do iPhone recorra a um modelo maior em uma máquina em casa quando necessário.
- Requisitos: iOS/iPadOS 18.1 ou superior (macOS 26.0 ou superior para a versão de Mac). Os ganhos de eficiência do Apple Silicon aparecem mais a partir do iPhone 15 Pro.
💡Dica: O Locally AI é o único app deste guia que consegue colocar o próprio modelo de base no dispositivo da Apple atrás de uma janela de chat comum — útil para testar o que o modelo do Apple Intelligence faz sem procurar nos menus das Ferramentas de Escrita. Para a flexibilidade de modelos de terceiros em GGUF, o PocketPal AI ainda tem o catálogo maior.
Google AI Edge Gallery: app gratuito do Google com Gemma 4
O Google AI Edge Gallery é o app gratuito do Google para executar os modelos Gemma 4 no celular, e está disponível na App Store do iPhone. A ficha mostra chat com IA com modo de raciocínio, agent skills, entrada de imagem e áudio, Prompt Lab e benchmark de modelos. O Google diz que o app está em desenvolvimento ativo. Análise completa: Análise do Google AI Edge Gallery.
- O que é: o app de demonstração de IA no aparelho do Google, construído sobre o runtime LiteRT-LM do Google. Gratuito; sem compras dentro do app listadas.
- Instalação: App Store → "Google AI Edge Gallery". Exige iOS 17.0 ou superior. Os modelos são baixados separadamente dentro do app.
- Versão e última atualização: v1.0.13, lançada em 8 de outubro de 2026 (histórico de versões da App Store). O suporte ao Gemma 4 chegou na v1.0.2, em 3 de abril de 2026 — sem aviso de inatividade.
- Modelos: a família Gemma 4 (E2B e E4B são as variantes do tamanho de um celular; o Google lista os arquivos LiteRT-LM em cerca de 2.58 GB e 3.65 GB), EmbeddingGemma 2 e FunctionGemma 270M. Modelos no formato LiteRT-LM também podem ser importados do Hugging Face.
- Recursos: Modo de Raciocínio (só nos modelos Gemma 4), Agent Skills (por exemplo, consulta à Wikipédia e mapas, além de skills da comunidade), Ask Image, Audio Scribe, Prompt Lab e benchmark de modelos.
- Limites: só modelos LiteRT-LM, não GGUF nem MLX; a ficha não menciona Shortcuts nem Siri; o PromptQuorum não tem números de velocidade para ele.
- Ideal para: quem quer o próprio Gemma 4 do Google, com modo de raciocínio visível e ferramentas de agente, sem custo.
💡Dica: O Google informa um pico de memória de cerca de 607 MB na CPU e 1,450 MB na GPU para o Gemma 4 E2B em um iPhone 17 Pro (números do fabricante, segundo a página do Google sobre o Gemma 4 no LiteRT-LM; não remedidos pelo PromptQuorum). O E2B é o ponto de partida prático para a maioria dos celulares; o E4B serve para iPhones de 8 GB+.
MLC Chat: otimização para Apple Silicon
Aviso de inatividade: o app MLC Chat para iPhone não recebe atualização desde a versão 1.6, de 27 de setembro de 2024 (mais de dois anos), então pode estar sem manutenção — verifique antes de depender dele. O repositório do motor MLC LLM continua ativo no GitHub (última atividade em 6 de outubro de 2026). O MLC Chat é gratuito, de código aberto e executa modelos compilados pela cadeia de ferramentas do MLC LLM em vez de GGUF padrão, e seu catálogo não acompanhou o do PocketPal AI nem o do Locally AI. Análise completa: Análise do MLC Chat.
- O que é: o app iOS de referência do projeto MLC LLM, que demonstra a inferência acelerada por Metal do MLC LLM no Apple Silicon.
- Instalação: App Store → "MLC Chat". Grátis. Exige iOS/iPadOS 17.0 ou superior.
- Versão e última atualização: v1.6, lançada em 27 de setembro de 2024 (histórico de versões da App Store; adicionou o Llama 3.2 3B). Antes: a 1.5 adicionou o Gemma 2 2B (agosto de 2024) e a 1.4 adicionou Phi-3, Mistral v3 e Qwen2 (junho de 2024). Última atualização para iPhone há mais de dois anos — aviso de inatividade ativado.
- Velocidade (afirmação do projeto, não medida aqui): o projeto MLC LLM descreve seu motor acelerado por Metal como mais rápido que apps baseados em llama.cpp no mesmo iPhone — mas a lista de modelos do próprio app é anterior às escolhas atuais, como o Phi-4 Mini e o Gemma 3, então essa vantagem não pode ser testada com os modelos recomendados de 2026 sem uma versão compilada por você.
- Biblioteca de modelos: limitada aos modelos que o projeto MLC LLM compilou antes de o app ficar parado — Llama 3.2 3B, Gemma 2 2B, Phi-3, Mistral v3, Qwen2 e outros lançamentos semelhantes de 2024. Nem todo GGUF do Hugging Face funciona, e nenhum modelo pequeno da geração atual vem na versão da App Store.
- Ideal para: desenvolvedores que já investiram na cadeia de ferramentas do MLC LLM e aceitam compilar o próprio modelo, ou que precisam especificamente de um dos modelos de antes de 2025 que ele já traz.
⚠️Aviso: Como a versão da App Store do MLC Chat não recebe atualização desde 27 de setembro de 2024, não espere ver Phi-4 Mini, Qwen3 ou Gemma 3 no seletor. Se você quer modelos da geração atual com eficiência de GPU no nível do Metal hoje, o Locally AI (Apple MLX), o PocketPal AI (llama.cpp com Metal Performance Shaders) ou o Google AI Edge Gallery (Gemma 4) são as alternativas com manutenção ativa.
LLM Farm: fora da App Store, código-fonte ainda disponível
Aviso de inatividade: a última versão do LLM Farm (1.4.3) foi lançada em 27 de janeiro de 2025 e o último envio de código foi em 30 de janeiro de 2026 — quase nove meses sem atualização —, então ele pode estar sem manutenção. A análise do PromptQuorum sobre o projeto data a remoção da App Store de agosto de 2025; o próprio README no GitHub descreve o app como "temporariamente indisponível" na App Store e no TestFlight. O projeto (GitHub: guinmoon/LLMFarm) continua de código aberto e teve atividade de issues no GitHub até outubro de 2026, mas novos usuários não conseguem mais instalá-lo pela App Store; é preciso compilá-lo a partir do código-fonte pelo Xcode (README: macOS 13+ e iOS 16+). Análise completa: Análise do LLM Farm.
- O que é: um app iOS do mantenedor do projeto que executa modelos GGUF com amplas opções de configuração, antes distribuído pela App Store.
- Disponibilidade atual: não pode ser instalado pela App Store nem pelo TestFlight na data desta atualização. O código-fonte continua público e compilável.
- Compilar a partir do código-fonte: clone o repositório, abra no Xcode e compile para um aparelho com uma conta Apple Developer gratuita ou paga — o fluxo padrão de sideloading para qualquer app iOS de código aberto sem ficha na App Store.
- Configuração exposta (depois de compilar): temperatura, top-p, top-k, amostragem mirostat, penalidade de repetição, prompt de sistema por modelo, escolha do template de chat, tamanho da janela de contexto.
- Ideal para: desenvolvedores à vontade para compilar um app a partir do código-fonte no Xcode e que querem especificamente os controles de amostragem mirostat. Todos os demais devem usar o PocketPal AI ou o Locally AI, ambos totalmente instaláveis pela App Store e gratuitos.
⚠️Aviso: Não espere que um link da App Store para o LLM Farm funcione — trate qualquer link desse tipo encontrado em outro lugar como desatualizado. Compilar a partir do código-fonte exige o Xcode e noções básicas de assinatura de código no iOS. Se isso for mais trabalho do que você quer ter, o PocketPal AI cobre o mesmo caso de uso de "app de chat gratuito e flexível" sem sair da App Store.
Apple Intelligence: IA no aparelho integrada ao sistema
O Apple Intelligence executa o modelo de base de ~3B da própria Apple no aparelho, no iPhone 15 Pro e modelos mais recentes (a geração do iPhone 15 Pro, com 8 GB de RAM segundo a imprensa; a Apple não divulga a RAM). Por padrão ele não é um app de chat — alimenta funções do sistema no Mail (Resposta Inteligente), Mensagens (ferramentas de escrita), Notas (resumos) e Resumos de Notificações. Desde o iOS 26, o framework Foundation Models da Apple permite que desenvolvedores terceiros chamem esse mesmo modelo no aparelho diretamente, e apps como o Locally AI o usam para oferecer uma interface de chat de verdade. O iOS 27 amplia o framework: o guia para desenvolvedores da Apple diz que os apps podem usar qualquer modelo de linguagem que siga o protocolo de modelos de linguagem do framework, incluindo os modelos da própria Apple e modelos na nuvem.
- Onde está: integrado ao iOS 18+ (framework Foundation Models adicionado no iOS 26). Ative em Ajustes → Apple Intelligence e Siri.
- Requisito de hardware: iPhone 15 Pro / 15 Pro Max, série iPhone 16, iPhone 16e, série iPhone 17 e, em 2026, iPhone 18 Pro, 18 Pro Max e iPhone Duo (A20 Pro). Os iPhones anteriores (14 e abaixo) não suportam o Apple Intelligence. Confira a lista de compatibilidade atual da Apple para o iOS 27 antes de comprar.
- Siri AI (iOS 27): a Apple descreve a Siri AI como disponível em beta no iOS 27, com lançamento primeiro em inglês, inicialmente indisponível na UE no iOS e sujeita a limites diários de uso em alguns recursos que rodam em servidor. Ela é separada dos apps de chat no aparelho deste guia.
- Funções no aparelho: Ferramentas de Escrita (reescrever, resumir, revisar) em qualquer campo de texto, Resposta Inteligente no Mail e no Mensagens, Resumos de Notificações, geração de Genmoji.
- Framework Foundation Models (iOS 26+): uma API Swift nativa que dá aos desenvolvedores acesso direto ao mesmo modelo no aparelho com poucas linhas de código — é assim que o Locally AI o oferece como opção de chat, e como a ação "Usar Modelo" do Shortcuts pode encaminhar um prompt a ele, ao Private Cloud Compute ou ao ChatGPT.
- Private Cloud Compute: para tarefas além da capacidade do modelo no aparelho, o Apple Intelligence pode enviar a solicitação ao Private Cloud Compute (PCC) — servidores operados pela Apple que executam modelos maiores, que, segundo a Apple, não retêm dados do usuário. Consulte a documentação da Apple sobre Apple Intelligence e privacidade para ver os ajustes disponíveis no seu aparelho.
- Relação com os apps de chat: o Apple Intelligence é um complemento, não um substituto. Suas funções de sistema cuidam de reescrever e resumir textos dentro dos apps do iOS; PocketPal AI, Private LLM, Locally AI e MLC Chat oferecem uma interface de chat dedicada para perguntas livres — e o Locally AI agora pode colocar o modelo da própria Apple atrás desse mesmo tipo de interface.
💡Dica: Se o Apple Intelligence é a sua única necessidade (reescrever e-mails, resumir notificações), você não precisa de um app de chat à parte. Se você quer fazer ao modelo perguntas como "explique o tunelamento quântico em termos simples" ou "monte um plano de projeto para X", instale um app de chat — um dedicado como o PocketPal AI, ou o Locally AI, que pode colocar o modelo da própria Apple atrás de uma janela de chat.
MemoryAI: chat offline com memória editável (não medido)
MemoryAI é um app de chat gratuito e offline para iPhone, com perguntas sobre documentos, uma memória editável no dispositivo e um Modo Criança protegido por PIN. Foi adicionado depois da comparação principal, por isso não está na tabela comparativa e não fez parte dos nossos testes.
- Biblioteca de modelos: os modelos são baixados dentro do app (de 0,3 a 4 GB cada) e arquivos GGUF próprios podem ser importados do Hugging Face. Usa dois motores de inferência: llama.cpp e o LiteRT do Google.
- Recursos: perguntas sobre documentos, uma memória de agente que você pode abrir, editar e apagar, voz mãos livres (entrada de voz e leitura em voz alta no dispositivo), compreensão de imagens com modelos de visão e um Modo Criança travado por um PIN dos responsáveis.
- Requisitos e preço: iOS 16.4+, 4 GB de RAM ou mais. Gratuito, sem anúncios, assinaturas ou compras no app.
- Privacidade e licença: conversas, documentos e memórias ficam no dispositivo depois do download do modelo. O app envia eventos de uso e relatórios de falhas (sem conteúdo das conversas, segundo o desenvolvedor) e é de código fechado.
- Instalação: App Store. Lançado em 30 de março de 2026, portanto é um app jovem. A App Store lista a versão 1.0.60.
💡Dica: Os dados acima vêm das páginas das lojas, da política de privacidade e do desenvolvedor, que revisou o nosso texto; não medimos o MemoryAI nos nossos celulares de teste. Notas completas: análise do MemoryAI.
fullmoon: chat gratuito e de código aberto sobre Apple MLX (sem versões desde o início de 2025)
O fullmoon é um app de chat offline gratuito, com licença MIT, para iPhone, iPad e Mac que executa modelos pequenos com o MLX da Apple, mas não recebe versão desde 28 de janeiro de 2025 nem alterações de código desde 5 de maio de 2025, e pode estar sem manutenção. Foi adicionado depois da comparação principal e, por isso, não fez parte dos nossos testes.
- Modelos: Llama 3.2 1B e 3B e duas versões do DeepSeek-R1-Distill-Qwen-1.5B (0.7–1.9 GB cada), segundo o site.
- Recursos: prompt do sistema editável, tema e fontes, e uma ação do Atalhos; o histórico de conversas fica armazenado localmente (README).
- Requisitos e preço: iOS 17.6+, 31.6 MB antes de baixar os modelos. Download gratuito.
- Privacidade e licença: a política diz que nada é coletado, mas também lista finalidades dos dados coletados, o que a torna contraditória. O código-fonte é público sob licença MIT.
- Instalação: App Store (versão 1.2.0); o site também oferece um link do TestFlight para versões mais novas.
💡Dica: Os dados acima vêm do site do fabricante, da página da App Store, da política de privacidade e do repositório público; não executamos o fullmoon nos nossos celulares de teste. Detalhes: análise do fullmoon.
Cloak: Local AI: chat offline de pagamento único (não medido)
O Cloak: Local AI é um app de chat offline de pagamento único para iPhone e iPad, com Notas de Voz e um Recap semanal. Ele foi adicionado depois da comparação principal, por isso não entra nos números de velocidade e não fez parte dos nossos testes.
- Biblioteca de modelos: o app baixa um modelo recomendado do Hugging Face durante a configuração; não há seletor de modelos, e o nome e o tamanho do modelo não são divulgados.
- Recursos: várias conversas locais, um prompt de sistema personalizável, Notas de Voz convertidas em anotações ou chats, e o Recap, um resumo dos últimos sete dias feito com Fotos, Localização e Notas de Voz. Uma versão separada para Mac, o Cloak: Local AI Chat, oferece apenas chat.
- Requisitos e preço: iOS ou iPadOS 18.0+. Compra única de R$ 12,90 na loja brasileira, sem assinatura e sem compras no app listadas.
- Privacidade e licença: segundo a política, as conversas ficam no aparelho depois do download do modelo. A versão para iPhone envia uma resposta opcional a uma pesquisa de configuração e, só se você ativar, contagens diárias de uso; é de código fechado.
- Instalação: App Store. Lançado em 25 de junho de 2026; a App Store lista a versão 1.2.9, de 27 de outubro de 2026.
💡Dica: Os dados vêm das páginas da App Store, do site da Polyaura e da política de privacidade; o desenvolvedor não foi contatado e não medimos o Cloak nos nossos celulares de teste. Detalhes completos: análise do Cloak: Local AI.
Reins: cliente de chat para o seu servidor Ollama ou LM Studio (não medido)
O Reins é um app de chat gratuito para iPhone e iPad que se conecta ao seu próprio servidor Ollama, LM Studio ou compatível com OpenAI e, desde a versão 2, também pode executar modelos MLX no aparelho. Foi adicionado depois da comparação principal, portanto não está na tabela comparativa e não fez parte dos nossos testes.
- Biblioteca de modelos: os modelos MLX no aparelho são baixados dentro do app a partir do Hugging Face, e qualquer modelo MLX pode ser pesquisado e baixado; os Apple Foundation Models também são suportados.
- Recursos: chamadas de ferramentas, busca na web integrada sem chave de API, anexos de imagem, PDF, CSV e texto, ramificação de chats, modo de raciocínio e chats temporários.
- Requisitos e preço: iOS 17.0 ou posterior (a geração em segundo plano exige iOS 26). Download gratuito, com o Reins Pro como compra no app mensal, anual ou vitalícia; as fontes não listam o que o Pro libera.
- Privacidade e licença: o desenvolvedor diz que não há login, análise nem coleta de dados. A versão 2 é de código fechado; o repositório público contém o código apenas até a versão 1.3.4.
- Instalação: App Store. A App Store lista a versão 2.3.3, lançada em 21 de outubro de 2026.
💡Dica: Os dados vêm da página da App Store, do site e das políticas do desenvolvedor; não medimos o Reins em nossos celulares de teste. Notas completas: análise do Reins.
Modelos conforme o modelo de iPhone
É a RAM do iPhone que define o limite de tamanho do modelo, e não a geração do chip. Um iPhone de 6 GB (14 Pro, 15) executa modelos 1.7B com folga; um iPhone de 8 GB+ (15 Pro, série 16, 16e, série 17) executa modelos 3B–4B com folga e modelos 7B devagar. Modelos pequenos mais novos que valem o teste ao lado do Phi-4 Mini: Gemma 4 E2B e E4B (Google, abril de 2026; cerca de 2.58 GB e 3.65 GB como arquivos LiteRT-LM) e a série pequena Qwen3.5 (Alibaba, março de 2026; 0.8B, 2B, 4B e 9B, Apache 2.0 segundo o resumo da Artificial Analysis). O PromptQuorum não tem números de velocidade para eles; o Locally AI e o Google AI Edge Gallery já os trazem. Para o panorama mais amplo de modelos em todo tipo de hardware (não só celular), veja Os melhores LLMs locais em 2026.
Nível de iPhone (Ano, RAM) | Modelo recomendado | Tamanho de download | Velocidade (indicativa) |
|---|---|---|---|
| iPhone 18 Pro / Pro Max (2026, ~12 GB segundo a imprensa) | Comece como no 17 Pro; RAM não divulgada pela Apple | ~2.5–3.7 GB | Sem número |
| iPhone 17 Pro / 17 Pro Max (2025, 12 GB) | Phi-4 Mini / Llama 3.2 3B / Gemma 4 E4B | ~2.5–3.7 GB | ~13–20 tok/seg (Phi-4 Mini) |
| iPhone série 16 / 16e / 17 (2024–2025, 8 GB) | Phi-4 Mini (3.8B Q4_K_M) ou Gemma 4 E2B | ~2.6–2.7 GB | ~10–15 tok/seg (Phi-4 Mini) |
| iPhone 15 Pro / Pro Max (2023, 8 GB) | Phi-4 Mini (3.8B Q4_K_M) | ~2.7 GB | ~8–12 tok/seg |
| iPhone 13 Pro / 14 Pro / Pro Max (6 GB) | Qwen3 1.7B ou SmolLM 2 1.7B (Q4_K_M) | ~1.1 GB | ~15–20 tok/seg |
| iPhone 14 / 14 Plus / 15 / 15 Plus (6 GB) | Qwen3 1.7B ou SmolLM 2 1.7B (Q4_K_M) | ~1.1 GB | ~12–18 tok/seg |
| iPhone 13 / 12 / SE / anteriores (4 GB) | Não recomendado para LLM no aparelho | — | — |
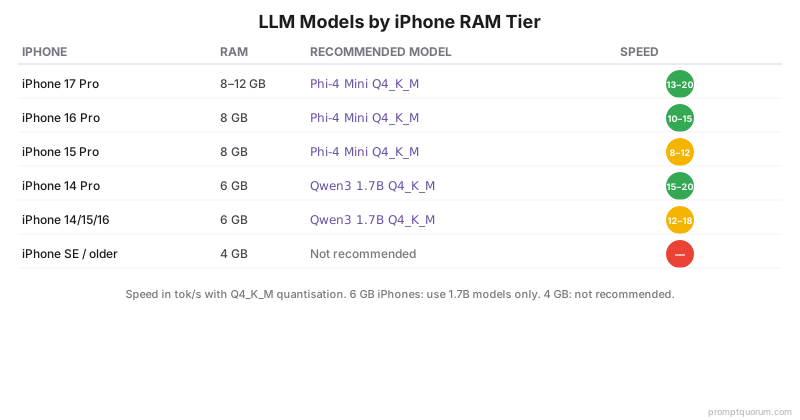
💡Dica: Para iPhones mais antigos de 6 GB, o Qwen3 1.7B ou o SmolLM 2 1.7B (HuggingFace) são escolhas sensatas em 2026; o Qwen3.5 2B e o Gemma 4 E2B são opções mais novas na mesma faixa de tamanho. Modelos tão pequenos geram respostas curtas coerentes (1–3 parágrafos), mas têm dificuldade com raciocínio em várias etapas. Não instale o Phi-4 Mini em um iPhone de 6 GB — nominalmente ele cabe, mas o iOS vai encerrar o app com qualquer pressão de memória. Os números de velocidade da tabela são faixas indicativas arredondadas para o Phi-4 Mini, o Llama 3.2 3B e o Qwen3 1.7B, sem vínculo com uma versão do app ou data de teste; Gemma 4 e Qwen3.5 não têm números aqui. As páginas de produto da Apple não informam a RAM dos iPhones: os valores de RAM aqui são especificações amplamente divulgadas, e os ~12 GB do 18 Pro vêm de reportagens da imprensa.
Consumo de bateria e limitação térmica
A inferência de LLM no iPhone exige muito da CPU/GPU e gera calor. Como referência aproximada (aproximação de orientação, não uma medição do PromptQuorum), a inferência ativa consome ~3–5 W; a geração contínua limita o desempenho do chip e pode esgotar a bateria em cerca de 20–30% por hora no iPhone 16 Pro.
- Consumo de bateria (chat ativo, indicativo): ~20–30% por hora no iPhone 16 Pro executando o Phi-4 Mini.
- A geração contínua pode acionar a limitação térmica. Quando o chip esquenta, o iOS reduz o clock e os tokens/seg caem. Quando isso começa e quanta velocidade você perde depende do aparelho, da capinha, do carregamento e da temperatura ambiente; o PromptQuorum não mediu isso. Deixar o celular esfriar restaura a velocidade.
- Como reduzir: deixe o iPhone com a tela para cima sobre uma superfície dura (não na mão nem no bolso) durante sessões longas de inferência para facilitar a dissipação do calor. Uma capinha com dissipador passivo ajuda, mas raramente é necessária em interações curtas.
- Consumo fantasma: se você deixar um app de chat aberto em segundo plano depois da geração, a RAM continua alocada, mas nenhuma inferência roda — o impacto na bateria é mínimo. Fechar o app por completo libera os ~3 GB de RAM.
- Carregamento MagSafe durante a inferência: carregar o aparelho durante a geração pode aumentar o calor; se o celular esquentar, pause o carregamento ou a geração, ou carregue depois.
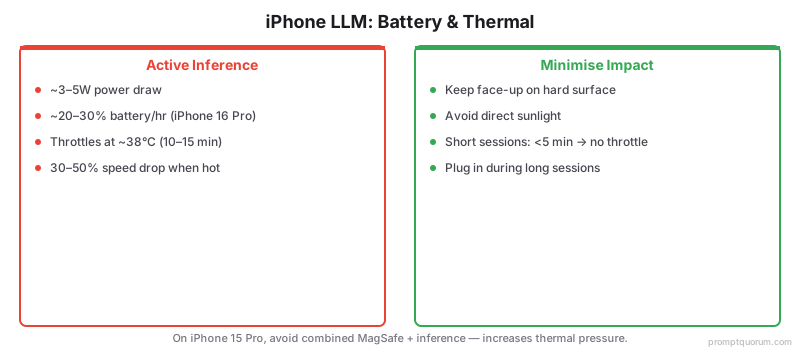
⚠️Aviso: Não rode inferência de LLM no iPhone sob sol direto nem dentro de um carro quente. Sob sol direto ou dentro de um carro quente, o chip pode atingir os limites térmicos mais cedo, o que pode ativar a limitação de desempenho e o aviso "O iPhone precisa esfriar" da Apple. Normalmente a geração fica mais lenta, em vez de o app fechar.
iOS Shortcuts, Siri e sideloading
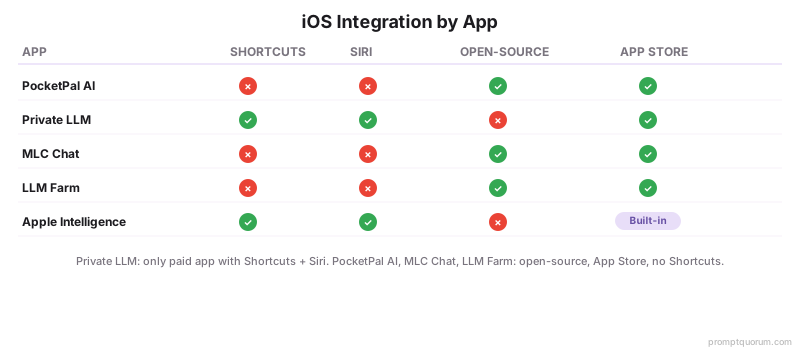
A integração com o iOS varia bastante conforme o app. O Private LLM e o Locally AI suportam o Shortcuts; o PocketPal AI, o Google AI Edge Gallery e o MLC Chat são apps de chat independentes, sem integração com Shortcuts ou Siri mencionada no README ou na ficha da App Store.
Atalho do Private LLM: resumir o texto selecionado
“1. Ação: "Obter Texto Selecionado" (entrada pela Folha de Compartilhamento do iOS). 2. Ação: geração de texto do Private LLM (nas ações de Shortcuts do app Private LLM) → Prompt: "Resuma o texto a seguir em três tópicos: [Texto Selecionado]" → escolha um modelo instalado no app. 3. Ação: "Mostrar Resultado" ou "Copiar para a Área de Transferência". Adicione à Folha de Compartilhamento para rodar sobre qualquer texto selecionado em qualquer app, sem WiFi depois que o modelo estiver baixado. Os nomes das ações seguem a descrição do desenvolvedor e podem variar conforme a versão do app.”
Atalho do Apple Intelligence: reescrever o tom
“1. Ação: "Obter Área de Transferência". 2. Ação: "Usar Modelo" → Modelo: No Aparelho → Prompt: "Reescreva isto em um tom profissional e conciso: [Área de Transferência]". 3. Ação: "Copiar para a Área de Transferência". Atribua a um widget da Tela Bloqueada para reescrever com um toque qualquer coisa que você copiar.”
- O Private LLM se conecta ao Shortcuts e à Siri, segundo o desenvolvedor, e pode repassar respostas a apps que suportam x-callback-url. É o mais nativo do iOS entre os apps de chat aqui.
- O Locally AI expõe uma ação de Shortcuts de graça e pode encaminhar um atalho ao modelo de base no dispositivo da Apple por meio da integração com o framework Foundation Models — sem comando de voz pela Siri, mas com automação por Shortcuts sem pagar.
- O PocketPal AI é um app de chat independente — o README não menciona ação de Shortcuts nem integração com a Siri. Você abre o app e conversa.
- O Google AI Edge Gallery é um app independente de chat e demonstração — a ficha da App Store não menciona ação de Shortcuts nem integração com a Siri.
- O MLC Chat é um app de referência do projeto MLC LLM — integração mínima com o iOS e nenhuma atualização para iPhone desde setembro de 2024. Sem ação de Shortcuts.
- O LLM Farm atualmente não está na App Store e, quando compilado a partir do código-fonte, também não tem ação de Shortcuts.
- O Apple Intelligence se integra ao iOS Shortcuts pela ação "Usar Modelo" (iOS 18.4+, ampliada no iOS 26 junto com o framework Foundation Models). Ela encaminha um prompt ao modelo no aparelho, ao Private Cloud Compute ou ao ChatGPT (configurável). A saída no aparelho pode ser encadeada em outras ações do Shortcuts.
- Sideloading: PocketPal AI, Private LLM, Locally AI, Google AI Edge Gallery e MLC Chat estão na App Store e não exigem sideloading nem jailbreak; o Apple Intelligence é integrado ao iOS. O LLM Farm é a exceção — instalá-lo agora exige compilar o código-fonte no Xcode. Na UE existem lojas de apps alternativas sob o DMA, mas quais apps elas oferecem fica a critério de cada desenvolvedor; por isso, instale pelo canal oficial do desenvolvedor — nenhum desses apps exige uma loja alternativa.
💡Dica: Para uso com as mãos livres ao dirigir ou cozinhar, a integração com a Siri do Private LLM é o único app de chat deste guia cujo desenvolvedor lista integração com a Siri, o que permite usá-lo sem tocar no celular. O Apple Intelligence suporta voz pela Siri, mas só para tarefas do sistema (escrever, resumir, ações de app) — ele não oferece perguntas e respostas gerais como os apps de chat.
Erros comuns
- Instalar um modelo maior do que a RAM do seu iPhone aguenta. Um modelo 7B em um iPhone de 8 GB costuma ser lento demais para chat e pode ser encerrado pelo iOS quando ele retoma a memória para outro app; meça antes com o benchmark integrado do PocketPal AI. Fique com o modelo recomendado para o seu nível de iPhone (3B–4B para aparelhos de 8 GB, 1.7B para os de 6 GB).
- Esperar a qualidade da IA na nuvem dos modelos no aparelho. O Phi-4 Mini (3.8B) impressiona para o tamanho, mas não é o GPT-5.5. Use-o para chat, resumos, rascunhos e perguntas rápidas — não para raciocínio em várias etapas, geração de código complexo ou escrita criativa cheia de nuances.
- Rodar inferência sob sol direto ou dentro de um carro quente. A limitação térmica pode entrar rapidamente, a geração fica mais lenta e pode aparecer o aviso "O iPhone precisa esfriar". Rode a inferência em temperatura ambiente.
- Deixar 3 ou mais apps de chat instalados, cada um com modelos de 3 GB. Você vai gastar ~10 GB de armazenamento com modelos duplicados. Escolha um app e um modelo; desinstale os outros até ter certeza de que precisa deles.
- Achar que o Apple Intelligence não tem interface de chat nenhuma. Isso valia até o iOS 18, mas desde o iOS 26 apps como o Locally AI conseguem colocar o modelo no aparelho da Apple atrás de uma janela de chat de verdade, pelo framework Foundation Models. As funções de sistema (Ferramentas de Escrita, Resposta Inteligente) continuam não sendo uma interface de chat por si só.
- Procurar o LLM Farm na App Store. Ele atualmente não está na App Store (a análise do LLM Farm do PromptQuorum data a remoção de agosto de 2025). Procurar por ele na App Store é perda de tempo; use o PocketPal AI para o mesmo uso gratuito e flexível, ou compile o LLM Farm a partir do código-fonte no Xcode se precisar especificamente dos controles de mirostat.
- Achar que "grátis" significa sem compras. O PocketPal AI é gratuito para chat local, mas vende conteúdo premium opcional (Pals e "PocketPal Plus"), enquanto o Locally AI e o Google AI Edge Gallery não listam compras dentro do app. Confira a seção de compras dentro do app na ficha antes de instalar (a ficha do PocketPal AI na App Store dos EUA mostrava classificação etária 18+ em 2026-10-23).
- Julgar um modelo só por uma tabela de velocidade. As faixas de tokens/seg deste guia são indicativas, e modelos mais novos, como o Gemma 4 e o Qwen3.5, não estão nelas. Rode o mesmo prompt em dois modelos no benchmark do PocketPal AI antes de apagar o que você já baixou.
Fontes
- PocketPal AI — github.com/a-ghorbani/pocketpal-ai (README, licença MIT, release v1.20.1 de 19 out 2026) e a ficha da App Store (histórico de versões, compras dentro do app, classificação etária, iOS 15.1+). Lido em 2026-10-23.
- Private LLM — ficha da App Store (v1.9.16, $4.99, iOS 17.0+, Compartilhamento em Família) e privatellm.app (Siri e Shortcuts, lista de modelos, uma compra para iPhone, iPad e Mac). Lido em 2026-10-23.
- Locally AI — ficha da App Store (v1.66.0, grátis, Element Labs Inc, iOS 18.1+; equipe da LM Studio) e lmstudio.ai/locally (LM Link). Lido em 2026-10-23.
- Google AI Edge Gallery — ficha da App Store (v1.0.13, grátis, iOS 17.0+, Gemma 4, Agent Skills, Modo de Raciocínio), github.com/google-ai-edge/gallery e a página do Google sobre o Gemma 4 no LiteRT-LM (tamanhos de arquivo e memória do E2B/E4B, números do fabricante). Lido em 2026-10-23.
- MLC Chat / projeto MLC LLM — ficha da App Store (v1.6, 27 set 2024, histórico de versões), llm.mlc.ai e github.com/mlc-ai/mlc-llm (repositório do motor). Lido em 2026-10-23.
- LLM Farm — github.com/guinmoon/LLMFarm (README: "temporariamente indisponível" no TestFlight e na App Store; release 1.4.3 de 27 jan 2025; último envio em 30 jan 2026) e a análise do LLM Farm pelo PromptQuorum sobre a remoção em agosto de 2025. Lido em 2026-10-23.
- Apple Intelligence e modelos de base no aparelho — Apple Machine Learning Research, o guia de novidades do iOS 27 para desenvolvedores (framework Foundation Models) e a página do iPhone 18 Pro (A20 Pro, Neural Engine de 16 núcleos duplo, beta da Siri AI, sem valor de RAM) e a página do iPhone Duo. Lido em 2026-10-23.
- Série pequena Qwen3.5 (0.8B–9B, março de 2026) — resumo da Artificial Analysis.
Perguntas frequentes
O iPhone consegue mesmo rodar um modelo 7B?
Tecnicamente sim, no iPhone 15 Pro e modelos mais recentes (8 GB de RAM), mas não a uma velocidade utilizável. Um modelo 7B Q4 no iPhone 16 Pro costuma ser lento demais para um chat confortável (indicativo). O iOS também tende a encerrar o app quando outros apps precisam de memória. Use modelos 3B–4B (Phi-4 Mini, Llama 3.2 3B, Gemma 3 4B) para o chat no aparelho do dia a dia. Para qualidade de 7B+, conecte-se remotamente a um Mac ou PC em casa rodando o Ollama.
A IA local gasta a bateria do meu iPhone?
Sim — a inferência ativa normalmente consome ~3–5 W e, como referência aproximada e indicativa, pode esgotar a bateria em cerca de 20–30% por hora no iPhone 16 Pro. Para uso ocasional (alguns prompts), o impacto é pequeno. Em uso contínuo (conversa longa, várias tarefas de resumo) a bateria descarrega rápido; carregar durante a geração pode aumentar o calor, então pause a geração se o celular esquentar. O modelo parado na RAM, sem inferência rodando, tem impacto desprezível na bateria.
Meu iPhone vai esquentar usando IA local?
Sim, pode esquentar, principalmente em geração contínua longa. O iOS reduz o clock quando o chip esquenta, o que diminui os tokens/seg; quando e quanto isso acontece varia conforme o aparelho, a capinha, o carregamento e a temperatura ambiente, e o PromptQuorum não mediu isso. Para minimizar isso: deixe o iPhone com a tela para cima sobre uma superfície dura (não na mão) em sessões longas e evite o sol direto. Interações curtas costumam causar pouco calor perceptível.
Dá para usar a Siri com um modelo local?
Sim, com o Private LLM ($4.99 pagamento único). O desenvolvedor afirma que ele se conecta diretamente à Siri e ao Shortcuts, então um prompt pode ser encaminhado ao modelo no aparelho sem conexão à internet. PocketPal AI, Locally AI, Google AI Edge Gallery e MLC Chat não mencionam integração de voz com a Siri, embora o Locally AI suporte automação por Shortcuts. O Apple Intelligence se integra à Siri, mas só para tarefas do sistema (escrever, resumir, ações de app), não para perguntas e respostas gerais; a Siri AI é um recurso beta separado do iOS 27, primeiro em inglês e inicialmente fora da UE.
Esses apps funcionam no iPhone SE ou em iPhones mais antigos?
Com limitações. O iPhone SE e o iPhone 13 / 12 (4 GB de RAM) estão abaixo do limite prático para LLMs no aparelho em 2026. O iPhone 14 / 15 (não Pro, 6 GB de RAM) consegue rodar modelos 1.7B (Qwen3 1.7B, SmolLM 2 1.7B), mas não 3B+. O iPhone 13 Pro e o 14 Pro (6 GB de RAM) também ficam nos 1.7B; o iPhone 15 Pro (8 GB de RAM) roda modelos 3B como o Phi-4 Mini a cerca de 8–12 tokens/seg (indicativo). Para iPhones mais antigos, o melhor caminho é se conectar remotamente a um Mac ou PC em casa.
Dá para sincronizar o histórico de chat entre o iPhone e o Mac?
Não no PocketPal AI, no Private LLM, no Google AI Edge Gallery nem no MLC Chat — o histórico de chat fica guardado localmente em cada aparelho, sem sincronização pelo iCloud. O Private LLM e o Locally AI também rodam nativamente no Mac, mas o histórico continua sem sincronizar entre as cópias do iPhone e do Mac. Para ter o histórico de chat entre aparelhos, o caminho prático é rodar o Open WebUI em um Mac em casa e acessá-lo pelos navegadores do iPhone e do Mac — o Open WebUI guarda o histórico de chat no servidor.
Esses apps estão disponíveis fora da App Store?
O PocketPal AI é de código aberto e pode ser compilado a partir do código-fonte pelo Xcode, mas a versão da App Store é a distribuição padrão. O LLM Farm é a exceção que agora exige compilar o código-fonte — ele atualmente não está na App Store nem no TestFlight (o README diz "temporariamente indisponível"). Private LLM, Locally AI, Google AI Edge Gallery e MLC Chat estão só na App Store. Na UE existem lojas de apps alternativas sob o DMA, mas quais apps elas oferecem fica a critério de cada desenvolvedor; por isso, instale pelo canal oficial do desenvolvedor — nenhum desses apps exige uma loja alternativa.
Algum deles exige jailbreak?
Não. PocketPal AI, Private LLM, Locally AI, Google AI Edge Gallery, MLC Chat e Apple Intelligence rodam todos no iOS original. Compilar o LLM Farm a partir do código-fonte no Xcode também não exige jailbreak — usa o sideloading padrão de desenvolvedor, não uma exploração de jailbreak. O jailbreak não é necessário nem recomendado para nenhum desses apps.
Dá para usar IA local no iOS Shortcuts?
Sim, pelo Private LLM (suas ações de Shortcuts), pelo Locally AI (uma ação de Shortcuts gratuita) ou pelo Apple Intelligence (a ação "Usar Modelo", iOS 18.4+, ampliada no iOS 26). PocketPal AI, Google AI Edge Gallery e MLC Chat não mencionam ações de Shortcuts. Entre os apps comparados aqui, o Locally AI é a única opção gratuita que lista suporte a Shortcuts e acesso ao modelo no aparelho da própria Apple.
Como a IA local se compara ao app do ChatGPT no iPhone?
Os modelos no aparelho (Phi-4 Mini, Llama 3.2 3B) continuam atrás dos modelos de ponta na nuvem em raciocínio complexo, conhecimento geral do mundo e tarefas multimodais, mas são mais rápidos em consultas simples (sem ida e volta pela rede) e, segundo a documentação de cada app, mantêm o chat no aparelho. A troca honesta: IA local para tarefas rotineiras e privadas; ChatGPT ou outro app na nuvem para as perguntas difíceis de vez em quando. Muitos usuários em 2026 mantêm os dois e escolhem a cada consulta.
O LLM Farm ainda é seguro de usar se não está mais na App Store?
O código-fonte é público no GitHub e ainda recebe atividade de issues em 2026, mas a última versão (1.4.3) saiu em 27 de janeiro de 2025 e o último envio de código foi em 30 de janeiro de 2026, então ele pode estar sem manutenção. Compilado a partir do código-fonte e instalado por sideloading, ele também deixa de passar pela revisão da App Store da Apple. Se você não precisa especificamente dos controles de amostragem mirostat, o PocketPal AI cobre o mesmo uso gratuito, flexível e de código aberto, continuando na App Store com a revisão padrão da Apple.
Quais desses apps de iPhone são gratuitos?
O PocketPal AI é gratuito (licença MIT), com compras opcionais dentro do app para Pals premium e "PocketPal Plus". O Locally AI e o Google AI Edge Gallery são gratuitos, sem compras dentro do app listadas. O MLC Chat é gratuito. O LLM Farm é gratuito, mas precisa ser compilado a partir do código-fonte. O Private LLM custa $4.99 pagamento único, sem compras dentro do app listadas. O Apple Intelligence é integrado ao iOS. Os preços foram lidos na App Store dos EUA em 2026-10-23 e podem variar conforme o país.
O iPhone Duo ou o iPhone 18 Pro roda um LLM local offline?
Em princípio sim: os dois usam o chip A20 Pro da Apple, e os apps deste guia rodam em qualquer iPhone que atenda ao iOS mínimo deles. O que define o tamanho do modelo é a RAM, e as páginas do iPhone 18 Pro e do iPhone Duo da Apple não informam a RAM; reportagens da imprensa falam em 12 GB no iPhone 18 Pro, o que não está confirmado. O PromptQuorum não tem velocidades medidas para nenhum dos dois. Instale o PocketPal AI e rode o benchmark integrado para ver o que o seu aparelho realmente faz.
Esses apps funcionam no iPad?
Sim, a maioria. PocketPal AI (iPadOS 15.1+, suporte completo a iPad segundo o README), Private LLM (iPadOS 17.0+) e Locally AI (iPadOS 18.1+) listam suporte a iPad. A ficha do Google AI Edge Gallery exige iOS 17.0 ou superior; confira a página para o seu iPad. Como no iPhone, é a RAM que define quais modelos cabem. Para dicas específicas de iPad, veja Como executar IA em um tablet.
Por que o LLM Farm sumiu da App Store?
O README do projeto diz: "The app is temporarily unavailable in TestFlight and Appstore." O PromptQuorum não encontrou um motivo público para a remoção, então qualquer explicação que você leia por aí não está confirmada (veja a análise do LLM Farm). O código-fonte continua público, mas a última versão foi a 1.4.3, de 27 de janeiro de 2025. Para uma alternativa gratuita e instalável pela App Store, use o PocketPal AI ou o Locally AI.
Existe um app do Ollama para iPhone?
A página de download do Ollama lista macOS, Windows e Linux, e nenhum app para iPhone. Para usar modelos do Ollama ou do LM Studio a partir de um iPhone, rode o servidor em um Mac ou PC e conecte-se por um app cliente; o Locally AI oferece o LM Link, que a LM Studio descreve como uma conexão criptografada com o LM Studio em um Mac. Para modelos que rodam inteiramente no celular, use os apps deste guia.
Devo baixar o Gemma 4 ou o Phi-4 Mini?
O PromptQuorum não tem um benchmark direto entre os dois no iPhone. Fatos que ajudam: o Gemma 4 E2B e o E4B são os modelos do Google do tamanho de um celular (cerca de 2.58 GB e 3.65 GB como arquivos LiteRT-LM no Google AI Edge Gallery; o Locally AI também lista o Gemma 4), enquanto o Phi-4 Mini (3.8B Q4_K_M, ~2.7 GB) é o modelo que as velocidades deste guia usam. Em um iPhone de 8 GB, teste os dois com os seus próprios prompts e compare os tokens/seg no benchmark do PocketPal AI; em um iPhone de 6 GB, fique nos modelos da faixa de 1.7B.