ما هي LiteLLM؟
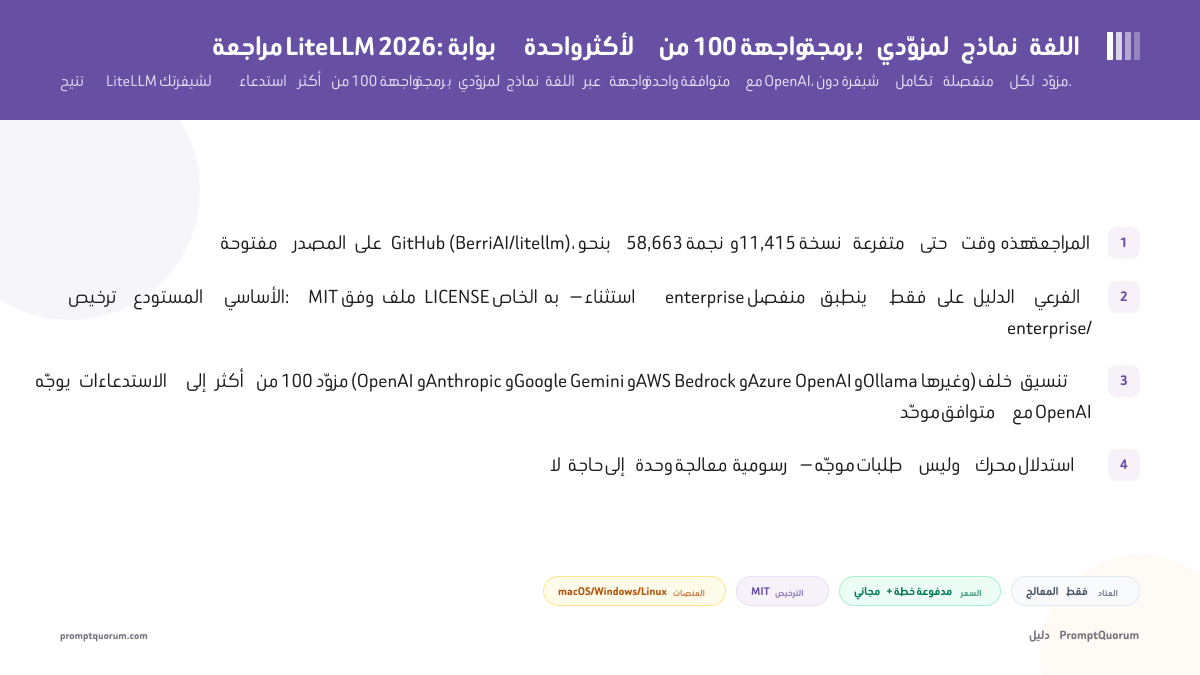
LiteLLM بوابة تترجم تنسيق طلب واحد متوافق مع OpenAI إلى استدعاءات لأكثر من 100 واجهة برمجة مختلفة لمزوّدي نماذج اللغة. يصفها وصف مستودع GitHub الخاص بها بأنها "أسرع وأخف بوابة ذكاء اصطناعي"، مبنية بنواة Rust وحزمة Python فوقها — وهو تحوّل عن التنفيذ القائم بالكامل على Python في السنوات الأولى للمشروع. فبدلاً من كتابة شيفرة عميل منفصلة لواجهة برمجة OpenAI وواجهة برمجة Anthropic وخادم Ollama محلي، يستدعي التطبيق LiteLLM مرة واحدة، وتقوم LiteLLM بإعادة توجيه الطلب إلى المزوّد المُهيّأ لاسم ذلك النموذج.
- الوظيفة الأساسية: استقبال طلب بتنسيق
chat/completionsالخاص بـ OpenAI (أو بالتنسيق الأصلي للمزوّد المستهدف)، وإعادة توجيهه إلى المزوّد المُهيّأ، وإرجاع استجابة موحّدة - وضعا وصول: حزمة Python باسم
litellm، تُستورد مباشرةً في شيفرة التطبيق، وLiteLLM Proxy Server، وهي خدمة مستقلة تستدعيها تطبيقات أخرى عبر HTTP - الجهة المطوّرة: BerriAI، المؤسسة الواقفة خلف مستودع github.com/BerriAI/litellm
- ليست بيئة تشغيل نموذج: لا تحمّل LiteLLM أوزان النموذج ولا تُجري الاستدلال بنفسها — بل توجّه الطلبات إلى المزوّدين الذين يقومون بذلك، بما في ذلك واجهات برمجة سحابية وخوادم محلية مثل Ollama أو vLLM
- ميزات على مستوى الإنتاج وفق التوثيق: مفاتيح API افتراضية، ميزانيات إنفاق لكل مفتاح ولكل مستخدم، تحديد معدل الطلبات، موازنة الحِمل بين عدة عمليات نشر لنفس النموذج، وتراجع احتياطي تلقائي عند حدوث خطأ لدى أحد المزوّدين
ماذا يمكنك أن تفعل باستخدام LiteLLM؟
تغطي مجموعة ميزات LiteLLM توجيه الطلبات والتحكم بالتكاليف والموثوقية — وهي الأجزاء التي تزداد صعوبتها في تشغيل تطبيق قائم على نماذج اللغة كلما أضفت مزوّدين ومستخدمين، وفق توثيق LiteLLM نفسه.
- واجهة برمجة موحّدة — أرسل طلبًا بتنسيق OpenAI؛ تترجمه LiteLLM إلى التنسيق الأصلي الذي يتطلبه مزوّد النموذج المستهدف، وتُوحّد الاستجابة قبل إعادتها
- التوجيه وموازنة الحِمل — توزيع حركة المرور بين عدة عمليات نشر لنفس النموذج (مثل عدة مناطق لـ Azure OpenAI) لتجنّب نقطة فشل واحدة أو الوصول إلى سقف تحديد معدل الطلبات
- منطق التراجع الاحتياطي وإعادة المحاولة — إعادة محاولة طلب فاشل تلقائيًا مع مزوّد أو عملية نشر نموذج أخرى بدلاً من إظهار الخطأ للمستخدم النهائي
- تتبع التكاليف والميزانيات — تسجيل الإنفاق لكل مفتاح API أو مستخدم أو فريق، وتحديد حدود ميزانية صارمة تمنع الطلبات الإضافية عند تجاوزها
- تحديد معدل الطلبات — تحديد عدد الطلبات في الدقيقة/عدد الرموز لكل مفتاح أو مستخدم، مع تطبيقه بشكل متسق عبر عدة نُسخ من الوكيل بواسطة Redis
- حواجز حماية وتسجيل — نقاط ربط للإشراف على المحتوى وتكاملات المراقبة، بالإضافة إلى تسجيل منظّم للطلبات/الاستجابات لأغراض التدقيق
- لوحة تحكم إدارية — واجهة ويب (تُقدَّم على
/uiفي الوكيل) لإدارة المفاتيح الافتراضية، وعرض الإنفاق، وتهيئة النماذج دون تعديل ملف التهيئة مباشرةً - تعمل أيضًا مع بيئات التشغيل المحلية — يمكن لنفس طبقة التوجيه التي تستدعي OpenAI أو Anthropic أن تشير بالمثل إلى نقطة نهاية محلية من Ollama أو vLLM، مما يتيح لبوابة واحدة مزج النماذج السحابية والمحلية
أمثلة استخدام: طريقتان لاستخدام LiteLLM
هذه سير عمل ملموسة مبنية على مسارات التثبيت الموثّقة لـ LiteLLM أعلاه — وليست حالات استخدام افتراضية.
استدعاء عدة مزوّدين من سكربت Python واحد
ثبّت الحزمة (pip install litellm)، ثم استبدل الاستدعاءات المباشرة لعملاء openai أو anthropic أو الخاصة بمزوّد معيّن بـ `litellm.completion(model="gpt-4o", messages=[...]) أو litellm.completion(model="claude-opus-4", messages=[...])`. يُرجع كلا الاستدعاءين نفس شكل الاستجابة الموحّد، لذا فإن تبديل المزوّد يقتصر على تغيير سطر واحد في اسم النموذج، لا إعادة كتابة كاملة.
تشغيل بوابة مستضافة ذاتيًا لفريق
انشر LiteLLM Proxy Server (عبر Docker أو Helm)، وحدّد ملف config.yaml بقائمة model_list تربط أسماء نماذج سهلة الفهم بعمليات نشر فعلية لدى المزوّدين، وأصدر مفتاح API افتراضيًا لكل مطوّر أو تطبيق. الآن يستدعي كل تطبيق نقطة نهاية داخلية واحدة بدلاً من الاحتفاظ بمفاتيح OpenAI/Anthropic الخاصة به، ويُتتبَّع الإنفاق مركزيًا في لوحة الإدارة.
مزج النماذج السحابية والمحلية خلف نقطة نهاية واحدة
أضف نموذجًا سحابيًا (مثل openai/gpt-4o) ونموذجًا محليًا يُقدَّم عبر Ollama أو vLLM إلى نفس model_list في config.yaml. وجّه حركة المرور الاعتيادية أو الحساسة من الناحية الخصوصية إلى النموذج المحلي، وارفع المستوى إلى النموذج السحابي فقط عند الحاجة، دون تغيير طريقة تواصل التطبيق المستدعي مع البوابة.
تثبيت LiteLLM: SDK والوكيل وDocker
LiteLLM إطار عمل وبوابة مستضافة ذاتيًا، وليست تطبيقًا قابلًا للتنزيل للمستخدم النهائي — لا يوجد مثبّت "لجلبه" من متجر تطبيقات. فيما يلي أوامر التثبيت والبدء السريع الفعلية، وفق توثيق LiteLLM نفسه ودليل البدء السريع عبر Docker؛ تحقّق دائمًا من التوثيق مباشرةً قبل النشر، إذ قد تتغيّر الخيارات الدقيقة وعلامات الصور بين الإصدارات.
حزمة Python
- الأمر:
pip install litellm(أوuv add litellm)
Proxy Server (عبر pip)
- الأمر:
- `pip install 'litellm[proxy]'
ثمlitellm --model gpt-4o`
Proxy Server (عبر Docker)
- الأمر:
docker run -v $(pwd)/config.yaml:/app/config.yaml -e OPENAI_API_KEY=<key> -e LITELLM_MASTER_KEY=sk-1234 -p 4000:4000 docker.litellm.ai/berriai/litellm:latest --config /app/config.yaml
Helm (Kubernetes)
- الأمر:
helm install litellm oci://ghcr.io/berriai/litellm-helm -f values.yaml
AWS ECS Fargate
- الأمر:
- وحدة Terraform رسمية باسم
BerriAI/litellm/aws(تُهيّئ VPC وAurora PostgreSQL وElastiCache Redis وALB وECS)
Google Cloud Run
- الأمر:
- وحدة Terraform رسمية باسم
BerriAI/litellm/google(تُهيّئ Cloud SQL وMemorystore Redis وGCS وموازن تحميل HTTPS)
يستخدم الوكيل المنفذ 4000 افتراضيًا، مع لوحة التحكم الإدارية على http://localhost:4000/ui (بيانات الدخول الافتراضية: اسم المستخدم admin، وكلمة المرور مطابقة لـ LITELLM_MASTER_KEY الخاص بك). يحتاج ملف config.yaml الأدنى إلى مصفوفة model_list تربط model_name بـ litellm_params (سلسلة النموذج الفعلية لدى المزوّد ومفتاح API الخاص بها) — راجع دليل البدء السريع للوكيل لمثال كامل. يوفّر Render وRailway أيضًا أزرار نشر بنقرة واحدة للوكيل، وفق توثيق النشر الخاص بـ LiteLLM.
أسعار LiteLLM: هل هي مجانية فعلًا؟
حزمة SDK مفتوحة المصدر وProxy Server مجانيتان — تدفع فقط مقابل استدعاءات واجهة برمجة المزوّد الأساسي التي توجّهها عبر LiteLLM، بالإضافة إلى تكاليف استضافتك الخاصة. لا تفرض LiteLLM نفسها رسومًا لكل طلب أو لكل رمز (token) في المسار مفتوح المصدر. توجد فئة مدفوعة منفصلة باسم LiteLLM Enterprise على litellm.ai/enterprise، تشمل تسجيل الدخول الموحّد (SSO) وطلبات الميزات ذات الأولوية والدعم المخصص، وفق موقع المشروع نفسه — لم تجد هذه المراجعة أسعارًا منشورة لفئة Enterprise، وتوصي بالتواصل مباشرةً مع LiteLLM للحصول على عرض سعر.
- حزمة SDK مفتوحة المصدر وProxy Server: بلا رسوم ترخيص، والمستودع الأساسي مرخّص بموجب MIT (راجع ملاحظة الترخيص أدناه)
- ستظل تدفع للمزوّد الذي توجّه إليه — لا تُخفّض LiteLLM أسعار واجهات برمجة OpenAI أو Anthropic أو Bedrock، بل توحّدها وتسجّلها فقط
- استضافة الوكيل ذاتيًا لها تكلفة بنية تحتية خاصة بها: خادم أو مضيف حاويات، بالإضافة إلى PostgreSQL وRedis للاستخدام في بيئة الإنتاج
- تضيف LiteLLM Enterprise تسجيل الدخول الموحّد ودعمًا ذا أولوية وميزات أخرى للأعمال فوق نفس النواة مفتوحة المصدر، وفق litellm.ai/enterprise — الأسعار غير منشورة وتتطلب التواصل مع الشركة
- تُحتسب أسعار Enterprise سنويًا وتُحدَّد وفق سعة الطلبات في البوابة ومعمارية النشر واحتياجات الدعم، وليس لكل رمز (token) أبدًا، بحسب litellm.ai/pricing؛ يتوفر مفتاح تجريبي لـ Enterprise لمدة 30 يومًا، وتُقدَّم عروض الأسعار عبر فريق المبيعات
- تسجيل الدخول الموحّد (SSO) مجاني لما يصل إلى 5 مستخدمين اعتبارًا من الإصدار v1.76.0، وما يتجاوز ذلك يتطلب ترخيص Enterprise، بحسب وثائق SSO في LiteLLM
LiteLLM مقابل vLLM مقابل LocalAI
تحل LiteLLM وvLLM وLocalAI مشكلات مختلفة يسهل الخلط بينها لأن الثلاثة تعرض واجهة برمجة متوافقة مع OpenAI. توجّه LiteLLM الطلبات إلى نماذج تعمل في مكان آخر؛ بينما تُشغّل vLLM وLocalAI أوزان النموذج بنفسها.
الجانب | LiteLLM | ||
|---|---|---|---|
| ماذا تفعل | توجّه الطلبات إلى المزوّدين | تُقدّم النماذج بنفسها | تُقدّم النماذج بنفسها |
| تشغيل أوزان النموذج | لا | نعم | نعم |
| الترخيص | MIT (+ استثناء enterprise) | Apache-2.0 | MIT |
| الحاجة لوحدة معالجة رسومية | لا (موجّه فقط) | نعم، للتقديم الفوري | حسب النموذج |
| الأنسب لـ | التوجيه متعدد المزوّدين وتتبع الإنفاق | تقديم مستضاف ذاتيًا بإنتاجية عالية | واجهة برمجة واحدة مستضافة ذاتيًا ومتوافقة مع OpenAI |
عادةً ما تُستخدم هذه الأدوات معًا وليس كبدائل لبعضها: يمكن لـ LiteLLM أن تقف أمام عملية نشر vLLM أو LocalAI كطبقة توجيه وتتبع تكاليف، بينما تقوم vLLM أو LocalAI بالاستدلال الفعلي للنموذج. راجع المقالين المخصصين شرح vLLM وشرح LocalAI لمزيد من التفاصيل عن الأداتين.
لمن تناسب LiteLLM؟
تعتمد ملاءمة LiteLLM على ما إذا كان تطبيقك يستدعي بالفعل، أو يخطط لاستدعاء، أكثر من مزوّد واحد لنماذج اللغة — فتطبيق أحادي المزوّد يحصل على فائدة أقل من طبقة توجيه.
استخدم LiteLLM إذا
- كان تطبيقك يستدعي مزوّدَين أو أكثر لنماذج اللغة (أو يخطط لذلك) وتريد مسار شيفرة واحد بدلاً من شيفرة تكامل لكل مزوّد
- كنت بحاجة إلى تتبع مركزي للتكاليف وميزانيات لكل مفتاح أو مستخدم عبر عدة تطبيقات أو فرق أو عملاء
- كنت تريد تراجعًا احتياطيًا تلقائيًا إلى مزوّد ثانٍ عندما يفشل الأول أو يحدّ من معدل الطلبات
- كنت تريد مزج نماذج سحابية مع نموذج مستضاف محليًا (عبر Ollama أو vLLM) خلف نفس نقطة النهاية
- كنت تريد أن تكون طبقة التوجيه مفتوحة المصدر (نواة MIT) بدلاً من خدمة مغلقة ومُستضافة فقط
انتظر، أو ابحث عن بديل، إذا
- كان تطبيقك يستدعي مزوّدًا واحدًا فقط ولا تخطط لإضافة مزوّد ثانٍ — إذ تضيف طبقة التوجيه سطحًا تشغيليًا (وكيل يجب تشغيله، أو اعتمادية SDK) دون فائدة فورية
- كنت تحتاج إلى محرك تقديم نماذج، لا موجّه — فأنت تحتاج فعليًا إلى شيء يُشغّل أوزان النموذج (راجع vLLM أو LocalAI)
- كنت تريد خدمة توجيه مُدارة بالكامل وبلا تشغيل ذاتي، بدلاً من وكيل مستضاف ذاتيًا — يوفّر موجّه مُستضاف مثل OpenRouter عبء تشغيل PostgreSQL/Redis، على حساب المرور عبر طرف ثالث
- كان قرار الترخيص يعتمد تحديدًا على شيفرة داخل الدليل
enterprise/— اقرأenterprise/LICENSEمباشرةً بدلاً من افتراض أن ترخيص MIT للمستودع بأكمله ينطبق هناك
LiteLLM مقابل بوابات وأطر عمل أخرى
تنتمي LiteLLM إلى فئة الموجّهات/البوابات في دليل برمجيات نماذج اللغة المحلية من PromptQuorum، والذي يضم ثلاث مراجعات مخصصة أخرى مذكورة أولًا أدناه. أما بقية المقارنات فمصدرها أدوات مجاورة في جزء "Run & Serve" نفسه من الدليل، إضافةً إلى بديل مستضاف معروف خارج الدليل.
- Plano — وكيل ذكاء اصطناعي مستضاف ذاتيًا قائم على Envoy ومستوى بيانات للتطبيقات القائمة على الوكلاء، مع توجيه LLM وقابلية المراقبة وحواجز الحماية (Apache-2.0).
- ClawRouter — موجّه LLM مستضاف ذاتيًا مصمَّم للوكلاء، يتخذ قرارات التوجيه محليًا بين النماذج المتقدمة والنماذج المفتوحة الأوزان المجانية (MIT).
- AIClient2API — وكيل مستضاف ذاتيًا يحوّل بروتوكولات عملاء Gemini CLI وCodex وGrok وKiro وAntigravity إلى واجهة برمجة واحدة متوافقة مع OpenAI (GPL-3.0).
- vLLM — محرك استدلال مستضاف ذاتيًا يُقدّم أوزان النموذج فعليًا (يتطلب وحدة معالجة رسومية)؛ غالبًا ما يُستخدم إلى جانب LiteLLM بدلاً من منافستها، حيث تقف LiteLLM كطبقة توجيه أمام واحد أو أكثر من عمليات نشر vLLM.
- LocalAI — خادم واجهة برمجة مستضاف ذاتيًا ومتوافق مع OpenAI لتشغيل نماذج مفتوحة محليًا؛ يحل مشكلة مختلفة عن LiteLLM (التقديم مقابل التوجيه) لكنه يعرض واجهة برمجة بتنسيق OpenAI مشابهة، وهو مصدر شائع للخلط بين الأداتين.
- LangChain — إطار عمل تطبيقات لبناء تطبيقات مدعومة بنماذج اللغة (سلاسل، عملاء ذكيون، ذاكرة)؛ يمكنه استدعاء LiteLLM (أو أي مزوّد مباشرةً) كطبقة وصوله إلى النماذج بدلاً من استبدال ما تقوم به LiteLLM.
- OpenRouter (خارجية، وغير مدرجة في دليل PromptQuorum) — خدمة توجيه مُستضافة ومُدارة تغطي حالة استخدام متعددة المزوّدين مشابهة لوكيل LiteLLM، لكنها خدمة طرف ثالث تستدعيها بدلاً من بنية تحتية تستضيفها بنفسك؛ تستحق المقارنة المباشرة إذا كنت تريد توجيهًا بلا تشغيل ذاتي بدلاً من تشغيل وكيلك الخاص.
الأخطاء الشائعة عند تقييم LiteLLM
ينشأ معظم اللبس حول LiteLLM من الخلط بينها وبين محرك تقديم نماذج، أو من تبسيط ترخيصها أكثر من اللازم.
الخطأ 1: افتراض أن LiteLLM تُشغّل النماذج بنفسها
LiteLLM موجّه — تعيد توجيه الطلبات إلى واجهات برمجة المزوّدين أو إلى بيئة تشغيل محلية توجّهها إليها (Ollama وvLLM وغيرها). وعلى خلاف vLLM أو LocalAI، فهي لا تحمّل أوزان النماذج ولا تُجري الاستدلال بنفسها.
الخطأ 2: التعامل مع المستودع بأكمله كأنه ببساطة MIT
الشيفرة الأساسية مرخّصة بموجب MIT وفق ملف LICENSE الخاص بالمستودع، لكن المحتوى داخل الدليل الفرعي enterprise/ مرخّص بشكل منفصل بموجب enterprise/LICENSE. تحقّق من الملفات التي تستخدمها فعليًا قبل افتراض انطباق شروط MIT الشاملة.
الخطأ 3: تخطّي PostgreSQL وRedis ثم مواجهة بيانات إنفاق مفقودة أو حدود معدل طلبات غير متسقة
حزمة litellm وحدها لا تحتاج إلى أي قاعدة بيانات. يحتاج Proxy Server المستضاف ذاتيًا إلى PostgreSQL لحفظ المفاتيح الافتراضية وسجلات الإنفاق، وإلى Redis لتحديد معدل طلبات يبقى متسقًا عبر أكثر من نسخة واحدة من الوكيل — تشغيل الوكيل دون أيّ منهما يصلح لاختبار سريع، لكنه يفقد هذه الميزات على نطاق واسع.
الخطأ 4: توقّع أن تُخفّض LiteLLM أسعار واجهات برمجة المزوّدين
تتتبّع LiteLLM وتوحّد التكاليف بين المزوّدين؛ لكنها لا تتفاوض أو تمنح خصومات على أسعار OpenAI أو Anthropic أو Bedrock الأساسية التي تدفعها بالفعل. يأتي التوفير من كون التوجيه/التراجع الاحتياطي يتجنّب إعادة المحاولات المهدَرة والتعطّل بسبب حدود معدل الطلبات، لا من سعر مختلف لكل رمز (token).
الأسئلة الشائعة
ما هي LiteLLM؟
LiteLLM (github.com/BerriAI/litellm) بوابة مفتوحة المصدر تتيح للتطبيقات استدعاء أكثر من 100 واجهة برمجة لمزوّدي نماذج اللغة من خلال واجهة واحدة متوافقة مع OpenAI، وتتوفر كحزمة Python أو كخادم وكيل مستضاف ذاتيًا يوفّر التوجيه وتتبع التكاليف وتحديد معدل الطلبات.
هل LiteLLM مجانية؟
حزمة SDK مفتوحة المصدر وProxy Server مجانيتان — تدفع فقط مقابل استدعاءات واجهة برمجة المزوّد الأساسي واستضافتك الخاصة. تضيف فئة LiteLLM Enterprise المدفوعة تسجيل الدخول الموحّد (SSO) لأكثر من خمسة مستخدمين وسجلات التدقيق ودعمًا على مدار الساعة طوال أيام الأسبوع مع اتفاقيات مستوى الخدمة؛ وتُباع سنويًا بعرض سعر من المبيعات وتُحدَّد وفق سعة الطلبات وليس لكل رمز (token). يتوفر مفتاح تجريبي لمدة 30 يومًا، ولا تُنشر أسعار.
هل LiteLLM مناسبة للاستخدام في الشركات؟
نعم. يمكن استخدام النواة المرخّصة بموجب MIT (كل ما هو خارج enterprise/) تجاريًا، وتشغّلها الفرق كبوابة داخلية مشتركة مع مفاتيح افتراضية وميزانيات وتتبّع للإنفاق. يتطلب SSO لأكثر من خمسة مستخدمين وSCIM وسجلات التدقيق والدعم المرتبط باتفاقيات مستوى الخدمة ترخيص Enterprise المدفوع؛ وتذكر صفحته SOC 2 Type 2 وISO 27001 (إفادة من المورّد لم نتحقق منها هنا). يعتمد الامتثال لحماية البيانات على المزوّدين الذين توجّه إليهم الطلبات وعلى إعداداتك. هذا لا يُعد استشارة قانونية؛ استشر مسؤول حماية البيانات لديك.
ما الترخيص الذي تستخدمه LiteLLM؟
المستودع الأساسي مرخّص بموجب MIT، وفق ملف LICENSE الخاص به. ينطبق ترخيص منفصل فقط على الدليل الفرعي enterprise/، بموجب enterprise/LICENSE — وتم التحقق من ذلك مباشرةً من ملف LICENSE الخاص بالمستودع لهذه المراجعة.
هل تحتاج LiteLLM إلى وحدة معالجة رسومية؟
لا. LiteLLM موجّه طلبات، لا محرك استدلال نماذج — تعيد توجيه الاستدعاءات إلى المزوّدين (واجهات برمجة سحابية أو بيئات تشغيل محلية مثل Ollama) بدلاً من تشغيل أوزان النموذج بنفسها، لذا تعمل جيدًا على أجهزة تعتمد على المعالج المركزي فقط.
كيف أثبّت LiteLLM؟
لحزمة Python: pip install litellm. للوكيل المستضاف ذاتيًا: `pip install 'litellm[proxy]' ثم litellm --model gpt-4o، أو شغّل صورة Docker docker.litellm.ai/berriai/litellm:latest مع تحميل config.yaml`. راجع جدول التثبيت أعلاه لخيارات Helm وAWS ECS Fargate وGoogle Cloud Run.
هل يتطلب وكيل LiteLLM قاعدة بيانات؟
للاستخدام في بيئة الإنتاج، نعم — يحفظ PostgreSQL المفاتيح الافتراضية وبيانات الإنفاق، ويحافظ Redis على اتساق تحديد معدل الطلبات عبر عدة نُسخ من الوكيل، وفق توثيق النشر الخاص بـ LiteLLM. يمكن تشغيل اختبار محلي سريع دون أيّ منهما، لكن هذا يفقد تلك الميزات.
هل يمكن لـ LiteLLM التوجيه إلى نموذج مستضاف محليًا؟
نعم. يمكن لنفس model_list في config.yaml التي تشير إلى OpenAI أو Anthropic أن تشير بالمثل إلى نقطة نهاية محلية من Ollama أو vLLM، مما يتيح لبوابة واحدة مزج النماذج السحابية والمحلية.
كيف تُقارَن LiteLLM بـ OpenRouter؟
يوحّد كلاهما عدة مزوّدين لنماذج اللغة خلف واجهة واحدة. LiteLLM بنية تحتية مستضافة ذاتيًا تُشغّلها بنفسك (وكيل أو حزمة مفتوحا المصدر)؛ أما OpenRouter فهي خدمة توجيه مُستضافة من طرف ثالث تستدعيها بدلاً من تشغيل خدمتك الخاصة. يعتمد الاختيار على ما إذا كنت تريد صفر تشغيل ذاتي (OpenRouter) أو تحكمًا كاملًا دون هامش ربح إضافي لكل طلب من مزوّد توجيه (LiteLLM المستضافة ذاتيًا).
من يطوّر LiteLLM؟
BerriAI، المؤسسة الواقفة خلف مستودع github.com/BerriAI/litellm، والذي يُظهر أكثر من 61,000 نجمة حتى وقت هذه المراجعة.