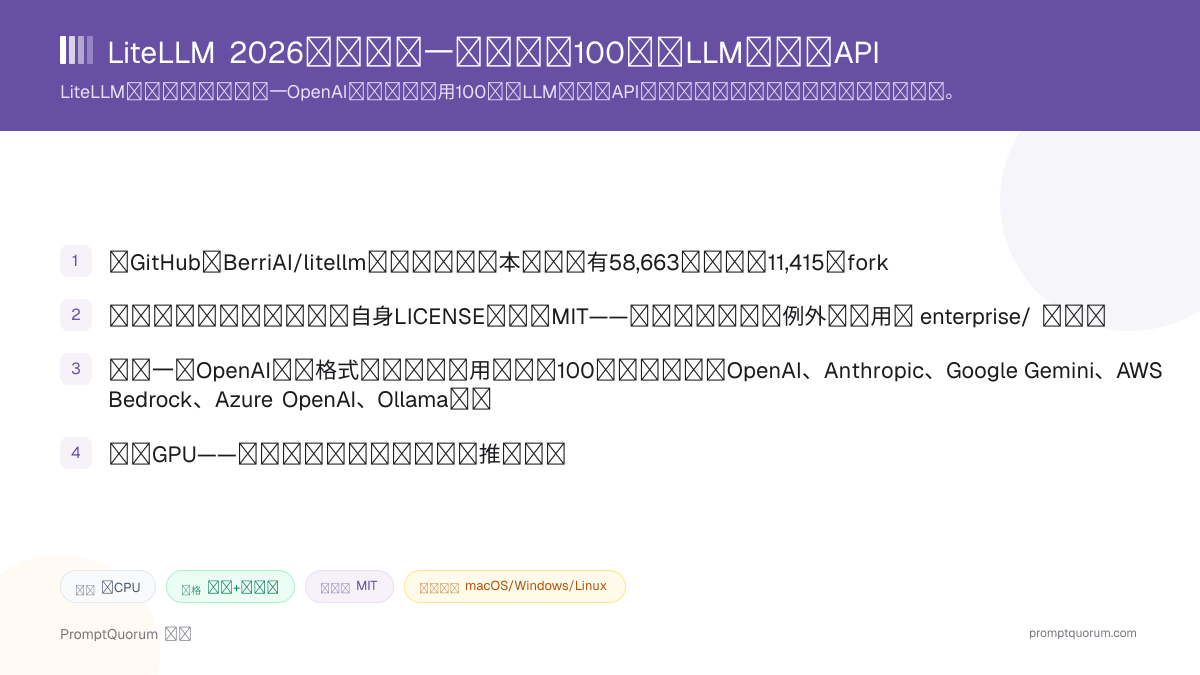
LiteLLM是什么?
LiteLLM是一个网关,将单一的OpenAI兼容请求格式转换为对100多个不同LLM提供商API的调用。 它自身的GitHub仓库简介将其描述为"最快、最轻量的AI网关",采用Rust核心加Python SDK的架构——这是相较项目早期纯Python实现的一次转变。应用无需为OpenAI API、Anthropic API和本地Ollama服务器分别编写客户端代码,只需调用一次LiteLLM,由LiteLLM将请求转发给该模型名称所配置的提供商。
- 核心功能:接收OpenAI的
chat/completions格式(或目标提供商的原生格式)请求,转发给已配置的提供商,并返回标准化响应 - 两种接入方式:直接导入应用代码的Python SDK
litellm,以及供其他应用通过HTTP调用的独立服务LiteLLM Proxy Server - 开发方:BerriAI,即github.com/BerriAI/litellm仓库背后的组织
- 并非模型运行时:LiteLLM本身不加载模型权重也不执行推理——它将请求路由给真正执行这些操作的提供商,包括云端API和Ollama、vLLM等本地服务器
- 根据文档,生产级代理功能包括:虚拟API密钥、按密钥和按用户的支出预算、速率限制、同一模型多个部署间的负载均衡,以及提供商出错时的自动故障转移
LiteLLM能做什么?
根据LiteLLM自身文档,其功能集涵盖请求路由、成本控制与可靠性——这些正是随着提供商和用户数量增加而愈发棘手的LLM应用运维部分。
- 统一的API接口 — 发送OpenAI格式的请求;LiteLLM将其转换为目标模型所需提供商的原生格式,并将响应标准化后返回
- 路由与负载均衡 — 将流量分散到同一模型的多个部署(例如多个Azure OpenAI区域),以避免单点故障或触及速率限制上限
- 故障转移与重试逻辑 — 请求失败时自动向另一个提供商或模型部署重试,而不是将错误直接暴露给终端用户
- 成本追踪与预算 — 按API密钥、用户或团队记录支出,并设置硬性预算上限,一旦超出即阻止后续请求
- 速率限制 — 按密钥或用户限制每分钟/每token的请求数,并通过Redis在多个代理实例间保持一致
- 护栏与日志 — 提供内容审核和可观测性集成的钩子,以及用于审计的结构化请求/响应日志
- 管理仪表盘 — 一个Web界面(在代理的
/ui提供),用于管理虚拟密钥、查看支出及配置模型,无需直接编辑配置文件 - 同样适用于本地运行时 — 调用OpenAI或Anthropic的同一路由层,也可以同样指向本地的Ollama或vLLM端点,使一个网关能够混合云端模型和本地模型
使用示例:使用LiteLLM的两种方式
以下是基于上述LiteLLM文档化安装路径构建的具体工作流程——而非假设性用例。
从一个Python脚本调用多个提供商
安装SDK(pip install litellm),然后将直接对openai、anthropic或特定提供商客户端的调用,替换为`litellm.completion(model="gpt-4o", messages=[...])或litellm.completion(model="claude-opus-4", messages=[...])`。两种调用返回相同的标准化响应结构,因此切换提供商只需改动一行模型名称,而无需重写。
为团队运行自托管网关
部署LiteLLM Proxy Server(Docker或Helm),定义一个带model_list的config.yaml,将易读的模型名称映射到真实的提供商部署,并为每位开发者或每个应用签发一个虚拟API密钥。现在每个应用调用的是一个内部端点,而不是各自持有OpenAI/Anthropic密钥,支出则在管理界面中集中追踪。
在同一端点背后混合云端与本地模型
在config.yaml的同一model_list中同时添加云端模型(例如openai/gpt-4o)和由Ollama或vLLM提供的本地模型。将常规或涉及隐私的流量路由到本地模型,仅在需要时才升级到云端模型,而调用方应用与网关的通信方式无需改变。
安装LiteLLM:SDK、代理与Docker
LiteLLM是一个框架兼自托管网关,而不是面向终端用户的可下载应用——没有可以从应用商店"获取"的安装程序。 以下是根据LiteLLM自身文档和Docker快速入门整理的实际安装与快速启动命令;部署前请务必直接查阅文档,因为具体参数和镜像标签可能随版本变化。
Python SDK
- 命令:
pip install litellm(或uv add litellm)
Proxy Server(pip)
- 命令:
- `pip install 'litellm[proxy]'
,然后litellm --model gpt-4o`
Proxy Server(Docker)
- 命令:
docker run -v $(pwd)/config.yaml:/app/config.yaml -e OPENAI_API_KEY=<key> -e LITELLM_MASTER_KEY=sk-1234 -p 4000:4000 docker.litellm.ai/berriai/litellm:latest --config /app/config.yaml
Helm(Kubernetes)
- 命令:
helm install litellm oci://ghcr.io/berriai/litellm-helm -f values.yaml
AWS ECS Fargate
- 命令:
- 官方Terraform模块
BerriAI/litellm/aws(配置VPC、Aurora PostgreSQL、ElastiCache Redis、ALB、ECS)
Google Cloud Run
- 命令:
- 官方Terraform模块
BerriAI/litellm/google(配置Cloud SQL、Memorystore Redis、GCS、HTTPS负载均衡器)
代理默认使用4000端口,管理仪表盘位于http://localhost:4000/ui(默认登录:用户名admin,密码与你的LITELLM_MASTER_KEY相同)。最简config.yaml需要一个model_list数组,将model_name映射到litellm_params(真实的提供商模型字符串及其API密钥)——完整示例参见代理快速入门。根据LiteLLM的部署文档,Render和Railway也为代理提供了一键部署按钮。
LiteLLM定价:真的免费吗?
开源SDK和Proxy Server是免费的——你只需为经LiteLLM路由的底层提供商API调用付费,外加自己的托管成本。 对于开源路径,LiteLLM本身不按请求或按token收费。根据项目自身网站,litellm.ai/enterprise提供单独的付费LiteLLM Enterprise层级,涵盖SSO、优先功能请求和专属支持——本评测未找到公开的Enterprise定价,建议直接联系LiteLLM获取报价。
- 开源SDK和Proxy Server:无许可费用,核心仓库采用MIT许可(见下方许可说明)
- 你仍需向所路由到的提供商付费——LiteLLM并不降低OpenAI、Anthropic或Bedrock的API价格,只是将其统一并记录
- 自托管代理有其自身的基础设施成本:服务器或容器托管,外加生产使用所需的PostgreSQL和Redis
- 根据litellm.ai/enterprise,LiteLLM Enterprise在同一开源核心之上增加SSO、优先支持及其他商业功能——价格未公开,需联系公司获取
- Enterprise定价按年计费,根据网关的请求容量、部署架构和支持需求确定,绝不按token计费(据litellm.ai/pricing);提供30天Enterprise试用密钥,报价需通过销售团队获取
- 据LiteLLM的SSO文档,自v1.76.0起,单点登录(SSO)最多5个用户免费,超出后需要企业许可证
LiteLLM 对比 vLLM 与 LocalAI
LiteLLM、vLLM和LocalAI解决的是不同的问题,因为三者都提供OpenAI兼容API,所以很容易被混淆。 LiteLLM将请求路由到运行在别处的模型;vLLM和LocalAI则自己执行模型权重。
谁适合使用LiteLLM?
LiteLLM是否适合,取决于你的应用是否已经调用(或计划调用)不止一个LLM提供商——单一提供商的应用从路由层获得的收益较小。
以下情况适合使用LiteLLM
- 你的应用调用两个或以上LLM提供商(或计划这样做),希望用一条代码路径取代按提供商分别编写的集成代码
- 你需要跨多个应用、团队或客户,实现集中的成本追踪以及按密钥或按用户的预算管理
- 你希望在主提供商出错或触发速率限制时,自动故障转移到第二个提供商
- 你希望在同一端点背后混合使用云端模型和本地托管模型(通过Ollama或vLLM)
- 你希望路由层是开源的(MIT核心),而不是一个封闭、仅提供托管的服务
LiteLLM 对比其他网关与框架
LiteLLM属于PromptQuorum本地LLM软件目录中的路由器/网关细分领域,该领域另有三篇专门评测,列在下方最前面。其余对比来自目录中同属“Run & Serve”部分的相邻工具,以及目录之外一个广为人知的托管替代方案。
- Plano — 面向智能体应用的自托管、基于Envoy的AI代理与数据平面,具备LLM路由、可观测性和防护栏(Apache-2.0)。
- ClawRouter — 为智能体设计的自托管LLM路由器,在本地做出路由决策,在前沿模型与免费开放权重模型之间分配请求(MIT)。
- AIClient2API — 自托管代理,将Gemini CLI、Codex、Grok、Kiro和Antigravity的客户端协议转换为统一的OpenAI兼容API(GPL-3.0)。
- vLLM — 一个真正提供模型权重服务的自托管推理引擎(需要GPU);通常与LiteLLM搭配使用而非与之竞争,由LiteLLM作为路由层置于一个或多个vLLM部署之前。
- LocalAI — 一个用于本地运行开放模型的自托管、OpenAI兼容API服务器;它解决的是与LiteLLM不同的问题(提供服务 vs. 路由),但暴露出类似的OpenAI格式API,这也是两者常被混淆的原因。
- LangChain — 一个用于构建LLM驱动应用(链、智能体、记忆)的应用框架;它可以调用LiteLLM(或直接调用任何提供商)作为其模型访问层,而不是取代LiteLLM所做的事情。
- OpenRouter(外部工具,未收录于PromptQuorum目录) — 一个托管、受管理的路由服务,覆盖与LiteLLM代理类似的多提供商场景,但它是你调用的第三方服务,而非你自行托管的基础设施;如果你想要零运维路由而不是自己运行代理,值得直接对比。
评估LiteLLM时的常见误区
关于LiteLLM的大多数困惑,来自将其与模型服务引擎混淆,或对其许可协议过度简化。
误区1:以为LiteLLM自己运行模型
LiteLLM是一个路由器——它将请求转发给提供商API,或你所指定的本地运行时(Ollama、vLLM等)。与vLLM或LocalAI不同,它本身既不加载模型权重,也不执行推理。
误区2:把整个仓库都当作简单的MIT许可
根据仓库自身的LICENSE文件,核心代码采用MIT许可,但enterprise/子目录中的内容根据enterprise/LICENSE单独授权。在假设一律适用MIT条款之前,请确认自己实际使用的是哪些文件。
误区3:跳过PostgreSQL和Redis,随后遇到支出数据缺失或速率限制不一致
仅使用litellm SDK本身不需要任何数据库。自托管的Proxy Server需要PostgreSQL来持久化虚拟密钥和支出记录,需要Redis来在多个代理实例间保持速率限制的一致性——不配置两者运行代理,用于快速测试是可行的,但在规模化场景下会失去这些功能。
误区4:期望LiteLLM能降低提供商API价格
LiteLLM在各提供商之间追踪并统一成本,但并不会为你已经支付的OpenAI、Anthropic或Bedrock底层价格进行议价或打折。节省来自路由/故障转移避免了无谓的重试和速率限制导致的停滞,而不是来自每个token价格的变化。
常见问题
LiteLLM是什么?
LiteLLM(github.com/BerriAI/litellm)是一个开源网关,让应用通过单一的OpenAI兼容接口调用100多个LLM提供商API,可作为Python SDK使用,也可作为具备路由、成本追踪和速率限制功能的自托管代理服务器使用。
LiteLLM是免费的吗?
开源SDK和Proxy Server是免费的——你只需为底层提供商API调用和自己的托管付费。付费的LiteLLM Enterprise增加了超过5个用户的SSO、审计日志和带SLA的7×24小时支持;它按年通过销售报价,依据请求容量确定,绝不按token计费。提供30天试用密钥,但未公布价格。
LiteLLM适合企业使用吗?
适合。采用MIT许可的核心(enterprise/之外的全部内容)可用于商业用途,团队通常将其作为共享的内部网关,配合虚拟密钥、预算和支出追踪使用。超过5个用户的SSO、SCIM、审计日志以及带SLA的支持需要付费的Enterprise许可证;其页面列出了SOC 2 Type 2和ISO 27001(厂商声明,本评测未核实)。数据保护合规性取决于你路由到的提供商和你的配置。这不构成法律建议,请咨询你的数据保护负责人。
LiteLLM使用哪种许可协议?
根据仓库自身的LICENSE文件,核心仓库采用MIT许可。另有单独许可仅适用于enterprise/子目录,见enterprise/LICENSE——本评测已直接核对仓库的LICENSE文件加以验证。
LiteLLM需要GPU吗?
不需要。LiteLLM是请求路由器,而非模型推理引擎——它将调用转发给提供商(云端API或Ollama等本地运行时),而不是自己执行模型权重,因此在纯CPU硬件上也能良好运行。
如何安装LiteLLM?
Python SDK:pip install litellm。自托管代理:`pip install 'litellm[proxy]',然后litellm --model gpt-4o;或挂载config.yaml运行Docker镜像docker.litellm.ai/berriai/litellm:latest`。Helm、AWS ECS Fargate和Google Cloud Run选项参见上方安装表格。
LiteLLM代理需要数据库吗?
生产使用需要——根据LiteLLM自身的部署文档,PostgreSQL持久化虚拟密钥和支出数据,Redis在多个代理实例间保持速率限制一致。快速本地测试可以不用两者运行,但会失去这些功能。
LiteLLM能否路由到本地托管的模型?
可以。指向OpenAI或Anthropic的同一份config.yaml中的model_list,同样可以指向本地的Ollama或vLLM端点,使一个网关能够混合云端和本地模型。
LiteLLM与OpenRouter相比如何?
两者都在单一接口之后统一了多个LLM提供商。LiteLLM是你自行运维的自托管基础设施(开源代理或SDK);OpenRouter是你调用而非自行运维的第三方托管路由服务。选择取决于你是想要零运维(OpenRouter),还是想要没有路由提供商按请求加价的完全掌控(自托管LiteLLM)。
LiteLLM由谁开发?
BerriAI,即github.com/BerriAI/litellm仓库背后的组织,截至本评测显示超过61,000个星标。