¿Qué es LiteLLM?
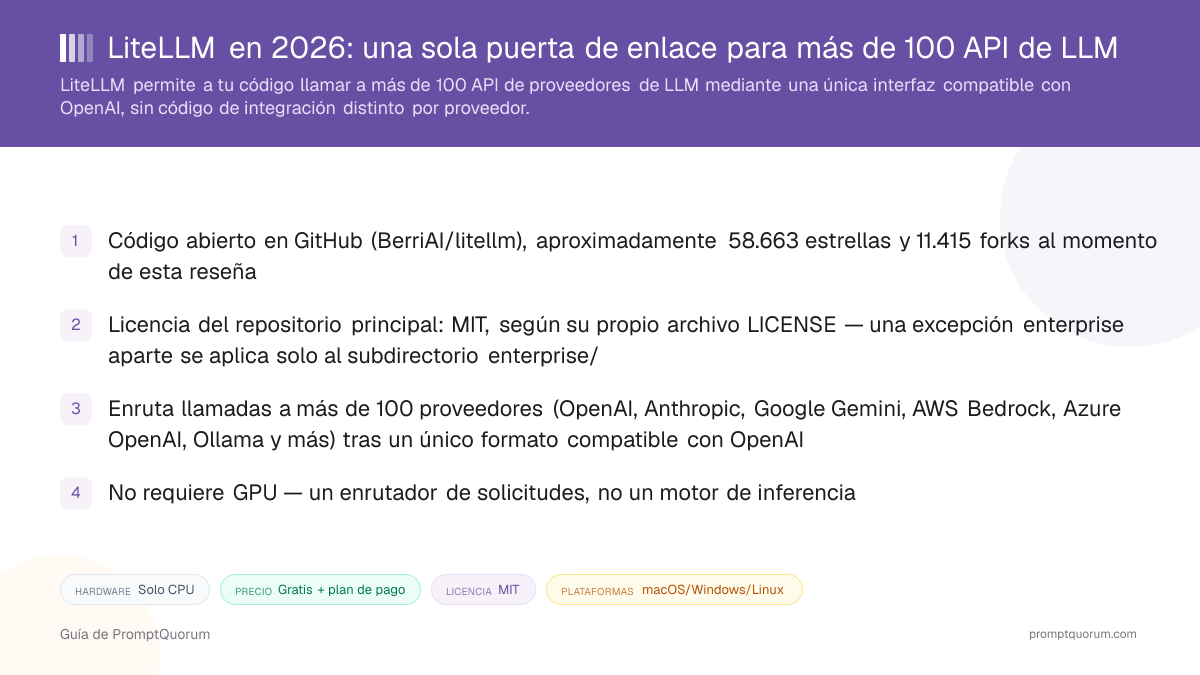
LiteLLM es una puerta de enlace que traduce un único formato de solicitud compatible con OpenAI en llamadas a más de 100 API de proveedores de LLM distintos. La descripción de su repositorio de GitHub lo presenta como "la puerta de enlace de IA más rápida y ligera", construida con un núcleo en Rust y un SDK de Python encima — un cambio respecto a la implementación puramente en Python de los primeros años del proyecto. En lugar de escribir código cliente separado para la API de OpenAI, la de Anthropic y un servidor Ollama local, una aplicación llama a LiteLLM una vez, y LiteLLM reenvía la solicitud al proveedor configurado para ese nombre de modelo.
- Función principal: aceptar una solicitud en el formato
chat/completionsde OpenAI (o en el formato nativo del proveedor de destino), reenviarla al proveedor configurado y devolver una respuesta normalizada - Dos modos de acceso: el SDK de Python
litellm, importado directamente en el código de una aplicación, y el LiteLLM Proxy Server, un servicio independiente que otras aplicaciones llaman por HTTP - Desarrollador: BerriAI, la organización detrás del repositorio github.com/BerriAI/litellm
- No es un motor de ejecución de modelos: LiteLLM no carga pesos de modelos ni realiza inferencia por sí mismo — enruta solicitudes a proveedores que sí lo hacen, incluyendo API en la nube y servidores locales como Ollama o vLLM
- Funciones de nivel producción según la documentación: claves de API virtuales, presupuestos de gasto por clave y por usuario, limitación de tasa, balanceo de carga entre varios despliegues del mismo modelo, y conmutación automática cuando un proveedor falla
¿Qué puedes hacer con LiteLLM?
El conjunto de funciones de LiteLLM abarca enrutamiento de solicitudes, control de costes y fiabilidad — las partes de operar una aplicación basada en LLM que se complican a medida que se añaden más proveedores y más usuarios, según la documentación de LiteLLM.
- Superficie de API unificada — enviar una solicitud en formato OpenAI; LiteLLM la traduce al formato nativo que requiera el proveedor del modelo de destino y normaliza la respuesta de vuelta
- Enrutamiento y balanceo de carga — repartir el tráfico entre varios despliegues del mismo modelo (por ejemplo, varias regiones de Azure OpenAI) para evitar un único punto de fallo o un límite de tasa
- Lógica de respaldo y reintento — reintentar automáticamente una solicitud fallida contra otro proveedor o despliegue de modelo en lugar de mostrar el error al usuario final
- Seguimiento de costes y presupuestos — registrar el gasto por clave de API, por usuario o por equipo, y fijar límites de presupuesto estrictos que bloquean nuevas solicitudes al superarse
- Limitación de tasa — limitar solicitudes por minuto/tokens por clave o usuario, aplicado de forma consistente entre varias instancias del proxy mediante Redis
- Barreras de protección y registro — puntos de integración para moderación de contenido e integraciones de observabilidad, más registro estructurado de solicitudes/respuestas para auditorías
- Panel de administración — una interfaz web (servida en
/uidel proxy) para gestionar claves virtuales, ver el gasto y configurar modelos sin editar el archivo de configuración directamente - También funciona con runtimes locales — la misma capa de enrutamiento que llama a OpenAI o Anthropic puede apuntar igualmente a un endpoint local de Ollama o vLLM, permitiendo que una puerta de enlace mezcle modelos en la nube y locales
Ejemplos de uso: dos formas de usar LiteLLM
Estos son flujos de trabajo concretos construidos a partir de las rutas de instalación documentadas de LiteLLM anteriores — no casos de uso hipotéticos.
Llamar a varios proveedores desde un script de Python
Instala el SDK (pip install litellm) y luego sustituye las llamadas directas a los clientes de openai, anthropic o específicos de un proveedor por `litellm.completion(model="gpt-4o", messages=[...]) o litellm.completion(model="claude-opus-4", messages=[...])`. Ambas llamadas devuelven la misma forma de respuesta normalizada, así que cambiar de proveedor es un cambio de una línea en el nombre del modelo, no una reescritura.
Operar una puerta de enlace autoalojada para un equipo
Despliega el LiteLLM Proxy Server (Docker o Helm), define un config.yaml con una model_list que asigne nombres de modelo amigables a despliegues reales de proveedores, y emite una clave de API virtual por desarrollador o por app. Cada app ahora llama a un endpoint interno único en lugar de guardar sus propias claves de OpenAI/Anthropic, y el gasto se rastrea de forma centralizada en el panel de administración.
Mezclar modelos en la nube y locales tras un solo endpoint
Añade tanto un modelo en la nube (por ejemplo, openai/gpt-4o) como un modelo local servido por Ollama o vLLM a la misma model_list del config.yaml. Enruta el tráfico rutinario o sensible a la privacidad hacia el modelo local y escala al modelo en la nube solo cuando sea necesario, sin cambiar cómo habla la aplicación que llama con la puerta de enlace.
Instalar LiteLLM: SDK, proxy y Docker
LiteLLM es un framework y una puerta de enlace autoalojada, no una app descargable para el usuario final — no hay un instalador que "obtener" de una tienda de apps. A continuación están los comandos reales de instalación e inicio rápido, según la propia documentación de LiteLLM y su guía rápida de Docker; comprueba siempre la documentación directamente antes de desplegar, ya que los indicadores exactos y las etiquetas de imagen pueden cambiar entre versiones.
SDK de Python
- Comando:
pip install litellm(ouv add litellm)
Proxy Server (pip)
- Comando:
- `pip install 'litellm[proxy]'
y luegolitellm --model gpt-4o`
Proxy Server (Docker)
- Comando:
docker run -v $(pwd)/config.yaml:/app/config.yaml -e OPENAI_API_KEY=<clave> -e LITELLM_MASTER_KEY=sk-1234 -p 4000:4000 docker.litellm.ai/berriai/litellm:latest --config /app/config.yaml
Helm (Kubernetes)
- Comando:
helm install litellm oci://ghcr.io/berriai/litellm-helm -f values.yaml
AWS ECS Fargate
- Comando:
- Módulo Terraform oficial
BerriAI/litellm/aws(provisiona VPC, Aurora PostgreSQL, ElastiCache Redis, ALB, ECS)
Google Cloud Run
- Comando:
- Módulo Terraform oficial
BerriAI/litellm/google(provisiona Cloud SQL, Memorystore Redis, GCS, balanceador de carga HTTPS)
El proxy usa por defecto el puerto 4000, con el panel de administración en http://localhost:4000/ui (inicio de sesión por defecto: usuario admin, contraseña igual a tu LITELLM_MASTER_KEY). Un config.yaml mínimo necesita un array model_list que asigne un model_name a litellm_params (la cadena real del modelo del proveedor más su clave de API) — consulta el inicio rápido del proxy para un ejemplo completo. Render y Railway también ofrecen botones de despliegue con un clic para el proxy, según la documentación de despliegue de LiteLLM.
Precios de LiteLLM: ¿es realmente gratis?
El SDK de código abierto y el Proxy Server son gratuitos — solo pagas las llamadas a la API del proveedor subyacente que enrutas a través de LiteLLM, más tus propios costes de alojamiento. LiteLLM en sí no cobra por solicitud ni por token en la vía de código abierto. Existe un nivel de pago aparte, LiteLLM Enterprise, en litellm.ai/enterprise, que cubre SSO, solicitudes de funciones prioritarias y soporte dedicado, según el propio sitio del proyecto — esta reseña no encontró precios de Enterprise publicados y recomienda contactar directamente con LiteLLM para una cotización.
- SDK de código abierto y Proxy Server: sin cuota de licencia, repositorio principal con licencia MIT (ver la nota de licencia abajo)
- Sigues pagando al proveedor al que enrutas — LiteLLM no reduce los precios de las API de OpenAI, Anthropic o Bedrock, solo los unifica y registra
- Autoalojar el proxy tiene su propio coste de infraestructura: un servidor o proveedor de contenedores, más PostgreSQL y Redis para uso en producción
- LiteLLM Enterprise añade SSO, soporte prioritario y otras funciones empresariales sobre el mismo núcleo de código abierto, según litellm.ai/enterprise — los precios no están publicados y requieren contactar con la empresa
- Los precios de Enterprise son anuales y se dimensionan según la capacidad de solicitudes de la puerta de enlace, la arquitectura de despliegue y las necesidades de soporte, nunca por token, según litellm.ai/pricing; hay una clave de prueba Enterprise de 30 días y los presupuestos los da el equipo comercial
- El inicio de sesión único (SSO) es gratuito para hasta 5 usuarios desde la versión v1.76.0; a partir de ahí se requiere una licencia enterprise, según la documentación de SSO de LiteLLM
LiteLLM frente a vLLM y LocalAI
LiteLLM, vLLM y LocalAI resuelven problemas distintos que es fácil confundir porque los tres exponen una API compatible con OpenAI. LiteLLM enruta solicitudes a modelos que se ejecutan en otro lugar; vLLM y LocalAI ejecutan ellos mismos los pesos del modelo.
Aspecto | LiteLLM | ||
|---|---|---|---|
| Qué hace | Enruta solicitudes a proveedores | Ejecuta modelos él mismo | Ejecuta modelos él mismo |
| Ejecuta pesos del modelo | No | Sí | Sí |
| Licencia | MIT (+ excepción enterprise) | Apache-2.0 | MIT |
| GPU necesaria | No (solo enrutador) | Sí, para servicio en tiempo real | Depende del modelo |
| Ideal para | Enrutamiento multiproveedor y seguimiento de gasto | Servicio autoalojado de alto rendimiento | API única autoalojada compatible con OpenAI |
Estas herramientas se suelen usar juntas en lugar de como sustitutas entre sí: LiteLLM puede colocarse delante de un despliegue de vLLM o LocalAI como capa de enrutamiento y seguimiento de costes, mientras que vLLM o LocalAI realiza la inferencia real del modelo. Consulta los artículos dedicados vLLM explicado y LocalAI explicado para más detalles sobre esos dos.
¿Para quién es LiteLLM?
Que LiteLLM encaje depende de si tu aplicación ya llama, o planea llamar, a más de un proveedor de LLM — una app de un solo proveedor obtiene menos beneficio de una capa de enrutamiento.
Usa LiteLLM si
- Tu aplicación llama a dos o más proveedores de LLM (o planea hacerlo) y quieres un solo camino de código en lugar de código de integración por proveedor
- Necesitas seguimiento centralizado de costes y presupuestos por clave o por usuario entre varias apps, equipos o clientes
- Quieres respaldo automático a un segundo proveedor cuando el principal falla o te limita la tasa
- Quieres mezclar modelos en la nube con un modelo alojado localmente (vía Ollama o vLLM) tras el mismo endpoint
- Quieres que la capa de enrutamiento sea de código abierto (núcleo MIT) en lugar de un servicio cerrado y solo alojado
Espera, o busca otra opción, si
- Tu aplicación solo llama a un proveedor y no planeas añadir un segundo — la capa de enrutamiento añade superficie operativa (un proxy que operar, o una dependencia de SDK) sin beneficio inmediato
- Quieres un motor de servicio de modelos, no un enrutador — realmente necesitas algo que ejecute los pesos del modelo (ver vLLM o LocalAI)
- Quieres un servicio de enrutamiento totalmente gestionado, sin operación propia, en lugar de un proxy autoalojado — un enrutador alojado como OpenRouter evita la carga operativa de PostgreSQL/Redis, a costa de pasar por un tercero
- Una decisión de licencia depende específicamente de código dentro del directorio
enterprise/— lee directamenteenterprise/LICENSEen lugar de asumir que allí aplica la licencia MIT de todo el repositorio
LiteLLM frente a otras puertas de enlace y frameworks
LiteLLM pertenece al segmento de enrutadores y puertas de enlace del Directorio de Software LLM Local de PromptQuorum, que cuenta con otras tres reseñas dedicadas, listadas primero a continuación. El resto de comparaciones proviene de herramientas adyacentes de la misma parte «Run & Serve» del directorio, más una alternativa alojada muy conocida fuera del directorio.
- Plano — un proxy de IA autoalojado basado en Envoy y plano de datos para aplicaciones con agentes, con enrutamiento de LLM, observabilidad y barreras de seguridad (Apache-2.0).
- ClawRouter — un enrutador de LLM autoalojado, pensado para agentes, que toma sus decisiones de enrutamiento en local entre modelos de frontera y modelos open-weight gratuitos (MIT).
- AIClient2API — un proxy autoalojado que convierte los protocolos de cliente de Gemini CLI, Codex, Grok, Kiro y Antigravity en una sola API compatible con OpenAI (GPL-3.0).
- vLLM — un motor de inferencia autoalojado que realmente sirve los pesos del modelo (requiere GPU); habitualmente combinado con LiteLLM en lugar de competir con él, con LiteLLM como capa de enrutamiento delante de uno o varios despliegues de vLLM.
- LocalAI — un servidor de API autoalojado y compatible con OpenAI para ejecutar modelos abiertos localmente; resuelve un problema distinto al de LiteLLM (servir vs. enrutar) pero expone una API de formato OpenAI similar, fuente habitual de confusión entre ambos.
- LangChain — un framework de aplicación para construir apps basadas en LLM (cadenas, agentes, memoria); puede llamar a LiteLLM (o directamente a cualquier proveedor) como su capa de acceso a modelos, en lugar de sustituir lo que hace LiteLLM.
- OpenRouter (externo, no está en el directorio de PromptQuorum) — un servicio de enrutamiento alojado y gestionado que cubre un caso de uso multiproveedor similar al proxy de LiteLLM, pero como servicio de terceros al que llamas en lugar de infraestructura que autoalojas; merece la pena comparar directamente si buscas enrutamiento sin operación propia en vez de gestionar tu propio proxy.
Errores comunes al evaluar LiteLLM
La mayor parte de la confusión sobre LiteLLM viene de confundirlo con un motor de servicio de modelos, o de simplificar en exceso su licencia.
Error 1: suponer que LiteLLM ejecuta los modelos él mismo
LiteLLM es un enrutador — reenvía solicitudes a API de proveedores o a un runtime local al que lo apuntes (Ollama, vLLM y otros). No carga pesos de modelos ni realiza inferencia por sí mismo, a diferencia de vLLM o LocalAI.
Error 2: tratar todo el repositorio como simplemente MIT
El código principal tiene licencia MIT según el propio archivo LICENSE del repositorio, pero el contenido del subdirectorio enterprise/ tiene una licencia aparte definida en enterprise/LICENSE. Comprueba qué archivos estás usando realmente antes de asumir que se aplican términos MIT generales.
Error 3: omitir PostgreSQL y Redis y luego encontrarte con datos de gasto faltantes o límites de tasa inconsistentes
El SDK litellm por sí solo no necesita base de datos alguna. El Proxy Server autoalojado necesita PostgreSQL para persistir claves virtuales y registros de gasto, y Redis para una limitación de tasa que se mantenga consistente entre más de una instancia del proxy — ejecutar el proxy sin ninguno de los dos funciona para una prueba rápida, pero pierde estas funciones a gran escala.
Error 4: esperar que LiteLLM reduzca los precios de las API de los proveedores
LiteLLM rastrea y unifica el coste entre proveedores; no negocia ni descuenta los precios subyacentes de OpenAI, Anthropic o Bedrock que ya pagas. El ahorro proviene de que el enrutamiento/respaldo evita reintentos desperdiciados y bloqueos por límite de tasa, no de un precio distinto por token.
Preguntas frecuentes
¿Qué es LiteLLM?
LiteLLM (github.com/BerriAI/litellm) es una puerta de enlace de código abierto que permite a las aplicaciones llamar a más de 100 API de proveedores de LLM mediante una única interfaz compatible con OpenAI, disponible como SDK de Python o como servidor proxy autoalojado con enrutamiento, seguimiento de costes y limitación de tasa.
¿Es gratis LiteLLM?
El SDK de código abierto y el Proxy Server son gratuitos — solo pagas las llamadas a la API del proveedor subyacente y tu propio alojamiento. El nivel de pago LiteLLM Enterprise añade SSO a partir de cinco usuarios, registros de auditoría y soporte 24/7 con SLA; se vende por años mediante cotización, dimensionado según la capacidad de solicitudes y nunca por token. Hay una clave de prueba de 30 días; no se publican precios.
¿Es LiteLLM adecuado para uso empresarial?
Sí. El núcleo con licencia MIT (todo lo que está fuera de enterprise/) puede usarse comercialmente, y los equipos lo ejecutan como puerta de enlace interna compartida con claves virtuales, presupuestos y seguimiento del gasto. El SSO a partir de cinco usuarios, SCIM, los registros de auditoría y el soporte con SLA requieren la licencia de pago Enterprise; su página menciona SOC 2 Type 2 e ISO 27001 (declaración del proveedor, no verificada aquí). El cumplimiento del RGPD depende de los proveedores a los que enrutes y de tu configuración; esto no es asesoramiento legal, consulta a tu delegado de protección de datos.
¿Qué licencia usa LiteLLM?
El repositorio principal tiene licencia MIT, según su propio archivo LICENSE. Una licencia aparte se aplica únicamente al subdirectorio enterprise/, definida en enterprise/LICENSE — verificado directamente contra el archivo LICENSE del repositorio para esta reseña.
¿Necesita LiteLLM una GPU?
No. LiteLLM es un enrutador de solicitudes, no un motor de inferencia de modelos — reenvía llamadas a proveedores (API en la nube o runtimes locales como Ollama) en lugar de ejecutar él mismo los pesos del modelo, por lo que funciona bien en hardware solo con CPU.
¿Cómo instalo LiteLLM?
Para el SDK de Python: pip install litellm. Para el proxy autoalojado: `pip install 'litellm[proxy]' y luego litellm --model gpt-4o, o ejecuta la imagen Docker docker.litellm.ai/berriai/litellm:latest con un config.yaml` montado. Consulta la tabla de instalación anterior para las opciones de Helm, AWS ECS Fargate y Google Cloud Run.
¿El proxy de LiteLLM requiere una base de datos?
Para uso en producción, sí — PostgreSQL persiste las claves virtuales y los datos de gasto, y Redis mantiene la limitación de tasa consistente entre varias instancias del proxy, según la propia documentación de despliegue de LiteLLM. Una prueba local rápida puede ejecutarse sin ninguna de las dos, pero pierde esas funciones.
¿Puede LiteLLM enrutar a un modelo alojado localmente?
Sí. La misma model_list del config.yaml que apunta a OpenAI o Anthropic puede apuntar igualmente a un endpoint local de Ollama o vLLM, permitiendo que una puerta de enlace mezcle modelos en la nube y locales.
¿Cómo se compara LiteLLM con OpenRouter?
Ambos unifican varios proveedores de LLM tras una interfaz. LiteLLM es infraestructura autoalojada que operas tú mismo (proxy o SDK de código abierto); OpenRouter es un servicio de enrutamiento alojado por un tercero al que llamas en lugar de operar el tuyo propio. La elección depende de si quieres cero operación propia (OpenRouter) o control total sin recargo por solicitud de un proveedor de enrutamiento (LiteLLM autoalojado).
¿Quién desarrolla LiteLLM?
BerriAI, la organización detrás del repositorio github.com/BerriAI/litellm, que muestra más de 61.000 estrellas al momento de esta reseña.