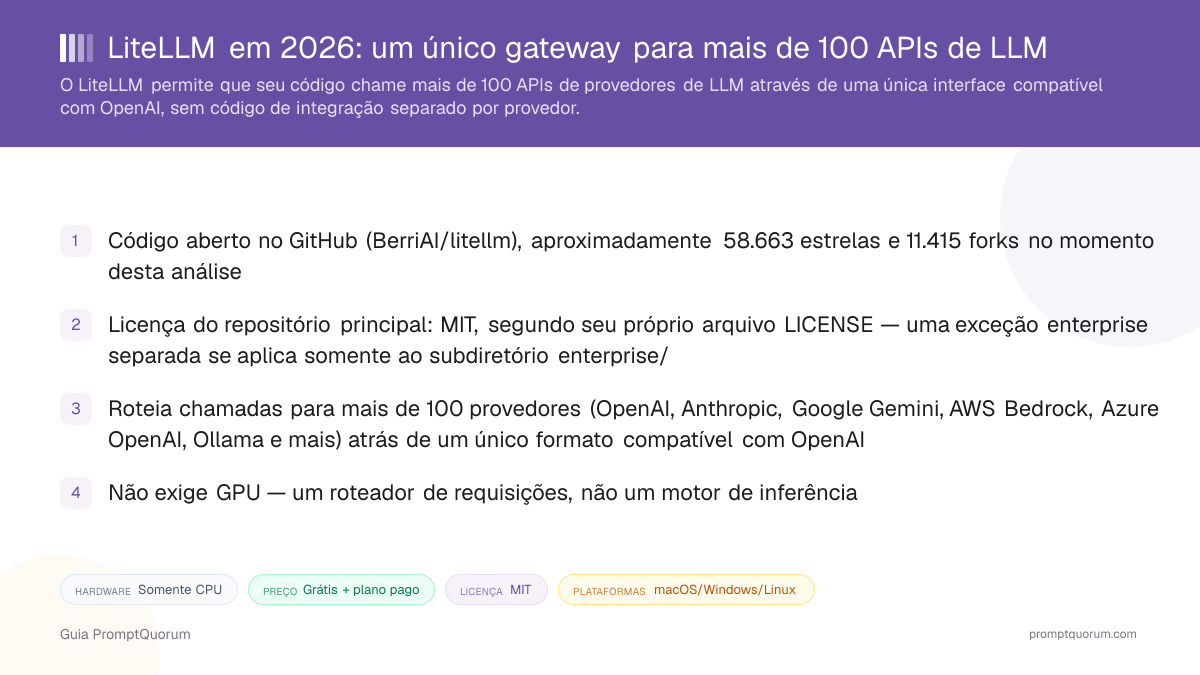
O que é o LiteLLM?
O LiteLLM é um gateway que traduz um único formato de requisição compatível com OpenAI em chamadas para mais de 100 APIs de provedores de LLM diferentes. A descrição do seu repositório no GitHub o apresenta como "o gateway de IA mais rápido e mais leve", construído com um núcleo em Rust e um SDK Python por cima — uma mudança em relação à implementação puramente em Python dos primeiros anos do projeto. Em vez de escrever código de cliente separado para a API da OpenAI, a API da Anthropic e um servidor Ollama local, uma aplicação chama o LiteLLM uma vez, e o LiteLLM encaminha a requisição para o provedor configurado para aquele nome de modelo.
- Função principal: aceitar uma requisição no formato
chat/completionsda OpenAI (ou no formato nativo do provedor de destino), encaminhá-la ao provedor configurado e retornar uma resposta normalizada - Dois modos de acesso: o SDK Python
litellm, importado diretamente no código de uma aplicação, e o LiteLLM Proxy Server, um serviço independente que outras aplicações chamam via HTTP - Desenvolvedor: BerriAI, a organização por trás do repositório github.com/BerriAI/litellm
- Não é um runtime de modelo: o LiteLLM não carrega pesos de modelo nem realiza inferência por conta própria — ele roteia requisições para provedores que fazem isso, incluindo APIs na nuvem e servidores locais como Ollama ou vLLM
- Funcionalidades de nível produção segundo a documentação: chaves de API virtuais, orçamentos de gastos por chave e por usuário, limitação de taxa, balanceamento de carga entre várias implantações do mesmo modelo, e fallback automático quando um provedor falha
O que dá para fazer com o LiteLLM?
O conjunto de funcionalidades do LiteLLM abrange roteamento de requisições, controle de custos e confiabilidade — as partes de operar uma aplicação baseada em LLM que ficam mais difíceis à medida que mais provedores e usuários são adicionados, segundo a documentação do LiteLLM.
- Superfície de API unificada — enviar uma requisição no formato OpenAI; o LiteLLM a traduz para o formato nativo exigido pelo provedor do modelo de destino, e normaliza a resposta de volta
- Roteamento e balanceamento de carga — distribuir o tráfego entre várias implantações do mesmo modelo (por exemplo, várias regiões do Azure OpenAI) para evitar um único ponto de falha ou um teto de limite de taxa
- Lógica de fallback e nova tentativa — tentar novamente automaticamente uma requisição falhada em outro provedor ou implantação de modelo, em vez de expor o erro ao usuário final
- Rastreamento de custos e orçamentos — registrar gastos por chave de API, por usuário ou por equipe, e definir limites de orçamento rígidos que bloqueiam novas requisições ao serem excedidos
- Limitação de taxa — limitar requisições por minuto/tokens por chave ou usuário, aplicado de forma consistente entre várias instâncias do proxy via Redis
- Guardrails e registro — pontos de integração para moderação de conteúdo e integrações de observabilidade, além de registro estruturado de requisições/respostas para auditorias
- Painel de administração — uma interface web (servida em
/uino proxy) para gerenciar chaves virtuais, ver gastos e configurar modelos sem editar diretamente o arquivo de configuração - Também funciona com runtimes locais — a mesma camada de roteamento que chama a OpenAI ou a Anthropic pode igualmente apontar para um endpoint local do Ollama ou vLLM, permitindo que um gateway misture modelos na nuvem e locais
Exemplos de uso: duas formas de usar o LiteLLM
Estes são fluxos de trabalho concretos construídos a partir dos caminhos de instalação documentados do LiteLLM acima — não casos de uso hipotéticos.
Chamar vários provedores a partir de um script Python
Instale o SDK (pip install litellm) e substitua chamadas diretas aos clientes openai, anthropic ou específicos de um provedor por `litellm.completion(model="gpt-4o", messages=[...]) ou litellm.completion(model="claude-opus-4", messages=[...])`. Ambas as chamadas retornam o mesmo formato de resposta normalizado, então trocar de provedor é uma mudança de uma linha no nome do modelo, não uma reescrita.
Operar um gateway auto-hospedado para uma equipe
Implante o LiteLLM Proxy Server (Docker ou Helm), defina um config.yaml com uma model_list que mapeie nomes de modelo amigáveis para implantações reais de provedores, e emita uma chave de API virtual por desenvolvedor ou por app. Cada app agora chama um único endpoint interno em vez de guardar suas próprias chaves da OpenAI/Anthropic, e os gastos são rastreados centralmente no painel de administração.
Misturar modelos na nuvem e locais atrás de um único endpoint
Adicione tanto um modelo na nuvem (por exemplo, openai/gpt-4o) quanto um modelo local servido pelo Ollama ou vLLM à mesma model_list no config.yaml. Roteie o tráfego rotineiro ou sensível à privacidade para o modelo local e escale para o modelo na nuvem apenas quando necessário, sem mudar como a aplicação chamadora fala com o gateway.
Instalar o LiteLLM: SDK, proxy e Docker
O LiteLLM é um framework e um gateway auto-hospedado, não um app baixável para o usuário final — não existe um instalador para "pegar" numa loja de apps. Abaixo estão os comandos reais de instalação e início rápido, segundo a própria documentação do LiteLLM e seu guia rápido de Docker; sempre confira a documentação diretamente antes de implantar, já que sinalizadores exatos e tags de imagem podem mudar entre versões.
SDK Python
- Comando:
pip install litellm(ouuv add litellm)
Proxy Server (pip)
- Comando:
- `pip install 'litellm[proxy]'
e depoislitellm --model gpt-4o`
Proxy Server (Docker)
- Comando:
docker run -v $(pwd)/config.yaml:/app/config.yaml -e OPENAI_API_KEY=<chave> -e LITELLM_MASTER_KEY=sk-1234 -p 4000:4000 docker.litellm.ai/berriai/litellm:latest --config /app/config.yaml
Helm (Kubernetes)
- Comando:
helm install litellm oci://ghcr.io/berriai/litellm-helm -f values.yaml
AWS ECS Fargate
- Comando:
- Módulo Terraform oficial
BerriAI/litellm/aws(provisiona VPC, Aurora PostgreSQL, ElastiCache Redis, ALB, ECS)
Google Cloud Run
- Comando:
- Módulo Terraform oficial
BerriAI/litellm/google(provisiona Cloud SQL, Memorystore Redis, GCS, balanceador de carga HTTPS)
O proxy usa por padrão a porta 4000, com o painel de administração em http://localhost:4000/ui (login padrão: usuário admin, senha igual ao seu LITELLM_MASTER_KEY). Um config.yaml mínimo precisa de um array model_list mapeando um model_name para litellm_params (a string real do modelo do provedor mais sua chave de API) — veja o início rápido do proxy para um exemplo completo. Render e Railway também oferecem botões de implantação em um clique para o proxy, segundo a documentação de implantação do LiteLLM.
Preços do LiteLLM: é realmente grátis?
O SDK de código aberto e o Proxy Server são gratuitos — você paga apenas pelas chamadas de API do provedor subjacente roteadas através do LiteLLM, mais seus próprios custos de hospedagem. O LiteLLM em si não cobra por requisição ou por token no caminho de código aberto. Existe um nível pago separado, o LiteLLM Enterprise, em litellm.ai/enterprise, cobrindo SSO, pedidos de funcionalidades prioritárias e suporte dedicado, segundo o próprio site do projeto — esta análise não encontrou preços do Enterprise publicados e recomenda entrar em contato diretamente com o LiteLLM para uma cotação.
- SDK de código aberto e Proxy Server: sem taxa de licença, repositório principal com licença MIT (veja a nota sobre licenciamento abaixo)
- Você continua pagando o provedor para o qual está roteando — o LiteLLM não reduz os preços das APIs da OpenAI, Anthropic ou Bedrock, apenas os unifica e registra
- Auto-hospedar o proxy tem seu próprio custo de infraestrutura: um servidor ou host de contêiner, mais PostgreSQL e Redis para uso em produção
- O LiteLLM Enterprise adiciona SSO, suporte prioritário e outras funcionalidades empresariais sobre o mesmo núcleo de código aberto, segundo litellm.ai/enterprise — os preços não são publicados e exigem contato com a empresa
- Os preços do Enterprise são anuais e dimensionados conforme a capacidade de requisições do gateway, a arquitetura de implantação e as necessidades de suporte, nunca por token, segundo litellm.ai/pricing; há uma chave de teste Enterprise de 30 dias e as cotações vêm da equipe comercial
- O login único (SSO) é gratuito para até 5 usuários a partir da versão v1.76.0; acima disso, é necessária uma licença enterprise, segundo a documentação de SSO do LiteLLM
LiteLLM vs. vLLM vs. LocalAI
LiteLLM, vLLM e LocalAI resolvem problemas diferentes que são fáceis de confundir porque os três expõem uma API compatível com OpenAI. O LiteLLM roteia requisições para modelos executados em outro lugar; o vLLM e o LocalAI executam os pesos do modelo eles mesmos.
Aspecto | LiteLLM | ||
|---|---|---|---|
| O que faz | Roteia requisições para provedores | Executa modelos por conta própria | Executa modelos por conta própria |
| Executa pesos do modelo | Não | Sim | Sim |
| Licença | MIT (+ exceção enterprise) | Apache-2.0 | MIT |
| GPU necessária | Não (só roteador) | Sim, para serviço em tempo real | Depende do modelo |
| Ideal para | Roteamento multiprovedor e rastreamento de gastos | Serviço auto-hospedado de alto throughput | API única auto-hospedada compatível com OpenAI |
Essas ferramentas costumam ser usadas juntas, em vez de como substitutas uma da outra: o LiteLLM pode ficar na frente de uma implantação do vLLM ou LocalAI como camada de roteamento e rastreamento de custos, enquanto o vLLM ou o LocalAI realiza a inferência real do modelo. Veja os artigos dedicados vLLM explicado e LocalAI explicado para detalhes sobre esses dois.
Para quem o LiteLLM é indicado?
O LiteLLM ser adequado ou não depende de sua aplicação já chamar, ou planejar chamar, mais de um provedor de LLM — um app de provedor único ganha menos benefício de uma camada de roteamento.
Use o LiteLLM se
- Sua aplicação chama dois ou mais provedores de LLM (ou planeja chamar) e você quer um único caminho de código em vez de código de integração por provedor
- Você precisa de rastreamento centralizado de custos e orçamentos por chave ou por usuário entre vários apps, equipes ou clientes
- Você quer fallback automático para um segundo provedor quando o principal falha ou limita sua taxa
- Você quer misturar modelos na nuvem com um modelo hospedado localmente (via Ollama ou vLLM) atrás do mesmo endpoint
- Você quer que a camada de roteamento seja de código aberto (núcleo MIT) em vez de um serviço fechado e apenas hospedado
Espere, ou procure outra opção, se
- Sua aplicação só chama um provedor e você não planeja adicionar um segundo — a camada de roteamento adiciona superfície operacional (um proxy para operar, ou uma dependência de SDK) sem benefício imediato
- Você quer um motor de serviço de modelos, não um roteador — você realmente precisa de algo que execute os pesos do modelo (veja vLLM ou LocalAI)
- Você quer um serviço de roteamento totalmente gerenciado, sem operação própria, em vez de um proxy auto-hospedado — um roteador hospedado como o OpenRouter evita a carga operacional de PostgreSQL/Redis, ao custo de passar por terceiros
- Uma decisão de licenciamento depende especificamente de código dentro do diretório
enterprise/— leiaenterprise/LICENSEdiretamente, em vez de presumir que a licença MIT de todo o repositório se aplica ali
LiteLLM vs. outros gateways e frameworks
O LiteLLM pertence ao segmento de roteadores e gateways do Diretório de Software LLM Local da PromptQuorum, que tem outras três análises dedicadas, listadas primeiro abaixo. As demais comparações vêm de ferramentas adjacentes da mesma parte "Run & Serve" do diretório, mais uma alternativa hospedada bastante conhecida fora do diretório.
- Plano — um proxy de IA auto-hospedado baseado em Envoy e plano de dados para aplicações com agentes, com roteamento de LLM, observabilidade e guardrails (Apache-2.0).
- ClawRouter — um roteador de LLM auto-hospedado, voltado a agentes, que toma as decisões de roteamento localmente entre modelos de ponta e modelos open-weight gratuitos (MIT).
- AIClient2API — um proxy auto-hospedado que converte os protocolos de cliente do Gemini CLI, Codex, Grok, Kiro e Antigravity em uma única API compatível com OpenAI (GPL-3.0).
- vLLM — um motor de inferência auto-hospedado que realmente serve os pesos do modelo (exige GPU); comumente combinado com o LiteLLM em vez de competir com ele, com o LiteLLM como camada de roteamento na frente de uma ou mais implantações do vLLM.
- LocalAI — um servidor de API auto-hospedado e compatível com OpenAI para executar modelos abertos localmente; resolve um problema diferente do LiteLLM (servir vs. rotear), mas expõe uma API de formato OpenAI semelhante, fonte comum de confusão entre os dois.
- LangChain — um framework de aplicação para construir apps baseados em LLM (chains, agentes, memória); pode chamar o LiteLLM (ou diretamente qualquer provedor) como sua camada de acesso a modelos, em vez de substituir o que o LiteLLM faz.
- OpenRouter (externo, fora do diretório da PromptQuorum) — um serviço de roteamento hospedado e gerenciado cobrindo um caso de uso multiprovedor semelhante ao proxy do LiteLLM, mas como um serviço de terceiros que você chama em vez de infraestrutura que você mesmo hospeda; vale a pena comparar diretamente se você quer roteamento sem operação própria em vez de gerenciar seu próprio proxy.
Erros comuns ao avaliar o LiteLLM
A maior parte da confusão sobre o LiteLLM vem de confundi-lo com um motor de serviço de modelos, ou de simplificar demais sua licença.
Erro 1: presumir que o LiteLLM executa os modelos por conta própria
O LiteLLM é um roteador — ele encaminha requisições para APIs de provedores ou para um runtime local para o qual você o aponta (Ollama, vLLM e outros). Ele não carrega pesos de modelo nem realiza inferência por conta própria, diferentemente do vLLM ou do LocalAI.
Erro 2: tratar todo o repositório como simplesmente MIT
O código principal tem licença MIT segundo o próprio arquivo LICENSE do repositório, mas o conteúdo dentro do subdiretório enterprise/ tem licença separada definida em enterprise/LICENSE. Confira quais arquivos você está realmente usando antes de presumir que termos MIT genéricos se aplicam.
Erro 3: pular PostgreSQL e Redis e depois encontrar dados de gastos ausentes ou limites de taxa inconsistentes
O SDK litellm sozinho não precisa de nenhum banco de dados. O Proxy Server auto-hospedado precisa de PostgreSQL para persistir chaves virtuais e registros de gastos, e de Redis para uma limitação de taxa que permaneça consistente entre mais de uma instância do proxy — rodar o proxy sem nenhum dos dois funciona para um teste rápido, mas perde essas funcionalidades em escala.
Erro 4: esperar que o LiteLLM reduza os preços das APIs dos provedores
O LiteLLM rastreia e unifica custos entre provedores; ele não negocia nem oferece desconto nos preços subjacentes da OpenAI, Anthropic ou Bedrock que você já paga. A economia vem do roteamento/fallback evitando novas tentativas desperdiçadas e bloqueios por limite de taxa, não de um preço diferente por token.
Perguntas frequentes
O que é o LiteLLM?
O LiteLLM (github.com/BerriAI/litellm) é um gateway de código aberto que permite às aplicações chamar mais de 100 APIs de provedores de LLM através de uma única interface compatível com OpenAI, disponível como SDK Python ou como servidor proxy auto-hospedado com roteamento, rastreamento de custos e limitação de taxa.
O LiteLLM é gratuito?
O SDK de código aberto e o Proxy Server são gratuitos — você paga apenas pelas chamadas de API do provedor subjacente e sua própria hospedagem. O nível pago LiteLLM Enterprise adiciona SSO acima de cinco usuários, logs de auditoria e suporte 24/7 com SLA; ele é vendido anualmente sob cotação, dimensionado pela capacidade de requisições e nunca por token. Há uma chave de teste de 30 dias; não há preços publicados.
O LiteLLM é adequado para uso empresarial?
Sim. O núcleo sob licença MIT (tudo fora de enterprise/) pode ser usado comercialmente, e as equipes o executam como gateway interno compartilhado, com chaves virtuais, orçamentos e rastreamento de gastos. SSO acima de cinco usuários, SCIM, logs de auditoria e suporte com SLA exigem a licença paga Enterprise; a página dela cita SOC 2 Type 2 e ISO 27001 (declaração do fornecedor, não verificada aqui). A conformidade com a LGPD depende dos provedores para os quais você roteia e da sua configuração; isto não é aconselhamento jurídico, consulte seu encarregado de proteção de dados.
Qual licença o LiteLLM usa?
O repositório principal tem licença MIT, segundo seu próprio arquivo LICENSE. Uma licença separada se aplica somente ao subdiretório enterprise/, definida em enterprise/LICENSE — verificado diretamente no arquivo LICENSE do repositório para esta análise.
O LiteLLM precisa de GPU?
Não. O LiteLLM é um roteador de requisições, não um motor de inferência de modelo — ele encaminha chamadas para provedores (APIs na nuvem ou runtimes locais como o Ollama) em vez de executar ele mesmo os pesos do modelo, então funciona bem em hardware apenas com CPU.
Como instalo o LiteLLM?
Para o SDK Python: pip install litellm. Para o proxy auto-hospedado: `pip install 'litellm[proxy]' e depois litellm --model gpt-4o, ou execute a imagem Docker docker.litellm.ai/berriai/litellm:latest com um config.yaml` montado. Veja a tabela de instalação acima para as opções Helm, AWS ECS Fargate e Google Cloud Run.
O proxy do LiteLLM exige um banco de dados?
Para uso em produção, sim — o PostgreSQL persiste as chaves virtuais e os dados de gastos, e o Redis mantém a limitação de taxa consistente entre várias instâncias do proxy, segundo a própria documentação de implantação do LiteLLM. Um teste local rápido pode rodar sem nenhum dos dois, mas perde essas funcionalidades.
O LiteLLM pode rotear para um modelo hospedado localmente?
Sim. A mesma model_list no config.yaml que aponta para a OpenAI ou Anthropic pode igualmente apontar para um endpoint local do Ollama ou vLLM, permitindo que um gateway misture modelos na nuvem e locais.
Como o LiteLLM se compara ao OpenRouter?
Ambos unificam vários provedores de LLM atrás de uma interface. O LiteLLM é infraestrutura auto-hospedada que você mesmo opera (proxy ou SDK de código aberto); o OpenRouter é um serviço de roteamento hospedado por terceiros que você chama em vez de operar o seu próprio. A escolha depende de você querer zero operação própria (OpenRouter) ou controle total sem markup por requisição de um provedor de roteamento (LiteLLM auto-hospedado).
Quem desenvolve o LiteLLM?
A BerriAI, organização por trás do repositório github.com/BerriAI/litellm, que mostra mais de 61.000 estrelas no momento desta análise.