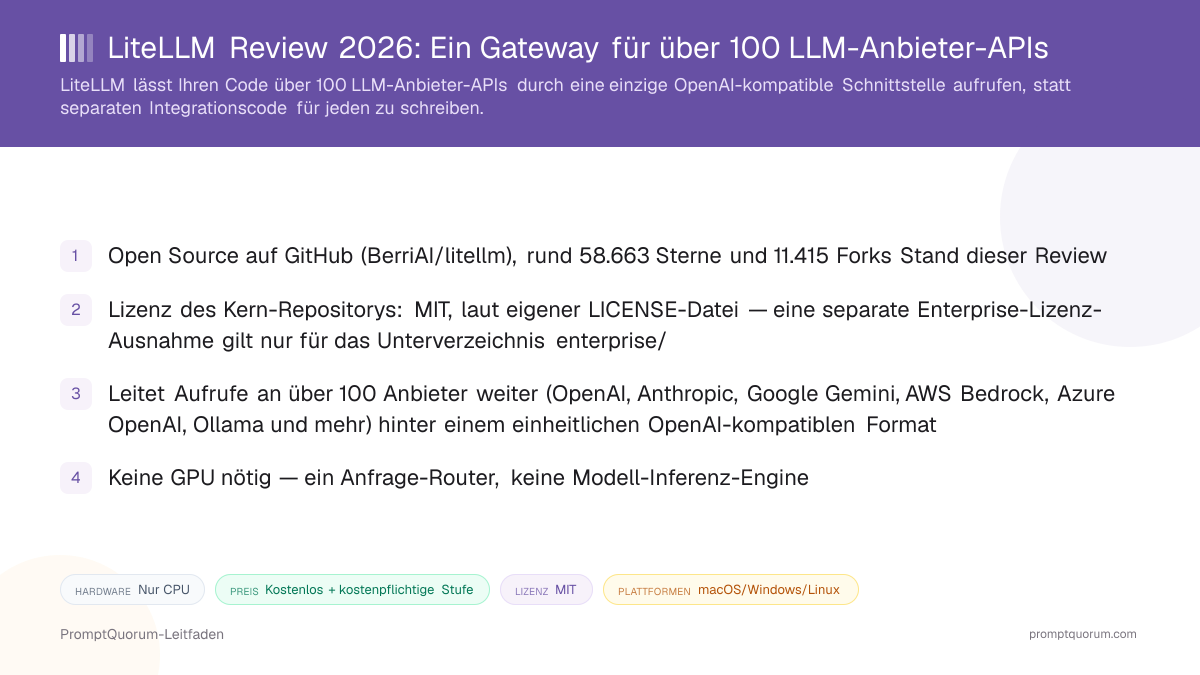
Was ist LiteLLM?
LiteLLM ist ein Gateway, das ein einziges OpenAI-kompatibles Anfrageformat in Aufrufe an über 100 verschiedene LLM-Anbieter-APIs übersetzt. Die GitHub-Repository-Beschreibung bezeichnet es als „the fastest, litest AI Gateway", aufgebaut mit einem Rust-Kern und einem Python-SDK darüber — ein Wandel gegenüber der reinen Python-Implementierung der früheren Projektjahre. Statt separaten Client-Code für die OpenAI-API, die Anthropic-API und einen lokalen Ollama-Server zu schreiben, ruft eine Anwendung LiteLLM einmal auf, und LiteLLM leitet die Anfrage an den für diesen Modellnamen konfigurierten Anbieter weiter.
- Kernfunktion: eine Anfrage im OpenAI-Format
chat/completions(oder im nativen Format des Zielanbieters) entgegennehmen, an den konfigurierten Anbieter weiterleiten und eine normalisierte Antwort zurückgeben - Zwei Zugangswege: das Python-SDK
litellm, direkt in den Code einer Anwendung eingebunden, sowie der LiteLLM Proxy Server, ein eigenständiger Dienst, den andere Anwendungen per HTTP aufrufen - Entwickler: BerriAI, die Organisation hinter dem Repository github.com/BerriAI/litellm
- Keine Modell-Laufzeitumgebung: LiteLLM lädt selbst keine Modellgewichte und führt keine Inferenz aus — es leitet Anfragen an Anbieter weiter, die das tun, einschließlich Cloud-APIs und lokaler Server wie Ollama oder vLLM
- Produktionsreife Proxy-Funktionen laut Dokumentation: virtuelle API-Schlüssel, Ausgabenbudgets pro Schlüssel und pro Nutzer, Rate-Limiting, Load Balancing über mehrere Deployments desselben Modells sowie automatischer Fallback bei Anbieterfehlern
Was können Sie mit LiteLLM tun?
LiteLLMs Funktionsumfang deckt Anfrage-Routing, Kostenkontrolle und Zuverlässigkeit ab — die Teile des Betriebs einer LLM-gestützten Anwendung, die mit mehr Anbietern und mehr Nutzern schwieriger werden, laut LiteLLMs eigener Dokumentation.
- Einheitliche API-Oberfläche — eine Anfrage im OpenAI-Format senden; LiteLLM übersetzt sie in das native Format des jeweiligen Anbieters und normalisiert die Antwort zurück
- Routing und Load Balancing — Traffic über mehrere Deployments desselben Modells verteilen (zum Beispiel mehrere Azure-OpenAI-Regionen), um einen einzelnen Ausfallpunkt oder eine Rate-Limit-Obergrenze zu vermeiden
- Fallback- und Retry-Logik — eine fehlgeschlagene Anfrage automatisch bei einem anderen Anbieter oder Modell-Deployment erneut versuchen, statt den Fehler an den Endnutzer durchzureichen
- Kostenverfolgung und Budgets — Ausgaben pro API-Schlüssel, Nutzer oder Team protokollieren und feste Budgetgrenzen setzen, die weitere Anfragen blockieren, sobald sie überschritten sind
- Rate-Limiting — Anfragen pro Minute bzw. Token pro Schlüssel oder Nutzer begrenzen, über mehrere Proxy-Instanzen hinweg per Redis durchgesetzt
- Guardrails und Logging — Hooks für Content-Moderation und Observability-Integrationen sowie strukturiertes Anfrage-/Antwort-Logging für Audits
- Admin-Dashboard — eine Weboberfläche (unter
/uiauf dem Proxy), um virtuelle Schlüssel zu verwalten, Ausgaben einzusehen und Modelle zu konfigurieren, ohne die Konfigurationsdatei direkt zu bearbeiten - Funktioniert auch mit lokalen Laufzeitumgebungen — dieselbe Routing-Schicht, die OpenAI oder Anthropic aufruft, kann ebenso auf einen lokalen Ollama- oder vLLM-Endpunkt zeigen, sodass ein Gateway Cloud- und lokale Modelle mischen kann
Anwendungsbeispiele: Zwei Wege, LiteLLM zu nutzen
Dies sind konkrete Arbeitsabläufe, aufgebaut auf den oben dokumentierten Installationswegen von LiteLLM — keine hypothetischen Anwendungsfälle.
Mehrere Anbieter aus einem Python-Skript aufrufen
SDK installieren (pip install litellm), dann direkte Aufrufe der openai-, anthropic- oder anbieterspezifischen Clients durch `litellm.completion(model="gpt-4o", messages=[...]) bzw. litellm.completion(model="claude-opus-4", messages=[...])` ersetzen. Beide Aufrufe liefern dieselbe normalisierte Antwortform, sodass ein Anbieterwechsel nur eine einzeilige Änderung des Modellnamens ist, keine Neuentwicklung.
Einen selbst gehosteten Gateway für ein Team betreiben
Den LiteLLM Proxy Server bereitstellen (Docker oder Helm), eine config.yaml mit einer model_list definieren, die verständliche Modellnamen auf echte Anbieter-Deployments abbildet, und pro Entwickler oder App einen virtuellen API-Schlüssel ausgeben. Jede App ruft nun einen internen Endpunkt auf, statt eigene OpenAI-/Anthropic-Schlüssel zu halten, und die Ausgaben werden zentral im Admin-Dashboard erfasst.
Cloud- und lokale Modelle hinter einem Endpunkt mischen
Sowohl ein Cloud-Modell (z. B. openai/gpt-4o) als auch ein lokal per Ollama oder vLLM bereitgestelltes Modell zur selben model_list in der config.yaml hinzufügen. Routinemäßigen oder datenschutzsensiblen Traffic an das lokale Modell leiten und nur bei Bedarf zum Cloud-Modell eskalieren, ohne zu ändern, wie die aufrufende Anwendung mit dem Gateway spricht.
LiteLLM installieren: SDK, Proxy und Docker
LiteLLM ist ein Framework und selbst gehostetes Gateway, keine herunterladbare Endnutzer-App — es gibt keinen Installer aus einem App Store. Unten stehen die tatsächlichen Installations- und Schnellstart-Befehle laut LiteLLMs eigener Dokumentation und Docker-Schnellstart; prüfen Sie vor jedem Deployment die Doku direkt, da sich genaue Flags und Image-Tags zwischen Releases ändern können.
Python-SDK
- Befehl:
pip install litellm(oderuv add litellm)
Proxy Server (pip)
- Befehl:
- `pip install 'litellm[proxy]'
, dannlitellm --model gpt-4o`
Proxy Server (Docker)
- Befehl:
docker run -v $(pwd)/config.yaml:/app/config.yaml -e OPENAI_API_KEY=<key> -e LITELLM_MASTER_KEY=sk-1234 -p 4000:4000 docker.litellm.ai/berriai/litellm:latest --config /app/config.yaml
Helm (Kubernetes)
- Befehl:
helm install litellm oci://ghcr.io/berriai/litellm-helm -f values.yaml
AWS ECS Fargate
- Befehl:
- Offizielles Terraform-Modul
BerriAI/litellm/aws(stellt VPC, Aurora PostgreSQL, ElastiCache Redis, ALB, ECS bereit)
Google Cloud Run
- Befehl:
- Offizielles Terraform-Modul
BerriAI/litellm/google(stellt Cloud SQL, Memorystore Redis, GCS, HTTPS-Load-Balancer bereit)
Der Proxy verwendet standardmäßig Port 4000, mit dem Admin-Dashboard unter http://localhost:4000/ui (Standard-Login: Benutzername admin, Passwort entspricht Ihrem LITELLM_MASTER_KEY). Eine minimale config.yaml benötigt ein model_list-Array, das einen model_name auf litellm_params (den tatsächlichen Anbieter-Modellstring plus dessen API-Schlüssel) abbildet — ein vollständiges Beispiel finden Sie im Proxy-Schnellstart. Render und Railway bieten laut LiteLLMs Deployment-Doku ebenfalls Ein-Klick-Buttons für den Proxy an.
LiteLLM-Kosten für Unternehmen: Kern kostenlos, Enterprise auf Anfrage
Das Open-Source-SDK und der Proxy Server sind kostenlos — Sie zahlen nur für die zugrunde liegenden Anbieter-API-Aufrufe, die Sie über LiteLLM leiten, plus Ihre eigenen Hosting-Kosten. LiteLLM selbst berechnet für den Open-Source-Weg weder pro Anfrage noch pro Token etwas. Eine separate, kostenpflichtige LiteLLM-Enterprise-Stufe existiert unter litellm.ai/enterprise mit SSO, priorisierten Feature-Wünschen und dediziertem Support, laut der eigenen Projektseite — diese Review fand keine veröffentlichten Enterprise-Preise und empfiehlt, für ein Angebot direkt Kontakt mit LiteLLM aufzunehmen.
- Open-Source-SDK und Proxy Server: keine Lizenzgebühr, Kern-Repository unter MIT-Lizenz (siehe Lizenzhinweis unten)
- Sie zahlen weiterhin an den Anbieter, an den geroutet wird — LiteLLM senkt nicht die API-Preise von OpenAI, Anthropic oder Bedrock, es vereint und protokolliert sie nur
- Das Selbst-Hosten des Proxys hat eigene Infrastrukturkosten: einen Server oder Container-Host, plus PostgreSQL und Redis für den produktiven Einsatz
- LiteLLM Enterprise ergänzt SSO, priorisierten Support und weitere Business-Funktionen auf demselben Open-Source-Kern, laut litellm.ai/enterprise — Preise sind nicht veröffentlicht und erfordern Kontakt mit dem Unternehmen
- Die Enterprise-Preise werden laut litellm.ai/pricing jährlich abgerechnet und nach Anfragekapazität des Gateways, Deployment-Architektur und Supportbedarf bemessen, nie pro Token; ein 30-Tage-Testschlüssel für Enterprise ist verfügbar, Angebote kommen über den Vertrieb
- Single Sign-on (SSO) ist laut LiteLLM-SSO-Dokumentation ab Version v1.76.0 für bis zu 5 Nutzer kostenlos; darüber hinaus ist eine Enterprise-Lizenz erforderlich
LiteLLM vs. vLLM vs. LocalAI
LiteLLM, vLLM und LocalAI lösen unterschiedliche Probleme, die leicht verwechselt werden, weil alle drei eine OpenAI-kompatible API bereitstellen. LiteLLM leitet Anfragen an anderswo laufende Modelle weiter; vLLM und LocalAI führen die Modellgewichte selbst aus.
Aspekt | LiteLLM | ||
|---|---|---|---|
| Was es tut | Leitet Anfragen an Anbieter weiter | Führt Modelle selbst aus | Führt Modelle selbst aus |
| Führt Modellgewichte aus | Nein | Ja | Ja |
| Lizenz | MIT (+ Enterprise-Ausnahme) | Apache-2.0 | MIT |
| GPU nötig | Nein (nur Router) | Ja, für Echtzeitbetrieb | Kommt auf Modell an |
| Am besten für | Multi-Anbieter-Routing & Kostenverfolgung | Hochdurchsatz-Betrieb selbst gehostet | Einzelner selbst gehosteter OpenAI-API-Server |
Diese Tools werden meist zusammen eingesetzt, nicht als Ersatz füreinander: LiteLLM kann als Routing- und Kostenverfolgungs-Schicht vor einem vLLM- oder LocalAI-Deployment stehen, während vLLM oder LocalAI die eigentliche Modell-Inferenz übernimmt. Details zu diesen beiden finden Sie im vLLM-Erklärartikel und LocalAI-Erklärartikel.
Für wen ist LiteLLM geeignet?
Ob LiteLLM passt, hängt davon ab, ob Ihre Anwendung bereits mehr als einen LLM-Anbieter aufruft oder dies plant — eine Ein-Anbieter-App profitiert weniger von einer Routing-Schicht.
Nutzen Sie LiteLLM, wenn
- Ihre Anwendung zwei oder mehr LLM-Anbieter aufruft (oder dies plant) und Sie einen gemeinsamen Codepfad statt anbieterspezifischen Integrationscode möchten
- Sie zentrale Kostenverfolgung und Budgets pro Schlüssel oder Nutzer über mehrere Apps, Teams oder Kunden hinweg benötigen
- Sie automatischen Fallback zu einem zweiten Anbieter wünschen, wenn der primäre einen Fehler wirft oder Sie ratenlimitiert
- Sie Cloud-Modelle mit einem lokal gehosteten Modell (über Ollama oder vLLM) hinter demselben Endpunkt mischen möchten
- Die Routing-Schicht quelloffen sein soll (MIT-Kern) statt ein geschlossener, nur gehosteter Dienst
Warten Sie ab oder schauen Sie sich anderweitig um, wenn
- Ihre Anwendung nur einen einzigen Anbieter aufruft und Sie keinen zweiten planen — die Routing-Schicht bringt operativen Aufwand (ein zu betreibender Proxy oder eine SDK-Abhängigkeit) ohne unmittelbaren Nutzen
- Sie eine Modell-Serving-Engine statt eines Routers brauchen — Sie benötigen tatsächlich etwas, das Modellgewichte ausführt (siehe vLLM oder LocalAI)
- Sie einen vollständig verwalteten, zero-ops Routing-Dienst statt eines selbst gehosteten Proxys möchten — ein gehosteter Router wie OpenRouter erspart den PostgreSQL-/Redis-Betriebsaufwand, auf Kosten des Betriebs über einen Dritten
- Eine Lizenzentscheidung speziell von Code innerhalb des Verzeichnisses
enterprise/abhängt — lesen Sieenterprise/LICENSEdirekt, statt anzunehmen, dass dort die MIT-Lizenz des gesamten Repositorys gilt
LiteLLM vs. andere Gateways und Frameworks
LiteLLM gehört zum Segment Router und Gateways in PromptQuorums Local LLM Software Directory, das drei weitere eigene Reviews umfasst, die unten zuerst aufgeführt sind. Die übrigen Vergleiche stammen von benachbarten Tools im selben „Run & Serve"-Teil des Directorys, ergänzt um eine bekannte gehostete Alternative außerhalb des Directorys.
- Plano — ein selbst gehosteter, Envoy-basierter KI-Proxy und Data Plane für agentenbasierte Anwendungen mit LLM-Routing, Observability und Guardrails (Apache-2.0).
- ClawRouter — ein selbst gehosteter, für Agenten konzipierter LLM-Router, der Routing-Entscheidungen lokal über Spitzen- und kostenlose Open-Weight-Modelle trifft (MIT).
- AIClient2API — ein selbst gehosteter Proxy, der die Client-Protokolle von Gemini CLI, Codex, Grok, Kiro und Antigravity in eine einzige OpenAI-kompatible API umwandelt (GPL-3.0).
- vLLM — eine selbst gehostete Inferenz-Engine, die tatsächlich Modellgewichte ausführt (GPU erforderlich); wird meist zusammen mit LiteLLM eingesetzt statt als Konkurrenz, wobei LiteLLM als Routing-Schicht vor einem oder mehreren vLLM-Deployments steht.
- LocalAI — ein selbst gehosteter, OpenAI-kompatibler API-Server zum lokalen Betrieb offener Modelle; löst ein anderes Problem als LiteLLM (Ausführen vs. Routing), bietet aber eine ähnliche OpenAI-Format-API — eine häufige Verwechslungsquelle zwischen beiden.
- LangChain — ein Anwendungs-Framework zum Bauen LLM-gestützter Apps (Chains, Agenten, Memory); kann LiteLLM (oder jeden Anbieter direkt) als Modellzugriffsschicht nutzen, statt zu ersetzen, was LiteLLM tut.
- OpenRouter (extern, nicht im Directory von PromptQuorum) — ein gehosteter, verwalteter Routing-Dienst für einen ähnlichen Multi-Anbieter-Anwendungsfall wie LiteLLMs Proxy, jedoch als Drittanbieter-Dienst, den Sie aufrufen, statt Infrastruktur, die Sie selbst betreiben; ein direkter Vergleich lohnt sich, wenn Sie zero-ops-Routing statt eines eigenen Proxys wollen.
Häufige Fehler bei der Bewertung von LiteLLM
Die meiste Verwirrung um LiteLLM entsteht, wenn es mit einer Modell-Serving-Engine verwechselt wird oder wenn seine Lizenz zu stark vereinfacht wird.
Fehler 1: Annehmen, LiteLLM führe die Modelle selbst aus
LiteLLM ist ein Router — es leitet Anfragen an Anbieter-APIs oder an eine lokale Laufzeitumgebung weiter, auf die Sie es verweisen (Ollama, vLLM und andere). Es lädt selbst keine Modellgewichte und führt keine eigene Inferenz aus, anders als vLLM oder LocalAI.
Fehler 2: Das gesamte Repository als einfach MIT behandeln
Der Kern-Code steht laut eigener LICENSE-Datei des Repositorys unter der MIT-Lizenz, aber Inhalte im Unterverzeichnis enterprise/ sind separat unter enterprise/LICENSE lizenziert. Prüfen Sie, welche Dateien Sie tatsächlich verwenden, bevor Sie pauschal MIT-Bedingungen annehmen.
Fehler 3: PostgreSQL und Redis auslassen und dann fehlende Ausgabendaten oder inkonsistente Rate-Limits erleben
Das SDK litellm allein benötigt keine Datenbank. Der selbst gehostete Proxy Server braucht PostgreSQL, um virtuelle Schlüssel und Ausgabendaten dauerhaft zu speichern, sowie Redis für Rate-Limiting, das über mehr als eine Proxy-Instanz hinweg konsistent bleibt — der Betrieb des Proxys ohne beides funktioniert für einen schnellen Test, verliert aber diese Funktionen im großen Maßstab.
Fehler 4: Erwarten, LiteLLM senke die Anbieter-API-Preise
LiteLLM verfolgt und vereinheitlicht Kosten über Anbieter hinweg; es verhandelt oder rabattiert nicht die zugrunde liegenden Preise von OpenAI, Anthropic oder Bedrock, die Sie ohnehin zahlen. Die Ersparnis entsteht durch Routing/Fallback, das verschwendete Wiederholungsversuche und Rate-Limit-Stillstände vermeidet, nicht durch einen anderen Preis pro Token.
Häufig gestellte Fragen
Was ist LiteLLM?
LiteLLM (auch „Lite LLM" geschrieben; github.com/BerriAI/litellm) ist ein Open-Source-Gateway, mit dem Anwendungen über eine einzige OpenAI-kompatible Schnittstelle auf über 100 LLM-Anbieter-APIs zugreifen können, verfügbar als Python-SDK oder als selbst gehosteter Proxy-Server mit Routing, Kostenverfolgung und Rate-Limiting.
Was kostet LiteLLM — ist es kostenlos?
Das Open-Source-SDK und der Proxy Server kosten nichts — Sie zahlen nur die zugrunde liegenden Anbieter-API-Aufrufe und Ihr eigenes Hosting. Die separate kostenpflichtige Enterprise-Stufe ergänzt SSO für mehr als fünf Nutzer, Audit-Logs und 24/7-Support mit SLAs; sie wird laut Anbieter jährlich über den Vertrieb angeboten, nach Anfragekapazität bemessen und nie pro Token abgerechnet. Ein 30-Tage-Testschlüssel ist verfügbar; veröffentlichte Preise gibt es nicht.
Ist LiteLLM für Unternehmen geeignet?
Ja. Der MIT-lizenzierte Kern (alles außerhalb von enterprise/) darf kommerziell genutzt werden, und Teams betreiben ihn als gemeinsames internes Gateway mit virtuellen Schlüsseln, Budgets und Ausgabenverfolgung. SSO für mehr als fünf Nutzer, SCIM, Audit-Logs und SLA-gestützter Support erfordern die kostenpflichtige Enterprise-Lizenz; deren Seite nennt SOC 2 Type 2 und ISO 27001 (Herstellerangabe, hier nicht geprüft). Ob der Einsatz DSGVO-konform ist, hängt von den angebundenen Anbietern und Ihrer Konfiguration ab ; das ist keine Rechtsberatung — klären Sie es mit Ihrem Datenschutzbeauftragten.
Welche Lizenz verwendet LiteLLM?
Das Kern-Repository steht laut eigener LICENSE-Datei unter der MIT-Lizenz. Eine separate Lizenz gilt ausschließlich für das Unterverzeichnis enterprise/, unter enterprise/LICENSE — für diese Review direkt anhand der LICENSE-Datei des Repositorys geprüft.
Braucht LiteLLM eine GPU?
Nein. LiteLLM ist ein Anfrage-Router, keine Modell-Inferenz-Engine — es leitet Aufrufe an Anbieter (Cloud-APIs oder lokale Laufzeitumgebungen wie Ollama) weiter, statt selbst Modellgewichte auszuführen, und läuft daher problemlos auf reiner CPU-Hardware.
Wie installiere ich LiteLLM?
Für das Python-SDK: pip install litellm. Für den selbst gehosteten Proxy: `pip install 'litellm[proxy]', dann litellm --model gpt-4o, oder das Docker-Image docker.litellm.ai/berriai/litellm:latest mit gemounteter config.yaml` ausführen. Weitere Optionen wie Helm, AWS ECS Fargate und Google Cloud Run finden Sie in der Installationstabelle oben.
Benötigt der LiteLLM-Proxy eine Datenbank?
Für den produktiven Einsatz ja — PostgreSQL speichert virtuelle Schlüssel und Ausgabendaten dauerhaft, und Redis hält das Rate-Limiting über mehrere Proxy-Instanzen hinweg konsistent, laut LiteLLMs eigener Deployment-Dokumentation. Ein schneller lokaler Test läuft auch ohne beides, verliert dann aber diese Funktionen.
Kann LiteLLM an ein lokal gehostetes Modell routen?
Ja. Dieselbe model_list in der config.yaml, die auf OpenAI oder Anthropic zeigt, kann ebenso auf einen lokalen Ollama- oder vLLM-Endpunkt zeigen, sodass ein Gateway Cloud- und lokale Modelle mischen kann.
Wie schneidet LiteLLM im Vergleich zu OpenRouter ab?
Beide vereinen mehrere LLM-Anbieter hinter einer Schnittstelle. LiteLLM ist selbst gehostete Infrastruktur, die Sie selbst betreiben (Open-Source-Proxy oder SDK); OpenRouter ist ein gehosteter Drittanbieter-Routing-Dienst, den Sie aufrufen, statt einen eigenen zu betreiben. Die Wahl hängt davon ab, ob Sie zero-ops (OpenRouter) oder volle Kontrolle ohne Aufschlag pro Anfrage durch einen Router-Anbieter (selbst gehostetes LiteLLM) wollen.
Wer entwickelt LiteLLM?
BerriAI, die Organisation hinter dem Repository github.com/BerriAI/litellm, das Stand dieser Review über 61.000 Sterne aufweist.