LiteLLMとは何か?
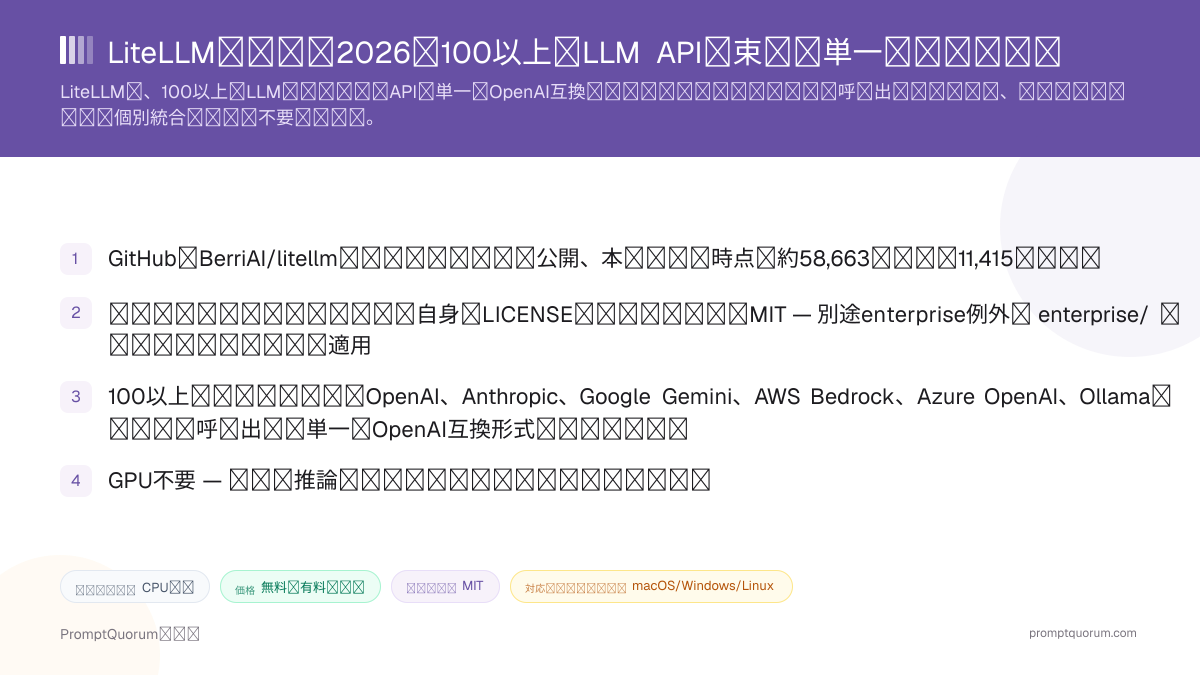
LiteLLMは、単一のOpenAI互換リクエスト形式を100以上の異なるLLMプロバイダーAPIへの呼び出しに変換するゲートウェイです。 自身のGitHubリポジトリの説明文では「最速・最軽量のAIゲートウェイ」と説明されており、Rustコアの上にPython SDKを載せた構成になっています — これはプロジェクト初期の純Python実装からの変化です。OpenAI API、Anthropic API、ローカルのOllamaサーバーそれぞれに個別のクライアントコードを書く代わりに、アプリケーションはLiteLLMを一度呼び出すだけで、LiteLLMがそのモデル名に設定されたプロバイダーへリクエストを転送します。
- 中核機能:OpenAIの
chat/completions形式(または対象プロバイダーのネイティブ形式)でリクエストを受け取り、設定済みのプロバイダーに転送し、正規化されたレスポンスを返す - 2つのアクセス方法:アプリケーションのコードに直接インポートするPython SDK
litellmと、他のアプリケーションがHTTP経由で呼び出す独立サービスのLiteLLM Proxy Server - 開発元:github.com/BerriAI/litellmリポジトリを運営する組織BerriAI
- モデルランタイムではない:LiteLLM自体はモデルの重みを読み込んだり推論を実行したりせず、クラウドAPIやOllama・vLLMのようなローカルサーバーなど、それを行うプロバイダーへリクエストをルーティングする
- ドキュメントによる本番向け機能:仮想APIキー、キー単位・ユーザー単位の支出予算、レート制限、同一モデルの複数デプロイ間でのロードバランシング、プロバイダーがエラーを返した際の自動フォールバック
LiteLLMで何ができるか?
LiteLLMの機能セットは、リクエストルーティング、コスト管理、信頼性という、プロバイダーとユーザーが増えるほど難しくなるLLMアプリケーション運用の部分をカバーしています。LiteLLM自身のドキュメントによる内容は次のとおりです。
- 統一されたAPI表面 — OpenAI形式でリクエストを送信すると、LiteLLMが対象モデルのプロバイダーが要求するネイティブ形式に変換し、レスポンスを正規化して返す
- ルーティングとロードバランシング — 単一障害点やレート制限の上限を避けるため、同一モデルの複数デプロイ(例:複数のAzure OpenAIリージョン)にトラフィックを分散
- フォールバックとリトライロジック — エラーをエンドユーザーに表示する代わりに、失敗したリクエストを別のプロバイダーやモデルデプロイに対して自動的に再試行
- コスト追跡と予算 — APIキー、ユーザー、チーム単位で支出を記録し、上限を超えると以降のリクエストをブロックする厳格な予算上限を設定
- レート制限 — キーまたはユーザーごとに分あたり/トークンあたりのリクエストを制限し、Redis経由で複数のプロキシインスタンス間でも一貫して適用
- ガードレールとロギング — コンテンツモデレーションやオブザーバビリティ統合向けのフック、および監査用の構造化されたリクエスト/レスポンスロギング
- 管理ダッシュボード — 設定ファイルを直接編集せずに仮想キーの管理、支出の確認、モデルの設定を行えるWeb UI(プロキシの
/uiで提供) - ローカルランタイムでも動作 — OpenAIやAnthropicを呼び出すのと同じルーティング層が、ローカルのOllamaやvLLMエンドポイントも同様に指せるため、1つのゲートウェイでクラウドモデルとローカルモデルを混在させられる
利用例:LiteLLMを使う2つの方法
これらは上記で説明したLiteLLMのインストール経路に基づく具体的なワークフローであり、仮定の話ではありません。
Pythonスクリプトから複数のプロバイダーを呼び出す
SDKをインストール(pip install litellm)し、openai・anthropic・プロバイダー固有のクライアント呼び出しを`litellm.completion(model="gpt-4o", messages=[...])またはlitellm.completion(model="claude-opus-4", messages=[...])`に置き換えます。どちらの呼び出しも同じ正規化されたレスポンス形式を返すため、プロバイダーの切り替えはモデル名を1行変更するだけで済み、書き直しは不要です。
チーム向けにセルフホスト型ゲートウェイを運用する
LiteLLM Proxy Server(DockerまたはHelm)をデプロイし、わかりやすいモデル名を実際のプロバイダーデプロイにマッピングするmodel_listを持つconfig.yamlを定義し、開発者またはアプリごとに仮想APIキーを発行します。各アプリは自前のOpenAI/Anthropicキーを保持する代わりに1つの内部エンドポイントを呼び出すようになり、支出は管理UIで一元的に追跡されます。
クラウドモデルとローカルモデルを1つのエンドポイントの背後で混在させる
クラウドモデル(例:openai/gpt-4o)とOllamaやvLLMで提供されるローカルモデルの両方を、config.yamlの同じmodel_listに追加します。日常的なトラフィックやプライバシーに敏感なトラフィックはローカルモデルにルーティングし、必要な場合のみクラウドモデルにエスカレーションします。呼び出し側アプリケーションがゲートウェイと話す方法は変更不要です。
LiteLLMのインストール:SDK、プロキシ、Docker
LiteLLMはフレームワーク兼セルフホスト型ゲートウェイであり、エンドユーザー向けのダウンロード可能なアプリではありません — アプリストアから「入手」するインストーラーは存在しません。 以下は、LiteLLM自身のドキュメントおよびDockerクイックスタートに基づく実際のインストール・クイックスタートコマンドです。正確なフラグやイメージタグはリリースごとに変わる可能性があるため、デプロイ前には必ずドキュメントを直接確認してください。
Python SDK
- コマンド:
pip install litellm(またはuv add litellm)
Proxy Server(pip)
- コマンド:
- `pip install 'litellm[proxy]'
の後litellm --model gpt-4o`
Proxy Server(Docker)
- コマンド:
docker run -v $(pwd)/config.yaml:/app/config.yaml -e OPENAI_API_KEY=<key> -e LITELLM_MASTER_KEY=sk-1234 -p 4000:4000 docker.litellm.ai/berriai/litellm:latest --config /app/config.yaml
Helm(Kubernetes)
- コマンド:
helm install litellm oci://ghcr.io/berriai/litellm-helm -f values.yaml
AWS ECS Fargate
- コマンド:
- 公式Terraformモジュール
BerriAI/litellm/aws(VPC、Aurora PostgreSQL、ElastiCache Redis、ALB、ECSをプロビジョニング)
Google Cloud Run
- コマンド:
- 公式Terraformモジュール
BerriAI/litellm/google(Cloud SQL、Memorystore Redis、GCS、HTTPSロードバランサーをプロビジョニング)
プロキシはデフォルトでポート4000を使用し、管理ダッシュボードはhttp://localhost:4000/uiにあります(デフォルトログイン:ユーザー名admin、パスワードはLITELLM_MASTER_KEYと同じ)。最小限のconfig.yamlには、model_nameをlitellm_params(実際のプロバイダーのモデル文字列とそのAPIキー)にマッピングするmodel_list配列が必要です — 完全な例はプロキシクイックスタートを参照してください。LiteLLMのデプロイドキュメントによると、RenderとRailwayもプロキシ用のワンクリックデプロイボタンを提供しています。
LiteLLMの料金:本当に無料か?
オープンソースのSDKとProxy Serverは無料です — LiteLLM経由でルーティングする基盤プロバイダーAPI呼び出しの費用と、自身のホスティング費用だけを支払います。 LiteLLM自体は、オープンソース経路についてリクエストごとやトークンごとの課金を行いません。プロジェクト自身のサイトによると、litellm.ai/enterpriseには、SSO、優先機能リクエスト、専任サポートをカバーする別の有償LiteLLM Enterpriseティアが存在します — 本レビューでは公開されたEnterprise料金は見つからず、見積もりについてはLiteLLMに直接問い合わせることを推奨します。
- オープンソースのSDKとProxy Server:ライセンス料なし、コアリポジトリはMITライセンス(下のライセンスに関する注記を参照)
- ルーティング先のプロバイダーへの支払いは引き続き発生する — LiteLLMはOpenAI、Anthropic、Bedrockの料金を下げるわけではなく、統合し記録するだけ
- プロキシのセルフホストには独自のインフラコストがかかる:サーバーまたはコンテナホスト、加えて本番利用にはPostgreSQLとRedis
- litellm.ai/enterpriseによれば、LiteLLM Enterpriseは同じオープンソースコアの上にSSO、優先サポート、その他のビジネス機能を追加する — 料金は公開されておらず、企業への問い合わせが必要
- Enterpriseの料金は年額で、ゲートウェイのリクエスト容量、デプロイ構成、サポート要件に応じて決まり、トークン単位ではありません(litellm.ai/pricingより)。30日間のEnterpriseトライアルキーが用意されており、見積もりは営業窓口経由です
- シングルサインオン(SSO)はv1.76.0以降、5ユーザーまで無料で、それを超える場合はエンタープライズライセンスが必要です(LiteLLMのSSOドキュメントより)
LiteLLM vs. vLLM vs. LocalAI
LiteLLM、vLLM、LocalAIは異なる問題を解決していますが、3つともOpenAI互換APIを公開しているため混同されがちです。 LiteLLMは他所で動いているモデルへリクエストをルーティングし、vLLMとLocalAIは自らモデルの重みを実行します。
観点 | LiteLLM | ||
|---|---|---|---|
| 何をするか | プロバイダーへリクエストをルーティング | 自らモデルを提供 | 自らモデルを提供 |
| モデルの重みを実行するか | しない | する | する |
| ライセンス | MIT(+ enterprise例外) | Apache-2.0 | MIT |
| GPUの要否 | 不要(ルーターのみ) | リアルタイム提供には必要 | モデル次第 |
| 最適な用途 | マルチプロバイダーのルーティングと支出追跡 | 高スループットのセルフホスト提供 | 単一のセルフホスト型OpenAI互換API |
これらのツールは代替品としてではなく、一緒に使われることが一般的です。LiteLLMはvLLMやLocalAIのデプロイの手前にルーティング・コスト追跡層として配置でき、実際のモデル推論はvLLMやLocalAIが行います。この2つの詳細については、専用記事のvLLM解説とLocalAI解説を参照してください。
LiteLLMは誰に向いているか?
LiteLLMが合うかどうかは、あなたのアプリケーションがすでに複数のLLMプロバイダーを呼び出している、あるいは呼び出す予定があるかどうかによります — 単一プロバイダーのアプリはルーティング層の恩恵が少なくなります。
こんな場合はLiteLLMを使う
- アプリケーションが2つ以上のLLMプロバイダーを呼び出している(または呼び出す予定がある)し、プロバイダーごとの統合コードではなく1つのコードパスにしたい
- 複数のアプリ、チーム、顧客にまたがる、キー単位またはユーザー単位の集中的なコスト追跡と予算管理が必要
- プライマリのプロバイダーがエラーやレート制限を返した際に、第2のプロバイダーへ自動フォールバックしたい
- クラウドモデルとローカルにホストされたモデル(OllamaやvLLM経由)を同じエンドポイントの背後で混在させたい
- ルーティング層は、クローズドでホスト専用のサービスではなく、オープンソース(MITコア)であってほしい
こんな場合は待つか他を探す
- アプリケーションが1つのプロバイダーしか呼び出しておらず、2つ目を追加する予定もない — ルーティング層は即座のメリットなしに運用面(運用するプロキシやSDK依存)を増やすだけになる
- ルーターではなくモデル提供エンジンが必要 — 実際にモデルの重みを実行する何かが必要(vLLMやLocalAIを参照)
- セルフホスト型プロキシではなく、完全マネージド・ゼロ運用のルーティングサービスがほしい — OpenRouterのようなホスト型ルーターはPostgreSQL/Redisの運用負荷を避けられるが、サードパーティ経由になる
- ライセンスの判断が特に
enterprise/ディレクトリ内のコードに依存する — そこにリポジトリ全体のMITライセンスが適用されると仮定せず、enterprise/LICENSEを直接読む
LiteLLM vs. 他のゲートウェイとフレームワーク
LiteLLMは、PromptQuorumのローカルLLMソフトウェアディレクトリのルーター/ゲートウェイ分野に属します。同じ分野にはほかに3件の専用レビューがあり、下に最初に挙げています。残りの比較は、ディレクトリ内の同じ「Run & Serve」領域にある隣接ツールと、ディレクトリ外のよく知られたホスト型の代替サービスです。
- Plano — エージェント型アプリ向けの、Envoyベースのセルフホスト型AIプロキシ兼データプレーンで、LLMルーティング、可観測性、ガードレールを備えます(Apache-2.0)。
- ClawRouter — エージェント向けに設計されたセルフホスト型LLMルーターで、ルーティングの判断をローカルで行い、先端モデルと無料のオープンウェイトモデルに振り分けます(MIT)。
- AIClient2API — Gemini CLI、Codex、Grok、Kiro、Antigravityのクライアントプロトコルを単一のOpenAI互換APIに変換する、セルフホスト型プロキシです(GPL-3.0)。
- vLLM — 実際にモデルの重みを提供するセルフホスト型推論エンジン(GPU必須)。LiteLLMと競合するというより組み合わせて使われることが多く、LiteLLMが1つ以上のvLLMデプロイの手前でルーティング層として機能する。
- LocalAI — オープンモデルをローカルで実行するための、セルフホスト型でOpenAI互換のAPIサーバー。LiteLLMとは異なる問題(提供 vs. ルーティング)を解決するが、似たOpenAI形式のAPIを公開しており、両者の混同の一般的な原因となっている。
- LangChain — チェーン、エージェント、メモリなどLLM搭載アプリを構築するためのアプリケーションフレームワーク。LiteLLMが行うことを置き換えるのではなく、モデルアクセス層としてLiteLLM(または任意のプロバイダーを直接)を呼び出せる。
- OpenRouter(外部、PromptQuorumのディレクトリには非掲載) — LiteLLMのプロキシと似たマルチプロバイダーのユースケースをカバーするホスト型・マネージドのルーティングサービスだが、自分でホストするインフラではなく呼び出すサードパーティサービスである。自前のプロキシを運用する代わりにゼロ運用のルーティングを求めるなら直接比較する価値がある。
LiteLLM評価時のよくある誤解
LiteLLMに関する混乱の多くは、モデル提供エンジンと混同すること、またはライセンスを単純化しすぎることから生じます。
誤解1:LiteLLMが自らモデルを実行すると思い込む
LiteLLMはルーターです — プロバイダーAPIや、あなたが指定したローカルランタイム(Ollama、vLLMなど)へリクエストを転送します。vLLMやLocalAIとは異なり、自らモデルの重みを読み込んだり推論を実行したりはしません。
誤解2:リポジトリ全体を単純にMITとして扱う
コアコードはリポジトリ自身のLICENSEファイルによればMITライセンスですが、enterprise/サブディレクトリ内のコンテンツはenterprise/LICENSEの下で別途ライセンスされています。包括的なMIT条件が適用されると仮定する前に、実際にどのファイルを使っているかを確認してください。
誤解3:PostgreSQLとRedisを省略し、支出データの欠落やレート制限の不整合に直面する
litellm SDK単体ではデータベースは不要です。セルフホスト型のProxy Serverは、仮想キーと支出記録を永続化するためにPostgreSQLが、複数のプロキシインスタンス間で一貫したレート制限を保つためにRedisが必要です — どちらもなしでプロキシを動かすことは簡単なテストには使えますが、規模が大きくなるとこれらの機能を失います。
誤解4:LiteLLMがプロバイダーAPI料金を下げてくれると期待する
LiteLLMはプロバイダー間のコストを追跡・統合しますが、すでに支払っているOpenAI、Anthropic、Bedrockの基盤料金を交渉したり割り引いたりはしません。節約は、無駄なリトライやレート制限による停滞をルーティング/フォールバックが回避することから生まれるのであり、トークンあたりの料金が変わるわけではありません。
よくある質問
LiteLLMとは何ですか?
LiteLLM(github.com/BerriAI/litellm)は、アプリケーションが単一のOpenAI互換インターフェースで100以上のLLMプロバイダーAPIを呼び出せるようにするオープンソースのゲートウェイで、Python SDKとして、またはルーティング・コスト追跡・レート制限を備えたセルフホスト型プロキシサーバーとして利用できます。
LiteLLMは無料ですか?
オープンソースのSDKとProxy Serverは無料です — 基盤プロバイダーAPI呼び出しの費用と自身のホスティング費用のみ支払います。有償のLiteLLM Enterpriseは、5ユーザーを超えるSSO、監査ログ、SLA付きの24時間365日サポートを追加します。料金は年額の見積もり制で、リクエスト容量に応じて決まり、トークン単位ではありません。30日間のトライアルキーがありますが、料金は公開されていません。
LiteLLMは企業での利用に向いていますか?
はい。MITライセンスのコア(enterprise/以外のすべて)は商用利用でき、チームは仮想キー、予算、支出追跡を備えた共有の社内ゲートウェイとして運用しています。5ユーザーを超えるSSO、SCIM、監査ログ、SLA付きサポートには有償のEnterpriseライセンスが必要で、そのページにはSOC 2 Type 2とISO 27001が記載されています(ベンダーの表明であり、本レビューでは未検証)。データ保護規制への適合は、ルーティング先のプロバイダーと設定次第です。これは法的助言ではありません。データ保護の担当者にご確認ください。
LiteLLMはどのライセンスを使っていますか?
コアリポジトリは、リポジトリ自身のLICENSEファイルによればMITライセンスです。enterprise/サブディレクトリにのみ別のライセンスがenterprise/LICENSEの下で適用されます — 本レビューではリポジトリのLICENSEファイルを直接確認して検証しました。
LiteLLMにGPUは必要ですか?
いいえ。LiteLLMはモデル推論エンジンではなくリクエストルーターです — 自らモデルの重みを実行するのではなく、プロバイダー(クラウドAPIやOllamaのようなローカルランタイム)へ呼び出しを転送するため、CPUのみのハードウェアでも問題なく動作します。
LiteLLMのインストール方法は?
Python SDKの場合:pip install litellm。セルフホスト型プロキシの場合:`pip install 'litellm[proxy]'の後litellm --model gpt-4oを実行するか、config.yamlをマウントしてDockerイメージdocker.litellm.ai/berriai/litellm:latest`を実行します。Helm、AWS ECS Fargate、Google Cloud Runのオプションは上のインストール表を参照してください。
LiteLLMプロキシにはデータベースが必要ですか?
本番利用でははい — LiteLLM自身のデプロイドキュメントによれば、PostgreSQLが仮想キーと支出データを永続化し、Redisが複数のプロキシインスタンス間でレート制限を一貫させます。簡単なローカルテストであればどちらもなしで動作しますが、それらの機能は失われます。
LiteLLMはローカルにホストされたモデルへルーティングできますか?
はい。OpenAIやAnthropicを指すconfig.yamlの同じmodel_listが、ローカルのOllamaやvLLMエンドポイントを同様に指すことができ、1つのゲートウェイでクラウドモデルとローカルモデルを混在させられます。
LiteLLMはOpenRouterとどう比較されますか?
どちらも複数のLLMプロバイダーを単一インターフェースの背後に統合します。LiteLLMは自分で運用するセルフホスト型インフラ(オープンソースのプロキシまたはSDK)であり、OpenRouterは自前で運用する代わりに呼び出すサードパーティのホスト型ルーティングサービスです。ゼロ運用(OpenRouter)を望むか、ルータープロバイダーによるリクエストあたりのマークアップなしの完全な制御(セルフホスト型LiteLLM)を望むかで選択します。
LiteLLMは誰が開発していますか?
github.com/BerriAI/litellmリポジトリを運営する組織BerriAIです。本レビュー時点で61,000以上のスターを示しています。